

Pour rivaliser avec Amazon dans les recommandations des agents d’achat IA, les marchands ont besoin de flux produit précis rendus côté serveur, d’un texte produit conversationnel qui répond directement aux questions des acheteurs, et d’une routine de test continue qui détecte les problèmes avant qu’ils ne coûtent des ventes. Les agents comme ChatGPT et Gemini s’appuient sur les données structurées définies dans la spécification d’OpenAI pour les flux produit et les consignes de Google sur les données structurées produit, pas seulement sur le classement des pages. Il existe des outils qui simulent précisément ces évaluations et signalent les lacunes avant qu’elles ne vous coûtent en visibilité.
En bref :
- Veillez à ce que les flux produit et le JSON LD rendu côté serveur concordent avec les pages visibles sur le prix, la disponibilité, les identifiants et les variantes ; validez les modifications avec le Rich Results Test de Google.
- Remplacez les spécifications brutes par des cas d’usage en langage clair, le profil d’acheteur visé, les compromis et une courte FAQ afin que les agents puissent répondre aux questions des acheteurs et justifier les recommandations.
- Commencez par vos 20 produits les plus visités : corrigez d’abord les écarts de prix et de stock, puis ajoutez deux ou trois puces conversationnelles et validez chaque modification.
- Testez ChatGPT, Gemini, Claude et Perplexity ensemble ; les modifications du flux se valident en quelques jours, l’ingestion prend des semaines, et les gains de trafic peuvent apparaître après 60 à 90 jours.
Ce que privilégient les agents d’achat IA, et pourquoi cela compte pour votre catalogue
Les agents ne lisent pas votre fiche produit comme le ferait un acheteur. Ils s’appuient d’abord sur les flux structurés et vérifient que le prix, la disponibilité et les informations vendeur correspondent bien à ce qui est publié sur la page elle-même. Un contenu qui se lit bien pour un humain, mais qui n’a pas d’appui lisible par machine, est souvent ignoré, car l’agent n’a aucun moyen fiable de confirmer ces informations.
La personnalisation amplifie encore ce phénomène. Au lieu de produire un classement fixe, des agents comme Gemini et ChatGPT associent dynamiquement les produits aux besoins exprimés par l’acheteur, ce qui signifie qu’un même catalogue peut remonter différemment pour deux clients distincts. Les propres tests d’Amazon sur une fonctionnalité appelée Interests montrent la direction que prend la catégorie : une découverte proactive, guidée par les préférences, plutôt que des résultats de recherche statiques.
Trois actions que les marchands peuvent mener cette semaine :
- Vérifiez que votre flux produit et votre page en ligne affichent exactement les mêmes prix et statuts de stock.
- Ajoutez des cas d’usage en langage simple sur vos fiches produit les plus importantes.
- Lancez une analyse gratuite pour voir quelles fiches produit un agent ignorerait actuellement.
Les indispensables techniques : flux produit et données structurées
Deux systèmes doivent être cohérents pour qu’un agent fasse confiance à votre fiche produit : le JSON-LD rendu côté serveur sur la page produit elle-même, et un flux canonique envoyé à Merchant Center ou via la spécification commerce d’OpenAI. Google indique clairement que les données structurées doivent apparaître dans le HTML renvoyé par le serveur, et non être injectées plus tard par JavaScript, et qu’elles doivent correspondre à ce que l’acheteur voit réellement sur la page.
Champs prioritaires sur lesquels s’appuient les agents et les flux sous-jacents :
- Prix et devise, maintenus synchronisés avec la page en ligne.
- Statut de disponibilité, mis à jour en temps réel.
- GTIN ou SKU, pour éviter qu’un même produit soit dupliqué ou mal interprété selon les sources.
- Données de variantes (taille, couleur, matière) correctement rattachées aux produits parents.
- Informations sur le vendeur et liens vers les politiques de livraison ou de retour, que les recommandations de Merchant Center considèrent comme essentiels pour un appariement précis.
La spécification de flux d’OpenAI impose aux marchands de fournir des fiches produit structurées incluant le prix, la disponibilité et les métadonnées vendeur afin que ChatGPT puisse refléter les données actuelles du catalogue plutôt qu’un texte obsolète récupéré par scraping.
Pour vérifier la conformité, testez vos pages avec le Rich Results Test de Google, surveillez Search Console pour repérer les erreurs de données structurées, et contrôlez l’état du flux à l’aide des validateurs publiés par OpenAI. Un écart entre le flux et la page, même minime comme un statut de stock dépassé, est l’une des raisons les plus fréquentes pour lesquelles une fiche produit est écartée de la présélection d’un agent.
Réécrivez vos contenus produit pour que les agents puissent citer et justifier votre produit
Les caractéristiques techniques indiquent à un agent ce qu’est un produit. Les attributs conversationnels lui indiquent à qui il convient et pourquoi il l’emporte, ce qui est précisément ce qui apparaît lorsqu’un agent construit un guide d’achat. Une caractéristique comme « 600D polyester, 9,8 litres » devient bien plus utile sous la forme « peut contenir un ordinateur portable de 13 pouces et un change pour une nuit ».
La fonctionnalité de recherche shopping d’OpenAI est conçue pour poser des questions de clarification et assembler des guides personnalisés avec leur justification, ce qui signifie que les fiches produit qui explicitent les cas d’usage et les compromis en langage simple ont plus de chances d’être citées.
Approches qui tendent à fonctionner :
- Des listes à puces courtes plutôt que des paragraphes denses, surtout pour les cas d’usage et les matériaux.
- Un court extrait de FAQ qui répond à la ou aux deux questions que les acheteurs posent toujours.
- Des libellés explicites indiquant à qui le produit convient (« idéal pour les petites cuisines », « non étanche »).
Conseil pro : Rédigez, pour chaque produit, une phrase qui répond à « pourquoi choisir celui-ci plutôt qu’une option similaire », car c’est la phrase qu’un agent a le plus de chances de reprendre dans un guide d’achat.
Ces modifications se combinent bien avec une réécriture structurée des descriptions produit spécifiquement pensée pour être lisible par les agents plutôt que pour améliorer le classement dans les moteurs de recherche.
Workflow fondé sur la simulation : comment tester, diagnostiquer et itérer
Les modifications ponctuelles faites au hasard suivent rarement le rythme auquel les agents évaluent les fiches produit, car les critères d’évaluation évoluent à mesure que les agents mettent à jour leurs modèles et leurs flux. La simulation continue traite l’agent comme un système testable : lancez une requête, voyez ce qu’il choisit, puis identifiez pourquoi votre produit a perdu.
Un diagnostic type fait généralement ressortir :
- Des lacunes dans le flux, comme un GTIN manquant ou un indicateur de disponibilité obsolète.
- Des lacunes de contenu, lorsqu’une page concurrente répond à une question d’acheteur que la vôtre ne couvre pas.
- Une confusion sur les variantes, lorsque les options de taille ou de couleur ne sont pas clairement rattachées.
| Étape de cadence | Ce qui se passe | Résultat type |
|---|---|---|
| Analyse | Simuler des requêtes d’agent sur votre catalogue | Carte des victoires/défaites par produit |
| Prioriser | Classer les corrections selon leur impact sur les requêtes perdues | Liste courte de 5 corrections |
| Mettre en œuvre | Mettre à jour le flux, le JSON-LD ou le contenu | Modifications en ligne sur la boutique |
| Relancer l’analyse | Confirmer que l’agent sélectionne désormais le produit | Validation ou nouveau diagnostic |
Un guide de diagnostic sur 7 à 30 jours construit autour de ce rythme permet généralement de détecter les écarts qu’un audit ponctuel ne voit pas, car le comportement des agents et les fiches concurrentes évoluent en permanence.
Checklist Shopify et WooCommerce : où modifier, valider et synchroniser précisément
Sur Shopify, le JSON-LD rendu côté serveur doit se trouver dans le modèle produit (product.json.liquid ou le fichier de section équivalent), et non être injecté via une application tierce reposant sur du JavaScript côté client. Sur WooCommerce, cela implique généralement de modifier le modèle de fiche produit unique ou d’utiliser un plugin qui écrit le balisage dans la réponse serveur plutôt que dans le navigateur.
Votre flux canonique, qu’il soit envoyé à Merchant Center ou formaté selon la spécification d’OpenAI, doit s’appuyer sur la même source de vérité que votre JSON-LD afin que le prix et le stock ne divergent jamais. Une structure de graphe de connaissances produit aide à maintenir la cohérence des variantes, GTIN et attributs entre les deux.
Gains rapides pour un seul sprint :
- Synchronisez d’abord le prix et la disponibilité entre le flux et la page, car les écarts bloquent directement l’inclusion.
- Ajoutez deux ou trois puces conversationnelles à vos produits générant le plus de trafic.
- Validez chaque modification avec Rich Results Test avant de passer au lot suivant.
Conseil pro : Corrigez d’abord vos 20 produits générant le plus de trafic avant de toucher à la longue traîne. Les agents évaluent ce qui est le plus recherché.
Mesure, calendrier et résultats attendus
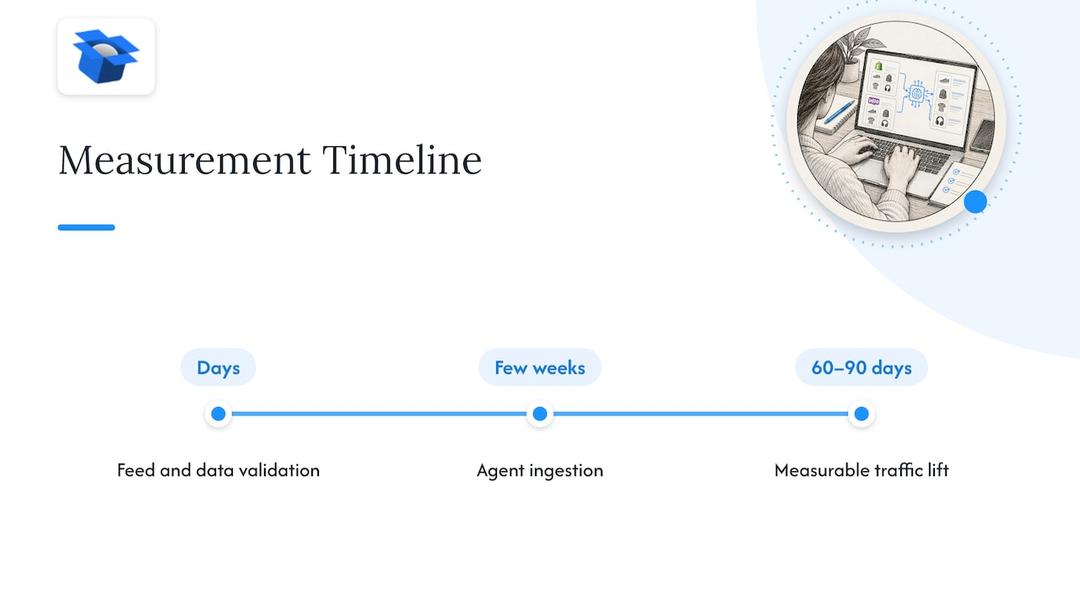
La validation des modifications du flux et des données structurées intervient en quelques jours. L’ingestion des flux mis à jour par les agents prend généralement quelques semaines, et une hausse mesurable du trafic apparaît souvent entre 60 et 90 jours, à mesure que les agents réexplorent et retestent votre catalogue.
Suivez séparément les visites attribuées aux agents par rapport à la recherche organique, ainsi que le taux de conversion issu de l’IA et la fréquence d’apparition de vos produits dans les guides d’achat générés par les agents pour des requêtes pertinentes.
La fonctionnalité de recherche shopping d’OpenAI est conçue pour poser des questions de clarification et générer des guides personnalisés, ce qui signifie qu’un instantané de simulation avant/après est souvent le moyen le plus clair de confirmer qu’une correction a réellement modifié la recommandation d’un agent plutôt que d’y avoir simplement coïncidé.
Les tests segmentés, comparant les produits corrigés à des produits similaires encore inchangés, aident à distinguer l’impact réel du bruit saisonnier.
Vue d’ensemble des principales stratégies concurrentielles face aux capacités IA d’Amazon
L’avantage d’Amazon n’a jamais reposé uniquement sur la taille de son catalogue. Il vient de la maîtrise de sa chaîne de données : précision des flux, inventaire en temps réel et désormais fonctionnalités de découverte proactive comme l’outil Interests actuellement testé, qui utilise des requêtes en langage naturel pour faire émerger des produits avant même qu’un acheteur ne lance une recherche. Les marchands indépendants ne peuvent pas égaler cette échelle, mais ils peuvent reproduire la rigueur qui la rend efficace.
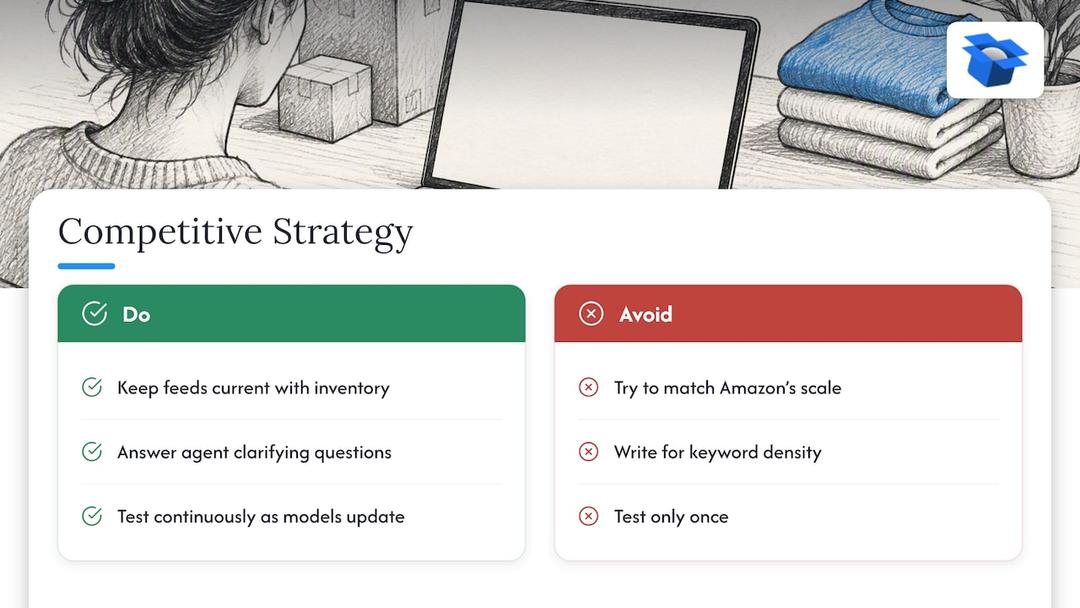
La stratégie concrète pour un vendeur hors Amazon comporte trois volets, détaillés dans ce guide Ecommerce AI SEO. Premièrement, traitez votre flux comme un produit à part entière, maintenu aussi à jour que votre système d’inventaire, car les agents font de plus en plus confiance aux données structurées plutôt qu’au contenu des pages. Deuxièmement, rédigez vos contenus produits pour répondre aux questions de clarification qu’un agent pose réellement, et non pour maximiser la densité de mots-clés. Troisièmement, testez en continu plutôt qu’une seule fois, car le comportement des agents évolue avec les mises à jour des modèles et les ajustements des fiches concurrentes.
La précision des prix et de la disponibilité compte ici plus que presque partout ailleurs, car un agent qui recommande un produit avec un mauvais statut de stock crée une mauvaise expérience qu’il cherchera à éviter de reproduire. La clarté des politiques de livraison et de retour a également pris plus d’importance, car les agents intègrent de plus en plus ces informations dans leurs recommandations d’achat.
Rien de tout cela n’exige d’égaler l’échelle d’Amazon. Il s’agit d’atteindre le même niveau d’hygiène des données qu’Amazon sur les produits que vous vendez, une tâche bien plus limitée et réalisable qu’elle n’en a l’air.
Intégration des agents d’achat IA multicanaux au-delà de ChatGPT et Gemini
ChatGPT et Gemini attirent le plus l’attention, mais ce ne sont pas les seuls agents qui formulent des recommandations. Claude et Perplexity disposent eux aussi de leurs propres parcours de recherche produit, chacun s’appuyant sur un mélange de flux structurés et de contenus de page. Une fiche optimisée pour un agent fonctionne donc généralement bien sur les autres lorsque les données sous-jacentes sont solides.
En pratique, les marchands ne devraient pas construire une stratégie uniquement pour ChatGPT ou Gemini. Un flux canonique conforme à la spécification commerce d’OpenAI et un flux Merchant Center respectant les recommandations de Google sur les données structurées couvrent les deux principales sources de trafic issues des agents, et les améliorations rédactionnelles conversationnelles qui aident un agent à citer votre produit tendent aussi à aider les autres.
Les différences entre agents concernent surtout la manière dont ils formulent les questions de clarification et structurent leur recommandation finale. Tester un produit simultanément face à plusieurs agents, plutôt qu’uniquement celui actuellement le plus médiatisé, est le seul moyen de savoir si une correction se généralise ou ne résout qu’un comportement spécifique d’un seul agent. C’est également là qu’une structure cohérente des données produit devient précieuse : une approche basée sur un graphe de connaissances qui relie attributs, variantes et politiques en un seul endroit facilite l’alimentation de chaque agent à partir d’une source unique et fiable, plutôt que de maintenir des versions séparées et divergentes de votre catalogue pour chacun.
Études de cas : concurrencer Amazon dans les recommandations IA
Le constat le plus clair dans les premiers travaux sur la visibilité auprès des agents est que de petites corrections ciblées surpassent souvent les refontes globales de contenu. Un marchand avec un écart entre le prix du flux et celui de la page obtiendra généralement des gains plus rapides en corrigeant ce seul champ qu’en réécrivant toutes les descriptions produit du site, car cet écart est souvent la raison directe pour laquelle un agent exclut la fiche.
Les marchands ayant ajouté un langage clarifiant les cas d’usage — répondant à des questions comme « à qui ce produit s’adresse » et « ce qu’il remplace » — ont signalé une amélioration de la fréquence d’apparition de leurs produits dans les guides d’achat générés par les agents plutôt que dans des résultats de recherche génériques. Cela correspond à la manière dont OpenAI décrit sa fonctionnalité de recherche shopping : elle pose des questions de clarification et renvoie des sélections argumentées. Une fiche produit qui répond déjà à ces questions dans un langage clair part donc avec une longueur d’avance.
Le point commun de ces réussites est la vitesse d’itération. Les équipes qui ont analysé, corrigé les quelques principaux problèmes puis relancé l’analyse rapidement ont systématiquement découvert de nouveaux problèmes plus mineurs que la première analyse n’avait pas révélés, comme une erreur de correspondance de variante n’apparaissant que pour une taille donnée. Une vision plus large des tactiques pour obtenir des recommandations pilotées par l’IA confirme ce constat : les marchands qui gagnent en visibilité sont ceux qui traitent cela comme un processus de diagnostic continu, et non comme un projet ponctuel.
Point de vue de l’éditeur : pourquoi nous privilégions l’optimisation basée d’abord sur la simulation
Les corrections limitées au contenu rédactionnel finissent par stagner, car elles traitent les recommandations des agents comme un problème d’écriture plutôt que de données et de tests. Les marchands qui avancent le plus vite considèrent chaque modification de fiche comme une hypothèse à retester, en analysant toutes les quelques semaines plutôt qu’une fois par trimestre.
— Xhurian
Comment ecentic aide : simulation, corrections priorisées et publication en un clic
Nous avons conçu une plateforme autour de l’écart qui surprend le plus souvent les marchands : comprendre précisément pourquoi un agent a ignoré un produit, et pas seulement constater qu’il l’a fait. La plateforme simule la manière dont ChatGPT, Gemini, Claude et Perplexity évaluent vos fiches, puis classe les corrections selon leur impact réel plutôt qu’au doigt mouillé.
- Elle diagnostique les problèmes de flux, de données structurées et de contenu dans un langage clair, sans jargon technique.
- Elle publie les corrections directement sur Shopify et WooCommerce en un clic.
- Elle relance automatiquement l’analyse afin de confirmer qu’une correction a réellement fonctionné.

Commencez par une analyse gratuite sur la ecentic page tarifaire pour voir comment vos fiches se positionnent actuellement face à l’évaluation des agents.
FAQ
Quel est le moyen le plus rapide de commencer à concurrencer Amazon dans les résultats shopping pilotés par l’IA ?
Lancez une analyse diagnostique de votre flux produit actuel et de vos pages en fonction de la manière dont des agents comme ChatGPT et Gemini évaluent réellement les fiches. Corriger les écarts détectés par l’analyse — généralement le prix, la disponibilité ou des données structurées manquantes — donne des résultats plus rapides qu’une réécriture complète du contenu.
Ai-je besoin à la fois d’un flux produit et de données structurées JSON-LD ?
Oui. Les recommandations de Google indiquent que les données structurées doivent être rendues côté serveur et correspondre à la page visible, tandis qu’un flux canonique distinct envoyé à Merchant Center ou via la spécification commerce d’OpenAI fournit aux agents une deuxième source vérifiable pour les mêmes données.
Combien de temps faut-il pour constater une amélioration du trafic piloté par l’IA après les modifications ?
La validation des corrections des données structurées et du flux intervient en quelques jours, l’ingestion par les agents prend généralement quelques semaines, et une hausse mesurable du trafic apparaît souvent entre 60 et 90 jours, à mesure que les agents réexplorent et retestent votre catalogue.
Combien coûte l’essai d’ecentic ?
ecentic propose une analyse d’introduction gratuite, avec des offres payantes incluant Compete à 14,90 $ par mois, Scale à 44,90 $ par mois et Dominate à 149 $ par mois, indiquées sur la page tarifaire d’ecentic.
Les petits marchands peuvent-ils réellement concurrencer les recommandations IA d’Amazon ?
Les petits marchands peuvent rivaliser sur la précision des données et la clarté conversationnelle même sans l’échelle d’Amazon, car les agents privilégient les fiches bien structurées et à jour quelle que soit la taille du catalogue. L’écart se réduit lorsque les données du flux et des pages restent synchronisées et que les contenus produits répondent directement aux questions des acheteurs.
Sources
Principales spécifications et outils de validation
- Spécification des flux produit – Agentic Commerce | OpenAI Developers : définit les champs de flux requis et les formats de variantes pour l’ingestion par ChatGPT.
- Présentation de la recherche shopping dans ChatGPT — OpenAI : explique comment les questions de clarification et les guides d’achat façonnent les recommandations des agents.
- Documentation sur les données structurées produit — Google Developers : définit les exigences JSON-LD et les règles de rendu côté serveur.
- Spécification des données produit — Google Merchant Center : couvre les attributs de flux requis et les formats nécessaires à une correspondance précise.
- Rich Results Test et Search Console : utilisez-les pour valider les données structurées et détecter les erreurs de reporting avant qu’elles n’affectent la visibilité auprès des agents.