

Le levier le plus important pour être sélectionné par ChatGPT, Gemini ou tout autre agent d’achat IA, c’est une fiche produit structurée, canonique et propre, pas un texte marketing astucieux. Cela signifie un JSON-LD ou un flux correct contenant des identifiants précis, une disponibilité à jour et une description en texte clair qui place les faits en premier. Appuyez-vous sur les standards que les agents analysent réellement : la spécification de flux produit OpenAI, le Shopify Catalog et des champs conversationnels comme product_highlight et question_and_answer. Des outils comme Ecentic existent parce que la plupart des boutiques se trompent sur ces points d’une manière invisible, jusqu’à ce qu’un agent les ignore discrètement.
En bref :
- Veiller à ce que vos données produit contiennent des identifiants précis, un schéma structuré et des faits placés en tête est essentiel pour les recommandations IA, car les agents s’appuient sur ces données plus que sur le ton marketing.
- Des écarts dans les titres, un statut de stock obsolète ou des GTIN manquants peuvent exclure vos produits des recommandations d’agents malgré de bonnes descriptions.
- Shopify prend naturellement en charge les données structurées, mais WooCommerce nécessite souvent des extensions supplémentaires et un mapping correct des attributs pour optimiser la découverte et la sélection.
- Tester régulièrement votre catalogue avec des outils de simulation aide à repérer les lacunes structurelles qui empêchent vos produits d’apparaître dans les recherches et recommandations pilotées par l’IA.
- Les descriptions générées par l’IA doivent privilégier un contenu factuel, centré sur les spécifications, complété par des détails distinctifs ajoutés par des humains afin de maximiser à la fois l’analyse par les agents et la confiance des acheteurs.
Comment les agents IA lisent-ils les descriptions produit pour formuler des recommandations ?
Un agent IA d’achat ne parcourt pas votre boutique comme le ferait une personne. Il reformule la question du client en requête structurée, extrait des « slots » spécifiques (marque, plafond de prix, couleur, taille, matériau), puis vérifie vos données produit par rapport à ces slots avant même de prendre en compte le ton ou les arguments de votre description. Les recherches sur les architectures marchands-agents montrent que cette validation passe souvent par des requêtes SQL déterministes ou des requêtes sur graphe de connaissances, plutôt que par un simple raisonnement approximatif du modèle de langage. Dans une étude d’ablation sur un framework hybride multi-agents, la suppression de cette validation au niveau SQL a fait chuter la conformité à la marque d’un parfait 1.000 à 0.684. En clair : sans règles strictes sur les données, l’agent commence à recommander des produits qu’il aurait dû exclure.
Cette distinction est importante pour prioriser les corrections. Vos données produit remplissent deux fonctions différentes :
- Champs de découverte permettent à votre produit d’entrer dans le pool de candidats : balisage JSON-LD, endpoint de flux public, entrées de sitemap et fichier
llms.txtindiquant aux agents où se trouve votre catalogue. - Champs de sélection déterminent si vous l’emportez une fois dans le pool : prix, disponibilité en temps réel, GTIN ou MPN, AggregateRating et données de marque correspondant exactement à ce que le client a demandé.
Une superbe description attachée à une page sans GTIN et avec un état de stock obsolète perdra face à une fiche produit plus simple mais correctement renseignée. Les attributs conversationnels réduisent l’écart entre les deux. Les recommandations de Google sur les attributs conversationnels pour Merchant Center vous permettent d’ajouter de courtes questions-réponses et des points forts produit qui lèvent les ambiguïtés qu’un agent devrait sinon deviner ou demander au client de préciser. Moins de questions de clarification signifie généralement un accès plus rapide à une recommandation directe.
Que doit contenir votre checklist de données produit ?
Avant de modifier un seul mot du texte marketing, corrigez la couche structurelle. La plupart des marchands font l’inverse : ils peaufinent la phrase et négligent le schéma.
- Uniformisez les titres. Utilisez un titre cohérent par produit sur votre boutique, votre flux et votre balisage schema. Les agents croisent les titres avec la marque et la catégorie ; les incohérences sont interprétées comme des signaux séparés et plus faibles au lieu d’un signal fort unique.
- Placez les faits essentiels au début de la description. Indiquez le matériau, la taille, la compatibilité et le cas d’usage dès la première phrase. Les spécifications de flux OpenAI autorisent des descriptions en texte brut jusqu’à 5 000 caractères, mais les agents accordent le plus de poids aux premières lignes.
- Renseignez les GTIN, MPN et SKU. Ces identifiants permettent à un agent de confirmer que votre produit est bien celui demandé par le client, et pas simplement un produit similaire.
- Synchronisez le prix et la disponibilité en temps réel. Un état de stock obsolète est l’un des moyens les plus rapides d’être discrètement exclu de la sélection.
- Rédigez des descriptions au niveau des variantes. La spécification de flux produit prend en charge les champs et tableaux multimédias par variante ; une variante « bleu, taille M » peut donc inclure ses propres détails précis au lieu d’hériter d’une description générique du produit parent.
- Ajoutez des paires
product_highlightetquestion_and_answerpaires lorsque votre produit présente un véritable point de confusion (taille, compatibilité, ingrédients).
Voici à quoi ressemble concrètement un texte orienté agents :
Vêtement : « Pull ras du cou en laine mérinos pour homme, 100% mérinos australien, lavable en machine à froid. Coupe classique, taille normalement. Disponible en bleu marine, anthracite et écru, du S au XXL. »
Accessoire : « Bracelet de montre en acier inoxydable, attaches rapides 20 mm, compatible avec les boîtiers Fossil et modèles fusion compatibles. Finition brossée, ajustable pour des poignets de 6,5 à 8,5 pouces. »
Produit consommable : « Café en grains torréfaction foncée, sachet de 12 oz, origine unique Guatemala, torréfié chaque semaine. Compatible avec les moutures filtre, cafetière à piston et expresso. »
Chaque exemple commence par le fait dont l’agent a besoin pour faire correspondre un slot, pas par une ambiance.
Conseil pro : Hébergez votre flux JSON à une URL publique et stable, puis référencez-le explicitement dans un fichier llms.txt à la racine de votre site. Les agents recherchent d’abord ce fichier ; une référence absente ou cassée signifie que votre flux, même parfaitement construit, ne sera jamais découvert.
Que doivent corriger en priorité les marchands Shopify et WooCommerce ?
Les deux plateformes partent de bases très différentes ; les gains rapides ne sont donc pas les mêmes selon celle qui fait tourner votre boutique.
Les marchands Shopify devraient :
- Vérifier que le schéma JSON-LD Product est bien rendu sur les pages produit en ligne (Shopify l’injecte par défaut, mais certains thèmes le remplacent ou le suppriment).
- Renseigner les GTIN et métachamps pour chaque SKU, pas seulement pour les produits phares.
- Activer Shopify Catalog ou exposer un flux public afin que les agents accèdent à une version structurée et mappée sur une taxonomie de vos données, plutôt qu’à du texte extrait des pages.
- Ajouter un fichier
llms.txtpointant vers votre flux et votre sitemap.
Les marchands WooCommerce devraient :
- Installer un plugin schema ou JSON-LD, puisque WooCommerce n’injecte pas automatiquement les données structurées comme Shopify.
- Mapper les attributs produit vers les propriétés schema.org appropriées au lieu de les laisser sous forme de champs personnalisés non structurés.
- Exposer un flux JSON stable et lisible par les agents plutôt que de s’appuyer sur l’export produit XML par défaut.
- Ajouter la même référence
llms.txtà la racine du site.
Quelle que soit la plateforme utilisée, maintenez le prix et la disponibilité synchronisés entre votre flux, votre boutique et tous les canaux tiers. Donnez à chaque variante ses propres métadonnées plutôt qu’une description générique commune, et rédigez des textes alternatifs d’image qui décrivent le produit réel, pas seulement un nom de fichier. Selon les comparaisons de plateformes sur l’accès API entre Shopify, BigCommerce et WooCommerce, les agents utilisent les textes alternatifs comme signal de secours lorsque les données structurées sont limitées.
Comment mesurer les taux de recommandation par l’IA ?
Impossible de corriger ce que vous ne voyez pas, et le trafic piloté par des agents se cache dans des outils d’analyse qui n’ont pas été conçus pour le distinguer des crawlers classiques ou des clics référents.
Commencez par taguer les sessions dont la chaîne user-agent correspond à des crawlers IA connus, puis séparez ce trafic du bruit généré par les bots génériques dans votre configuration analytics. Ensuite :
- Lancez une simulation sur votre propre catalogue pour voir quels produits un agent ferait remonter pour les requêtes courantes de votre catégorie, avant de le découvrir à vos dépens après une baisse de trafic.
- Effectuez un test A/B entre deux variantes de description, l’une centrée sur les faits et l’autre sur le marketing, puis comparez laquelle l’agent sélectionne le plus souvent pour la même requête.
- Suivez séparément la conversion en aval des simples visites générées par les agents. Une description qui obtient davantage de recommandations mais fait chuter la conversion nécessite une correction différente d’une description moins recommandée mais qui convertit bien.
Les rescans continus comptent davantage qu’un audit ponctuel. Le comportement des agents évolue avec les mises à jour des modèles, et un framework multi-agents applique un relâchement progressif des contraintes lorsqu’il existe moins de trois correspondances. Votre produit peut donc entrer ou sortir de la sélection sans aucun changement de votre côté. Un outil piloté par simulation qui rescane régulièrement détecte cette dérive avant qu’elle ne devienne un problème de revenus.
Les descriptions rédigées par l’IA convertissent-elles mieux que celles rédigées par des humains ?
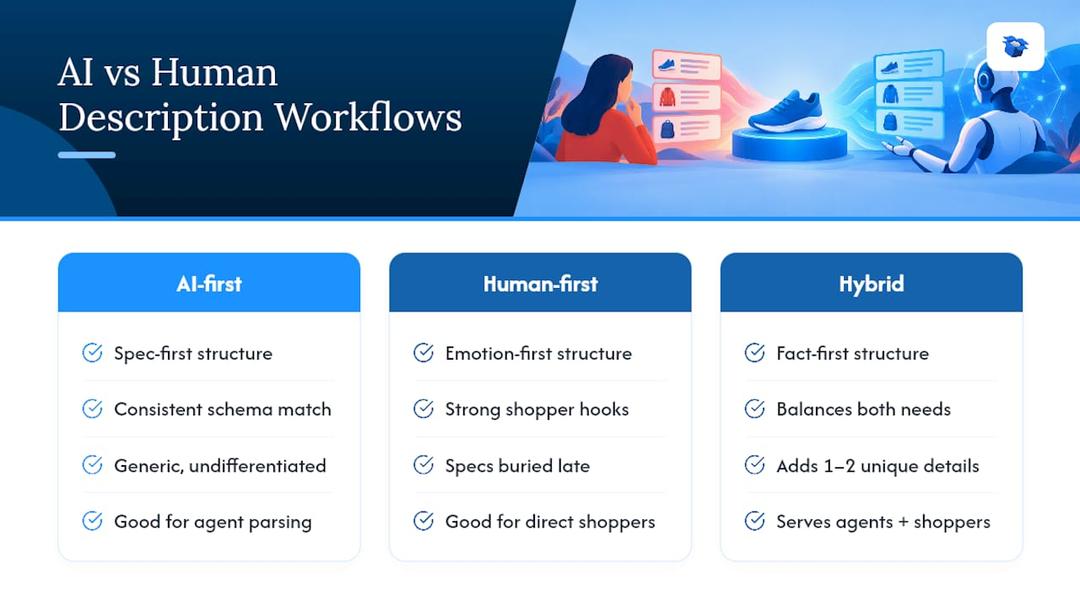
Aucune des deux ne l’emporte clairement, et la formulation même de la question est légèrement trompeuse. Le vrai sujet n’est pas « IA contre humain », mais de savoir si la description correspond à la manière dont un agent analyse le texte, par opposition à la manière dont une personne naviguant rapidement le lit.
Les descriptions rédigées par des humains et optimisées pour des visiteurs en navigation commencent souvent par des accroches émotionnelles et une mise en scène lifestyle. Ce style peut très bien convertir sur une fiche produit consultée directement par une personne. Il fonctionne souvent moins bien avec un agent qui extrait des slots, car l’information dont l’agent a besoin (matériau, dimensions, compatibilité) est enfouie dans le troisième paragraphe au lieu de la première phrase.
Les descriptions générées par l’IA peuvent être rapides et cohérentes sur le plan structurel, en listant proprement les spécifications et en correspondant sans faute aux champs schema. Le risque est le caractère générique. Une description qui semble assemblée depuis un modèle, sans détail distinctif, ne donne à l’agent aucun moyen de différencier votre produit de cinq SKU concurrents au même prix.
Pour le trafic piloté par l’IA, l’approche la plus pragmatique consiste à conserver une structure centrée sur les faits et les spécifications, quel que soit l’auteur du premier brouillon, puis à laisser un éditeur humain ajouter un ou deux détails distinctifs qui rendent réellement le produit différent. Cette approche hybride répond généralement à la fois aux besoins d’analyse de l’agent et au besoin de réassurance du client humain, sans sacrifier l’un ou l’autre.
Quels sont les risques juridiques des descriptions produit rédigées par l’IA ?
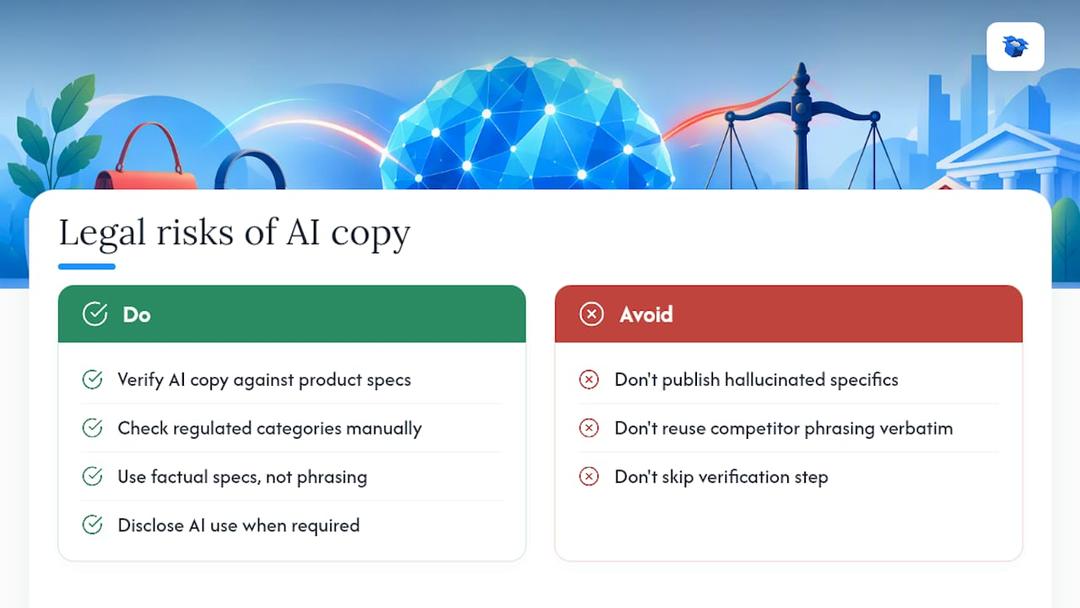
La responsabilité liée à l’exactitude ne disparaît pas simplement parce qu’un modèle de langage a rédigé la phrase. Si une description générée par IA exagère une caractéristique matérielle, une certification ou une promesse de compatibilité, le marchand reste responsable de cette affirmation au regard des lois sur la protection des consommateurs et la publicité dans la plupart des marchés.
Le principal risque pratique est la précision hallucinée. Les outils d’IA peuvent générer avec assurance une composition textile, un pays d’origine ou une certification de sécurité qui ne correspondent pas réellement au produit, car le modèle prédit un texte plausible au lieu de vérifier les données d’inventaire. Faites toujours passer les contenus générés par IA par une étape de vérification par rapport à vos spécifications produit réelles avant publication, en particulier pour les catégories réglementées comme l’alimentaire, les cosmétiques, les compléments alimentaires et l’électronique.
Il existe aussi une considération éthique plus discrète mais réelle autour de la transparence et de l’originalité. Réutiliser mot pour mot le texte d’un concurrent, même via un outil d’IA ayant généré indépendamment un texte similaire, peut soulever des questions de droit d’auteur selon le degré de ressemblance avec un contenu créatif protégé. Tenez-vous-en à vos propres spécifications factuelles et laissez la structure, plutôt que le style, faire le gros du travail ; ce risque disparaît alors en grande partie.
Les vidéos et modèles 3D aident-ils les agents IA à comprendre les produits ?
Le multimédia aide les clients humains à décider, mais sa valeur pour un agent IA dépend entièrement du fait que ce média soit décrit dans un texte que l’agent peut réellement lire. Un modèle 3D ou une vidéo produit sans texte alternatif, légende ou champ structuré media est aujourd’hui invisible pour la plupart des agents, peu importe son rendu visuel pour un humain.
En pratique, cela signifie que la solution n’est pas « ajouter plus de vidéos », mais « décrire la vidéo ». La spécification de flux OpenAI prend en charge des tableaux multimédias aux côtés de l’objet description ; une fiche produit peut donc pointer vers une image, une vidéo et une spécification écrite comme éléments liés d’un même enregistrement, plutôt que comme ressources isolées sur une page.
Pour les marchands qui vendent des produits avec des enjeux de taille, de texture ou de complexité spatiale (meubles, vêtements, matériel), associez une courte vidéo ou un modèle 3D à une légende textuelle expliquant précisément ce qu’il montre : « Vue à 360 degrés montrant les détails des coutures et l’emplacement des poches. » Cette légende devient le pont entre l’élément visuel et la compréhension textuelle de l’agent. Sans légende, le média est pratiquement inexistant pour les agents, même s’il joue un rôle réel pour le client humain qui fait défiler votre page sans jamais regarder votre JSON-LD.
Pourquoi la simulation est plus efficace que les suppositions pour les recommandations IA
La plupart des marchands découvrent qu’un concurrent leur prend l’avantage seulement après une baisse de trafic, ce qui est contre-productif. La simulation inverse cette logique : vous pouvez tester votre catalogue avec des requêtes d’agents réalistes et voir exactement où une contrainte stricte, comme un GTIN manquant ou un indicateur de disponibilité obsolète, vous élimine avant que cela ne vous coûte de vraies commandes.
C’est précisément le problème de diagnostic qu’ecentic a été conçu pour résoudre, en se connectant directement aux boutiques Shopify et WooCommerce afin d’exécuter cette simulation et de faire remonter des corrections prioritaires en langage clair. Des marchands ont signalé des hausses mesurables à la fois des visites générées par l’IA et des ventes en aval après avoir appliqué des corrections similaires, ce qui correspond à la sensibilité de la sélection des agents aux détails structurels abordés dans cet article.
— Xhurian
Lancez une analyse gratuite et découvrez ce que les agents IA voient réellement
Il existe des outils spécifiquement conçus pour répondre à une question : qu’est-ce qui empêche actuellement ChatGPT, Gemini, Claude ou Perplexity de recommander votre produit ? Au lieu de deviner quel champ est défaillant, ces outils simulent de vraies requêtes d’agents sur votre catalogue en ligne, classent les corrections par impact et vous permettent de republier les données corrigées vers des boutiques Shopify ou WooCommerce.

Cette boucle fermée — simulation, diagnostic, publication — le distingue d’un simple outil de rédaction IA. Il ne s’agit pas seulement de générer des phrases plus convaincantes ; il comble des lacunes précises vérifiées par la couche de validation d’un agent marchand, avec une amélioration quantifiable du taux de victoire. Commencez par une analyse gratuite, consultez les corrections prioritaires de votre catalogue, puis décidez si les offres Compete, Scale ou Dominate sont plus adaptées qu’une tarification à l’usage basée sur les commandes attribuées à l’IA. Vous pouvez également découvrir l’ensemble des fonctionnalités d’optimisation des fiches produit avant de vous engager.
FAQ
Que sont exactement les descriptions produit pour agents IA ?
Les descriptions produit pour agents IA sont des enregistrements structurés et centrés sur les faits, combinant description en texte brut, balisage schema et identifiants comme GTIN et MPN, rédigés pour qu’un agent puisse extraire des slots et confirmer une correspondance. Elles diffèrent des textes orientés navigation, car les agents analysent d’abord les champs structurés avant même de prendre en compte le langage persuasif.
Quels champs comptent le plus pour les recommandations produit par IA ?
Le prix, la disponibilité en temps réel, le GTIN ou le MPN et les données de marque pilotent la sélection une fois votre produit découvert, tandis que le balisage JSON-LD et un flux public assurent la découverte initiale. Les champs conversationnels comme product_highlight et question_and_answer, définis dans les recommandations de Google pour Merchant Center, réduisent l’ambiguïté en complément de ces champs essentiels.
Shopify ou WooCommerce gèrent-ils mieux la découvrabilité par l’IA ?
Shopify injecte automatiquement le schéma JSON-LD Product par défaut et propose Shopify Catalog pour le mapping des données structurées, tandis que WooCommerce nécessite généralement un plugin schema et un mapping manuel des attributs, selon les comparaisons de plateformes sur l’accès API pour les agents IA. Les deux plateformes peuvent atteindre un niveau équivalent avec la bonne configuration ; Shopify part simplement avec une longueur d’avance.
Combien coûte Ecentic ?
Ecentic propose un scan d’introduction gratuit, puis des offres payantes avec Compete à partir de 14,90 $ par mois, Scale à 44,90 $ par mois et Dominate à 149 $ par mois. Une option à l’usage applique des frais de performance de 3 % par commande attribuée à l’IA pour les marchands qui préfèrent une tarification basée sur l’utilisation plutôt qu’un abonnement mensuel fixe.
Puis-je tester la manière dont les agents IA voient ma boutique avant de faire des modifications ?
Oui. Les outils de simulation vous permettent d’exécuter des requêtes d’agents réalistes sur votre catalogue existant et de voir quels produits ressortent, lesquels sont exclus et pourquoi, avant de publier la moindre modification. Cette étape de diagnostic transforme les suppositions en liste de corrections priorisées, plutôt qu’en réécriture aveugle de chaque fiche produit.