

Un graphe de connaissances produit est le réseau structuré d’entités produit, d’attributs et de relations qu’interrogent des agents d’achat IA comme ChatGPT, Gemini et Claude lorsqu’ils décident quoi recommander. Vous ne possédez pas entièrement ce graphe — il est réparti entre les fiches des distributeurs, les flux, les avis et les métadonnées — mais vous pouvez l’influencer de façon décisive en rendant vos données lisibles par machine et cohérentes partout où elles apparaissent.
Trois actions rendent aujourd’hui une fiche produit recommandable :
- Déployer un
Product+OfferJSON-LD valide sur chaque page de détail produit (PDP), avec notamment un GTIN ou un MPN canonique, un objet imbriquéBrand, et des valeurs exactes pourAggregateRating. - Harmonisez le prix et la disponibilité pour que les valeurs de votre flux, de votre PDP et de toute fiche marketplace correspondent exactement.
- Renseignez les attributs typés sur lesquels les acheteurs filtrent : taille, matériau, compatibilité, poids et note.
Conseil de pro : Avant d’étendre cela à l’ensemble de votre catalogue, faites passer un SKU phare par une simulation d’agent de bout en bout. Le test sur un seul SKU révèle les modes de défaillance qui se répéteront sur des centaines de produits.
À retenir
Un graphe de connaissances produit pour les agents d’achat IA est un réseau distribué et structuré d’entités produit et d’attributs que les agents interrogent pour décider quoi recommander — et les marchands qui maintiennent des données complètes, cohérentes et lisibles par machine dans leur flux, leur PDP et leurs marketplaces sont ceux qui sont cités.
| Point | Détails |
|---|---|
| Déployer un JSON-LD valide sur chaque PDP | Incluez GTIN/MPN, un objet Brand imbriqué, les champs Offer et AggregateRating avec reviewCount sur chaque page produit. |
| Aligner les données sur tous les canaux | Le prix et la disponibilité doivent être identiques dans votre flux, votre PDP et vos marketplaces — les écarts déclenchent des échecs dans la couche de vérification des agents. |
| Viser un taux de remplissage des attributs de 95 %+ | Le Shopping Graph de Google favorise les marchands qui renseignent les champs obligatoires et recommandés à ce seuil ou au-delà. |
| Simuler avant de passer à l’échelle | Faites passer un SKU pilote dans une simulation d’agent pour repérer les défaillances structurelles avant de déployer des changements sur l’ensemble de votre catalogue. |
| Gouverner par l’automatisation | Utilisez des pipelines de validation des flux, des outils de surveillance du balisage de schéma et des rescans périodiques pour maintenir l’exactitude du graphe à mesure que le stock évolue. |
| Utiliser ecentic pour le diagnostic | La plateforme d’ecentic, pilotée par simulation, identifie les causes de suppression et publie les correctifs directement dans Shopify ou WooCommerce. |
Quels signaux un agent d’achat IA utilise-t-il réellement ?
Les agents ne lisent pas votre page produit comme un humain. Ils exécutent un pipeline retrieve-rank-verify : ils récupèrent des produits candidats, les évaluent par rapport à la requête, puis vérifient si les données sont suffisamment fiables pour être citées. Les problèmes de données catalogue — attributs enfouis dans le texte, GTIN manquants, prix incohérents, doublons de fiches fournisseur — sont la raison la plus fréquente pour laquelle un produit pourtant pertinent pour une requête n’apparaît jamais.
Les signaux à plus forte valeur, par ordre de priorité approximatif :
- GTIN/MPN : l’identifiant principal utilisé par les agents pour faire correspondre une entité produit entre plusieurs sources
- Prix + devise : doivent correspondre entre le flux, la fiche produit et les marketplaces ; les écarts réduisent la vérifiabilité
- Disponibilité:
InStock,OutOfStock, ouPreOrderdans le schéma, avec une mise à jour en quasi temps réel - AggregateRating + reviewCount : les agents accordent beaucoup de poids à la preuve sociale ; une note sans
reviewCountest considérée comme invérifiable - Attributs typés : matériau, poids, dimensions, compatibilité, ingrédients — ces attributs correspondent directement aux filtres des acheteurs
- Images avec métadonnées:
alttexte et les champsnameaident les agents à faire correspondre le contexte visuel aux requêtes - Données d’offre:
priceCurrency,priceValidUntil,seller— autant de champs que les agents utilisent pour vérifier que l’offre est à jour
Un attribut typé vide n’est pas neutre. Les agents évaluent les pages sur trois couches — complétude structurelle, densité sémantique et signaux de confiance — et un champ manquant dans la couche structurelle peut éliminer un produit de l’ensemble de considération avant même le début du classement. Des valeurs contradictoires (par exemple, $49 sur votre PDP et $52 dans votre flux Google Merchant Center) réduisent la vérifiabilité et font reculer le produit.
Conseil pratique : Faites correspondre directement les filtres d’achat de votre catégorie aux champs d’attributs de schéma. Si, dans votre catégorie, les acheteurs filtrent par « matériau », ce champ doit figurer dans votre JSON-LD — pas seulement dans une puce de la description.
Les recherches de simulation ACES confirment que les signaux structurés — position dans la grille, prix, note, recommandations et formulation de la description — influencent la sélection par les agents, et que des réécritures de descriptions dans des simulations contrôlées ont produit des variations de part mesurables sur plusieurs modèles d’agents.
Comment mettre en œuvre des graphes de connaissances produit sur Shopify et WooCommerce
Shopify
Stockez votre GTIN dans le champ Code-barres (natif) ou dans un custom.gtin métachamp. Pour les attributs typés supplémentaires — matériau, compatibilité, poids — utilisez des métachamps sous un espace de noms product avec des valeurs typées (single_line_text_field ou number_decimal). Le modèle product.json de votre thème doit générer un bloc <script type="application/ld+json"> qui injecte ces valeurs de métachamps dans un objet de schéma Product valide.
Une structure JSON-LD minimale mais complète ressemble à ceci :
{
  "@context": "https://schema.org/",
  "@type": "Product",
  "name": "Merino Wool Crew Neck Sweater",
  "sku": "MW-CREW-M-NAVY",
  "gtin13": "0123456789012",
  "brand": { "@type": "Brand", "name": "YourBrand" },

  "offers": {
    "@type": "Offer",
    "price": "89.00",
    "priceCurrency": "USD",
    "availability": "https://schema.org/InStock",
    "priceValidUntil": "2026-12-31"
  },
  "aggregateRating": {
    "@type": "AggregateRating",
    "ratingValue": "4.7",
    "reviewCount": "312"
  }
}
Déployer cette structure sur chaque fiche produit est l’action la plus rentable pour être éligible à ChatGPT Shopping. Pour les variantes, conservez une entité canonique Product et imbriquez les variantes sous forme d’objets hasVariant plutôt que de publier des blocs de schéma séparés qui dupliquent le parent — les schémas dupliqués font partie des principaux pièges abordés ci-dessous.
WooCommerce
Utilisez le panneau intégré de WooCommerce Attributs produit pour les valeurs typées (matériau, taille, compatibilité). Pour le GTIN/MPN, ajoutez un champ personnalisé via un plugin comme Yoast SEO Premium ou une metabox personnalisée légère. Pour la sortie JSON-LD, configurez soit un plugin de schéma (Rank Math ou Schema Pro prennent tous deux en charge Product + Offer) soit insérez manuellement un bloc <script> dans le modèle single-product.php.
Notes sur les flux et les robots d’exploration
- Soumettez votre flux produit à Google Merchant Center et actualisez-le toutes les heures pour les catégories concurrentielles. Le Shopping Graph de Google vise des taux de remplissage des attributs supérieurs à 95 % pour les champs obligatoires et traite des milliards de mises à jour par heure — les marchands qui passent sous ce seuil perdent en visibilité.
- Ajoutez un fichier
llms.txtà la racine de votre domaine répertoriant l’URL de votre flux et votre sitemap afin que les robots d’agents puissent découvrir vos points d’accès de données structurées. - Vérifiez
robots.txtpour confirmer que vous n’avez pas bloqué accidentellement GPTBot, Googlebot-Shopping ou d’autres robots d’agents.
Conseil pratique : *Placez les attributs importants pour l’acheteur dans les 200 premiers caractères de votre description produit.
| Champ | Emplacement Shopify | Emplacement WooCommerce |
|---|---|---|
| GTIN/MPN | Champ Code-barres ou custom.gtin métachamp |
Champ personnalisé ou Yoast SEO Premium |
| Matériau/Attributs | Métachamps produit (product espace de noms) |
Panneau Attributs produit |
| Sortie JSON-LD | Thème product.json de thème |
Rank Math, Schema Pro ou single-product.php |
| Soumission du flux | Application Google & Meta Sales Channels | Plugin Google Listings & Ads |
| Synchronisation des disponibilités | Inventaire suivi dans l’administration Shopify | Gestion des stocks WooCommerce |
Comment tester si des agents IA recommanderont vos produits ?
Tester avant de passer à l’échelle est ce qui distingue les marchands qui obtiennent des résultats en quelques semaines de ceux qui passent des mois à deviner. Trois méthodes fonctionnent en pratique :
- Prompts d’agents contrôlés : rédigez 5 à 10 requêtes correspondant à vos principales références SKU (« meilleur pull en laine mérinos à moins de 100 $ pour temps froid ») et testez-les avec ChatGPT, Gemini et Perplexity. Notez quels produits apparaissent et si le vôtre en fait partie.
- Simulation d’agents via Ecentic : le Playground UCP d’Ecentic exécute des simulations structurées sur votre boutique, attribue un score à chaque SKU selon la complétude des attributs, la validité du schéma et la vérifiabilité — et signale précisément quels champs provoquent la suppression.
- Réécritures A/B des descriptions : réécrivez la description d’un SKU pour mettre les attributs typés en avant, puis relancez la simulation. Les recherches ACES montrent que les modifications de description produisent des variations mesurables de sélection, même si l’ampleur de l’effet varie selon le modèle d’agent.
Suivez ces KPI chaque semaine :
| KPI | Ce que cela mesure | Objectif |
|---|---|---|
| Taux de sélection par l’IA | % de requêtes simulées renvoyant votre SKU | Amélioration semaine après semaine |
| Sessions générées par des agents | Sessions attribuées à des références d’agents IA | Suivi via UTM + page de destination |
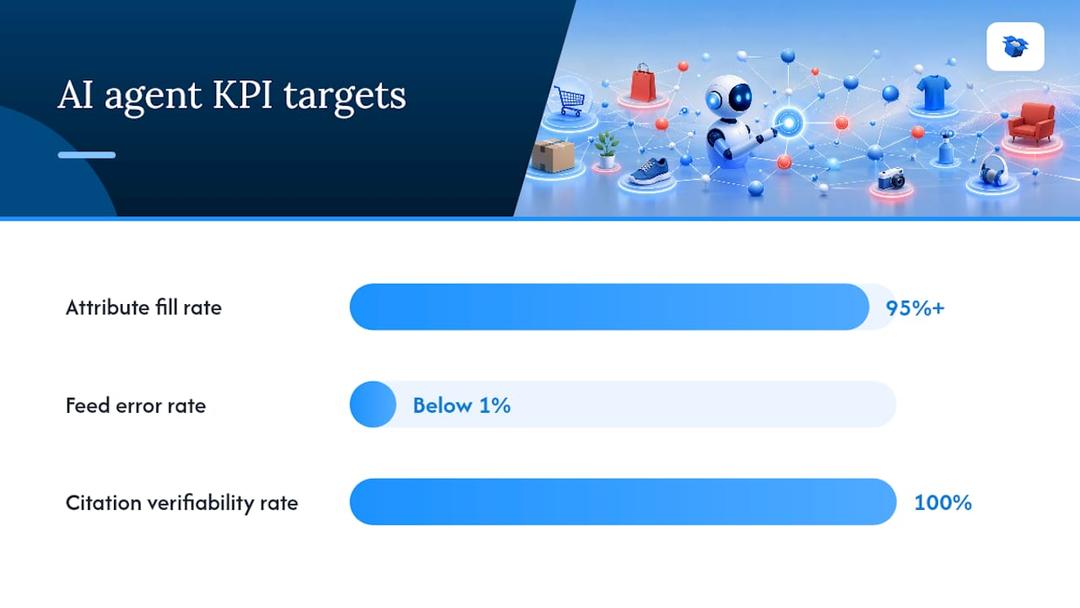
| Taux de remplissage des attributs | % de champs obligatoires renseignés | 95%+ |
| Taux d’erreur du flux | Erreurs signalées dans Google Merchant Center | Inférieur à 1 % |
| Taux de vérifiabilité des citations | % de citations d’agents avec des données correspondantes sur la page | 100% |
Pour l’attribution, marquez le trafic de référence des agents avec des paramètres UTM (utm_source=chatgpt, utm_medium=ai_agent) et utilisez ecentic pour le suivi du trafic des agents afin de distinguer les sessions générées par l’IA des sessions organiques. Validez votre JSON-LD avec le test des résultats enrichis de Google et le validateur de Schema.org avant et après toute modification du schéma.
Que faut-il corriger en premier ? Une feuille de route sur 30/90 jours
Priorisez selon le rapport impact/effort : corrigez d’abord les problèmes qui bloquent les SKU générant le plus de revenus, et commencez par les modifications ne nécessitant aucun code.
Jours 1 à 30 (corrections urgentes) :
- Corrigez toutes les erreurs de flux dans Google Merchant Center (écarts de prix, GTIN manquants, conflits de disponibilité)
- Ajoutez des GTIN/MPN à vos 20 principaux SKU par chiffre d’affaires
- Validez le JSON-LD de ces mêmes SKU avec le test des résultats enrichis
- Confirmez que les robots d’agents ne sont pas bloqués dans
robots.txt - Exécutez une simulation pilote sur votre SKU à plus forte marge
Jours 31 à 90 (à l’échelle du catalogue) :
- Étendez la couverture des attributs typés à l’ensemble du catalogue (matériau, poids, compatibilité)
- Mettez en œuvre une structure
hasVariantpour éliminer les schémas dupliqués sur les fiches produit de variantes - Mettez en place une actualisation horaire du flux pour les produits concurrentiels en stock.
- Ajoutez le schéma
FAQPageaux 10 principales fiches produit. Les paires de schémas FAQ figurent parmi les formats les plus citables pour les réponses des agents. - Exécutez une analyse complète du catalogue avec Ecentic et appliquez la liste de corrections priorisées
| Niveau de priorité | Critères SKU | Responsable | Calendrier |
|---|---|---|---|
| Niveau 1 | Marge élevée + forte intention de recherche + erreurs de flux | Développement + merchandising | Jours 1 à 14 |
| Niveau 2 | Meilleurs revenus, attributs typés manquants | Merchandising + PIM | Jours 15 à 30 |
| Niveau 3 | Remplissage des attributs sur tout le catalogue et nettoyage des variantes | Développement + PIM | Jours 31 à 90 |
Comment gouverner et automatiser vos données produit
La gouvernance est ce qui maintient le graphe exact après le lancement. Sans elle, une mise à jour de prix dans votre ERP qui ne se propage pas à votre flux crée un échec de vérifiabilité en quelques heures.
- Désignez une source unique de vérité pour chaque attribut — généralement votre PIM ou ERP — et documentez quel système est responsable du prix, de la disponibilité et de chaque attribut typé.
- Mettez en place un pipeline de validation des flux qui vérifie les GTIN manquants, les écarts de prix et les champs obligatoires vides avant chaque soumission de flux.
- Configurez des contrôles de schéma (une simple exploration planifiée de vos principales fiches produit) afin d’être alerté lorsqu’un JSON-LD disparaît après une mise à jour du thème.
- Effectuez des analyses périodiques — la fonctionnalité d’optimisation automatique d’Ecentic le fait en continu — et déclenchez des alertes pour tout SKU dont le taux de remplissage des attributs passe sous 95 %.
- Pour les données enrichies par les fournisseurs (ingrédients, certifications, listes de compatibilité), associez un horodatage de fraîcheur et un identifiant de source à chaque attribut afin que les agents puissent vérifier la provenance.
Conseil pratique : Lorsque vous récupérez des données depuis des flux fournisseurs, n’écrasez jamais votre GTIN canonique ou votre nom de marque avec une variante fournisseur. Conservez vos valeurs canoniques et traitez les données fournisseurs uniquement comme un enrichissement.
Pièges courants qui poussent les agents IA à ignorer vos produits
GTIN/MPN manquants. Sans identifiant canonique, les agents ne peuvent pas résoudre l’entité produit entre différentes sources. Correctif : ajoutez le GTIN dans le champ Code-barres de Shopify ou dans un champ personnalisé de WooCommerce, puis vérifiez qu’il apparaît dans vos données JSON-LD gtin13.
Explosion des variantes avec schémas dupliqués. Publier un bloc de schéma Product distinct pour chaque variante (couleur, taille) crée des dizaines d’entités quasi identiques que les agents considèrent comme du bruit. Correctif : un seul Product canonique avec des enfants hasVariant.
Disponibilités obsolètes ou écarts de prix. Un produit affiché comme InStock dans le schéma mais « Rupture de stock » sur la page, ou à 89 $ dans le JSON-LD et 94 $ dans le flux, déclenche un échec de la couche de vérification. Correctif : synchronisez la disponibilité et le prix depuis une source unique en temps réel et validez avec une exploration planifiée.
AggregateRating sans reviewCount. Un ratingValue seul est invérifiable. Correctif : incluez toujours reviewCount comme entier typé aux côtés de ratingValue.
Robots d’agents bloqués. Un Disallow: / pour GPTBot ou Googlebot-Shopping dans robots.txt rend l’ensemble de votre boutique invisible pour ces agents. Correctif : auditez robots.txt et ajoutez explicitement les robots d’agents à la liste blanche.
Attributs typés vides. Un produit sans material, weight, ou compatibility ne peut pas correspondre aux requêtes basées sur des filtres. Correctif : renseignez au minimum les attributs utilisés comme filtres par les acheteurs de votre catégorie, en commençant par vos SKU de niveau 1.
Après chaque correction, relancez vos prompts d’agents contrôlés et la simulation d’Ecentic pour confirmer que le SKU est passé de supprimé à citable.
Quels résultats les marchands peuvent-ils raisonnablement attendre ?
Les résultats pilotes — un SKU unique ou un petit groupe — montrent généralement des changements mesurables des taux de sélection par les agents dans les 2 à 6 semaines suivant la mise en œuvre d’un schéma valide et la correction des erreurs de flux.
KPI métier à surveiller :
- Part des sessions générées par des agents dans le trafic total (à suivre chaque semaine après activation du marquage)
- Taux de conversion sur les pages recevant des références d’agents (ces visiteurs arrivent souvent avec une intention d’achat plus forte)
- Valeur moyenne des commandes attribuées aux agents
- Baisse du taux d’erreur du flux dans Google Merchant Center (indicateur indirect de la qualité globale des données)
Les marchands qui mettent en œuvre les bonnes pratiques de schéma et de flux avec des intégrations UCP signalent des augmentations mesurables des revenus attribués aux agents dans les premiers groupes d’adoption. Nuance importante : les pondérations des modèles d’agents changent à chaque cycle de mise à jour ; un produit bien classé à un instant donné peut nécessiter une nouvelle optimisation après une version majeure du modèle. Une surveillance continue — et non une correction ponctuelle — est ce qui permet de maintenir les gains.
Confidentialité des données et conformité lors de la structuration des données produit pour les agents IA
La structuration des données produit pour les agents IA concerne principalement des attributs produit accessibles publiquement — prix, disponibilité, matériaux, notes — ce qui réduit l’exposition en matière de confidentialité par rapport aux contextes impliquant des données consommateurs. Cela dit, quelques considérations de conformité s’appliquent.
Si vos descriptions produit ou vos avis incluent des informations personnellement identifiables (par exemple le nom complet d’un évaluateur lié à un problème de santé), supprimez ces données avant qu’elles n’entrent dans votre flux structuré ou votre JSON-LD. En vertu du RGPD dans l’UE et de cadres similaires ailleurs, les données personnelles présentes dans des données structurées accessibles publiquement restent soumises aux droits des personnes concernées.
Pour les marchands vendant dans des catégories réglementées — alimentation, compléments alimentaires, dispositifs médicaux, cosmétiques — les données sur les ingrédients et les allégations de votre graphe de connaissances doivent respecter les réglementations d’étiquetage de chaque marché où vous vendez. Un ingrédient listé dans votre schéma qui contredit votre étiquette physique crée à la fois un risque de conformité et un échec de vérifiabilité pour les agents. Gardez les allégations du schéma alignées avec votre contenu produit approuvé.
Enfin, si vous utilisez des services tiers d’enrichissement de données pour renseigner les attributs, vérifiez que les accords de partage de données de ces fournisseurs autorisent une utilisation en aval dans des données structurées visibles publiquement. C’est une lacune fréquente lors de l’exploitation de bases de données fournisseurs.
Comment gérer les fiches produit multilingues et multidevises
Les agents IA sont de plus en plus multilingues, et un produit proposé uniquement en anglais avec un prix en USD sera moins performant dans les requêtes d’acheteurs français, allemands ou japonais, même si le produit est expédié dans le monde entier.
L’approche la plus propre : maintenir une entité Product distincte par locale, avec des champs spécifiques à la langue pour name, description, et des attributs typés, ainsi qu’un bloc Offer contenant les valeurs correctes de priceCurrency et price. Dans Shopify, Markets gère nativement les prix propres à chaque locale ; associez-le à des métachamps propres à chaque locale pour les valeurs d’attribut traduites. Dans WooCommerce, des extensions comme WPML ou Polylang gèrent les contenus traduits, et WooCommerce Multilingual prend en charge les prix propres à chaque devise.
Pour votre flux, soumettez des flux complémentaires spécifiques à chaque langue à Google Merchant Center plutôt que de vous appuyer sur la traduction automatique. Les valeurs d’attributs traduites automatiquement échouent souvent aux vérifications de vérifiabilité des agents parce que le texte traduit ne correspond pas au contenu affiché sur la page dans cette langue.
Règle pratique : ne mélangez jamais plusieurs devises dans un même bloc Offer . Si un produit est disponible à la fois en USD et en EUR, publiez deux objets Offer distincts avec des champs eligibleRegion explicites, ou utilisez priceCurrency limité au marché concerné.
Benchmarks ecommerce pour la visibilité auprès des agents d’achat IA
Les benchmarks concrets dans ce domaine sont encore en cours d’émergence, mais certains signaux directionnels méritent d’être connus. Le framework de simulation ACES — qui a testé des signaux structurés sur plusieurs modèles d’agents en 2025 — a constaté que la sensibilité au prix et la sensibilité aux notes produisaient toutes deux des effets statistiquement directionnels sur la sélection par les agents, et que les réécritures de descriptions modifiaient les parts dans des expériences contrôlées. L’ampleur des effets variait selon le modèle et l’instantané observé, ce qui explique pourquoi les simulations continues comptent davantage qu’un test unique.
Du côté de la qualité des données, le Shopping Graph de Google traite plus de 2 milliards de mises à jour par heure sur plus de 50 milliards de fiches.
Pour les marchands ayant utilisé l’optimisation pilotée par simulation d’Ecentic, le schéma observé est cohérent : corriger d’abord les erreurs de schéma et les lacunes d’attributs sur les principaux SKU, puis étendre à l’ensemble du catalogue, produit l’amélioration mesurable la plus rapide des taux de sélection par les agents. L’alignement SEO ecommerce issu de ce travail tend également à améliorer les classements dans la recherche traditionnelle comme effet secondaire, puisque les mêmes données structurées utilisées par les agents alimentent aussi les résultats enrichis de Google.
Aligner vos actions SEO ecommerce avec des données structurées destinées aux agents revient de plus en plus au même travail : les signaux qui rendent un produit citable par un agent IA recoupent largement ceux qui permettent d’obtenir un résultat enrichi dans la recherche traditionnelle.
Tendances futures qui façonnent l’optimisation des graphes de connaissances produit
Trois évolutions méritent d’être anticipées dès maintenant.
Boucles d’achat pilotées par des agents IA. Le mode shopping de ChatGPT et les AI Overviews de Google sont les premières versions d’une évolution plus large : des agents qui ne se contentent pas de recommander, mais réalisent les achats de manière autonome. Le Universal Commerce Protocol (UCP) devient la norme émergente pour exposer directement aux agents les données produit, les prix et les points d’accès au paiement. Les marchands qui construisent dès maintenant des points d’accès compatibles UCP disposeront d’un avantage structurel à mesure que les achats agentiques se développeront.
Compréhension produit multimodale. Les agents évaluent de plus en plus les images produit, les vidéos et les ressources 3D en plus des attributs textuels. Le texte alt alt et le schéma structuré ImageObject sont déjà des signaux ; attendez-vous à ce que l’extraction d’attributs visuels (couleur, forme, texture à partir des images) devienne un facteur de classement à mesure que les modèles de vision progressent.
Mises à jour du graphe en temps réel. À mesure que les index d’agents se rafraîchissent plus fréquemment, la pénalité liée aux données obsolètes augmente. Les marchands qui exécutent des mises à jour de flux par lot une fois par jour perdront progressivement du terrain face à ceux qui synchronisent en temps réel ou quasi réel. Les modèles d’automatisation de gouvernance décrits plus haut — pipelines de validation des flux, contrôles de schéma, réécritures vers le PIM — constituent l’infrastructure nécessaire pour rester compétitif dans cet environnement.
Les AI Overviews de Google montrent déjà comment l’empreinte éditoriale et les données structurées interagissent : les produits présentant des données cohérentes et vérifiables sur plusieurs sources apparaissent plus souvent dans les panneaux générés par l’IA. Cette tendance va s’accentuer à mesure que les index d’agents gagneront en maturité.
Pourquoi simuler avant d’optimiser
La plupart des marchands abordent les données produit de la mauvaise manière : ils optimisent d’abord le contenu, puis vérifient ensuite si les agents réagissent, lorsqu’ils le font. Cette séquence gaspille des efforts, car les modifications du contenu ont un effet plus faible et moins prévisible sur la sélection par les agents que les corrections structurelles.
L’approche la plus solide consiste à simuler d’abord. Exécutez une requête d’agent sur votre principal SKU avant de modifier un seul mot du contenu. Si le produit n’apparaît pas, le problème est presque toujours structurel — GTIN manquant, robot bloqué, écart de prix, attribut typé vide. Corrigez ces points, relancez la simulation, puis envisagez seulement ensuite de retravailler la description.
C’est important parce que les marchands qui signalent les résultats les plus rapides ne sont pas ceux qui ont les meilleurs rédacteurs. Ce sont ceux qui ont traité leurs données produit comme une infrastructure et corrigé la couche lisible par les machines avant de se soucier de persuasion. La simulation rend cette séquence visible et mesurable plutôt que basée sur des suppositions.
Autre point que la plupart des guides minimisent : les agents ne récompensent pas seulement l’exhaustivité, ils récompensent la cohérence. Un produit avec une note de 4,7 étoiles dans le schéma et de 4,2 étoiles sur la page n’est pas seulement incorrect — c’est un échec de signal de confiance qui peut supprimer entièrement le produit. Chaque incohérence entre votre schéma, votre flux et votre contenu de page est une raison pour un agent de vous ignorer au profit d’un concurrent dont les données sont cohérentes.
ecentic diagnostique et corrige votre visibilité auprès des agents d’achat IA
La plupart des marchands découvrent leurs problèmes de données produit seulement après avoir été ignorés par un agent. ecentic inverse cette logique : connectez votre boutique Shopify ou WooCommerce, et le moteur de simulation d’ecentic teste vos principaux SKU avec ChatGPT, Gemini, Claude et Perplexity avant que vous ne perdiez une seule vente.

La plateforme fournit des diagnostics en langage clair — exactement quels attributs manquent, quels champs de schéma sont invalides et quels concurrents remportent les requêtes sur lesquelles vous devriez apparaître. Ensuite, ecentic génère des suggestions de réécriture et publie directement les corrections sur votre boutique en un clic. Les analyses d’attribution des agents suivent ensuite si ces corrections se traduisent par des sessions et des revenus mesurables générés par les agents. Commencez par un scan gratuit de vos principaux SKU sur la page d’optimisation des fiches produit d’ecentic ou explorez la suite complète d’outils IA pour l’ecommerce pour voir ce qui réduit votre visibilité actuellement.
Sources
- Comment fonctionnent les agents d’achat IA : récupération, classement et vérification · Claro
- Graphes de connaissances produit : le nouveau cerveau du commerce IA
- Comment les agents d’achat IA découvrent les produits : guide technique de l’optimisation des données produit | Blog Hexagon
- Comment optimiser les pages produit pour les agents IA (guide 2026)
FAQ
Qu’est-ce qu’un graphe de connaissances produit pour les agents d’achat IA ?
Il s’agit du réseau structuré d’entités produit, d’attributs et de relations que des agents IA comme ChatGPT et Gemini interrogent lorsqu’ils génèrent des recommandations d’achat. Les marques l’influencent en publiant des données cohérentes et lisibles par les machines sur leurs fiches produit, leurs flux et leurs fiches marketplace.
Quels champs de schéma comptent le plus pour l’éligibilité des agents IA ?
Les données Product + Offer JSON-LD valides avec un GTIN ou un MPN, un objet imbriqué Brand, priceCurrency, availability, et AggregateRating avec une valeur typée pour reviewCount sont les champs les plus déterminants pour faire entrer vos produits dans les sélections des agents.
À quelle fréquence dois-je actualiser mon flux produit ?
Visez des mises à jour horaires dans les catégories concurrentielles. Le Shopping Graph de Google traite des milliards de mises à jour par heure, et les marchands qui utilisent des mises à jour quotidiennes par lot perdent du terrain face à ceux qui synchronisent en quasi temps réel.
Comment savoir si un agent IA ignore mes produits ?
Exécutez des prompts d’agents contrôlés avec des requêtes correspondant à vos principaux SKU, puis vérifiez si vos produits apparaissent. Les outils de simulation d’Ecentic automatisent ce processus et signalent précisément quels attributs ou champs de schéma provoquent la suppression.
Combien de temps avant de voir des résultats après avoir corrigé mes données produit ?
Les améliorations sur des SKU pilotes montrent généralement des changements mesurables des taux de sélection par les agents dans un délai de 2 à 6 semaines.