

Les systèmes d’IA qui recommandent des produits aujourd’hui s’appuient sur quatre couches : les flux marchands et les API, les données structurées sur les fiches produit, les fiches produit des détaillants et des places de marché, ainsi que les avis, auxquels s’ajoute le comportement des acheteurs sur les canaux propriétaires. Les marchands doivent immédiatement donner la priorité à trois points : un catalogue canonique avec des identifiants stables, des prix et disponibilités étroitement synchronisés, et des descriptions produit claires et riches en attributs. Ensuite, les tests par prompts confirment si ces corrections modifient réellement ce qu’un agent d’achat IA recommande.
À retenir :
- Les flux marchands doivent inclure des identifiants stables, des prix synchronisés et des attributs produit riches pour éviter les incohérences de recommandation et renforcer la confiance de l’IA.
- Le balisage de données structurées doit être rendu côté serveur, à jour et correspondre au contenu visible de la page pour garantir une compréhension précise par l’IA.
- Des tests réguliers avec des prompts d’achat et des simulations réalistes d’IA aident à identifier les points où les données produit ou les descriptions provoquent des échecs de recommandation.
- Maintenir une source unique de vérité et faire correspondre en permanence les données du flux, de la page et du paiement limite les baisses de recommandation dues à des informations obsolètes ou incohérentes.
- Les signaux comportementaux first-party et les avis soutiennent la personnalisation, mais ne peuvent pas primer sur les faits produit de base comme l’état du stock ou le prix, qui exigent des données de flux fiables.
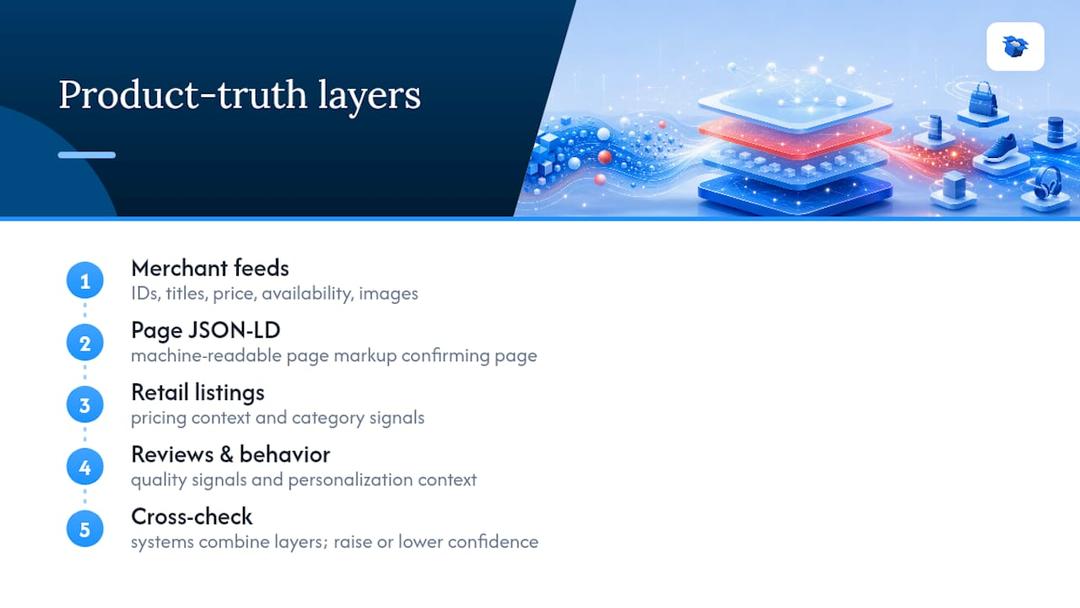
Vue d’ensemble : les couches de vérité produit ingérées par les agents d’achat IA
Un agent d’achat IA ne voit jamais votre boutique comme un acheteur. Il voit un assemblage d’enregistrements et doit décider auxquels faire confiance. Chaque couche apporte une partie différente de la vérité.
Les flux marchands et les API portent les données fondamentales : identifiants stables, titres, descriptions, prix, devise, disponibilité, variantes, images et informations vendeur. C’est la couche que la spécification commerce d’OpenAI considère comme la source principale des informations produit dans ChatGPT.
Les données structurées des pages produit (balisage JSON-LD) donnent aux robots une version lisible par machine de ce qui est déjà visible sur la page et servent de seconde confirmation des informations déclarées dans le flux.
Les fiches produit des détaillants et marketplaces apportent un contexte tarifaire et des signaux de catégorie, notamment lorsqu’un produit apparaît sur plusieurs canaux.
Les avis et les données comportementales first-party complètent le tableau avec des signaux de qualité et un contexte de personnalisation, sans jamais remplacer des faits concrets comme l’état du stock.
Les systèmes qui recommandent des produits combinent ces quatre couches et les recoupent. Quand votre flux indique « en stock » et que le balisage de votre page indique « rupture de stock », ce désaccord ne fait pas que perturber l’algorithme. Il réduit la confiance dans l’ensemble de votre fiche produit, selon la spécification des données produit de Google.
Bonnes pratiques des flux produit et des API que les marchands doivent suivre
Votre flux est l’actif à plus fort impact que vous contrôlez, et il doit contenir des champs précis, pas des données vaguement complètes.
- Incluez les champs d’identité essentiels : identifiant stable ou SKU, titre, description, lien canonique, URL d’image, prix, devise, état de disponibilité, attributs de variante et marque.
- Respectez le schéma flat-file d’OpenAI là où vous voulez être éligible dans ChatGPT. La spécification produit Agentic Commerce attend au minimum id, title, description, link, image_link, availability, price et brand.
- Définissez les indicateurs d’éligibilité de manière intentionnelle.
is_eligible_searchetis_eligible_checkoutsont deux paramètres distincts. Une fiche produit parfaitement complète n’apparaîtra pas dans ChatGPT si ces indicateurs ne sont pas définis. - Respectez les exigences principales de Google Merchant Center : identifiant produit stable, lien de page de destination fonctionnel, prix et disponibilité exacts, ainsi que champs de catégorie et d’identifiant corrects.
- Gardez des valeurs identiques entre le flux, la page de destination et le paiement. Les divergences à ce niveau sont l’une des causes les plus fréquentes de refus ou de perte silencieuse de recommandations.
Conseil pro : Chaque semaine, choisissez 20 SKU au hasard et comparez leurs données dans votre flux, sur les pages produit et dans le parcours de paiement. La plupart des écarts s’installent discrètement, au fil des mises à jour de prix ou des synchronisations de stock. Personne ne les remarque jusqu’à ce qu’un agent IA annonce un prix erroné à un acheteur.
Concernant la fréquence : les catégories à forte volatilité (habillement avec réassorts fréquents, électronique avec tarification dynamique) nécessitent des mises à jour le jour même ou horaires. Les catégories plus stables peuvent tolérer des synchronisations quotidiennes, mais jamais au-delà.
Données structurées sur les pages produit : champs Schema.org et pièges fréquents
Les données structurées sont la manière de transmettre à un système IA les faits exacts que vous voulez lui faire utiliser, dans un format qui ne lui laisse rien à deviner.
Les propriétés Schema.org essentielles pour toute page produit incluent :
Productavec name, description et imageOfferimbriqué à l’intérieur, contenantprice,priceCurrency, etavailabilitygtin(ou la variante GTIN appropriée) pour l’identification produit mondialeskupour votre identifiant interneitem_group_idpour relier entre elles les variantes d’un même produit
Les recommandations de Google sur les attributs de données structurées pris en charge sont explicites : ce balisage doit être présent dans le HTML rendu côté serveur, et non injecté uniquement après l’exécution du JavaScript côté client. De nombreux robots et agents n’exécutent jamais votre JavaScript, ce qui rend un balisage uniquement JS pratiquement invisible pour eux.
Le piège le plus fréquent n’est pas l’absence de balisage. C’est un balisage qui était correct puis s’est discrètement désynchronisé de la page visible, généralement après un changement de prix ou une promotion qui n’a mis à jour que l’affichage front-end.
Conseil pro : Réussir un validateur de schéma indique seulement que la syntaxe est correcte. Cela ne dit rien sur la manière dont une IA décrit réellement votre produit. Associez les contrôles du validateur à de vrais audits de prompts pour voir comment le SKU est décrit.
Avis, signaux vendeur et données comportementales first-party
Les avis et les données comportementales influencent la façon dont un système IA personnalise une recommandation, mais ils jouent un rôle de soutien, pas un rôle fondamental.
- Les avis apportent une perception de qualité et des preuves d’usage, le type de contexte qui aide un agent à décider qu’un produit en stock correspond au besoin exprimé par un acheteur.
- Les données comportementales first-party recueillies avec consentement permettent aux plateformes d’adapter les recommandations au contexte, à l’historique d’achat ou aux habitudes de navigation, selon les recherches de Klaviyo sur l’IA et le comportement des consommateurs.
- Les deux types de données doivent être reliés à un identifiant SKU stable, sinon les éléments issus des avis et la fiche produit actuelle se désynchronisent avec le temps.
- Ni les avis ni les signaux comportementaux ne doivent remplacer votre flux canonique de prix ou de stock. Si un avis cinq étoiles dit qu’un produit est une excellente affaire et que votre flux indique une rupture de stock, c’est le flux qui prévaut.
Fraîcheur, synchronisation et identité : règles pour éviter les pertes de recommandations
Des données de prix et de disponibilité obsolètes ne font pas qu’agacer les acheteurs. Elles poussent les systèmes IA à cesser discrètement de recommander un SKU plutôt que de risquer une mauvaise réponse.
- Faites correspondre en permanence les valeurs du flux, des données structurées, de la page de destination et du paiement. Selon les recommandations de Google pour Merchant Center, toute incohérence augmente le risque de refus ou de perte de visibilité.
- Ne renommez jamais les SKU et ne les réattribuez pas en cours de route. La dérive d’identité, lorsqu’un identifiant change lors d’une refonte de site ou d’une migration de catalogue, est l’une des façons les plus courantes par lesquelles les marchands coupent le lien entre l’historique de prix d’un produit, ses avis et sa fiche produit actuelle.
- Modélisez explicitement les variantes à l’aide de
item_group_idplutôt que de laisser les variations de couleur ou de taille exister comme des produits séparés et déconnectés. - Adaptez la fréquence des mises à jour à la volatilité. Les stocks qui évoluent rapidement nécessitent des contrôles horaires ; les articles de catalogue stables peuvent fonctionner sur un cycle quotidien.
- Testez les cas limites, pas seulement les scénarios idéaux. Les états de précommande, de réapprovisionnement et de rupture de stock nécessitent le même niveau de vérification que les fiches produit standard en stock.
Conseil pro : Créez un petit tableau de bord qui signale tout SKU dont le prix du flux et celui de la page diffèrent depuis plus de deux heures. Cet écart est presque toujours le premier signe qu’un problème est survenu en amont.
Tests et mesure : prompts, simulations et attribution du trafic
Un validateur de schéma au vert ne dit rien sur le fait que ChatGPT ou Gemini recommande réellement votre produit lorsqu’un vrai acheteur pose une question. C’est pourquoi les tests doivent inclure la sortie réelle de l’IA, et pas seulement la structure de données sous-jacente.
- Créez un ensemble de prompts représentatif. Incluez des prompts de catégorie (« meilleures chaussures de running pour pieds plats »), des prompts d’usage, des prompts avec contrainte budgétaire et des prompts de comparaison directe avec les concurrents.
- Exécutez les prompts dans des simulations d’agents et enregistrez si votre SKU est mentionné, si le prix annoncé correspond à la réalité et si le positionnement correspond au besoin exprimé par l’acheteur.
- Identifiez le trafic attribué à l’IA dans vos analyses et suivez le taux de conversion séparément du trafic organique et du trafic payant.
- Relancez des scans régulièrement. Les recommandations évoluent selon le prompt, le marché et l’état du stock ; un bon résultat aujourd’hui ne garantit donc pas le même résultat la semaine prochaine.
Une seule réponse IA favorable n’est pas un rapport de classement. Les résultats varient selon la formulation du prompt, la langue, le marché et le stock actuel, c’est précisément pourquoi l’analyse de NIQ sur l’achat piloté par l’IA présente le véritable changement stratégique comme le passage de la part de recherche à la part de recommandation, quelque chose qui doit être mesuré de manière répétée, et non une seule fois.
Checklist actionnable : étapes prioritaires pour les 7 à 30 prochains jours
- Auditez votre catalogue pour vérifier la stabilité des identifiants et corrigez toute relation de variante cassée ou dupliquée.
- Synchronisez les valeurs du flux, de la page et du paiement pour le prix, la devise et la disponibilité.
- Corrigez le balisage JSON-LD afin qu’il soit rendu côté serveur et corresponde au contenu visible de la page.
- Enrichissez les descriptions produit trop légères avec des attributs concrets et un langage orienté cas d’usage.
- Exécutez un test de simulation de base sur vos 20 principaux SKU pour observer le comportement actuel des recommandations IA.
| Tâche | Responsable habituel | Indicateur de réussite |
|---|---|---|
| Audit des identifiants stables | Responsable catalogue | Zéro SKU dupliqué ou renommé |
| Synchronisation flux/page/paiement | Développeur | Taux de correspondance prix/disponibilité |
| Corrections JSON-LD | Développeur | Le balisage correspond à la page visible |
| Enrichissement des descriptions | Responsable catalogue | Complétude des attributs par SKU |
| Test de simulation | Responsable marketing/ecommerce | Taux de mention des SKU dans l’ensemble de prompts |
Comment les systèmes IA utilisent les contrôles d’éligibilité par opposition aux informations produit
Une fiche produit complète et exacte et un produit éligible sont deux choses différentes, et les marchands les confondent régulièrement.
Les informations produit — prix, disponibilité, images, descriptions — répondent à la question « qu’est-ce que ce produit et peut-il être vendu en principe actuellement ». Les indicateurs d’éligibilité répondent à une question plus étroite et distincte : « ce système spécifique doit-il afficher ou traiter ce produit spécifique maintenant ». La documentation Agentic Commerce d’OpenAI sépare volontairement ces deux notions, avec is_eligible_search qui contrôle la découvrabilité et is_eligible_checkout qui contrôle si une transaction peut réellement être finalisée dans l’agent.
Cette distinction piège de nombreux marchands qui supposent que corriger leur flux corrige automatiquement leur visibilité. Ce n’est pas le cas. Un produit avec des données parfaites mais un indicateur d’éligibilité absent ou mal configuré n’apparaîtra tout simplement pas, quelle que soit la qualité de la fiche sous-jacente. L’inverse est également vrai : un produit peut être techniquement éligible mais mal décrit, ce qui le fait rarement apparaître ou le fait rapidement écarter lors d’une comparaison.
En pratique, la vérification de l’éligibilité doit avoir sa propre étape dans la checklist, distincte de l’examen de la qualité des données. Traitez-la comme une validation explicite, et non comme une conséquence automatique d’un catalogue propre. Les marchands opérant sur plusieurs marchés doivent vérifier les indicateurs d’éligibilité par marché, car un indicateur correctement défini pour la soumission de flux d’une région ne s’applique pas automatiquement partout où le même catalogue est diffusé.
Considérations de confidentialité et de conformité des données avec l’IA et les sources de données d’achat
Les données comportementales first-party sont l’entrée de personnalisation la plus précieuse à laquelle les systèmes d’achat IA ont accès, et aussi la plus sensible juridiquement.
Le consentement est la base. Les signaux comportementaux, l’historique de navigation, les habitudes d’achat et les interactions sur le site ne peuvent alimenter les modèles de personnalisation que si les acheteurs ont réellement accepté cet usage, et les règles applicables varient selon les juridictions (régimes de protection des données dans l’UE, lois de confidentialité des États américains et autres définissent chacun leurs propres exigences). Les marchands opérant sur plusieurs marchés doivent suivre quelle norme de consentement s’applique à quel segment de clientèle plutôt que d’appliquer une politique uniforme.
La minimisation des données compte également ici. Fournir à un système IA plus de détails comportementaux qu’un cas d’usage de personnalisation n’en nécessite réellement n’améliore pas significativement les recommandations. Cela augmente simplement votre exposition en matière de conformité. La même logique s’applique aux données d’avis : agréger et anonymiser les signaux dérivés des avis avant qu’ils n’entrent dans un pipeline de recommandation réduit les risques sans réduire significativement leur utilité.
Le partage de données avec des tiers mérite une attention particulière. Lorsqu’un flux ou une API transmet des données d’acheteurs à une plateforme IA externe pour traitement, ce transfert peut lui-même déclencher des obligations de divulgation ou contractuelles selon la plateforme et la juridiction. Les marchands devraient traiter toute nouvelle intégration avec une plateforme d’achat IA comme ils traiteraient l’intégration d’un nouveau prestataire de paiement : un examen du partage de données avant le lancement, pas après.
Défis d’intégration lors de la combinaison de plusieurs sources de données pour les modèles d’achat IA
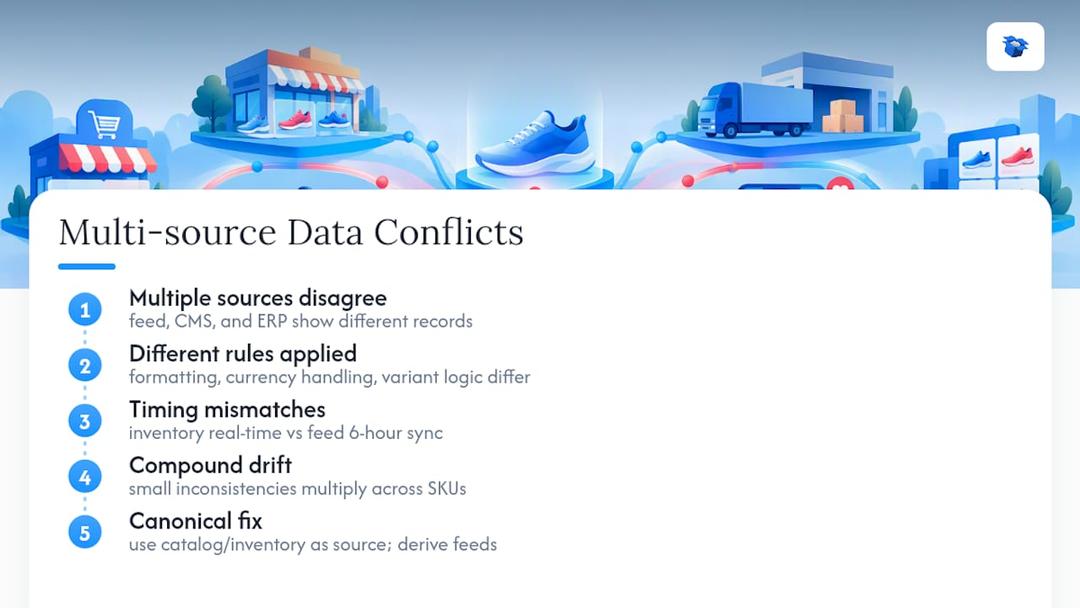
Tous les marchands finissent par se heurter au même problème : le flux dit une chose, le CMS en dit une autre, et le système ERP contredit les deux.
Le défi principal n’est pas de collecter les données. C’est de réconcilier des enregistrements conçus pour des usages différents et jamais pensés pour être cohérents entre eux. Un flux conçu pour Google Shopping et un flux conçu pour une plateforme de commerce IA peuvent provenir de la même base de données source tout en appliquant des règles de formatage, de gestion des devises ou de regroupement des variantes différentes. Les petites incohérences se multiplient rapidement dans un catalogue de milliers de SKU.
Les décalages de synchronisation aggravent encore le problème. Si votre système d’inventaire se met à jour en temps réel mais que votre flux ne se synchronise que toutes les six heures, il existe une fenêtre pendant laquelle un agent IA travaille déjà avec des données erronées. Les recommandations de Google sur les données structurées et les mises à jour automatiques sont claires : la fraîcheur n’est pas optionnelle, et des fréquences de mise à jour incohérentes entre systèmes créent précisément les conflits qui réduisent la confiance de l’IA dans une fiche produit.
La solution pratique consiste à établir une source canonique unique de vérité, généralement le système de gestion des stocks ou du catalogue, puis à traiter chaque flux en aval comme une sortie dérivée plutôt qu’un enregistrement maintenu indépendamment. Toute modification manuelle effectuée directement dans un fichier de flux sans mise à jour du système source crée une dérive presque impossible à retracer ensuite. Les marchands utilisant Shopify ou WooCommerce avec plusieurs canaux de vente devraient auditer le nombre réel d’endroits où résident les données de prix et de stock avant de supposer que leurs systèmes sont synchronisés.
Rôle des fournisseurs de données agrégées tiers et leur fiabilité
Les agrégateurs qui collectent des données produit auprès de plusieurs détaillants et les normalisent dans un flux unique jouent un véritable rôle dans l’écosystème de l’achat IA, mais leur fiabilité varie davantage que la plupart des marchands ne l’imaginent.
L’intérêt est simple : au lieu de maintenir des flux distincts pour chaque canal, un marchand peut envoyer un seul flux à un agrégateur et le laisser redistribuer des données normalisées. Le risque est que la normalisation est un processus de traduction, et toute traduction introduit une possibilité d’erreur. Une mise à jour de prix de votre côté peut mettre plus de temps à se propager via un agrégateur qu’avec un flux direct, et ce délai est précisément le type d’obsolescence qui réduit la confiance des recommandations IA.
La fiabilité dépend aussi fortement de la fréquence à laquelle l’agrégateur lui-même resynchronise vos données source, et cette cadence n’est pas toujours visible pour vous en tant que marchand. Avant de compter sur un agrégateur comme canal principal de distribution pour la visibilité dans l’achat IA, il vaut la peine de vérifier que sa fréquence de rafraîchissement correspond à votre propre volatilité, et pas seulement à sa promesse marketing de synchronisation « en temps réel ».
L’approche la plus sûre consiste à traiter les données distribuées par agrégateur comme un canal secondaire qui doit être cohérent avec votre flux direct et le balisage de vos pages, et non comme un substitut au maintien de ces canaux directs. Lorsque les trois divergent, la version de l’agrégateur est celle qu’un système IA a le moins de raisons de considérer fiable, car elle est la plus éloignée de la source d’origine.
Impact de la qualité des données sur les recommandations IA dans les scénarios d’achat
La qualité des données n’influence pas seulement la capacité d’un système IA à trouver votre produit. Elle détermine si le système lui fait suffisamment confiance pour le recommander à la place de la fiche produit d’un concurrent.
Un produit peut être techniquement découvrable, indexé, éligible dans le flux et structurellement valide, tout en perdant des opportunités de recommandation parce que ses attributs sont incomplets, que ses variantes sont ambiguës ou que son prix est discrètement devenu obsolète. La spécification commerce d’OpenAI l’exprime directement : mesurer uniquement la validité des données ne suffit pas, car les résultats observés des recommandations peuvent diverger de ce qu’un simple contrôle de schéma propre laisserait prévoir.
Les données contradictoires d’une source à l’autre aggravent le problème. Lorsque votre flux, le balisage de votre page et la fiche d’un revendeur décrivent le même produit de façon légèrement différente, un système IA ne fait pas la moyenne de ces différences. Il y voit un signe de manque de fiabilité et accorde moins de confiance à l’ensemble des champs associés à ce SKU. C’est ce que confirme, en pratique, la spécification de Google pour Merchant Center en insistant sur la cohérence entre les sources.
L’effet cumulatif est particulièrement important ici. Un seul champ d’attribut faible fait rarement chuter une fiche produit à lui seul. Mais un catalogue contenant des dizaines de petites incohérences — un prix obsolète ici, un attribut de variante manquant là, une description qui ne mentionne jamais un cas d’usage clé — finit par former un schéma que les systèmes IA apprennent à déprioriser. Corriger la qualité des données n’est pas un projet de nettoyage ponctuel. C’est une discipline continue dont les bénéfices se cumulent avec le temps.
Point de vue éditeur : pourquoi la simulation dépasse la simple validation
Les validateurs de schéma confirment la syntaxe. Ils ne peuvent pas vous dire qu’un agent IA ignore votre produit parce que la description cache l’unique attribut réellement demandé par l’acheteur. La simulation révèle cet écart, et une boucle diagnostiquer, réécrire, publier, retester le réduit plus rapidement que n’importe quel audit statique. Les marchands qui exécutent ce cycle de manière répétée ont tendance à détecter les dérives, les écarts de prix et les descriptions trop faibles ou variantes ambiguës avant que cela ne leur coûte une saison de recommandations perdues, et non après.
— Xhurian
Comment Ecentic transforme les corrections de données en gains de recommandations IA
Corriger des flux et du balisage isolément revient à travailler à l’aveugle sans moyen de voir comment ChatGPT, Gemini ou Perplexity réagissent réellement à votre catalogue à cet instant. Certaines plateformes ferment cette boucle : elles simulent de vrais prompts d’achat sur votre boutique, montrent exactement où une fiche produit gagne ou perd face aux concurrents en langage clair, puis permettent de publier la correction directement dans Shopify ou WooCommerce en un clic.

Le UCP Playground vous permet de tester n’importe quelle boutique avec des agents d’achat IA avant de vous lancer dans une réécriture. Vous savez ainsi quels SKU nécessitent votre attention, au lieu de le deviner. Une fois les lacunes identifiées, ecentic fournit des outils d’optimisation des fiches produit qui génèrent les corrections et les publient, puis relancent un scan pour vérifier si le taux de recommandation a effectivement évolué.
Commencez par un scan gratuit pour voir où en est actuellement votre catalogue, puis comparez les offres sur la page des tarifs, qui présente différentes options d’abonnement ainsi qu’une commission de performance par commande attribuée à l’IA.
Spécifications et documentation de référence à consulter ensuite
Pour des détails d’implémentation au-delà de ce guide, allez directement à la source. La spécification OpenAI Agentic Commerce couvre la structure des flux et l’éligibilité, tandis que les recommandations de Google sur les données structurées couvrent la validation du balisage et les propriétés requises pour une découvrabilité précise.
Sources
Les images et les descriptions en texte libre contiennent de véritables informations utilisées par les systèmes IA, mais elles sont plus difficiles à valider qu’un champ de prix structuré, et cet écart crée des angles morts que les marchands manquent régulièrement.
Les images produit ne servent pas seulement à illustrer une fiche produit. Les systèmes IA multimodaux peuvent extraire directement des attributs à partir des images — couleur, texture du matériau, taille approximative par rapport aux autres objets présents dans l’image — lorsque les champs d’attributs structurés sont absents ou incomplets. C’est utile, mais cela signifie aussi qu’une image de stock générique ou de mauvaise qualité peut activement jouer contre vous en fournissant des signaux visuels vagues ou trompeurs là où un attribut texte clair aurait été plus fiable.
Les descriptions en texte libre comportent un risque similaire dans l’autre sens. Une description écrite pour la densité de mots-clés SEO plutôt que pour des attributs clairs (« qualité premium, meilleur de sa catégorie, valeur incroyable ») n’apporte presque rien de concret qu’un système IA puisse extraire. Une description qui indique le matériau, les dimensions et le cas d’usage précis lui fournit au contraire beaucoup d’informations exploitables, même sans un seul champ structuré pour les soutenir.
L’approche pratique consiste à traiter le contenu non structuré comme un complément aux données structurées, jamais comme un remplacement. Rédigez des descriptions qui énoncent des attributs concrets dans un langage simple et utilisez des images qui montrent clairement les attributs importants pour la catégorie — repère de taille pour les meubles, texture pour les tissus, échelle pour l’électronique. Lorsque des champs structurés existent, assurez-vous que le texte et les images ne les contredisent pas.
FAQ
Ai-je besoin à la fois d’un flux produit et d’un balisage de données structurées ?
Oui. Les flux et les données structurées servent des systèmes différents et se recoupent mutuellement ; s’appuyer sur un seul laisse des lacunes que les agents IA peuvent interpréter comme des incohérences. La spécification des données produit de Google considère la cohérence des valeurs entre les deux comme une exigence de base, pas comme une option.
À quelle fréquence dois-je mettre à jour les données de prix et de disponibilité ?
Adaptez la fréquence aux variations du stock : toutes les heures ou le jour même pour les articles qui se vendent vite, et au moins une fois par jour pour les articles dont le stock varie peu. Selon les recommandations de Google pour Merchant Center, les données obsolètes sont l’une des causes les plus fréquentes de perte de recommandations par l’IA.
Les avis peuvent-ils remplacer la nécessité de données de flux exactes ?
Non. Les avis apportent des preuves de qualité et de cas d’usage, mais ils ne remplacent jamais les données de prix ou de stock faisant autorité, qui restent du ressort du flux quelle que soit la force du signal des avis.
Comment tester ce que les agents IA recommandent réellement pour mes produits ?
Créez un ensemble représentatif de prompts d’achat couvrant les scénarios de catégorie, de budget et de comparaison, puis exécutez-les dans une simulation d’agent comme le UCP Playground d’Ecentic afin d’observer directement les mentions de SKU et l’exactitude des prix.
Quel est le coût d’ecentic pour une petite boutique ecommerce ?
L’offre Compete d’ecentic démarre à $14.90 par mois, avec Scale à $44.90 et Dominate à $149, plus une option à l’usage avec une commission de 3 % par commande attribuée à l’IA, le tout indiqué sur la page des tarifs.