

Da igual si la gente busca en Google, entra en Amazon o pregunta a un chatbot: ahora la IA les devuelve una respuesta con un producto, y la mayoría de las marcas ecommerce no tienen ni idea de cómo convertirse en ese producto. La calidad de los datos de producto para IA significa que tus títulos, especificaciones, identificadores, precios y estado de stock estén completos, sean coherentes en todos los lugares donde aparecen y puedan ser leídos por software. Corrige eso y un agente podrá comparar tu producto con el de un competidor y elegir el tuyo.
Creo que lo más gracioso es el tiempo que todos hemos dedicado a pulir páginas de inicio. El agente nunca ve la tuya. Lee el feed de productos, el catálogo y los datos estructurados de las fichas de producto, y pasa al siguiente cuando falta algo. Tu banner principal es precioso, y nadie lo está mirando.
TL;DR
- Los agentes de IA comparan productos usando campos del feed, datos del catálogo y datos estructurados en las fichas de producto, no tu página de inicio ni la historia de tu marca.
- Los campos ausentes, incoherentes o desactualizados (especificaciones, identificadores, precio, disponibilidad) son las razones más habituales por las que un agente descarta un producto.
- El feed y el marcado de la página deben decir lo mismo. Google usa ambos y los compara entre sí.
- Audita primero las discrepancias que podrían hacer que un comprador eligiera mal: identidad, idoneidad, oferta y destino.
- Empieza poco a poco: un análisis gratuito de ecentic cubre tus 10 productos principales y muestra qué competidor te supera y por qué.
Qué significa la calidad de los datos de producto cuando quien compra es un agente
Para una persona, una ficha de producto es una historia con fotos. Para un agente, es un registro. El agente se hace una pregunta sencilla: ¿este registro me dice qué es el producto, si encaja con la solicitud, cuánto cuesta, si está disponible y dónde comprarlo?
Un artículo de 2026 sobre descubrimiento de productos mediante IA plantea un planteamiento prudente: unos datos de producto completos pueden aumentar la probabilidad de que un sistema asistido por IA evalúe y muestre un producto, pero no demuestran que un producto menos conocido vaya a superar a una marca más grande. Estoy de acuerdo con ese enfoque. Disponer de datos fiables es un requisito de partida, no una garantía.
Jager Robinson, de LogicBroker, añade una observación útil en una publicación de 2026 sobre calidad de los datos de producto: los ganadores en el descubrimiento impulsado por IA no suelen ser quienes tienen los mayores presupuestos de marketing, sino quienes tienen datos lo bastante limpios, estructurados y coherentes como para que los modelos puedan leerlos y confiar en ellos. La mayoría de los catálogos se crearon para publicar productos rápido, dejando la completitud como un extra opcional. Antes, ese compromiso salía barato. Ya no.
Las cuatro cosas que comprueba un agente
Me resulta más fácil pensarlo en cuatro preguntas, que encajan con el marco de auditoría del informe de preparación para compras con IA:
- Identidad. ¿De qué producto y variante exactos se trata? Los identificadores y la imagen principal responden a eso.
- Idoneidad. ¿Encaja con lo que pidió el comprador? Los atributos, la compatibilidad y las pruebas de apoyo responden a eso.
- Oferta. ¿Cuál es el precio, en qué moneda, está disponible y bajo qué condiciones?
- Destino. ¿El enlace lleva a la ficha de producto correcta y a un proceso de compra funcional?
Si una de esas cuatro cosas falla, el agente o bien adivina o bien se va. Y que adivine es peor para ti, porque mostrar a un comprador un precio o una talla incorrectos acaba convirtiéndose en una devolución o en una venta perdida.
Por qué las carencias hacen que los agentes te descarten
LogicBroker describe estos fallos como algo predecible a gran escala: las especificaciones están incompletas, las descripciones están llenas de palabras clave, los atributos se rellenan de forma desigual entre SKUs y el mismo producto tiene nombres distintos según el canal. Su resumen es claro: un modelo no compensa las carencias, simplemente pasa al siguiente.
Google dice algo parecido con sus propias palabras. La documentación de Google sobre la especificación de datos de producto de Merchant Center afirma que una información de producto incorrecta, inexacta o ausente puede provocar rechazos, elegibilidad limitada o visualizaciones erróneas, y que unos datos precisos y con el formato correcto son esenciales para anuncios y fichas gratuitas en formatos impulsados por IA.
También existe un fallo más silencioso: datos a los que una persona puede acceder pero un agente no. Core dna describió una prueba en un sitio de Clark Rubber donde la información a nivel de producto podía recuperarse, mientras que el stock por tienda quedaba detrás de una interacción que la ruta de recuperación nunca exponía. Una persona hace clic en un selector de tienda y ve el stock. El agente no hace clic en nada. Es lógico, es un robot, pero aun así decide quién consigue la venta.
Lo que vemos en nuestras propias simulaciones
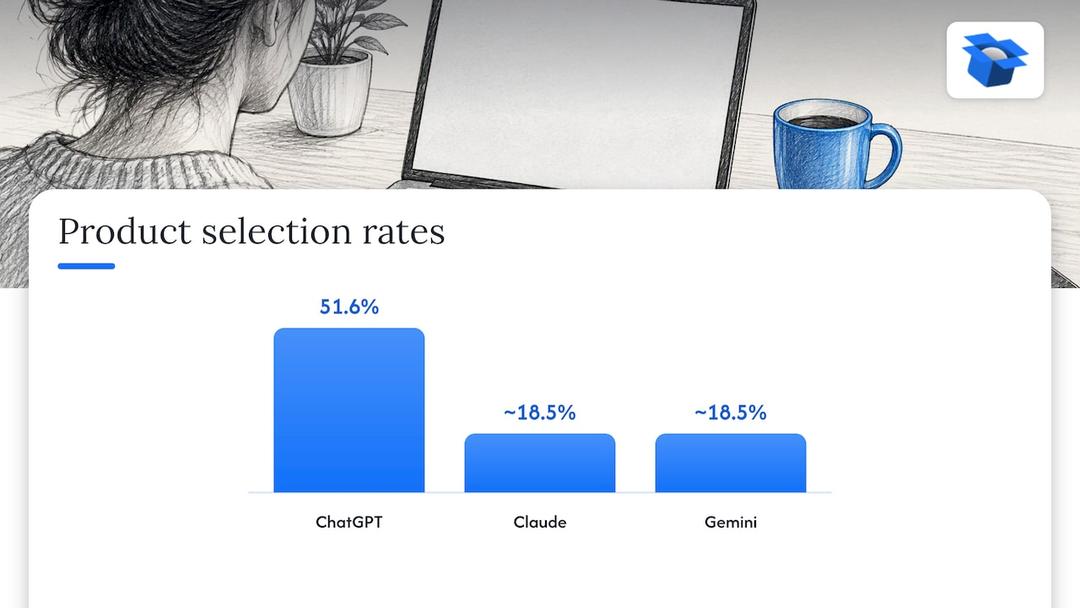
Estas cifras son de ecentic, obtenidas en nuestras propias pruebas, así que léelas como tales. En octubre de 2026 habíamos ejecutado 36.797 compras simuladas. Sobre el mismo catálogo, ChatGPT eligió el producto aproximadamente tres veces más que Claude o Gemini: un 51,6 % frente a alrededor del 18,5 %. Así que «la IA» no es un único comprador. Cada modelo valora tus datos de forma distinta, y un registro que gana en uno puede perder en otro.
En una auditoría anónima, un marketplace de bebidas espirituosas con unos ingresos de 70 millones € al año tenía un fallo en los datos que leen los agentes en el 88 % de sus 9.699 productos. Cuando se preguntó a los agentes dónde comprar dos botellas que tenía en stock, el resultado fue 0 apariciones en 20 respuestas. Nadie se había dado cuenta, porque la web tenía muy buen aspecto.
Otra auditoría, de una marca sueca de cuidado de la piel, detectó que los procesos de compra iniciados por agentes llegaban al paso del pago en 0 de 6 países porque una configuración de envío pedía un número de teléfono. Un agente que rellena un carrito no tiene el número de teléfono de tu cliente. Era un ajuste mínimo y bloqueaba todos los pedidos.
Qué especificaciones y atributos debes proporcionar
Empieza por lo que piden las propias plataformas. OpenAI, en su especificación de feeds de productos, exige item_id, title, description, url, brand, seller_name, image_url, availability y price. También incluye campos opcionales para condition, product_category, material, color, size, gender, age_group, dimensions y weight. Opcional es una forma elegante de decirlo. Cuando dos productos compiten, el que tiene los campos de material y dimensiones completos es más fácil de asociar a una solicitud concreta.
Xorosoft plantea el caso práctico en su guía sobre datos para agentes de compra: la completitud factual importa más que el lenguaje promocional, y los atributos estructurados facilitan la comparación porque el software no necesita inferir detalles a partir de texto libre. Su ejemplo es el de un comprador que busca un escritorio de nogal de menos de 50 pulgadas de ancho. Esa coincidencia es mucho más fiable cuando el material y la anchura son campos independientes y no adjetivos dentro de un párrafo.
Photoroom propone una estructura de ficha de producto en siete capas que me parece una lista de comprobación muy útil:
| Capa | Qué incluye |
|---|---|
| Título | Tipo de producto, marca, modelo, material, color, talla, capacidad |
| Atributos estructurados | Color, talla, material, género, estado, compatibilidad, dimensiones |
| Descripción | Construcción, rendimiento, elementos incluidos, uso previsto, mantenimiento |
| Identificadores | GTIN, MPN, SKU, ID de grupo de artículos |
| Datos de la oferta | Precio, moneda, disponibilidad, estado, entrega, devoluciones |
| Imágenes | Principal, ángulos alternativos, detalle, en contexto |
| Consistencia entre página y feed | Precio, stock, título, variante, imagen y URL coinciden |
Fíjate en lo que falta: eslóganes. Un título como «La única taza que necesitarás jamás» no le dice nada a un agente. «Taza de café de gres, 12 oz, negro mate, apta para lavavajillas» le dice todo lo que puede comparar. Si quieres profundizar en títulos y descripciones, nuestra guía sobre optimización de fichas de producto cubre la parte de reescritura.
El feed y el marcado de la página deben coincidir
La mayoría de las tiendas mantienen dos fuentes de referencia: el feed de productos y los datos estructurados (JSON-LD, un bloque legible por máquinas) en la ficha de producto. Se desincronizan más rápido de lo que nadie admite.
La documentación de Google Search Central dice que proporcionar tanto datos estructurados como un feed de Merchant Center maximiza la elegibilidad y ayuda a Google a verificar los datos. Algunas experiencias combinan ambos, así que los fragmentos de producto pueden tomar el precio del feed cuando el marcado de la página no lo incluye. La propia página de ayuda de Merchant Center añade las reglas con las que la gente suele tropezar: el marcado debe estar en el HTML devuelto por el servidor, no generado por JavaScript; debe coincidir con lo que ve el usuario; las páginas necesitan un objeto Product con un objeto Offer anidado; y el precio usa un punto como separador decimal.
El blog de Universal Commerce Protocol enumera las propiedades mínimas del esquema Product para el comercio con agentes: name, description, sku o gtin13, brand, image, offers con price y availability, y aggregateRating. Recomienda añadir weight, height, width, depth, color, size, category y additionalProperty para atributos específicos del tipo de producto. Si todavía no conoces el marcado en sí, una explicación sencilla sobre cómo funciona el marcado de datos estructurados ayuda, y una guía paso a paso para añadir marcado de datos estructurados de producto incluye un ejemplo listo para copiar.
| Feed de productos | Datos estructurados de la página | |
|---|---|---|
| Dónde se encuentra | Subido a un canal como Merchant Center | En el HTML de cada ficha de producto |
| Más útil para | Precio, stock e identidad a escala, siempre actualizados | Permitir que los sistemas verifiquen que la página coincide con el feed |
| Fallo habitual | Precio o stock desactualizados | Offer ausente, marcado solo con JavaScript |
| Quién suele encargarse | Equipo de crecimiento o de canales | Desarrollador o plantilla |
BBQ Growth Lab lo plantea bien como cuatro capas: datos de origen (PIM, ERP, inventario, precios), un modelo de producto normalizado, salidas para canales (HTML de la página, JSON-LD, feeds) y una capa de feedback con estados, avisos y rechazos. Su regla es que ningún feed de plataforma debe sobrescribir silenciosamente los datos de origen. Creo que tienen razón, y es la regla que la mayoría de las tiendas pequeñas incumplen la primera vez que alguien edita un título dentro de un canal de ventas.
Conviene hacer una aclaración: los datos estructurados no garantizan una recomendación. Core dna lo explica de forma justa al decir que ofrecen a los sistemas de IA mejor información comercial con la que trabajar, mientras que el descubrimiento sigue dependiendo de la relevancia, el contexto y otras señales. Además, tener una API no es lo mismo que ser accesible para un agente, a menos que el agente tenga una forma compatible de usarla.
Para conocer nuestra visión sobre el marcado, consulta la lista de comprobación de datos estructurados para fichas de producto y el artículo sobre datos estructurados de producto respaldados por simulaciones.
Cómo auditar tu catálogo
No necesitas corregir 10.000 productos el primer día. Corrige los casos en los que una discrepancia podría hacer que un comprador eligiera mal. Esa es la prioridad que First Brand propone en su auditoría de preparación, y es un filtro sensato.
- Exporta tu feed y elige tus 20 productos más vendidos. Las muestras pequeñas muestran patrones rápidamente.
- Para cada uno, comprueba la identidad: ¿cada variante tiene su propio identificador y el título es el mismo en tu web, el feed y los marketplaces?
- Comprueba la idoneidad: ¿material, talla, dimensiones, compatibilidad y uso previsto están rellenados como campos y no escondidos dentro de texto libre?
- Comprueba la oferta: compara el precio, la moneda y la disponibilidad del feed con lo que muestra la página en vivo y con lo que dice el JSON-LD.
- Comprueba el destino: haz clic en la URL del feed. Debe llevar a la variante correcta, con un proceso de compra que no requiera iniciar sesión ni un número de teléfono.
- Pregunta por tu producto a varios chatbots igual que lo haría un comprador y anota qué marcas aparecen en lugar de la tuya.
El paso 6 es donde la mayoría de los equipos se atascan, porque hacerlo a mano es lento y las respuestas cambian según el modelo. Por eso creamos la funcionalidad de simulación de ecentic. Más abajo te contamos más.
Cómo medir si tus datos son lo bastante buenos
No existe una puntuación estándar para el sector, así que yo mantendría un cuadro de control sencillo y haría seguimiento mensual. Cuatro métricas lo cubren:
- Completitud: el porcentaje de productos con todos los campos obligatorios y recomendados rellenados.
- Consistencia: el porcentaje de productos en los que el título, el precio y la disponibilidad coinciden entre el feed, la página y los marketplaces.
- Precisión: una comprobación puntual de una muestra frente al producto real, el embalaje y la ficha del proveedor.
- Actualización: el tiempo que pasa entre un cambio de precio o stock en tu sistema y ese mismo cambio en el feed.
Las herramientas que ya tienes ayudan. Merchant Center muestra avisos y rechazos a nivel de artículo, lo que sirve como comprobación gratuita de consistencia frente a las propias reglas de Google. También importa quién se encarga de qué. La visión de BBQ Growth Lab es que el equipo de producto define los datos, los sistemas comerciales son la fuente de referencia para precios e inventario, ingeniería se ocupa de la distribución y el equipo de crecimiento gestiona el mapeo a plataformas y los controles de calidad. Lo que necesita gobernanza es si precio, inventario, identificadores, variantes e imágenes están representados correctamente en todas partes, no quién sube el archivo.
Para una implantación más larga, nuestro plan de 30 a 90 días para optimizar fichas de producto para IA y el artículo sobre qué fuentes de datos utiliza la IA para compras explican la secuencia.
Nuestra perspectiva sobre hacia dónde va esto
Creemos que los datos de producto se están convirtiendo en el escaparate. Cuando alguien pide a un agente que encuentre un regalo, compare dos batidoras o vuelva a pedir café, el agente lee registros. No navega, no se deja seducir por un banner y no perdona que falte una talla.
Por eso ecentic trabaja sobre la propia tienda: el feed de productos, el catálogo y el proceso de compra que utiliza un agente. Nos conectamos a Shopify, WooCommerce o a un feed de productos. Hacemos que ChatGPT, Claude y Gemini comparen cada uno de tus productos con el de un competidor concreto y mostramos por qué el tuyo pierde, en lenguaje claro. Cuando haces clic en Aplicar, reescribimos el título, la descripción y los datos estructurados y los publicamos en tu tienda.
El proceso de compra importa. La compra dentro de la respuesta de IA ya está activa en Google AI Mode y Gemini en Estados Unidos mediante UCP, el estándar abierto de Google para procesos de compra mediante agentes. En WooCommerce, el plugin gratuito de ecentic permite a los agentes buscar, rellenar un carrito y completar la compra mediante UCP. En Shopify, enviamos las correcciones a Google Merchant Center y hacemos seguimiento de las visitas procedentes de asistentes de IA. ChatGPT enlaza con el proceso de compra propio de la tienda, así que ahí la ficha de producto y el proceso de compra siguen teniendo que funcionar para un agente. OpenAI tiene ACP, Google tiene UCP y Amazon tiene un muro.
Nuestro primer piloto, DUA Flavours, vio aumentar un 12 % las visitas procedentes de asistentes de IA y el tráfico directo entre abril y julio de 2026. Es una cifra de visitas, no de ventas, y quiero dejarlo claro. Estamos en una fase temprana y seguimos realizando pilotos.
Xhurian Shaba
Empieza con un análisis gratuito
Si prefieres ver las carencias en lugar de leer sobre ellas, el análisis gratuito de ecentic cubre tus 10 productos principales, no requiere tarjeta y muestra qué competidor concreto prefiere cada modelo de IA y por qué. También puedes realizar la auditoría gratuita de compras WebMCP para tu tienda y leer cómo funciona antes de conectar nada.

Cuando quieras publicar las correcciones, el plan Compete cuesta 14,90 $ al mes para hasta 100 productos. Scale cuesta 44,90 $ al mes para hasta 1.000 productos y añade correcciones con un clic. Dominate cuesta 149 $ al mes y añade sincronización con Google Merchant Center y configuración del proceso de compra mediante agentes. También hay una opción de pago por uso del 3 % de los pedidos atribuidos a IA, con un límite de 500 $ al mes. Las condiciones actuales están en la página de precios, y los catálogos más grandes pueden consultar Enterprise.
FAQ
¿Qué es la calidad de los datos de producto para IA?
Es el nivel de completitud, consistencia, precisión y actualización de tus registros de producto, y si el software puede leerlos. Los agentes comparan productos a partir de campos como el título, los atributos, los identificadores, el precio y la disponibilidad. Un registro con carencias es fácil de descartar, así que el producto con la ficha más completa suele ser el más fácil de recomendar.
¿Qué especificaciones de producto importan más para los agentes de compra con IA?
Empieza por los campos que exigen las plataformas: título, descripción, marca, imagen, precio y disponibilidad, además de identificadores como GTIN o SKU. La especificación de feeds de OpenAI también incluye material, color, talla, dimensiones y peso como campos opcionales. Complétalos como campos independientes, no solo dentro de la descripción.
¿Necesito tanto un feed de productos como datos estructurados?
Sí, porque cumplen funciones distintas. La documentación de Google dice que proporcionar ambos maximiza la elegibilidad y le permite verificar uno frente al otro. Mantén idénticos el precio, la disponibilidad, el título y la variante, y conserva el marcado en el HTML que devuelve el servidor.
¿Unos datos limpios garantizan que la IA recomiende mi producto?
No. Unos datos limpios hacen que tu producto sea legible y comparable, pero la relevancia, el contexto y otras señales siguen contando. Lo que sí hacen es eliminar los motivos evitables por los que se descarta un producto, que suelen ser además los más baratos de corregir.
Fuentes
- Descubrimiento de compras con IA: por qué importan los datos de producto
- Por qué la IA no encuentra tus productos: calidad de los datos de producto
- Preparación para compras con IA: datos de producto para recomendaciones
- Especificación de datos de producto, Ayuda de Google Merchant Center
- Optimización de feeds de producto para compras y búsquedas con IA
- Especificación de feeds de productos de OpenAI
- Datos de producto para compras con IA: cómo prepararse para los agentes de compra
- Cómo estructurar fichas de producto para agentes de compra con IA
- Introducción a los datos estructurados de producto en Google
- Configurar datos estructurados para Merchant Center
- Datos estructurados para agentes de IA: schema.org, JSON-LD y UCP
- Datos estructurados de producto frente a feeds
- Explicación del marcado schema