ecenticecentic
Cómo funcionaRecursosPreciosBlog
Instalar ahora
ASCII-art illustration of a stack of books

Comercios: simular y corregir fuentes IA en 7–30 días

Publicado: 22 de septiembre de 2026 · 26 min de lectura

Guía para comercios sobre cómo simular, corregir y publicar fuentes de datos para compras con IA. Prioriza SKUs estables, precio y stock sincronizados.

00

Introducción

Ilustración decorativa de datos de compras con IA

Los sistemas de IA que recomiendan productos hoy se nutren de cuatro capas: feeds y API de comerciantes, datos estructurados en las páginas de producto, fichas de minoristas y marketplaces, y reseñas, además del comportamiento de compra propio. Los comerciantes deberían priorizar tres cosas de inmediato: un catálogo canónico con ID estables, un precio y una disponibilidad estrechamente sincronizados, y descripciones de producto claras y ricas en atributos. Después de eso, las pruebas basadas en prompts confirman si esas correcciones realmente cambian lo que recomienda un agente de IA.


Resumen rápido:

  • Los feeds de los comerciantes deben incluir ID estables, precios sincronizados y atributos de producto ricos para evitar incoherencias en las recomendaciones y mejorar la confianza de la IA.
  • El marcado de datos estructurados debe renderizarse en el servidor, estar actualizado y coincidir con el contenido visible de la página para garantizar una comprensión precisa por parte de la IA.
  • Las pruebas periódicas con prompts de compra y simulaciones reales de IA ayudan a identificar en qué puntos los datos o las descripciones del producto provocan fallos en las recomendaciones.
  • Mantener una única fuente de verdad y hacer que los datos del feed, la página y el checkout coincidan en todo momento minimiza la caída de recomendaciones debida a información desactualizada o que no coincide.
  • Las señales propias de comportamiento y reseñas contribuyen a la personalización, pero no pueden sustituir los hechos básicos del producto, como el estado de stock o el precio, que requieren datos fiables en el feed.
ecentic
Descubre cómo la IA evalúa tus fichas
ecentic se conecta con Shopify o WooCommerce y muestra fortalezas, debilidades y formas prácticas de mejorar las recomendaciones de productos de la IA.
Explorar ecentic
01

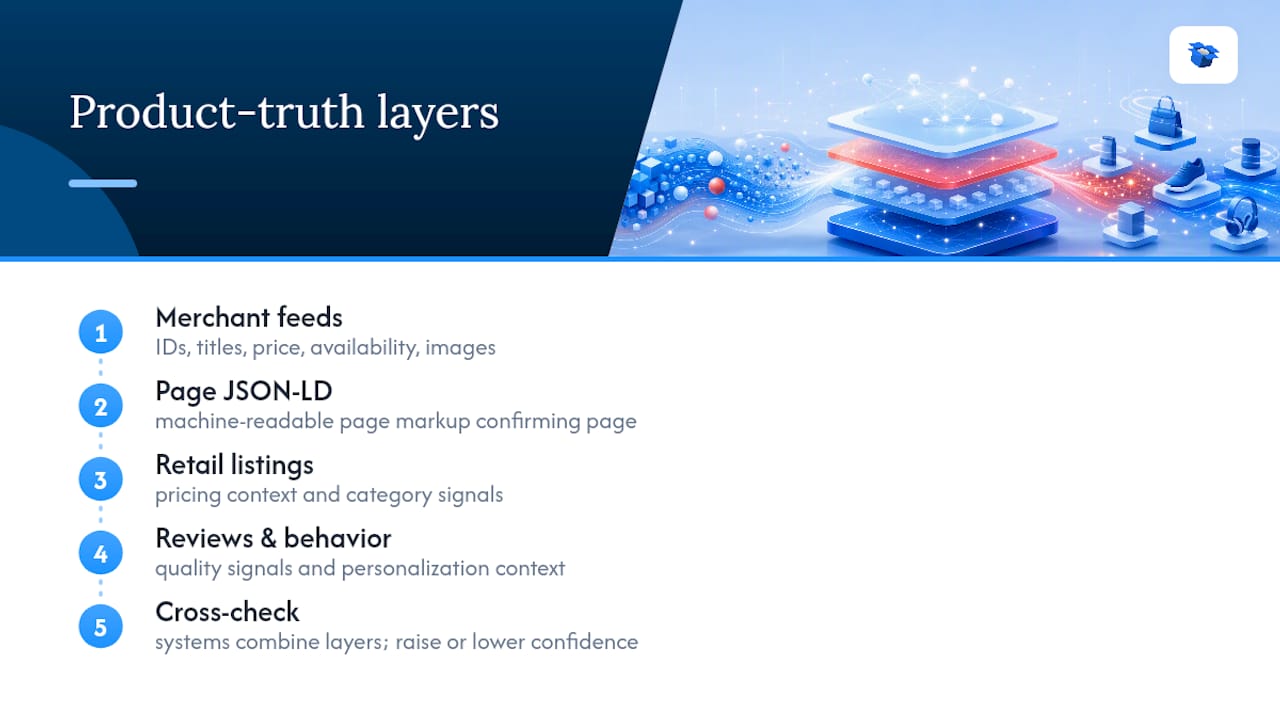
Resumen: las capas de verdad del producto que ingieren los agentes de compra con IA

Resumen: las capas de verdad del producto que ingieren los agentes de compra con IA

Un agente de compras con IA nunca ve tu tienda online como lo hace un comprador. Ve un mosaico de registros y tiene que decidir en cuáles confiar. Cada capa aporta una parte distinta de la verdad.

Los feeds y las API del comerciante transportan los datos troncales: identificadores estables, títulos, descripciones, precio, divisa, disponibilidad, variantes, imágenes e información del vendedor. Esta es la capa que la especificación de comercio de OpenAI trata como la fuente principal de hechos del producto dentro de ChatGPT.

Los datos estructurados de la página de producto (marcado JSON-LD) ofrecen a los rastreadores una versión legible por máquina de lo que ya es visible en la página, actuando como una segunda confirmación de lo que afirma el feed.

Los listados de minoristas y marketplaces aportan contexto de precios y señales de categoría, especialmente cuando un producto aparece en múltiples canales.

Las reseñas y los datos de comportamiento de primera mano completan la imagen con señales de calidad y contexto de personalización, aunque nunca sustituyen a hechos objetivos como el estado de stock.

Los sistemas que recomiendan productos combinan las cuatro capas y las contrastan entre sí. Cuando tu feed dice «en stock» y el marcado de tu página dice «agotado», esa discrepancia no solo confunde al algoritmo. Reduce la confianza en todo tu registro, según la especificación de datos de producto de Google.

Cuatro capas de datos de compras con IA contrastadas

02

Feeds de productos y mejores prácticas de API que los comerciantes deben seguir

Feeds de productos y mejores prácticas de API que los comerciantes deben seguir

Tu feed es el activo de mayor impacto que controlas, y necesita campos específicos, no una completitud vaga.

  1. Incluye los campos principales de identidad: id estable o SKU, título, descripción, enlace canónico, URL de la imagen, precio, divisa, estado de disponibilidad, atributos de variante y marca.
  2. Ajusta el feed al esquema de archivo plano de OpenAI cuando quieras optar a la elegibilidad en ChatGPT. La especificación de producto de Agentic Commerce espera como mínimo id, title, description, link, image_link, availability, price y brand.
  3. Configura los indicadores de elegibilidad de forma deliberada. is_eligible_search y is_eligible_checkout son interruptores separados. Un registro de producto perfectamente completo no aparecerá en ChatGPT si estos indicadores no están configurados.
  4. Cumple los requisitos principales de Google Merchant Center: ID de producto estable, enlace funcional a la página de destino, precio y disponibilidad precisos, y campos correctos de categoría e identificador.
  5. Mantén los valores del feed idénticos a los de la página de destino y del proceso de pago. La divergencia en este punto es una de las causas más comunes de desaprobación o de pérdida silenciosa de recomendaciones.

Consejo profesional: Haz una comprobación puntual semanal comparando 20 SKU aleatorios en tu feed, la página de producto y el flujo de pago. La mayor parte de la deriva del feed ocurre silenciosamente, una actualización de precio o una sincronización de inventario cada vez, y nadie se da cuenta hasta que un agente de IA cita el precio equivocado a un comprador.

En cuanto a la frecuencia: las categorías de alta volatilidad (ropa con reposiciones frecuentes, electrónica con precios dinámicos) necesitan actualizaciones en el mismo día o cada hora. Las categorías con menos movimiento pueden tolerar sincronizaciones diarias, pero nunca más espaciadas.

03

Datos estructurados en las páginas de producto: campos de Schema.org y errores habituales

Datos estructurados en las páginas de producto: campos de Schema.org y errores habituales

Los datos estructurados son la forma de entregar a un sistema de IA los hechos exactos que quieres que utilice, con un formato que no le obligue a adivinarlos.

Las propiedades esenciales de Schema.org para cualquier página de producto incluyen:

  • Product con nombre, descripción e imagen
  • Offer anidado dentro, con price, priceCurrency y availability
  • gtin (o la variante GTIN adecuada) para la identificación global del producto
  • sku para tu identificador interno
  • item_group_id para vincular entre sí las variantes del mismo producto

La guía de Google sobre los atributos de datos estructurados compatibles deja claro que este marcado debe estar presente en el HTML renderizado por el servidor, no inyectarse solo después de que JavaScript se ejecute en el cliente. Muchos rastreadores y agentes ni siquiera ejecutan tu JavaScript, lo que significa que el marcado solo con JS es, en la práctica, invisible para ellos.

El error más común no es la ausencia de marcado. Es un marcado que antes era correcto y que silenciosamente dejó de estar sincronizado con la página visible, normalmente después de un cambio de precio o de un cambio promocional que solo actualizó la visualización del front-end.

Consejo profesional: Superar un validador de schema te indica que la sintaxis está limpia. No te dice nada sobre si una IA describe realmente tu producto correctamente. Combina las comprobaciones del validador con auditorías de prompts reales para ver cómo se describe el SKU.

04

Reseñas, señales del vendedor y datos conductuales de primera parte

Reseñas, señales del vendedor y datos conductuales de primera parte

Las reseñas y los datos conductuales influyen en cómo un sistema de IA personaliza una recomendación, pero desempeñan un papel de apoyo, no uno fundamental.

  • Las reseñas aportan calidad percibida y evidencia de casos de uso, el tipo de contexto que ayuda a un agente a decidir qué producto en stock se ajusta a la necesidad declarada de un comprador.
  • Los datos conductuales de primera parte, recogidos con consentimiento, permiten a las plataformas adaptar las recomendaciones al contexto, al historial de compras o a los patrones de navegación, según la investigación de Klaviyo sobre IA y comportamiento del consumidor.
  • Ambos tipos de datos deben vincularse a un identificador SKU estable, o la evidencia de las reseñas y el registro actual del producto acabarán desalineándose con el tiempo.
  • Ni las reseñas ni las señales conductuales deberían prevalecer nunca sobre tu feed canónico de precio o inventario. Si una reseña de cinco estrellas dice que un producto es una gran oferta y tu feed dice que está agotado, gana el feed.
05

Actualización, sincronización e identidad: reglas para evitar pérdidas de recomendación

Actualización, sincronización e identidad: reglas para evitar pérdidas de recomendación

Los datos desactualizados de precio y disponibilidad no solo molestan a los compradores. Hacen que los sistemas de IA dejen silenciosamente de recomendar un SKU por completo en lugar de arriesgarse a dar una mala respuesta.

  1. Haz coincidir en todo momento los valores del feed, los datos estructurados, la página de destino y el checkout. Cualquier discrepancia aumenta el riesgo de desaprobación o pérdida de visibilidad, según las directrices de Google Merchant Center.
  2. Nunca cambies de nombre ni vuelvas a emitir SKUs a mitad del proceso. La deriva de identidad, es decir, cambiar un identificador durante un rediseño del sitio o una migración del catálogo, es una de las formas más habituales en que los comerciantes rompen el vínculo entre el historial de precios de un producto, sus reseñas y su ficha actual.
  3. Modela las variantes explícitamente usando item_group_id en lugar de permitir que las variaciones de color o talla existan como productos separados y desconectados.
  4. Ajusta la frecuencia de actualización a la volatilidad. El inventario de movimiento rápido necesita comprobaciones cada hora; los artículos de catálogo estables pueden funcionar con un ciclo diario.
  5. Prueba los casos límite, no solo la ruta ideal. Los estados de preventa, pedido pendiente y agotado necesitan el mismo rigor de verificación que los listados estándar con stock disponible.

Consejo profesional: Crea un pequeño panel que marque cualquier SKU en el que el precio del feed y el precio de la página hayan diferido durante más de dos horas. Esa diferencia es casi siempre la primera señal de que algo se rompió en un paso anterior.

06

Pruebas y medición: prompts, simulaciones y atribución de tráfico

Pruebas y medición: prompts, simulaciones y atribución de tráfico

Que un validador de schema aparezca en verde no te dice nada sobre si ChatGPT o Gemini recomiendan realmente tu producto cuando un comprador real pregunta. Esa brecha es la razón por la que las pruebas tienen que incluir la salida real de la IA, no solo la estructura de datos subyacente.

  1. Crea un conjunto representativo de prompts. Incluye prompts de categoría («mejores zapatillas de running para pies planos»), prompts de caso de uso, prompts con presupuesto limitado y prompts de comparación directa frente a competidores.
  2. Ejecuta los prompts mediante simulaciones de agentes y registra si se menciona tu SKU, si el precio citado coincide con la realidad y si el enfoque encaja con la necesidad declarada del comprador.
  3. Etiqueta en analítica el tráfico referido por IA y realiza un seguimiento de la tasa de conversión por separado del tráfico orgánico o de pago.
  4. Vuelve a escanear con una cadencia regular. Las recomendaciones cambian según el prompt, el mercado y el estado del inventario, así que un buen resultado hoy no garantiza el mismo resultado la próxima semana.

Una única respuesta favorable de IA no es un informe de posicionamiento. Los resultados varían según la formulación del prompt, el idioma, el mercado y el stock actual, que es precisamente la razón por la que el análisis de NIQ sobre las compras impulsadas por IA plantea el verdadero cambio estratégico como pasar de la cuota de búsqueda a la cuota de recomendación, algo que debe medirse repetidamente, no una sola vez.

07

Lista de comprobación práctica: pasos priorizados para los próximos 7 a 30 días

Lista de comprobación práctica: pasos priorizados para los próximos 7 a 30 días

  1. Audita tu catálogo para garantizar IDs estables y corrige cualquier relación entre variantes que esté rota o duplicada.
  2. Sincroniza los valores del feed, la página y el checkout para el precio, la divisa y la disponibilidad.
  3. Corrige el marcado JSON-LD para que se renderice en el servidor y coincida con el contenido visible de la página.
  4. Enriquece las descripciones de producto escuetas con atributos concretos y lenguaje orientado a casos de uso.
  5. Realiza una prueba básica de simulación con tus 20 SKU principales para ver el comportamiento actual de recomendación de la IA.
Tarea Responsable habitual Métrica de éxito
Auditoría de IDs estables Responsable de catálogo Cero SKU duplicados o renombrados
Sincronización feed/página/checkout Desarrollador Tasa de coincidencia de precio/disponibilidad
Correcciones de JSON-LD Desarrollador El marcado coincide con la página visible
Enriquecimiento de descripciones Responsable de catálogo Integridad de atributos por SKU
Prueba de simulación Responsable de marketing/ecommerce Tasa de menciones de SKU en el conjunto de prompts
08

Cómo usan los sistemas de IA los controles de elegibilidad frente a los datos del producto

Cómo usan los sistemas de IA los controles de elegibilidad frente a los datos del producto

Un registro de producto completo y preciso y un producto elegible son dos cosas distintas, y los comerciantes las confunden habitualmente.

Los datos del producto, el precio, la disponibilidad, las imágenes y las descripciones responden a la pregunta «qué es este producto y si actualmente puede venderse en principio». Las marcas de elegibilidad responden a una pregunta más limitada y distinta: «si este sistema específico debe mostrar o tramitar este producto específico ahora mismo». La documentación de Agentic Commerce de OpenAI separa esto deliberadamente, con is_eligible_search controlando la capacidad de descubrimiento y is_eligible_checkout controlando si una transacción puede completarse realmente dentro del agente.

Esta distinción confunde a muchos comerciantes que asumen que corregir su feed corrige automáticamente la visibilidad. No es así. Un producto con datos perfectos pero con una marca de elegibilidad sin configurar o mal configurada sencillamente no aparecerá, por muy sólido que sea el registro subyacente. A la inversa también es cierto: un producto puede ser técnicamente elegible pero estar mal descrito, lo que hace que aparezca pocas veces o que se descarte rápidamente en una comparación.

La implicación práctica es que la revisión de elegibilidad necesita su propio elemento en la lista de comprobación, separado de la revisión de calidad de datos. Trátala como una puerta de control que verificas de forma explícita, en lugar de como una suposición que se deriva automáticamente de un catálogo limpio. Los comerciantes que operan en varios mercados deben verificar las marcas de elegibilidad por mercado, ya que una marca correctamente configurada para el envío del feed de una región no se aplica automáticamente a todos los lugares donde se distribuye el mismo catálogo.

09

Consideraciones de privacidad y cumplimiento de datos con la IA y las fuentes de datos de compras

Consideraciones de privacidad y cumplimiento de datos con la IA y las fuentes de datos de compras

Los datos de comportamiento de origen propio son la información de personalización más valiosa a la que tienen acceso los sistemas de compra con IA, y también son los más sensibles desde el punto de vista legal.

El consentimiento es la base. Las señales de comportamiento, el historial de navegación, los patrones de compra y las interacciones en el sitio solo pueden alimentar los modelos de personalización cuando los compradores han aceptado realmente ese uso, y las normas aplicables difieren según la jurisdicción (los regímenes de protección de datos en la UE, las leyes estatales de privacidad en EE. UU. y otras establecen cada uno su propio umbral). Los comerciantes que operan en varios mercados necesitan hacer un seguimiento de qué estándar de consentimiento se aplica a cada segmento de clientes en lugar de aplicar una única política general.

La minimización de datos también importa aquí. Proporcionar a un sistema de IA más detalle de comportamiento del que realmente requiere un caso de uso de personalización no mejora de forma significativa las recomendaciones. Solo amplía su exposición al cumplimiento normativo. La misma lógica se aplica a los datos de reseñas: agregar y anonimizar las señales derivadas de reseñas antes de que entren en cualquier canal de recomendaciones reduce el riesgo sin reducir de forma significativa su utilidad.

El intercambio de datos con terceros merece un escrutinio especial. Cuando un feed o una API envía datos de compradores a una plataforma externa de IA para su procesamiento, esa transferencia en sí misma puede activar requisitos de divulgación o contractuales según la plataforma y la jurisdicción. Los comerciantes deberían tratar cualquier nueva integración con una plataforma de compras con IA del mismo modo que tratarían una nueva integración de procesador de pagos: una revisión del intercambio de datos antes del lanzamiento, no después.

10

Desafíos de integración al combinar múltiples fuentes de datos para modelos de compra con IA

Desafíos de integración al combinar múltiples fuentes de datos para modelos de compra con IA

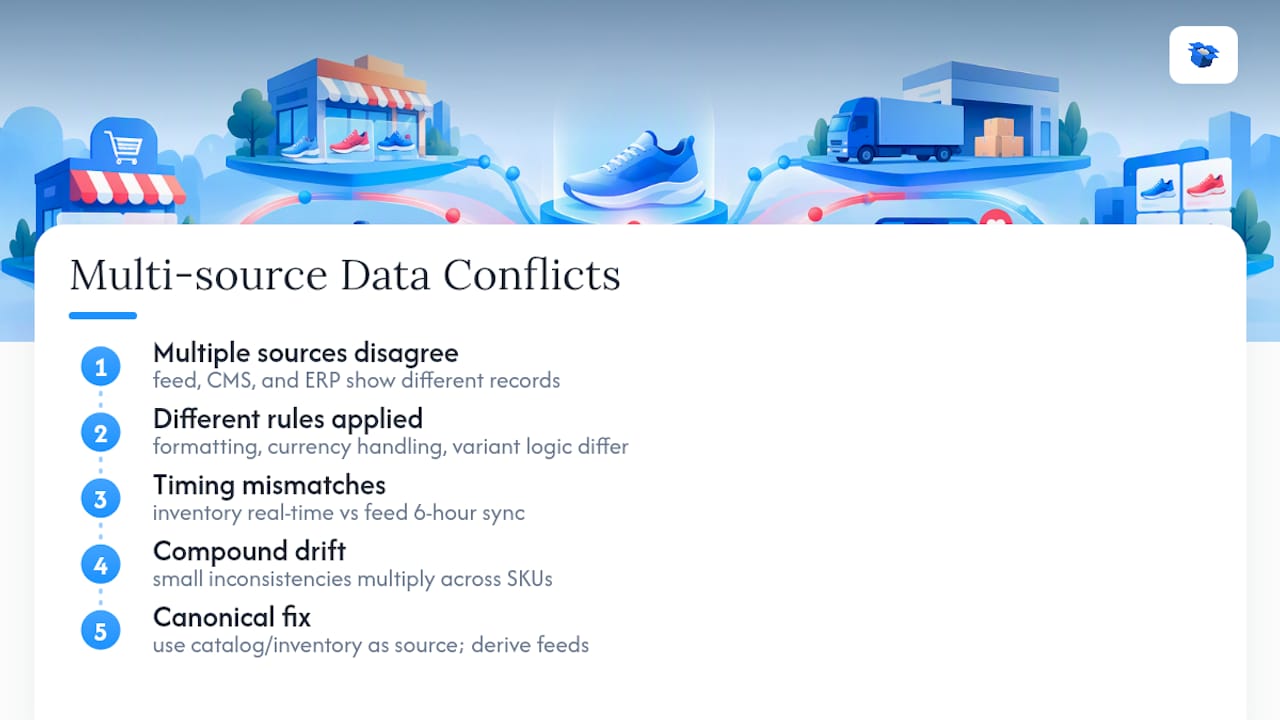
Todos los comerciantes acaban chocando con el mismo muro: el feed dice una cosa, el CMS dice otra y el sistema ERP discrepa de ambos.

El desafío principal no es recopilar datos. Es conciliar registros que se crearon para fines distintos y nunca se diseñaron para coincidir. Un feed creado para Google Shopping y un feed creado para una plataforma de comercio con IA pueden extraer de la misma base de datos de origen, pero aplicar reglas de formato diferentes, una gestión de divisas distinta o una lógica diferente de agrupación de variantes. Las pequeñas inconsistencias se acumulan rápidamente en un catálogo de miles de SKU.

Los desajustes de tiempo empeoran esto. Si su sistema de inventario se actualiza en tiempo real pero su feed solo se sincroniza cada seis horas, existe una ventana en la que un agente de IA trabaja con datos que ya son incorrectos. La guía de Google sobre datos estructurados y actualizaciones automáticas es clara al respecto: la frescura no es opcional, y los ritmos de actualización desajustados entre sistemas crean exactamente los conflictos que erosionan la confianza de la IA en un listado.

La solución práctica es establecer una única fuente canónica de verdad, normalmente el sistema de inventario o de gestión de catálogo, y tratar cada feed descendente como una salida derivada en lugar de como un registro mantenido de forma independiente. Cualquier edición manual realizada directamente en un archivo de feed sin actualizar el sistema de origen crea una desviación que es casi imposible de rastrear más tarde. Los comerciantes que usan Shopify o WooCommerce con múltiples canales de venta deberían auditar en cuántos lugares viven realmente los datos de precio y stock antes de asumir que sus sistemas están sincronizados.

Desafíos de integración al combinar múltiples fuentes de datos para modelos de compra con IA — diagrama general

11

Papel de los proveedores de datos agregados de terceros y su fiabilidad

Papel de los proveedores de datos agregados de terceros y su fiabilidad

Los agregadores que extraen datos de productos de múltiples minoristas y los normalizan en un único feed desempeñan un papel real en el ecosistema de compras con IA, pero su fiabilidad varía más de lo que la mayoría de los comerciantes asumen.

El atractivo es directo: en lugar de mantener feeds separados para cada canal, un comerciante puede enviar un único feed a un agregador y dejar que este redistribuya los datos normalizados hacia fuera. El riesgo es que la normalización es un proceso de traducción, y la traducción siempre introduce la posibilidad de error. Una actualización de precio por tu parte puede tardar más en propagarse a través de un agregador de lo que tardaría mediante un feed directo, y ese retraso es exactamente el tipo de desactualización que erosiona la confianza de la IA en la recomendación.

La fiabilidad también depende en gran medida de la frecuencia con la que el propio agregador vuelve a sincronizarse con tus datos de origen, y esa cadencia no siempre es visible para ti como comerciante. Antes de depender de un agregador como canal principal de distribución para la visibilidad en compras con IA, merece la pena confirmar que su frecuencia de actualización coincide con tu propia volatilidad, y no solo con su promesa de marketing de sincronización en “tiempo real”.

La postura más segura es tratar los datos distribuidos por agregadores como un canal secundario que debe coincidir con tu feed directo y el marcado de tu página, no como un sustituto de mantener tú mismo esos canales directos. Cuando los tres discrepan, la versión del agregador es aquella en la que un sistema de IA tiene menos motivos para confiar, porque es la que está más alejada de la fuente original.

12

Impacto de la calidad de los datos en las recomendaciones de IA en escenarios de compra

Impacto de la calidad de los datos en las recomendaciones de IA en escenarios de compra

La calidad de los datos no solo afecta a si un sistema de IA encuentra tu producto. Determina si el sistema confía lo suficiente en él como para recomendarlo por encima del listado de un competidor.

Un producto puede ser técnicamente detectable, estar indexado, ser apto para feeds, ser estructuralmente válido y aun así perder oportunidades de recomendación porque sus atributos están incompletos, sus variantes son ambiguas o su precio se ha quedado silenciosamente desactualizado. La especificación de comercio de OpenAI lo plantea de forma directa: medir solo la validez de los datos no es suficiente, porque los resultados observados de recomendación pueden divergir de lo que predeciría una comprobación limpia del esquema.

Los registros contradictorios entre distintas fuentes agravan el problema. Cuando tu feed, el marcado de tu página y un listado de un minorista describen todos el mismo producto de forma ligeramente distinta, un sistema de IA no promedia esas diferencias. Trata la discrepancia como una señal de falta de fiabilidad, lo que reduce la confianza general en cada campo asociado a ese SKU, tal como la especificación de Merchant Center de Google confirma de manera efectiva mediante su énfasis en la consistencia entre fuentes.

El efecto acumulativo es lo que más importa aquí. Un campo de atributo débil rara vez hunde un listado por sí solo. Pero un catálogo con docenas de pequeñas incoherencias, un precio desactualizado aquí, un atributo de variante ausente allí, una descripción que nunca menciona un caso de uso clave, se acumula hasta formar un patrón que los sistemas de IA aprenden a relegar. Corregir la calidad de los datos no es un proyecto puntual de limpieza. Es una disciplina continua que genera rendimientos acumulativos cuanto más tiempo se mantiene.

13

Perspectiva del editor: por qué la simulación supera a la validación pura

Perspectiva del editor: por qué la simulación supera a la validación pura

Los validadores de esquemas confirman la sintaxis. No pueden decirte que un agente de IA omite tu producto porque la descripción esconde el único atributo por el que realmente preguntó un comprador. La simulación revela esa brecha, y un ciclo de diagnosticar, reescribir, publicar y volver a probar la cierra más rápido que cualquier auditoría estática. Los comerciantes que ejecutan este ciclo de forma repetida tienden a detectar desviaciones, discrepancias de precio, descripciones escasas y variantes ambiguas antes de que les cueste una temporada de recomendaciones perdidas, no después.

— Xhurian

14

Cómo Ecentic convierte las correcciones de datos en mejoras en las recomendaciones de IA

Cómo Ecentic convierte las correcciones de datos en mejoras en las recomendaciones de IA

Corregir feeds y marcado de forma aislada es hacer conjeturas si no tienes una manera de ver cómo responden realmente ChatGPT, Gemini o Perplexity a tu catálogo en este momento. Algunas plataformas cierran ese ciclo: simulan prompts de compra reales frente a tu tienda, muestran exactamente dónde un listado gana o pierde frente a la competencia en lenguaje claro y te permiten publicar la corrección directamente en Shopify o WooCommerce con un solo clic.

Ecentic

El UCP Playground te permite probar cualquier tienda frente a agentes de compra con IA antes de comprometerte a una reescritura, para que sepas qué SKU necesitan atención en lugar de adivinarlo. Una vez que ves las carencias, las herramientas de optimización de fichas de producto de Ecentic generan la corrección y la publican, y después vuelven a escanear para confirmar que la tasa de recomendación realmente ha cambiado.

Empieza con un escaneo gratuito para ver dónde se encuentra actualmente tu catálogo y después compara los planes en la página de precios, que enumera varias opciones de suscripción junto con una comisión por rendimiento por cada pedido atribuido a la IA.

15

Especificaciones y documentación autorizadas para consultar a continuación

Especificaciones y documentación autorizadas para consultar a continuación

Para obtener detalles de implementación más allá de esta guía, ve directamente a la fuente. La especificación Agentic Commerce de OpenAI cubre la estructura del feed y la elegibilidad, mientras que la guía de datos estructurados de Google cubre la validación del marcado y las propiedades obligatorias para un descubrimiento preciso.

16

Fuentes

Fuentes

Las imágenes y las descripciones en texto libre contienen información real que utilizan los sistemas de IA, pero son más difíciles de validar que un campo de precio estructurado, y esa diferencia crea puntos ciegos que los comerciantes pasan por alto de forma habitual.

Las imágenes de producto hacen más que decorar una ficha. Los sistemas de IA multimodales pueden extraer atributos directamente de las imágenes, color, textura del material, tamaño aproximado en relación con otros objetos del encuadre, cuando faltan campos de atributos estructurados o están incompletos. Eso es útil, pero también significa que una imagen de archivo genérica o de baja calidad puede jugar activamente en tu contra al aportar señales visuales vagas o engañosas allí donde un atributo de texto claro habría sido más fiable.

Las descripciones en texto libre conllevan un riesgo similar en la otra dirección. Una descripción escrita para la densidad de palabras clave SEO en lugar de un lenguaje de atributos claro («calidad prémium, la mejor de su clase, valor increíble») no ofrece a un sistema de IA casi nada concreto que extraer. Una descripción que indique el material, las dimensiones y el caso de uso específico le da mucho con lo que trabajar, incluso sin un solo campo estructurado que la respalde.

El enfoque práctico es tratar el contenido no estructurado como un complemento de los datos estructurados, nunca como un sustituto. Escribe descripciones que indiquen atributos concretos en lenguaje claro y utiliza imágenes que muestren claramente los atributos del producto que importan para la categoría, referencia de tamaño para muebles, textura para tejidos, escala para electrónica. Cuando existan campos estructurados, asegúrate de que el texto y el contenido de la imagen no los contradigan.

  • Especificación del feed de productos – Agentic Commerce | OpenAI Developers
  • Especificación de datos de producto - Ayuda de Google Merchant Center
  • Análisis de NIQ: compras personalizadas con IA y descubrimiento de productos
17

Preguntas frecuentes

Preguntas frecuentes

¿Necesito tanto un feed de producto como marcado de datos estructurados?

Sí. Los feeds y los datos estructurados sirven a sistemas diferentes y actúan como comprobaciones cruzadas entre sí; depender solo de uno deja huecos que los agentes de IA pueden interpretar como una inconsistencia. La especificación de datos de producto de Google trata los valores coherentes en ambos como un requisito básico, no como una opción.

¿Con qué frecuencia debo actualizar los datos de precio y disponibilidad?

La frecuencia debe ajustarse a la volatilidad: cada hora o en el mismo día para inventario de rápida rotación, y diariamente como mínimo para artículos de catálogo estables. Los valores desactualizados son una de las causas más comunes de pérdida de recomendaciones de IA, según las directrices de Merchant Center de Google.

¿Pueden las reseñas sustituir la necesidad de datos precisos en el feed?

No. Las reseñas aportan evidencia de calidad y casos de uso, pero nunca sustituyen los datos autoritativos de precio o inventario, que siguen siendo responsabilidad del feed independientemente de lo sólida que sea la señal de las reseñas.

¿Cómo pruebo lo que los agentes de IA realmente recomiendan para mis productos?

Crea un conjunto representativo de prompts de compra que cubran escenarios de categoría, presupuesto y comparación, y luego ejecútalos a través de una simulación de agente como el UCP Playground de Ecentic para ver directamente las menciones de SKU y la precisión del precio.

¿Cuánto cuesta Ecentic para una pequeña tienda ecommerce?

El plan Compete de Ecentic empieza en $14,90 al mes, con Scale en $44,90 y Dominate en $149, además de una opción de pago por uso con una comisión del 3% por pedido atribuido a IA, todo ello indicado en la página de precios.

estado del inventario para IAcómo la IA cambia las comprasfuentes de datos compras ia
Volver al blogGet started

Guías e investigación para ganar con agentes de compras con IA.

Que te elija la IA

¿Listo para ser el producto que recomiendan los agentes?

Instálalo gratis en Shopify o WooCommerce y mira tu puntuación de IA en minutos.

Instalar en ShopifyInstalar en WooCommerce
ecentic

Gana el carrito de cada agente de compras con IA.

Hecho para la economía de agentes
Producto
  • Funciones
  • Cómo funciona
  • Precios
  • Fichas de producto
Plataformas
  • Shopify
  • WooCommerce
  • Enterprise
Recursos
  • Documentación
  • Referencia de la API
  • Recursos
  • Blog
  • Compare
  • UCP Validator
  • Escáner WebMCP
  • UCP Playground
  • Reservar una demo
Empresa
  • Soporte
  • Instrucciones para IA
  • Política de privacidad
  • Términos de servicio

© 2026 ecentic. Todos los derechos reservados.

Hecho para comercios que se niegan a ser invisibles para la IA.