Qué evalúan realmente los benchmarks
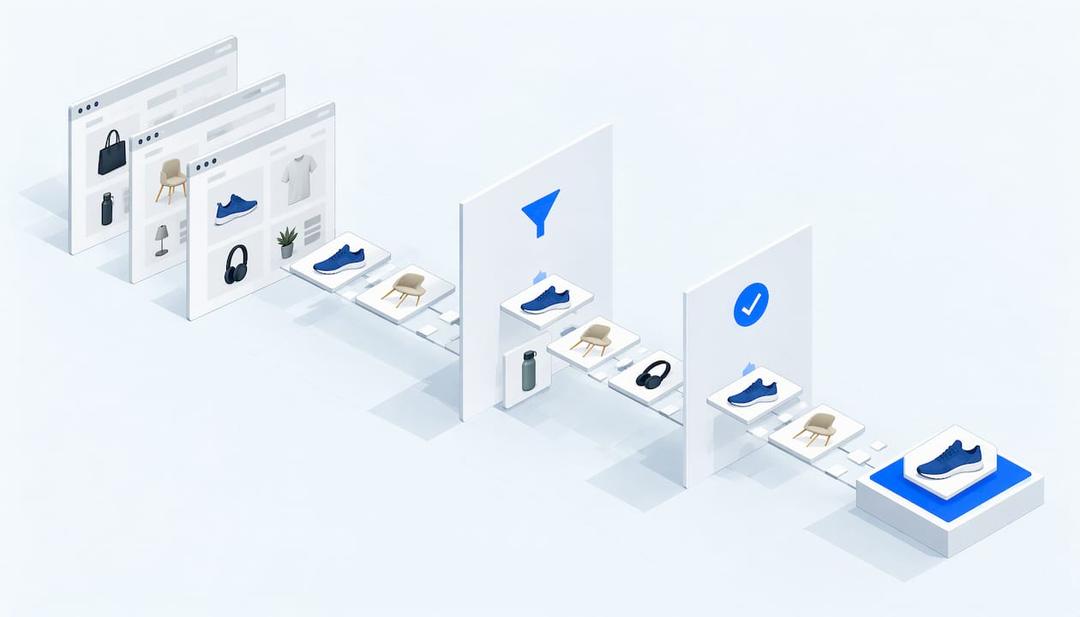
Un investigador de Rezolve publicó un artículo para el workshop de RecSys 2026 que evalúa 12 modelos como agentes conversacionales de compra a lo largo de todo el ciclo de búsqueda, aclaración, recomendación y añadir al carrito. Puntúa 1.200 conversaciones (cinco ejecuciones en 20 escenarios) utilizando un juez LLM de cinco rúbricas, además de métricas de comportamiento leídas de los rastros de conversación. Las rúbricas cubren la comprensión de la intención, la aclaración, la calidad de la recomendación, la corrección al añadir al carrito y el grounding. El grounding es la cuestión simple de si las afirmaciones del agente coinciden con los datos de producto que se le proporcionaron.
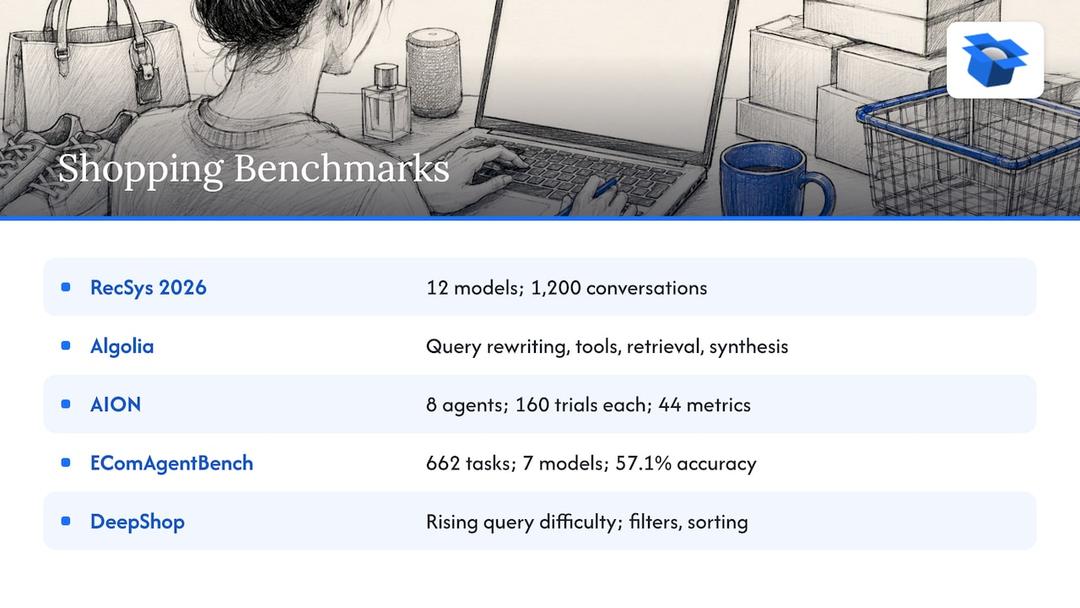
La clasificación de Algolia adopta una perspectiva similar desde el lado de la búsqueda. Cada modelo se ejecuta dentro de un agente de recuperación en producción y se puntúa en reescritura de consultas, llamadas a herramientas, recuperación y síntesis de respuestas, leyendo el texto de la respuesta, las llamadas a herramientas y los registros recuperados. Así que el modelo se evalúa como parte de un sistema, no como si fuera un concursante de trivial.
El artículo de AION va aún más lejos en cuanto a rigor. Construye un entorno de compra determinista donde la persona cliente, la dificultad y el carrito objetivo de cada prueba se fijan de antemano, y luego prueba ocho agentes de pesos abiertos con 160 pruebas cada uno y 44 métricas. Su punto útil es que un aprobado o suspenso al final oculta qué salió mal. Mantener el rastro de herramientas y el estado del entorno le permite separar la falta de acción, la compra excesiva, los atributos de producto no respaldados y una mala búsqueda. Son cuatro fallos distintos que todos parecen «el agente se equivocó».
EComAgentBench, del Industry Track de EMNLP 2026, utiliza 662 tareas construidas sobre productos y reseñas reales de Amazon. Los requisitos están repartidos entre una consulta visible, un perfil oculto y una aclaración guionizada, y el agente debe comprometerse con un único producto. Incluso el más fuerte de los siete modelos alcanzó solo un 57,1% de precisión global, y los resultados empeoraron a medida que los requisitos pasaban de fuentes visibles a fuentes ocultas.
DeepShop, de la Universidad de Ámsterdam, evalúa agentes web sobre consultas de compra con dificultad creciente. Su hallazgo es que la recuperación simple tiene dificultades con consultas complejas, y otros métodos tropiezan con los filtros y las preferencias de ordenación.
Leídos en conjunto, estos artículos dicen lo mismo con distintos matices. Comprar es una tarea de varios pasos, los agentes fallan de formas específicas y diagnosticables, y un modelo que suena seguro aún puede elegir el artículo equivocado. Lo cual es más o menos como compramos muchos de nosotros después de medianoche, así que al menos las máquinas resultan cercanas.