

Que les gens recherchent sur Google, aillent sur Amazon ou interrogent un chatbot, l’IA leur renvoie désormais une réponse qui contient un produit, et la plupart des marques e-commerce n’ont aucune idée de la manière de devenir ce produit. La qualité des données produit pour l’IA signifie que vos titres, spécifications, identifiants, prix et statuts de stock sont complets, cohérents partout où ils apparaissent et lisibles par des logiciels. Corrigez cela, et un agent pourra comparer votre produit à celui d’un concurrent et choisir le vôtre.
Le plus amusant, je trouve, c’est le temps que nous avons tous passé à peaufiner les pages d’accueil. L’agent ne voit jamais la vôtre. Il lit le flux produit, le catalogue et les données structurées sur les fiches produit, puis passe à autre chose dès qu’il manque quelque chose. Votre bannière principale est magnifique, et personne ne la regarde.
En bref
- Les agents IA comparent les produits à partir des champs du flux, des données du catalogue et des données structurées sur les fiches produit, pas de votre page d’accueil ni de votre histoire de marque.
- Les champs manquants, incohérents ou obsolètes (spécifications, identifiants, prix, disponibilité) sont les raisons les plus fréquentes pour lesquelles un agent ignore un produit.
- Le flux et le balisage de la page doivent dire la même chose. Google utilise les deux et vérifie l’un par rapport à l’autre.
- Commencez par auditer les incohérences qui pourraient amener un acheteur à faire le mauvais choix : identité, adéquation, offre, destination.
- Commencez petit : un scan gratuit d’ecentic couvre vos 10 meilleurs produits et montre quel concurrent vous bat et pourquoi.
Ce que signifie la qualité des données produit quand l’agent est l’acheteur
Pour un humain, une fiche produit est une histoire avec des photos. Pour un agent, c’est une fiche. L’agent pose une question simple : cette fiche me dit-elle ce qu’est l’article, s’il correspond à la demande, combien il coûte, s’il est en stock et où l’acheter ?
Un article de 2026 sur la découverte de produits par l’IA avance un point prudent point nuancé : des données produit complètes peuvent augmenter la probabilité qu’un système assisté par IA évalue un produit et le fasse remonter, mais cela ne prouve pas qu’un produit moins connu battra une grande marque. Je suis d’accord avec cette formulation. Des données propres sont le ticket d’entrée. Ce n’est pas une garantie.
Jager Robinson de LogicBroker ajoute une observation utile dans un article de 2026 sur la qualité des données produit : les gagnants de la découverte pilotée par l’IA ne sont souvent pas ceux qui ont les plus gros budgets marketing, mais ceux dont les données sont suffisamment propres, structurées et cohérentes pour que les modèles puissent les lire et leur faire confiance. La plupart des catalogues ont été conçus pour mettre les produits en ligne rapidement, la complétude étant un bonus appréciable. Ce compromis ne coûtait pas cher auparavant. Ce n’est plus le cas.
Les quatre éléments qu’un agent vérifie
Je trouve plus simple de raisonner en quatre questions, qui correspondent au cadre d’audit du rapport sur l’état de préparation au shopping par IA:
- Identité. De quel produit exact et de quelle variante s’agit-il ? Les identifiants et l’image principale répondent à cette question.
- Adéquation. Correspond-il à ce que l’acheteur demande ? Les attributs, la compatibilité et les éléments justificatifs répondent à cette question.
- Offre. Quel est le prix, dans quelle devise, le produit est-il disponible et sous quelles conditions ?
- Destination. Le lien mène-t-il à la bonne fiche produit avec un parcours d’achat fonctionnel ?
Si l’un de ces quatre éléments est erroné, l’agent soit devine, soit passe son chemin. Deviner est pire pour vous, car un mauvais prix ou une mauvaise taille affichés à un acheteur se transforment en retour ou en commande perdue.
Pourquoi les lacunes poussent les agents à vous ignorer
LogicBroker décrit ces échecs comme prévisibles à grande échelle : les spécifications sont incomplètes, les descriptions sont bourrées de mots-clés, les attributs sont renseignés de manière inégale selon les SKU et un même produit porte des noms différents selon les canaux. Leur résumé est simple : un modèle ne contourne pas les lacunes, il passe au suivant.
Google dit quelque chose de similaire avec ses propres mots. La spécification de Google spécification des données produit de Merchant Center indique que des informations produit incorrectes, imprécises ou manquantes peuvent entraîner des refus, une éligibilité limitée ou des affichages erronés, et que des données exactes et correctement formatées sont essentielles pour les annonces et les fiches gratuites dans les formats alimentés par l’IA.
Il existe aussi un échec plus discret : des données accessibles à un humain mais pas à un agent. Core dna a décrit un test sur un site Clark Rubber où les informations au niveau produit étaient récupérables tandis que le stock au niveau magasin restait derrière une interaction que le chemin de récupération n’exposait jamais. Une personne clique sur un sélecteur de magasin et voit le stock. L’agent, lui, ne clique sur rien. C’est logique, c’est un robot, mais c’est quand même lui qui décide qui remporte la vente.
Ce que nous voyons dans nos propres simulations
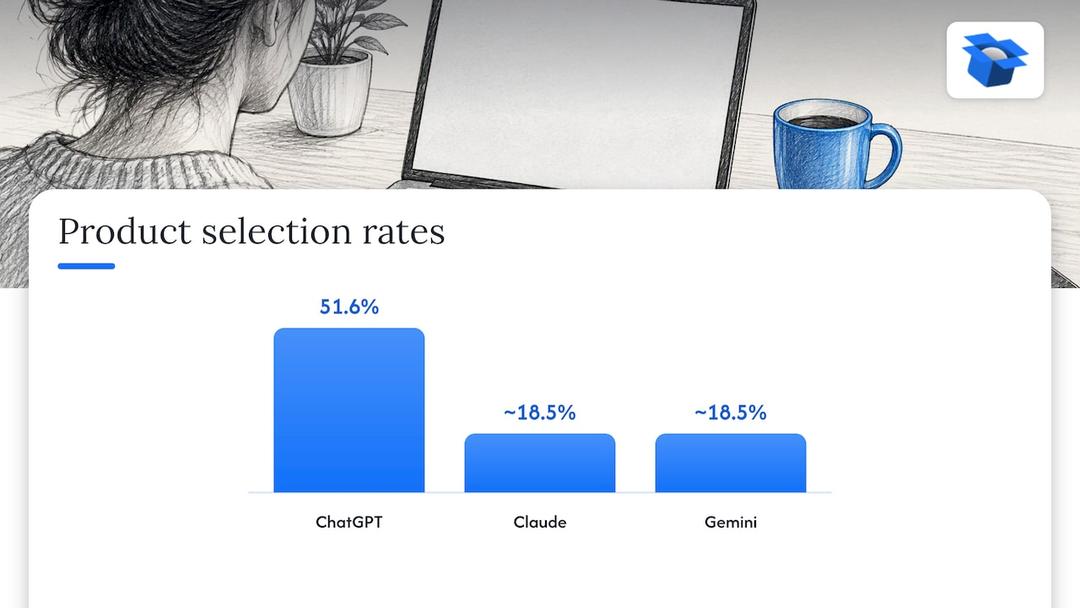
Ces chiffres viennent d’ecentic, issus de nos propres simulations, donc lisez-les comme tels. En octobre 2026, nous avions exécuté 36 797 achats simulés. Sur le même catalogue, ChatGPT sélectionnait le produit environ trois fois plus souvent que Claude ou Gemini, avec 51,6 % contre environ 18,5 %. Donc « l’IA » n’est pas un acheteur unique. Chaque modèle pondère vos données différemment, et une fiche qui gagne dans l’un peut perdre dans un autre.
Dans un audit anonyme, une marketplace de spiritueux réalisant environ 70 M€ par an présentait un défaut dans les données lues par les agents sur 88 % de ses 9 699 produits. Lorsque les agents ont été invités à indiquer où acheter deux bouteilles qu’elle avait en stock, elle est apparue 0 fois sur 20. Personne ne l’avait remarqué, car le site était très réussi.
Un autre audit, réalisé pour une marque suédoise de soins de la peau, a montré que les paiements par agents atteignaient l’étape de paiement dans 0 pays sur 6, car un paramètre de livraison demandait un numéro de téléphone. Un agent qui remplit un panier n’a pas le numéro de téléphone de votre client. C’était un paramètre minuscule, et il bloquait chaque commande.
Quelles spécifications et quels attributs fournir
Commencez par ce que les plateformes elles-mêmes demandent. La spécification de flux produit d’OpenAI spécification du flux produit exige item_id, title, description, url, brand, seller_name, image_url, availability et price. Elle liste aussi des champs facultatifs pour condition, product_category, material, color, size, gender, age_group, dimensions et weight. Facultatif est le mot poli. Quand deux produits sont en concurrence, celui dont le matériau et les dimensions sont renseignés est plus facile à faire correspondre à une demande précise.
Xorosoft défend une approche pratique dans son guide des données pour agents d’achat : l’exhaustivité factuelle compte plus que le langage promotionnel, et les attributs structurés facilitent la comparaison parce que le logiciel n’a pas besoin de déduire les détails à partir du texte. Leur exemple : un acheteur cherche un bureau en noyer de moins de 50 pouces de large. La correspondance est bien plus fiable lorsque le matériau et la largeur sont des champs, et non des adjectifs dans un paragraphe.
Photoroom propose une structure de fiche produit en sept couches que je trouve utile comme checklist :
| Couche | Contenu |
|---|---|
| Titre | Type de produit, marque, modèle, matériau, couleur, taille, capacité |
| Attributs structurés | Couleur, taille, matériau, genre, état, compatibilité, dimensions |
| Description | Construction, performances, éléments inclus, usage prévu, entretien |
| Identifiants | GTIN, MPN, SKU, ID de groupe d’articles |
| Données d’offre | Prix, devise, disponibilité, état, livraison, retours |
| Images | Principale, angles alternatifs, détails, mise en situation |
| Cohérence entre page et flux | Correspondance du prix, du stock, du titre, de la variante, de l’image et de l’URL |
Remarquez ce qui manque : les slogans. Un titre comme « The Only Mug You’ll Ever Need » ne dit rien à un agent. « Mug à café en grès, 12 oz, noir mat, compatible lave-vaisselle » lui donne tout ce qu’il peut comparer. Si vous voulez approfondir le sujet des titres et descriptions, notre guide sur l’optimisation des fiches produit couvre la partie réécriture.
Le flux et les données structurées de la page doivent correspondre
La plupart des boutiques maintiennent deux versions de la vérité : le flux produit et les données structurées (JSON-LD, un bloc lisible par machine) sur la fiche produit. Elles divergent plus vite que quiconque ne veut l’admettre.
La documentation Search Central de Google indique que fournir à la fois des données structurées et un flux Merchant Center maximise l’éligibilité et aide Google à vérifier les données. Certaines expériences combinent les deux, donc les extraits produit peuvent récupérer le prix depuis le flux lorsque le balisage de la page ne le contient pas. La page d’aide de Merchant Center ajoute aussi les règles qui piègent souvent les équipes : le balisage doit être présent dans le HTML renvoyé par le serveur, et non généré par JavaScript, il doit correspondre à ce que voit l’utilisateur, les pages doivent contenir un objet Product avec une offre Offer imbriquée, et le prix utilise un point comme séparateur décimal.
Le blog Universal Commerce Protocol liste les propriétés minimales du schéma Product pour le commerce avec agents IA : name, description, sku ou gtin13, brand, image, offers avec price et availability, ainsi que aggregateRating. Il recommande d’ajouter weight, height, width, depth, color, size, category et additionalProperty pour les attributs spécifiques au type de produit. Si vous débutez avec le balisage lui-même, un guide simple sur le fonctionnement du balisage schema peut aider, et un tutoriel pas à pas sur l’ajout d’un balisage produit inclut un exemple prêt à copier.
| Flux produit | Données structurées de la page | |
|---|---|---|
| Emplacement | Importé dans un canal comme Merchant Center | Dans le HTML de chaque fiche produit |
| Le plus adapté pour | Prix, stock et identité à grande échelle, maintenus à jour | Permettre aux systèmes de vérifier que la page correspond au flux |
| Échec typique | Prix ou stock obsolète | Offer manquante, balisage uniquement généré en JavaScript |
| Responsable habituel | Équipe growth ou gestion des canaux | Développeur ou thème |
BBQ Growth Lab présente bien cela comme quatre couches : les données source (PIM, ERP, inventaire, tarification), un modèle produit normalisé, les sorties par canal (HTML de page, JSON-LD, flux) et une couche de retour avec statuts, avertissements et rejets. Leur règle : aucun flux de plateforme ne doit écraser silencieusement les données source. Je pense qu’ils ont raison, et c’est précisément la règle que la plupart des petites boutiques enfreignent la première fois que quelqu’un modifie un titre directement dans un canal de vente.
Précision utile : les données structurées ne garantissent pas une recommandation. Core dna le formule justement en expliquant qu’elles donnent aux systèmes d’IA de meilleures informations commerciales à exploiter, tandis que la découverte dépend toujours de la pertinence, du contexte et d’autres signaux. De même, avoir une API ne signifie pas qu’un agent peut réellement l’utiliser, sauf si celui-ci dispose d’un moyen pris en charge pour le faire.
Pour notre propre approche du balisage, consultez la checklist de données structurées pour les fiches produit et l’article sur le schéma produit validé par simulation.
Comment auditer votre catalogue
Vous n’avez pas besoin de corriger 10 000 produits dès le premier jour. Corrigez ceux pour lesquels une incohérence pourrait pousser un acheteur à faire le mauvais choix. C’est la priorité proposée par First Brand dans son audit de préparation, et c’est un filtre raisonnable.
- Exportez votre flux et sélectionnez vos 20 meilleures ventes. Les petits échantillons révèlent rapidement les tendances.
- Pour chacun, vérifiez l’identité : chaque variante possède-t-elle son propre identifiant, et le titre est-il identique sur votre site, votre flux et les marketplaces ?
- Vérifiez l’adéquation : le matériau, la taille, les dimensions, la compatibilité et l’usage prévu sont-ils renseignés dans des champs, et non enfouis dans du texte ?
- Vérifiez l’offre : comparez le prix, la devise et la disponibilité dans le flux avec ce qu’affiche la page en ligne et ce qu’indique le JSON-LD.
- Vérifiez la destination : cliquez sur l’URL du flux. Elle doit mener à la bonne variante, avec un parcours d’achat qui ne nécessite ni connexion ni numéro de téléphone.
- Demandez à quelques chatbots votre produit comme le ferait un acheteur, et notez qui est cité à votre place.
L’étape 6 est celle où la plupart des équipes bloquent, car elle est lente à faire manuellement et les réponses changent selon le modèle. C’est pour cette raison que nous avons développé la partie simulation d’ecentic. Plus d’informations ci-dessous.
Comment mesurer si vos données sont suffisantes
Il n’existe pas de score unique dans le secteur, donc je garderais une fiche d’évaluation simple à suivre chaque mois. Quatre mesures couvrent l’essentiel :
- Complétude : la part des produits dont tous les champs requis et recommandés sont renseignés.
- Cohérence : la part des produits dont le titre, le prix et la disponibilité correspondent entre le flux, la page et les marketplaces.
- Exactitude : une vérification ponctuelle d’un échantillon par rapport au produit réel, à l’emballage et à la fiche fournisseur.
- Fraîcheur : le délai entre un changement de prix ou de stock dans votre système et ce même changement dans le flux.
Les outils que vous utilisez déjà peuvent aider. Merchant Center affiche des avertissements et des refus au niveau des articles, ce qui constitue une vérification gratuite de cohérence par rapport aux propres règles de Google. La répartition des responsabilités compte aussi. Selon BBQ Growth Lab, l’équipe produit définit les données de référence, les systèmes commerciaux gèrent la vérité des prix et des stocks, l’ingénierie s’occupe de la distribution, et les équipes growth gèrent le mapping des plateformes et les contrôles qualité. Ce qui doit être gouverné, ce n’est pas qui importe le fichier, mais si le prix, le stock, les identifiants, les variantes et les images sont correctement représentés partout.
Pour un déploiement plus long, notre plan sur 30 à 90 jours pour optimiser les fiches produit pour l’IA et l’article sur les sources de données utilisées par le shopping par IA présentent la séquence.
Notre vision de l’évolution du secteur
Nous pensons que les données produit deviennent la vitrine. Lorsqu’une personne demande à un agent de trouver un cadeau, de comparer deux blenders ou de commander à nouveau du café, l’agent lit des fiches. Il ne navigue pas, il ne se laisse pas séduire par une bannière et il ne pardonne pas une taille manquante.
C’est pourquoi ecentic travaille directement sur la boutique : le flux produit, le catalogue et le paiement qu’un agent utilise pour acheter. Nous nous connectons à Shopify, WooCommerce ou à un flux produit. Nous demandons à ChatGPT, Claude et Gemini de comparer chacun de vos produits à celui d’un concurrent identifié, et nous montrons pourquoi le vôtre perd, en langage clair. Lorsque vous cliquez sur Apply, nous réécrivons le titre, la description et les données structurées, puis les publions dans votre boutique.
La partie paiement est importante. L’achat directement dans la réponse IA est actif sur Google AI Mode et Gemini aux États-Unis via UCP, le standard ouvert de Google pour le paiement par agent. Sur WooCommerce, le plugin gratuit ecentic permet aux agents de rechercher des produits, de remplir un panier et de finaliser le paiement via UCP. Sur Shopify, nous poussons les corrections dans Google Merchant Center et suivons les visites provenant des assistants IA. ChatGPT redirige vers le paiement propre à la boutique, donc dans ce cas la fiche produit et le paiement doivent toujours fonctionner pour un agent. OpenAI a ACP, Google a UCP, Amazon a un mur.
Notre premier pilote, DUA Flavours, a vu les visites provenant des assistants IA et le trafic direct augmenter de 12 % entre avril et juillet 2026. Il s’agit d’un chiffre de visites, pas d’un chiffre de ventes, et je tiens à être clair là-dessus. Nous en sommes encore au début et nous menons des pilotes.
Xhurian Shaba
Commencez par un scan gratuit
Si vous préférez voir les lacunes plutôt que lire des explications à leur sujet, le scan gratuit d’ecentic couvre vos 10 meilleurs produits, ne nécessite aucune carte bancaire et montre quel concurrent nommé chaque modèle d’IA préfère, ainsi que pourquoi. Vous pouvez aussi lancer le audit shopping WebMCP gratuit pour votre boutique, et lire comment cela fonctionne avant de connecter quoi que ce soit.

Lorsque vous souhaitez publier les corrections, l’offre Compete coûte 14,90 $ par mois pour jusqu’à 100 produits. Scale coûte 44,90 $ par mois pour jusqu’à 1 000 produits et ajoute les corrections en un clic. Dominate coûte 149 $ par mois et ajoute la synchronisation avec Google Merchant Center ainsi que la configuration du paiement par agent. Il existe également une option à l’usage à 3 % des commandes attribuées à l’IA, plafonnée à 500 $ par mois. Les conditions actuelles figurent sur la page des tarifs, et les catalogues plus importants peuvent consulter Enterprise.
FAQ
Qu’est-ce que la qualité des données produit pour l’IA ?
Il s’agit du niveau de complétude, de cohérence, d’exactitude et de mise à jour de vos fiches produit, ainsi que de leur lisibilité par les logiciels. Les agents comparent les produits à partir de champs tels que le titre, les attributs, les identifiants, le prix et la disponibilité. Une fiche comportant des lacunes est facile à ignorer, donc le produit disposant de la fiche la plus complète a tendance à être le plus facile à recommander.
Quelles spécifications produit comptent le plus pour les agents d’achat IA ?
Commencez par les champs requis par les plateformes : titre, description, marque, image, prix et disponibilité, ainsi que des identifiants comme le GTIN ou le SKU. La spécification du flux d’OpenAI liste aussi le matériau, la couleur, la taille, les dimensions et le poids comme champs facultatifs. Renseignez-les dans des champs séparés, pas uniquement dans la description.
Ai-je besoin à la fois d’un flux produit et de données structurées ?
Oui, car ils remplissent des fonctions différentes. La documentation de Google indique que fournir les deux maximise l’éligibilité et lui permet de vérifier l’un par rapport à l’autre. Gardez-les identiques sur le prix, la disponibilité, le titre et la variante, et assurez-vous que le balisage est présent dans le HTML renvoyé par le serveur.
Des données propres garantissent-elles que l’IA recommandera mon produit ?
Non. Des données propres rendent votre produit lisible et comparable, mais la pertinence, le contexte et d’autres signaux comptent toujours. Ce qu’elles font, c’est éliminer les raisons évitables d’être ignoré, qui sont souvent les moins coûteuses à corriger.
Sources
- Découverte shopping par IA : pourquoi les données produit comptent
- Pourquoi l’IA ne trouve pas vos produits : qualité des données produit
- Préparation au shopping par IA : données produit pour la recommandation
- Spécification des données produit, aide Google Merchant Center
- Optimisation des flux produit pour le shopping et la recherche par IA
- Spécification du flux produit OpenAI
- Données produit pour le shopping par IA : comment se préparer aux agents d’achat
- Comment structurer des fiches produit pour les agents d’achat IA
- Introduction aux données structurées Product sur Google
- Configurer les données structurées pour Merchant Center
- Données structurées pour les agents IA : schema.org, JSON-LD et UCP
- Données structurées produit vs flux
- Le balisage schema expliqué