

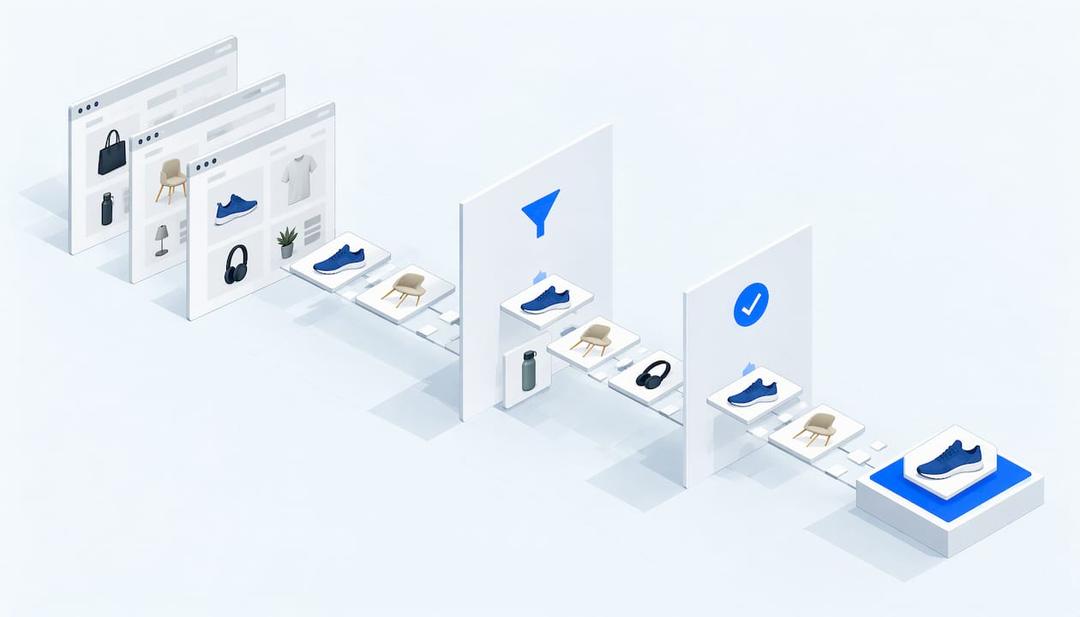
Dans l’e-commerce, l’évaluation des LLM consiste à tester si un modèle de langage exécute correctement de vraies tâches d’achat : trouver le bon produit, le comparer à d’autres et l’ajouter à un panier. Pour une boutique, il en existe deux versions. Vous pouvez tester un chatbot que vous exploitez sur votre propre site, ou tester la façon dont des agents d’achat IA externes traitent vos produits. Que les gens fassent une recherche sur Google, aillent sur Amazon ou posent la question à un chatbot, l’IA leur donne désormais une réponse avec un produit, et la plupart des marques e-commerce n’ont aucune idée de la manière d’être ce produit.
Mon avis : la plupart des discours sur l’évaluation s’adressent aux personnes qui construisent le modèle, et presque jamais à celle qui doit vendre par son intermédiaire. Si vous exploitez une boutique, vous n’avez pas besoin de noter le modèle. Vous devez comprendre pourquoi il choisit le produit de quelqu’un d’autre, et c’est un examen différent : c’est la boutique qui le passe.
TL;DR
- Évaluer un agent d’achat consiste à noter toute la boucle (recherche, clarification, recommandation, ajout au panier), pas des réponses isolées.
- Les recherches actuelles montrent que même des modèles solides échouent sur beaucoup de tâches d’achat ; vos données produit doivent donc compenser davantage que vous ne l’espéreriez.
- Les agents lisent votre flux produit, votre catalogue et vos données structurées, pas votre page d’accueil. Des identifiants manquants, des prix vagues et des caractéristiques non quantifiées font écarter votre produit.
- Pour un propriétaire de boutique, le test utile est un face-à-face : la même question d’acheteur, votre produit contre celui d’un concurrent nommé, le tout répété plusieurs fois.
- Corrigez les données, publiez, relancez. Un scan est un instantané, une série d’exécutions est une preuve.
Deux sens de l’évaluation des LLM dans l’e-commerce
L’expression recouvre deux tâches que les gens confondent.
Le premier consiste à évaluer un LLM que vous déployez : un assistant d’achat sur votre site qui répond aux questions, suggère des produits et les ajoute au panier. Ici, vous choisissez le modèle, vous contrôlez le prompt et vous pouvez voir chaque conversation. La question est de savoir si l’assistant est réellement performant.
Le second consiste à évaluer la manière dont des agents IA tiers traitent votre boutique. Vous ne choisissez pas le modèle. C’est l’acheteur qui le fait, souvent sans le savoir. L’agent ne voit jamais votre page d’accueil. Il lit votre flux produit, votre catalogue et les données structurées des fiches produit, puis décide quel produit présenter à l’acheteur. La question est de savoir si vos produits passent ce filtre.
La plupart des travaux universitaires portent sur le premier cas. Ils restent utiles pour le second, car ils montrent à quoi ressemble une tâche d’achat lorsqu’elle est correctement évaluée, et où les modèles échouent.
Ce que les benchmarks testent réellement
Un chercheur de Rezolve a publié un article pour l’atelier RecSys 2026 qui évalue 12 modèles comme agents conversationnels d’achat sur l’ensemble de la boucle de recherche, clarification, recommandation et ajout au panier. L’étude note 1 200 conversations (cinq exécutions sur 20 scénarios) à l’aide d’un juge LLM basé sur cinq rubriques, auxquelles s’ajoutent des métriques comportementales issues des traces de conversation. Les rubriques couvrent la compréhension de l’intention, la clarification, la qualité des recommandations, la justesse de l’ajout au panier et l’ancrage factuel. L’ancrage factuel revient simplement à vérifier si les affirmations de l’agent correspondent aux données produit qui lui ont été fournies.
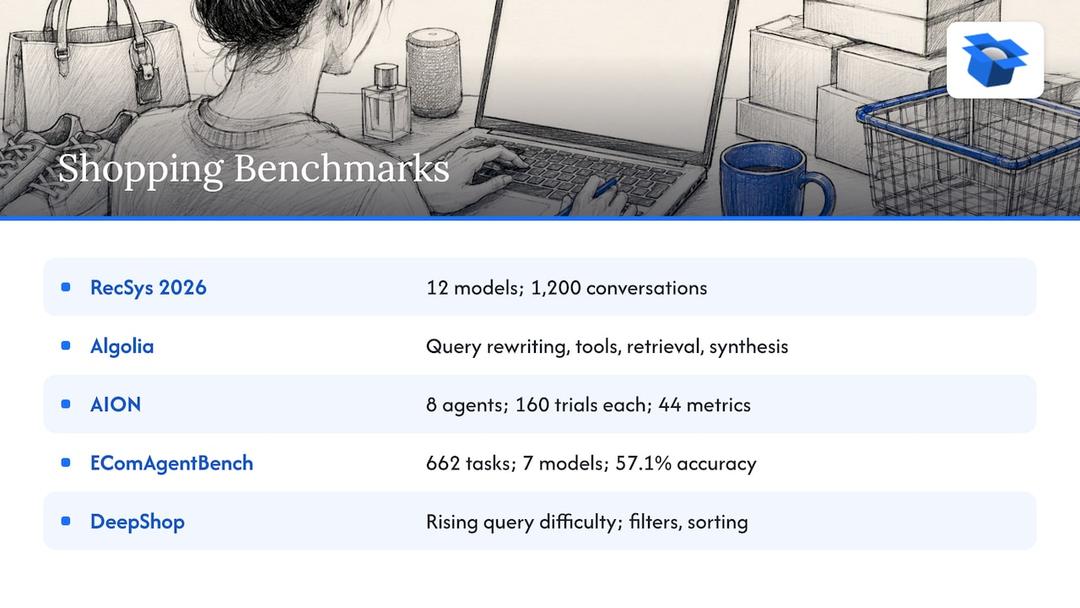
Le classement d’Algolia adopte une approche similaire du côté de la recherche. Chaque modèle fonctionne dans un agent de recherche en production et est évalué sur la réécriture des requêtes, les appels d’outils, la récupération d’informations et la synthèse des réponses, en analysant le texte de réponse, les appels d’outils et les enregistrements récupérés. Le modèle est donc évalué comme partie d’un système, pas comme un candidat à un quiz.
L’article AION va plus loin sur la rigueur méthodologique. Il construit un environnement d’achat déterministe où le profil client, la difficulté et le panier cible de chaque essai sont définis à l’avance, puis teste huit agents dont les poids sont accessibles au public, avec 160 essais chacun et 44 métriques. Son apport utile est de montrer qu’un simple succès ou échec final masque ce qui a réellement dysfonctionné. En conservant la trace des outils et l’état de l’environnement, l’étude distingue sous-action, surachat, attributs produit non pris en charge et mauvaise recherche. Ce sont quatre échecs différents qui ressemblent tous à « l’agent s’est trompé ».
EComAgentBench, issu de la piste Industry Track d’EMNLP 2026, utilise 662 tâches construites à partir de vrais produits et avis Amazon. Les exigences sont réparties entre une requête visible, un profil caché et des clarifications scriptées, et l’agent doit se décider pour un seul produit. Même le meilleur des sept modèles n’a atteint que 57,1 % de précision globale, et les résultats se dégradaient à mesure que les exigences passaient de sources visibles à des sources cachées.
DeepShop, de l’Université d’Amsterdam, teste des agents web sur des requêtes d’achat de difficulté croissante. Sa conclusion est que la simple récupération d’informations peine sur les requêtes complexes, et que les autres méthodes échouent sur les filtres et préférences de tri.
Pris ensemble, ces articles disent la même chose avec des nuances différentes. L’achat est une tâche en plusieurs étapes, les agents échouent de façons précises et identifiables, et un modèle qui paraît sûr de lui peut malgré tout choisir le mauvais produit. Ce qui ressemble finalement assez à notre manière de faire du shopping après minuit, donc au moins les machines restent crédibles.
Les indicateurs qui comptent pour une boutique
Les chercheurs évaluent les modèles. Les commerçants doivent évaluer les résultats. Un bon équilibre ressemble à ceci.
Exactitude de ce que l’agent dit sur votre produit. Un article scientifique sur les assistants conversationnels d’achat définit l’exactitude des informations produit pour le prix, le stock et les caractéristiques, l’exactitude des fourchettes de prix et l’exactitude des descriptions de caractéristiques. Si un agent affiche le mauvais prix ou invente une fonctionnalité, aucune métrique de classement ne sauvera la vente.
Taux de sélection. Sur plusieurs exécutions de la même question d’acheteur, à quelle fréquence l’agent choisit-il votre produit plutôt qu’une alternative ? C’est le chiffre qui intéresse le plus un propriétaire de boutique, et c’est un taux, pas un simple oui ou non, parce que les réponses des modèles varient d’une exécution à l’autre.
Comportement sur l’ensemble de la conversation. L’étude de Zalando sur l’évaluation des agents en production recommande d’évaluer des conversations complètes plutôt que des tours de dialogue isolés, car des scores agrégés comme la pertinence indiquent qu’il y a eu une variation de qualité sans expliquer ce qui a échoué ni comment le corriger. Pour un commerçant, cela signifie : ne comptez pas seulement les victoires, analysez pourquoi vous avez perdu.
Couverture, pas seulement précision. Un article sur l’évaluation multi-objectifs des systèmes de recommandation avertit que optimiser uniquement la précision produit des systèmes qui se généralisent mal dans des conditions réelles, et recommande aussi des mesures comme la diversité, la couverture et l’équité. Pour une boutique, cela signifie vérifier l’ensemble du catalogue, pas seulement vos cinq produits phares.
Précision importante : aucune de ces métriques universitaires ne mesure le chiffre d’affaires. Elles indiquent si un agent pourrait faire le travail, pas si cela a eu un effet sur votre compte bancaire. Vous avez toujours besoin de vos propres données de commandes à côté.
Ce dont les agents ont besoin dans vos données
Le constat d’évaluation le plus utile et le moins coûteux que je connaisse est celui-ci : les agents comparent des fiches, pas des pages.
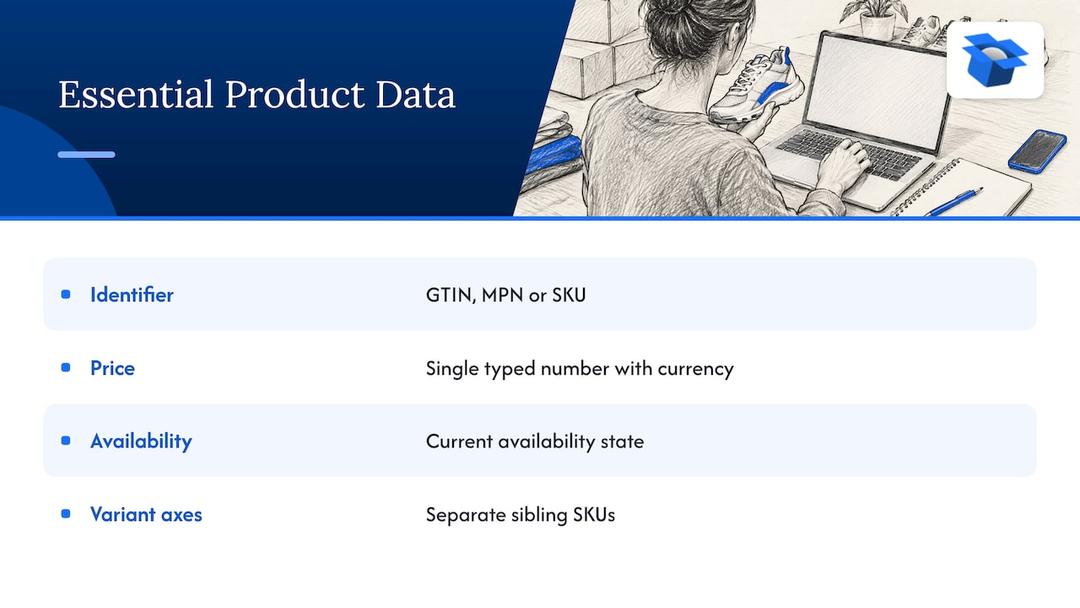
Ecommerce Guide décrit quatre catégories de champs qui déterminent si un article peut être comparé tout court : un identifiant stable (GTIN, MPN ou SKU), un prix actuel avec devise, un état de disponibilité et les axes de variantes qui distinguent un SKU de ses équivalents. S’il en manque un, l’article disparaît d’une comparaison avec contraintes. La même source souligne aussi que le prix doit être un nombre unique typé. Une valeur d’affichage comme « à partir de 39 $ » ne donne rien à l’agent pour vérifier un budget de 60 $, donc l’article est discrètement écarté.
Les spécifications sont l’autre point faible. Une contrainte numérique ne peut pas être vérifiée à partir d’un adjectif. « Léger » est une impression, « 1,2 lb » est une valeur. La plupart des catalogues sont remplis d’impressions.
C’est cohérent avec ce que nous observons dans les audits. Une marketplace de spiritueux réalisant environ 70 M€ de chiffre d’affaires annuel avait une anomalie dans les données lues par les agents sur 88 % de ses 9 699 produits. Lorsque les agents devaient trouver où acheter deux bouteilles qu’elle vendait, elle apparaissait 0 fois sur 20. Les parcours de paiement d’agents pour une marque suédoise de soins de la peau ont atteint l’étape du paiement dans 0 des 6 pays parce qu’un paramètre d’expédition exigeait un numéro de téléphone. Je ne citerai aucune des deux boutiques. Le point important est qu’aucun de ces problèmes n’était visible sur le site. Un acheteur humain ne les aurait jamais remarqués. L’agent, lui, les a vus immédiatement et est parti, sans plainte ni avis.
Si vous voulez aller plus loin sur le rôle de la fiche produit elle-même dans ce processus, notre guide sur les fiches produit lisibles par l’IA détaille le balisage, et l’article sur la manière dont les agents d’achat IA recommandent vos produits explique la logique de sélection.
Comment tester votre propre boutique, étape par étape
Vous n’avez pas besoin d’un laboratoire de recherche. Vous avez besoin d’une méthode reproductible. Voici celle que j’utiliserais.
- Rédigez les questions des acheteurs. Choisissez 10 à 20 questions réelles que vos clients poseraient, avec des contraintes : un budget, une taille, un cas d’usage, un pays de livraison. Évitez votre nom de marque, car les acheteurs ne le tapent pas.
- Choisissez un concurrent identifié pour chaque produit. L’agent choisit entre plusieurs options, vous avez donc besoin d’une option contre laquelle perdre. Utilisez le concurrent qui apparaît le plus souvent lorsque vous recherchez vous-même la catégorie.
- Interrogez plusieurs modèles, plusieurs fois. Les modèles ne sont pas d’accord entre eux, et un même modèle n’est pas toujours cohérent avec lui-même. Dans nos propres simulations, sur le même catalogue, ChatGPT choisissait le produit environ 3 fois plus souvent que Claude ou Gemini (51,6 % contre environ 18,5 %). Le verdict d’un modèle n’est pas celui du marché.
- Notez pourquoi il a perdu. Une raison d’échec comme « le concurrent fournit un GTIN, pas vous » vaut mieux que dix graphiques de taux de victoire. L’argument de Zalando en faveur de l’analyse des conversations complètes s’applique aussi ici.
- Corrigez les données, puis recommencez. Modifiez une seule catégorie de problème à la fois, comme les identifiants, puis les prix, puis les spécifications, afin de savoir ce qui a fait évoluer le résultat. Le cadre de Zalando utilise des exécutions répétées pour établir une base de référence et des comparaisons par paires sur des changements isolés, et cette logique reste valable à l’échelle d’une boutique.
- Testez le paiement, pas seulement la réponse. Gagner la recommandation puis échouer au paiement, c’est exactement l’histoire de la marque de soins évoquée plus haut. Parcourez le chemin qu’un agent suivrait : recherche, panier, livraison, paiement.
Pour l’étape 6 côté Google, notre UCP Playground vous permet de tester des agents d’achat IA sur une boutique. UCP est le standard ouvert de Google pour le paiement par agent. L’achat directement dans la réponse IA est déjà disponible aujourd’hui sur Google AI Mode et Gemini aux États-Unis via UCP. ChatGPT, en revanche, renvoie vers le paiement propre à la boutique. OpenAI a ACP, Google a UCP, Amazon a un mur.
Si vous voulez un aperçu rapide de la manière dont les agents lisent les outils de votre site, il existe aussi un audit shopping WebMCP gratuit.
Évaluer un chatbot sur votre propre site
Si votre vrai sujet correspond au premier sens, c’est-à-dire un assistant de marque sur votre boutique en ligne, reprenez les méthodes des benchmarks. Testez des conversations à plusieurs tours, pas des questions isolées. Vérifiez chaque produit et variante suggérés par rapport à ce que l’acheteur a demandé et aux données produit vérifiées. Vérifiez que les exigences restent cohérentes après les questions de suivi. Vérifiez ce qu’il se passe lorsqu’un article est en rupture de stock. C’est dans ces cas que les assistants inventent des choses.
Il existe de nombreux exemples d’IA dans l’ecommerce qui montrent où les assistants sur site apportent une vraie valeur, et la grille d’évaluation ci-dessus vous indique si le vôtre le fait.
Un avertissement de ma part. Un excellent assistant sur site n’aide pas l’acheteur qui ne visite jamais votre site. L’agent externe a déjà fait son choix. Le travail sur les données de la section précédente passe donc avant l’assistant. Une fois dit à voix haute, cet ordre me paraît évident, et pourtant presque personne ne le suit.
Maintenir des résultats fiables dans le temps
Les modèles changent, les catalogues changent, les concurrents modifient leurs flux. Un score obtenu en mars vous apprend peu de choses sur novembre.
Considérez l’évaluation comme une boucle. Lancez l’analyse, lisez les raisons des pertes, corrigez les données, publiez, puis recommencez. Gardez les mêmes questions d’acheteurs entre les exécutions, sinon vous comparez des examens différents. Lorsque vous ajoutez une nouvelle gamme de produits, ajoutez aussi ses questions.
Suivez également ce que vous pouvez réellement observer : les visites provenant des assistants IA dans vos outils d’analyse, ainsi que les commandes de votre côté. Lors de notre premier pilote, DUA Flavours a vu les visites provenant d’assistants IA et le trafic direct augmenter de 12 % entre avril et juillet 2026. Il s’agit d’un chiffre de visites, pas d’un chiffre de ventes, et je préfère le préciser plutôt que vous laisser supposer le contraire. Nos guides sur la mesure du trafic des agents IA et les outils d’attribution approfondissent la partie mesure.
Perspective : pourquoi nous testons la boutique, pas le modèle
Nous avons réalisé 36 797 achats simulés à octobre 2026, et la principale leçon est de savoir où se situe le problème. Il est rarement dans le modèle. Il est dans le flux produit, le catalogue et le paiement que l’agent doit utiliser.
C’est pourquoi ecentic travaille directement sur la boutique. Nous nous connectons à Shopify, WooCommerce ou à un flux produit, puis demandons à ChatGPT, Claude et Gemini de comparer chaque produit avec celui d’un concurrent identifié. Nous montrons pourquoi l’agent choisit l’autre produit, en langage clair. Lorsque vous cliquez sur Apply, nous réécrivons le titre, la description et les données structurées, puis les publions dans votre boutique.
Sur Shopify, nous envoyons les corrections vers Google Merchant Center et suivons les visites provenant des assistants IA. Sur WooCommerce, le plugin gratuit ecentic permet aux agents de rechercher, remplir un panier et finaliser un achat via UCP. C’est précisément la partie paiement que les simples outils de flux ne gèrent pas.
Je pense qu’une boutique qui attend que les modèles s’améliorent prend un pari qu’elle ne contrôle pas. Les modèles progresseront, et ils continueront à lire vos données. Mieux vaut avoir des données qui méritent d’être lues.
Xhurian Shaba
Lancez le premier test sur vos propres produits
Le moyen le plus rapide d’obtenir vos propres chiffres est l’analyse gratuite. Elle couvre vos 10 meilleurs produits, ne nécessite aucune carte bancaire et montre comment ChatGPT, Claude et Gemini les comparent à ceux d’un concurrent identifié, ainsi que pourquoi vous perdez lorsque c’est le cas.

À partir de là, les offres de notre page tarifs sont Compete à 14,90 $ par mois pour jusqu’à 100 produits, Scale à 44,90 $ par mois pour jusqu’à 1 000 produits avec corrections en un clic, et Dominate à 149 $ par mois, qui ajoute la synchronisation Google Merchant Center et la configuration du paiement par agent. Il existe aussi une formule à l’usage à 3 % des commandes attribuées à l’IA, plafonnée à 500 $ par mois. Si vous voulez commencer par la partie fiches produit, consultez l’optimisation des fiches produit par IA. Nous avons aussi des pages dédiées à Shopify et WooCommerce également.
FAQ
Qu’est-ce que l’évaluation des LLM dans l’ecommerce ?
Il s’agit du processus d’évaluation de la capacité d’un modèle de langage à gérer des tâches d’achat comme la recherche, les questions de clarification, les recommandations et l’ajout au panier. Les bonnes évaluations notent des conversations complètes et vérifient les réponses par rapport à de vraies données produit. Pour les commerçants, cela signifie aussi vérifier comment des agents IA externes traitent vos produits.
Comment savoir si des assistants IA recommandent mes produits ?
Posez des questions d’acheteurs réalistes, avec budgets et contraintes, sur plusieurs modèles et plusieurs exécutions. Comptez à quelle fréquence votre produit est choisi face à celui d’un concurrent identifié, et notez la raison lorsqu’il ne l’est pas. Une réponse unique d’un seul chatbot est une anecdote ; une série d’exécutions répétées est une mesure.
Quelles données produit les agents IA doivent-ils avoir ?
Au minimum, un identifiant stable comme un GTIN, MPN ou SKU, un prix actuel avec devise sous forme d’un nombre unique, un état de disponibilité et des options de variantes claires. Les spécifications doivent être des valeurs mesurables, pas des adjectifs. Sans cela, un agent ne peut pas comparer votre produit et tend à l’écarter.
Comment intégrer des données IA dans une boutique ecommerce ?
Commencez par le flux produit et les données structurées de vos fiches produit, puisque c’est ce que les agents lisent. ecentic se connecte à Shopify, WooCommerce ou à un flux produit, réécrit les titres, descriptions et données structurées lorsque vous cliquez sur Apply, puis les publie dans la boutique. Relancez ensuite votre test pour voir ce qui a changé.
Les scores des benchmarks indiquent-ils comment ma boutique va se comporter ?
Pas directement. Les benchmarks montrent comment les modèles se comportent sur des tâches d’achat de manière générale, et le meilleur score d’EComAgentBench, à 57,1 %, montre qu’il reste une large marge d’erreur. Votre propre catalogue et vos propres concurrents déterminent votre résultat, donc testez-les.
Sources
- Benchmarking Models for Conversational E-Commerce (Rezolve, atelier RecSys 2026)
- Algolia LLM Leaderboard : méthodologie
- Evaluating Open-Weight E-Commerce Agents with Environment-Grounded Verification
- EComAgentBench : Benchmarking Shopping Agents (EMNLP 2026 Industry Track)
- DeepShop : A Benchmark for Deep Research Shopping Agents
- Measuring and Improving AI Performance in Conversational Shopping Assistants
- E Pluribus Unum : Guidelines on Multi-Objective Evaluation of Recommender Systems
- On Evaluating and Improving Conversational Agents in Production (Zalando)
- Product Feeds for AI Agents : What Machines Need to Compare
Sujets à explorer