

Une fiche produit lisible par l’IA expose ses informations essentielles, son prix, sa disponibilité, ses spécifications et son identité sous forme de texte direct et de données structurées, au lieu de les enfouir dans des images ou des scripts. Le correctif le plus impactant consiste à publier un schéma Product JSON-LD précis, en parallèle d’un texte qui commence par la réponse. L’étape suivante consiste à lancer une vérification du schéma ou un scan de préparation pour voir ce que ChatGPT, Gemini ou Perplexity voient actuellement lorsqu’ils accèdent à votre page.
En bref :
- Publier un schéma produit JSON-LD complet et précis, avec des données SKU et de variantes cohérentes, permet aux agents IA d’extraire de manière fiable les informations essentielles directement depuis votre page.
- Veiller à ce que les attributs visibles comme la taille, la couleur et le prix apparaissent dans un texte clair et libellé, et non cachés dans des images ou des scripts, permet aux systèmes d’IA de confirmer facilement les détails clés.
- Intégrer des données structurées de FAQ et d’avis, ainsi qu’un texte alternatif descriptif et un HTML sémantique, améliore la capacité d’un agent IA à vérifier et citer vos informations produit.
- Des scans réguliers pour détecter les incohérences entre le schéma et le contenu visible révèlent des lacunes critiques qui freinent la découverte et la recommandation par l’IA.
- La vitesse, l’explorabilité et les temps de réponse serveur influencent aussi la visibilité dans l’IA, ce qui rend le rendu côté serveur et une configuration technique correcte essentiels pour des performances optimales.
Pourquoi la lisibilité par l’IA compte maintenant pour la découverte et les ventes
Le SEO traditionnel optimise pour le clic. La découverte pilotée par l’IA optimise pour la citation : un agent lit votre page, en extrait un fait, puis le cite directement ou s’en sert pour décider si votre produit remporte la recommandation. C’est une logique fondamentalement différente : une page peut très bien se positionner dans Google et pourtant être ignorée par un agent IA si ses informations clés sont enfermées dans un carrousel rendu en JavaScript ou dans un paragraphe marketing sans détails exploitables.
Ce basculement se produit dans un paysage de recherche déjà en pleine transformation. Generative Engine Optimization des recherches de Princeton formulent clairement l’objectif : présenter l’identité, les attributs, le prix et la disponibilité sous forme de texte direct, appuyé par un socle de schémas essentiel, afin que les modèles de langage puissent traiter votre produit comme une entité structurée plutôt que comme un bloc de prose à interpréter.
La logique commerciale est simple. Une citation mène à une recommandation, une recommandation mène à une vente, et chaque couche d’ambiguïté entre les données de votre produit et l’analyseur d’un agent IA est une couche de revenu perdu. Les marchands qui considèrent cela comme optionnel sont de fait invisibles pour une part croissante d’acheteurs qui demandent désormais à un agent de simplement choisir quelque chose pour eux.
Comment les agents IA modernes lisent réellement les fiches produit
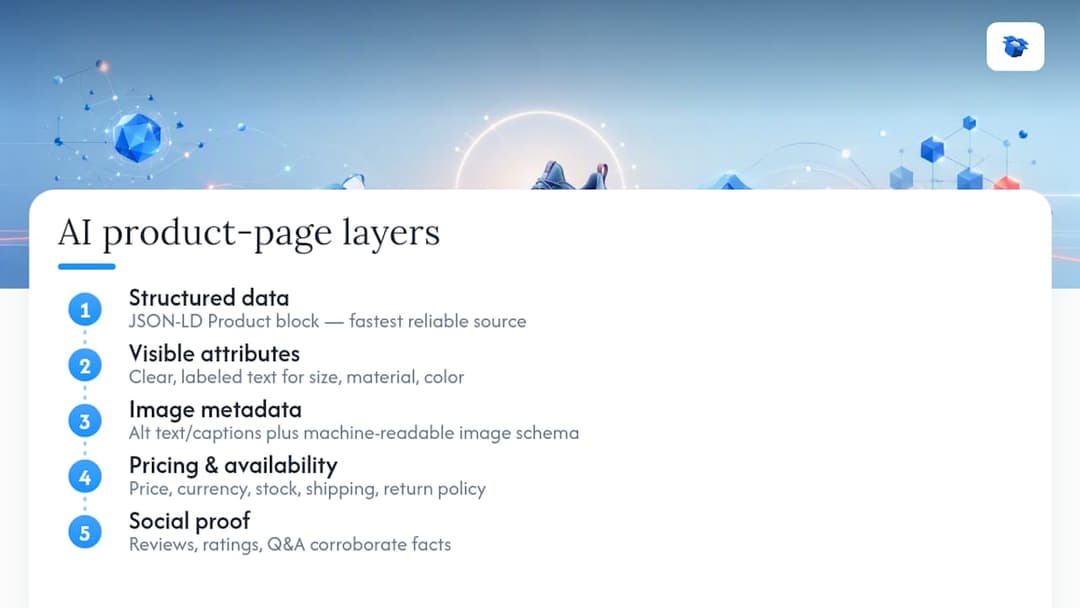
Les systèmes d’IA n’analysent pas une fiche produit comme le ferait un œil humain. Ils la lisent par couches, et chaque couche confirme ou contredit la précédente, selon une analyse de la manière dont l’IA lit réellement les fiches produit.
Première couche correspond aux données structurées. Le bloc Product JSON-LD est la source de vérité la plus rapide et la plus fiable qu’un agent puisse analyser, à condition qu’il soit bien présent et cohérent en interne.
Deuxième couche correspond aux attributs visibles. La taille, le matériau, la couleur et la compatibilité doivent apparaître sous forme de texte clair et libellé, et non être seulement suggérés par une photo ou une image de guide des tailles.
Troisième couche concerne les images et leurs métadonnées. Le texte alternatif, les légendes et toute spécification visible intégrée dans l’image ne comptent que s’il existe aussi une description lisible par machine associée à l’objet image dans les données structurées.
Quatrième couche couvre le prix, la disponibilité et la fiabilité du marchand : prix actuel, devise, statut du stock, délais d’expédition et politique de retour. Les agents les prennent en compte parce qu’ils servent d’indicateurs pour savoir si une recommandation a des chances de se convertir en commande finalisée.
Cinquième couche correspond à la preuve sociale : avis, notes et contenu de questions-réponses qui répondent aux questions contextuelles qu’un acheteur — ou un agent agissant pour son compte — poserait. L’analyse de Practical Ecommerce de fiches produit publiées sur de grandes places de marché a montré que les pages qui l’emportent combinent des données détaillées sur les attributs avec des avis et des FAQ. C’est précisément cette redondance qui aide un système d’IA à corroborer un fait à travers plusieurs couches d’information avant de le juger assez fiable pour le citer.
Checklist technique : quoi exposer et comment
Rendre une fiche produit lisible par machine n’est pas un projet de refonte. C’est un projet de discipline des données, et l’essentiel se joue dans les données structurées et le balisage plus que dans le design visuel.
Commencez par l’ensemble JSON-LD. Au minimum, votre schéma Product doit inclure name, description, sku, brand, ainsi qu’un objet offers avec price, priceCurrency, et availability. Ajoutez ensuite le schéma Organization au niveau du site et BreadcrumbList afin que les agents comprennent où le produit se situe dans votre catalogue. La documentation de référence Product de Schema.org est la source canonique pour chaque nom de champ et format attendu, et mérite d’être mise en favori plutôt que d’essayer de deviner les noms de propriétés de mémoire.
Voici les priorités, dans l’ordre :
- Publiez
Product,Offer,Organization,BreadcrumbList, etFAQPagedu JSON-LD sur chaque URL produit, pas seulement sur un échantillon - Incluez
skuougtinà la fois dans le texte visible et dans le schéma, en utilisant exactement la même valeur aux deux endroits - Présentez les variantes (taille, couleur, lot) avec des URL distinctes ou une structure
hasVariantclaire, jamais comme une page unique où la variante n’existe que dans le JavaScript d’un menu déroulant - Déplacez toute information actuellement enfermée dans une image, une fiche technique PDF ou un accordéon chargé au clic vers un texte brut pouvant être exploré
- Ajoutez un texte alternatif descriptif et des légendes à chaque image produit, et référencez ces images comme des
ImageObjectentrées structurées dans le schéma - Auditez votre flux marchand (Google Merchant Center ou équivalent) afin que le prix, la disponibilité et le titre correspondent à ce qui est réellement affiché sur la page, et non à une exportation obsolète
La canonicalisation des variantes mérite une attention particulière. Si les versions rouge taille M et bleue taille L d’une chemise se trouvent sur la même URL avec seulement un sélecteur côté client, un agent n’a aucun moyen fiable de confirmer quelle offre il cite réellement. Des URL de variantes séparées, ou des relations hasVariant bien structurées, résolvent ce problème. Notre checklist des données structurées pour les fiches produit ecommerce détaille l’implémentation champ par champ si vous cherchez une référence technique plus approfondie.
Conseil pratique : Affichez votre page en mode texte uniquement (désactivez JavaScript dans les DevTools) et vérifiez si le prix, le statut du stock et le SKU apparaissent toujours. S’ils disparaissent, un robot d’exploration IA ne peut probablement pas les voir non plus.
Rédiger un contenu extractible, pas seulement lisible
Un bon contenu lisible par l’IA et un bon contenu de conversion sont plus proches que la plupart des équipes ne l’imaginent. La clé, c’est la structure : commencez chaque section par la réponse concrète, puis laissez le langage persuasif prendre le relais.
Au lieu d’ouvrir une description par « Conçue pour le confort et pensée pour durer », commencez par « Il s’agit d’une bouteille isotherme en acier de 14 onces qui garde les liquides froids pendant 24 heures. » Une phrase donne à un agent un fait qu’il peut citer ; l’autre ne lui donne rien à extraire. Les recherches de Netguru sur l’UX writing soulignent le même point du côté humain : une conception adaptée à la lecture par l’IA et un bon UX writing ne sont pas des priorités concurrentes, mais une seule et même discipline. Réduire le superflu aide les deux.
Quelques habitudes concrètes font toute la différence :
- Présentez les dimensions, matériaux, conditions de garantie et compatibilités dans des champs courts et libellés, pas sous forme de paragraphe
- Ajoutez un bloc FAQ compact répondant à des questions situationnelles (« Est-ce compatible avec un MacBook Pro 16 pouces ? ») puisque celles-ci correspondent directement à la façon dont les acheteurs formulent leurs requêtes auprès d’un agent
- Gardez une nomenclature cohérente dans votre catalogue, votre flux produit et les textes du site : appeler un produit « Chargeur sans fil » sur une page et « Chargeur WCP-100 » sur une autre perturbe autant les acheteurs que les analyseurs
- Placez le fait le plus important dans la première phrase sous chaque titre ; les recommandations sur le comportement de recherche par IA suggèrent que les systèmes privilégient les passages qui répondent à la question implicite dans les cent premiers mots
Notre guide d’optimisation des fiches produit pour les agents d’achat IA présente davantage d’exemples de réécriture avant/après si vous voulez voir cette approche appliquée à de vraies fiches produit.
Avis et signaux de confiance réellement pris en compte par les agents
Les avis ne sont pas qu’un habillage pour la conversion : ils constituent des preuves qu’un agent peut citer lorsqu’un acheteur demande « est-ce que ce produit est bien ? ». Exposez aggregateRating dans le schéma et associez-le à quelques extraits d’avis visibles, pas seulement à une icône d’étoile sans texte d’appui.
Les sections Q&R remplissent une double fonction : elles capturent les formulations exactes que les acheteurs utilisent avec un assistant IA (« est-ce compatible avec une cuisinière à gaz ? ») et donnent aux agents une citation directe à afficher. Au-delà des avis, les signaux opérationnels comptent aussi : stocks précis, délais de livraison réalistes et conditions de retour claires. Gardez une modération des avis authentique ; agents et acheteurs perdent vite confiance lorsque les notes semblent gonflées ou génériques.
Gains rapides : une feuille de route par étapes peut faire évoluer les résultats sans reconstruction complète. Commencez par valider et ajouter le Product JSON-LD, afficher les SKU/GTIN dans le texte visible, ajouter un bloc FAQPage et confirmer le prix et la disponibilité en texte brut. Passez ensuite à la normalisation des données de variantes, à la réécriture des textes alternatifs avec de vrais détails descriptifs, à l’ajout d’objets image structurés dans le schéma et au nettoyage des exportations de flux pour qu’elles correspondent aux données en direct. Enfin, travaillez la cohérence de la taxonomie, enrichissez les attributs et lancez des scans de simulation d’agents pour évaluer la visibilité des citations.
Outils utiles à utiliser pendant cette période :
- Un validateur de schéma pour détecter les erreurs structurelles avant la mise en production
- Un diagnostic de flux marchand pour vérifier que les données du flux et de la page correspondent
- Un simulateur de préparation pour les agents d’achat IA, comme les analyses réalisées par ecentic, pour voir les résultats de victoire/défaite par produit au lieu de faire des suppositions
Notre playbook des recommandations produit dans ChatGPT décompose cette même structure 30/60/90 avec des listes de tâches plus détaillées si vous voulez un document opérationnel à transmettre à votre équipe.
Ce qu’un diagnostic basé sur la simulation révèle et que les validateurs ne voient pas
Un validateur de schéma vous indique que votre balisage est syntaxiquement correct. Il ne dit rien sur le fait que votre JSON-LD corresponde réellement au texte qu’un acheteur ou un agent voit sur la page. C’est dans cet écart que se cachent la plupart des problèmes de visibilité IA.
ecentic exécute des simulations qui reproduisent la manière dont ChatGPT, Gemini, Claude et Perplexity évaluent réellement une offre produit, puis fournit des diagnostics de victoire/défaite en langage clair plutôt qu’un simple score de schéma réussi/échoué. Selon l’analyse de Mirakl sur la visibilité produit dans l’IA, les analyseurs de préparation capables de détecter ces incohérences croisées — par exemple un schéma indiquant un prix alors que la page en affiche un autre — sont ceux qui font réellement progresser les taux de citation par les agents.
Ce que les marchands apprennent généralement grâce à une analyse :
- Quels faits précis manquent par rapport à la fiche d’un concurrent
- Où le schéma et le texte visible se contredisent
- Les lacunes du flux qui empêchent les agents de recevoir des signaux précis sur les prix ou les stocks
Priorisez les corrections par fréquence : commencez par les lacunes qui apparaissent sur le plus grand nombre de SKU.
Considérations d’accessibilité pour la lisibilité par l’IA
Le balisage d’accessibilité et la lisibilité par l’IA résolvent des problèmes qui se recoupent : dans les deux cas, le contenu doit exister sous forme de texte propre et structuré plutôt que d’être enfermé dans un visuel. Les rôles ARIA, les repères sémantiques et le balisage adapté aux lecteurs d’écran ont été conçus pour les personnes utilisant des technologies d’assistance, mais produisent aussi exactement le type de structure documentaire non ambiguë que préfère un analyseur IA.
Une fiche produit avec des attributs aria-label correctement appliqués aux éléments interactifs, des libellés de formulaire correctement associés et une hiérarchie logique des titres offre à la fois à un lecteur d’écran et à un crawler IA une carte claire de ce qui compte. Si votre sélecteur de taille est un ensemble de div stylisés pour ressembler à des boutons, un lecteur d’écran n’annonce rien d’utile, et un agent IA qui analyse le DOM rencontre le même problème : aucun signal sémantique indiquant qu’il s’agit d’un sélecteur de variantes lié à une offre spécifique.
Les corrections pratiques recoupent presque entièrement les audits d’accessibilité classiques : étiquetez chaque contrôle de formulaire, utilisez de vrais éléments <button> et <select> au lieu de div stylisés, et assurez-vous que les attributs alt décrivent le produit plutôt que de répéter le nom du fichier. Les liens d’évitement, un ordre de focus correct et des textes de lien descriptifs réduisent tous l’ambiguïté pour les technologies d’assistance, et cette même réduction de l’ambiguïté aide précisément un modèle de langage à extraire un fait clair au lieu de deviner l’intention à partir de la seule mise en page. Considérez un audit d’accessibilité comme un deux-en-un : vous corrigez à la fois les écarts de conformité et les problèmes de lisibilité machine.
Optimiser pour les assistants vocaux et la recherche conversationnelle par IA
La recherche vocale et les agents conversationnels suppriment tout ce sur quoi une page s’appuie visuellement : pas d’images, pas de mise en page, pas de codes couleur. Il ne reste que le texte qu’un agent peut lire à voix haute ou résumer, ce qui rend les phrases concises et factuelles encore plus importantes.
La différence pratique avec une recherche IA tapée au clavier, c’est la brièveté. Un assistant vocal qui résume un produit lit généralement une ou deux phrases ; le fait le plus important doit donc apparaître dès la première phrase de votre description, pas être enfoui après trois lignes de storytelling de marque. « Ce blender possède un bol de 64 onces et un moteur de 1 200 watts » répond directement à une requête vocale. Un paragraphe sur le fait de « libérer votre potentiel culinaire » ne donne rien à lire à voix haute à un assistant vocal.
Le contenu FAQ est encore plus important ici, car les requêtes conversationnelles prennent souvent la forme de questions : « Cette cafetière a-t-elle une minuterie ? » « Cette veste passe-t-elle en machine ? » Structurer votre schéma FAQPage et vos questions/réponses visibles autour des formulations réellement utilisées par les acheteurs dans une conversation, plutôt qu’autour de questions marketing génériques, augmente les chances qu’un assistant affiche votre réponse exacte. Gardez des réponses autonomes : un assistant vocal ne lira pas « voir le tableau ci-dessous » à voix haute, puisqu’il n’y a pas de tableau dans une réponse vocale.
Les fondamentaux du SEO technique qui influencent la lisibilité par l’IA
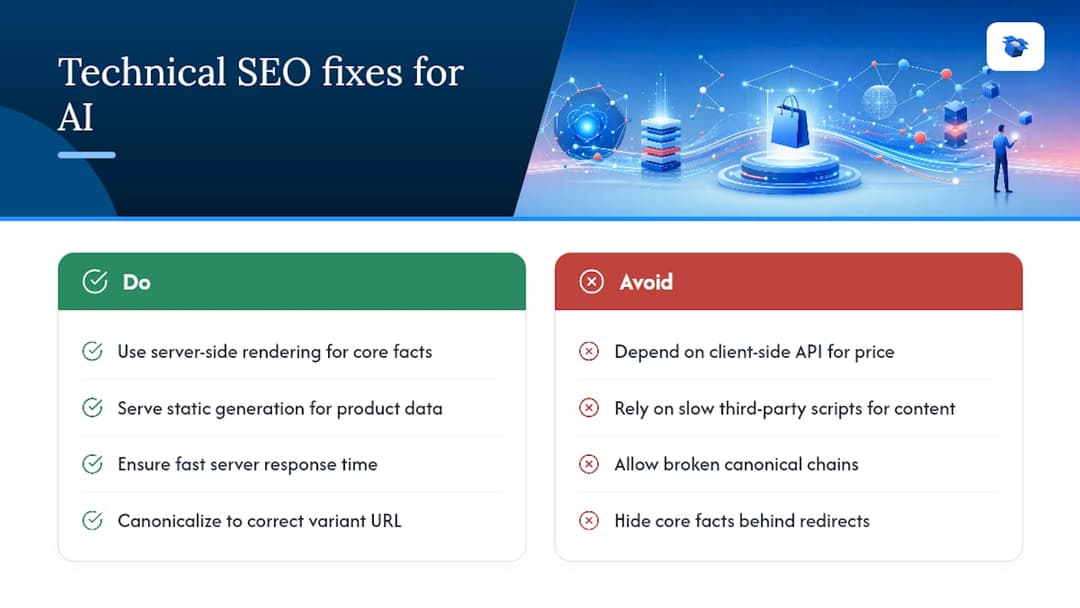
Les données structurées attirent l’essentiel de l’attention, mais un crawler IA doit quand même atteindre et afficher votre page avant que le schéma n’ait la moindre importance. La vitesse de chargement, l’explorabilité et le comportement de rendu interviennent tous en amont du travail de lisibilité abordé ailleurs dans ce guide.
Les pages lentes risquent un rendu partiel si un crawler atteint le délai d’expiration avant la fin de l’exécution de JavaScript, ce qui signifie que tout fait injecté côté client — prix, statut du stock, options de variantes — peut ne jamais apparaître dans ce que le crawler voit réellement. Le rendu côté serveur ou la génération statique des informations produit essentielles éliminent totalement ce risque. Si votre prix et votre disponibilité n’apparaissent qu’après la résolution d’un appel API côté client, considérez cela comme un problème de lisibilité, pas seulement comme un détail de performance.
Les bases de l’explorabilité restent valables : un robots.txtpropre, un sitemap XML précis et des balises canoniques pointant vers la bonne URL de variante déterminent tous si le robot d’exploration d’un agent atteint réellement la page concernée. Des chaînes canoniques cassées, lorsqu’une URL de variante est définie comme canonique pour un produit totalement différent, éliminent discrètement des produits de la sélection, quelle que soit la qualité du schéma présent sur la page.
Le temps de réponse du serveur est plus important que la plupart des équipes ne le pensent pour les crawlers IA en particulier, car beaucoup fonctionnent avec des délais plus stricts qu’un robot de moteur de recherche classique. Une fiche produit cachée derrière plusieurs redirections, ou dépendante d’un script tiers lent avant que le contenu principal ne s’affiche, est une page qu’un agent peut abandonner avant même d’avoir extrait quoi que ce soit.
Les pratiques HTML sémantiques qui améliorent la compréhension par l’IA
Le HTML sémantique donne du sens à la structure avant même qu’une seule ligne de JSON-LD soit chargée. Utiliser <article> pour le bloc produit, <h1> pour le nom du produit, et <dl> (liste de définitions) pour les couples de spécifications comme « Matériau : acier inoxydable » indique exactement à un analyseur le rôle de chaque élément de contenu, sans interprétation nécessaire.
Générique <div> génériques oblige un système IA à deviner la structure à partir des classes CSS ou de la position visuelle, ce qui est peu fiable et incohérent d’un site à l’autre. Un <table> pour un guide des tailles, un balisage <ul> ou <ol> correct pour les listes de fonctionnalités au lieu de paragraphes séparés par des retours à la ligne, et <figure> avec <figcaption> pour les images produit réduisent presque totalement cette part de supposition.
Une habitude utile à adopter : encapsulez votre bloc principal de spécifications dans un conteneur sémantique avec un titre clair, « Informations produit » ou « Caractéristiques », directement sous le titre du produit, en reprenant les mêmes champs que dans votre JSON-LD. Cette redondance entre le HTML sémantique visible et les données structurées est exactement le type de cohérence croisée qui donne suffisamment confiance à un agent IA pour citer un fait plutôt que l’ignorer.
Voix de marque vs. lisibilité machine : le vrai compromis
Les machines récompensent la précision ; les humains restent sensibles à une bonne histoire. La solution n’est pas de choisir l’un ou l’autre, mais de les superposer : une section hero pensée pour l’humain qui vend l’émotion, suivie d’un bloc de spécifications pensé pour la machine qui expose clairement les faits. La plupart des marques voient cela comme un compromis. C’est plus proche d’une discipline d’écriture rigoureuse qui impose une clarté bénéfique à tous, y compris à l’acheteur qui parcourt la page sur son téléphone.
Une règle éditoriale utile : un fait clair et vérifiable tous les vingt mots. Si une phrase dépasse ce seuil sans mentionner un nombre, un matériau ou une mesure précise, il s’agit probablement de remplissage déguisé en voix de marque.
— Xhurian
Comment ecentic vous aide à être trouvé par les agents d’achat IA
Tout dans ce guide — la pile de schémas, les signaux multicouches, le recouvrement avec l’accessibilité — se résume à un problème difficile : savoir précisément quelle correction fait évoluer les résultats pour votre catalogue spécifique. Les simulations peuvent vous montrer, produit par produit, pourquoi un agent a recommandé un concurrent plutôt que vous.

Au lieu d’un score de schéma générique, vous obtenez des diagnostics de victoire/défaite en langage clair, des données SKU manquantes, des prix contradictoires et des suggestions de réécriture que vous pouvez publier directement dans Shopify ou WooCommerce en un clic. Les nouvelles analyses suivent l’évolution de votre taux de sélection par l’IA après chaque correction, afin que vous sachiez réellement si le travail a porté ses fruits.
Commencez par l’analyse gratuite de votre principale catégorie produit, corrigez ce que le diagnostic identifie comme ayant le plus d’impact, puis republiez. Consultez les fonctionnalités d’optimisation des fiches produit pour voir ce qu’une analyse peut révéler sur un catalogue.
FAQ
Qu’est-ce qui rend une fiche produit « lisible par l’IA » ?
Une page est lisible par l’IA lorsque ses informations essentielles — prix, disponibilité, spécifications et identité — existent sous forme de texte direct et de données structurées cohérentes, et non cachées dans des images, des PDF ou des scripts côté client qu’un analyseur pourrait ne jamais afficher.
Ai-je besoin de données structurées si mon texte mentionne déjà le prix ?
Oui. Les données structurées et le texte visible doivent correspondre exactement ; les agents vérifient les deux, et une différence entre votre prix JSON-LD et le prix affiché sur la page est l’une des raisons les plus fréquentes pour lesquelles une fiche produit est ignorée.
En quoi est-ce différent du SEO classique ?
Le SEO classique optimise le classement et le clic. La lisibilité par l’IA optimise l’extraction et la citation : un agent extrait un fait précis de votre page pour faire une recommandation sans que l’acheteur visite nécessairement votre site au préalable.
Quel est le moyen le plus rapide de vérifier si mes pages sont lisibles par l’IA dès maintenant ?
Exécutez un validateur de schéma sur votre Product JSON-LD, puis affichez votre page avec JavaScript désactivé pour vérifier que le prix, le stock et le SKU apparaissent toujours. Une analyse basée sur la simulation, comme celle d’ecentic, va plus loin en montrant quels faits précis un agent a réellement utilisés ou ignorés.
Corriger cela aide-t-il aussi mon SEO classique ?
En général, oui. Des données structurées propres, des attributs cohérents et un contenu qui donne d’abord la réponse tendent à améliorer à la fois les extraits de recherche traditionnels et les citations IA, car les deux systèmes récompensent la clarté et la cohérence factuelle plutôt qu’un langage marketing vague.