

无论用户是在 Google 搜索、去 Amazon,还是直接问聊天机器人,AI 现在都会给出包含商品的回答,而大多数电商品牌并不知道怎样才能让自己的商品被选中。AI 商品信息模拟测试正是用来补上这个盲区的。把自己的商品和指定竞品放到 AI 模型面前,让它做选择,再看它为什么这么选。
它依赖智能体实际会读取的数据:商品数据源、商品目录,以及商品页面上的结构化数据。它不会查看首页,因为智能体根本看不到首页。
我认为,这是当下电商里最被低估的测试。很多店铺花几周争论首屏横幅,而真正决定成交的,可能只是一个写着“Blue Bottle 2”的标题字段。真人用户会直接离开。智能体只会转而选择别人的商品,而且不会告诉您原因。
要点速览
- AI 商品信息模拟,就是让 AI 模型在您的商品和竞品之间做出选择,再查看它们给出的原因。
- 输入数据包括您的商品数据源、商品目录和结构化数据。其中最重要的是标题、描述、GTIN、价格、库存状态、配送和退货信息。
- 应把结果视为方向性证据。即使是很强的学术模拟器,也只是在 77% 的案例中与真实加购变化一致,而不是全部。
- 修复数据后,重新运行同样的对比,然后观察来自 AI 助手的访问,看看是否出现变化。
- ecentic 的免费扫描覆盖排名前 10 的商品,且无需绑卡,足以让您看清整体模式。
AI 商品信息模拟对网店意味着什么
这个说法常和房地产工具、描述生成器混在一起,所以我具体说明一下。对网店来说,listing 指的是商品信息:标题、描述、图片、属性、价格、库存、配送条款和退货条款。所谓模拟,就是把一次购物请求送入 AI 模型,看它会选中哪条商品信息。
一个有用的模拟包含三个部分:
- 一条购物请求,例如“给喜欢黑巧克力的人挑选 $60 以下的最佳礼物”。
- 一组候选商品,包括您的商品,以及至少一个指定竞品。
- 一条用通俗英文说明为何做出该选择的原因。
真正有价值的是原因。只有分数、没有原因,就像看星座运势。要是智能体说它更偏向另一款商品,因为对方的商品信息写清了材质、尺寸和退货期限,你就知道接下来该改什么了。
这和传统 A/B 测试也不同。A/B 测试需要流量和数周时间,而模拟只需要商品目录和几分钟。Shopify 的工程团队在自己的智能体项目中也写过类似思路:他们的 ShopGym 沙盒 让开发者能在受控且一致的条件下复现智能体失败情况,而这正是你无法从真实消费者身上获得的。如果想进一步了解为什么要在上线改动前先测试,我们在 面向 AI 智能体的“模拟优先”A/B 测试.
AI 智能体如何读取你的店铺
智能体根本看不到你的首页。它读取的是机器可读数据,而不同平台的数据来源也不同。
在 Shopify 上,商品目录数据已标准化,方便应用和智能体搜索与展示。Shopify 在 Summer '25 发布中提到 Shopify Catalog 对价格、选项和库存状态进行了标准化 ,供应用和 AI 智能体使用。实际结果就是:薄弱或不一致的商品记录会跟着你出现在所有渠道。
购物助手也会把静态商品信息与实时消费者行为结合起来。Gorgias 文档提到,它的 Shopping Assistant 会结合商品目录信息、商品页内容、自定义商品详情以及消费者行为数据,例如浏览过的商品和购物车内容,来决定推荐什么。静态部分才是你能控制的:描述、材质、保修信息。
然后是结账。Google 的 UCP(Universal Commerce Protocol)是面向智能体结账的开放标准。Google 自己的开发者资料写道,UCP 可通过 /.well-known/ucp 配置文件实现商家发现、商品目录搜索和结账。它还配合 AP2 支付协议使用,商家签名的结账信息会与消费者授权内容进行校验,因此智能体无法偷偷修改价格。如今,美国用户已经可以在 Google AI Mode 和 Gemini 中直接在 AI 回答内完成购买。ChatGPT 则会把消费者带到商家自己的结账页面。
OpenAI 有自己的协议,Google 有 UCP,而 Amazon 是封闭体系。你的商品目录必须能和它们全部兼容,至少别在它们面前出问题。
如果想从底层理解这些智能体是如何构建的,这篇关于 如何构建 AI 智能体 的指南能帮助你更直观地理解“检索—推理—执行”循环。它也解释了为什么缺失字段对模型来说等于不存在:数据里没有,它就看不见。
模拟中该检查什么
开始运行之前,先弄清楚智能体可以依据哪些字段作出判断。Google 的 Merchant Center 文档列出了支持的属性,其中决定大多数比较结果的是标题、描述、图片、品牌、SKU、GTIN、价格、计价币种、库存状态,以及结构化的配送和退货信息。完整列表可查看 Google 结构化数据属性参考.
当智能体选择竞品时,我会这样解读每个字段:
| 字段 | 智能体如何使用 | 常见失败情况 |
|---|---|---|
| 标题 | 最先与消费者需求匹配的内容 | 只有品牌名,没有商品类型、尺寸或用途 |
| 描述 | 智能体给出理由时的主要信息来源 | 只有营销文案,没有具体属性 |
| GTIN、品牌、SKU | 确认这是一个已知且明确的商品 | 标识符缺失或重复 |
| 价格与货币 | 用于基础比较与结账 | Feed 中的价格与页面不一致 |
| 库存状态 | 决定是否适合推荐 | 库存状态过期 |
| 配送与退货 | 决定购买流程能否完成 | 字段缺失或不一致 |
决定输赢的往往是那些不起眼的问题。在我们自己的审查中,一家年销售额约 7000 万欧元的烈酒电商平台,其 9,699 个商品中有 88% 存在智能体读取的数据问题。当智能体被问到应去哪里购买该平台销售的两瓶酒时,平台在 20 次回答中被提及的次数为 0。那个团队没有人想让商品变得不可见,只是商品数据源传递出了这样的信息。
结账环节也会悄无声息地失败。一家瑞典护肤品牌的智能体结账流程,在 6 个国家中有 0 个进入了支付阶段,因为配送设置要求填写电话号码。智能体没有消费者的电话号码,这其实很合理。这里不会点名任何店铺,我也会继续保持匿名。
如何在自己的商品目录上运行模拟
你可以先手动做一个粗略版本,而且如果从没做过,建议先这样试。选一个商品和一个真实竞品,然后按以下步骤操作。
- 像真实消费者在聊天里输入那样写出购物需求,包括预算、用途和限制条件。
- 把你的商品记录和竞品记录放进同一个提示词里,尽可能去掉品牌信息,然后让模型做选择并说明原因。
- 至少换两个不同模型重复测试。它们之间的分歧会比你想象的大。
- 保存模型给出的理由并分类:缺失属性、卖点较弱、价格、配送、信任度。
- 只修改商品信息中的一个点,再用完全相同的提示词重新运行,看看选择是否发生变化。
最后一步才是关键。一次只改一个东西,否则你什么也学不到。
手动给一个商品做这种测试,大概需要一个下午;给 800 个商品做,就成了一份全职工作。这也是我们打造 ecentic 的原因:它能连接 Shopify、WooCommerce 或商品 feed,让 ChatGPT、Claude 和 Gemini 将每个商品与指定竞品进行比较,并显示它为什么会输给竞品。如果想了解这一类工具,我们写过一篇 用于测试商品页可见性的 AI 智能体模拟器 ,里面比较了不同方案,你也可以试试 UCP Playground ,直接针对店铺测试智能体。
如果你的团队偏开发导向,也可以测试数据管道这一侧。Stripe 文档介绍了一个沙盒环境,平台可以 上传商品目录数据,并验证解析、字段映射和数据质量 ,然后再启用实时更新。思路是一样的:在智能体看到线上版本之前,先验证数据。
如何避免误读模拟结果
模拟本质上是“模型对模型”的模拟。它可能在两个层面出错:模拟消费者不是真实消费者,而你测试的 AI,也未必是下个月消费者实际使用的 AI。那么你该相信它多少?
这里其实有一些有价值的学术证据。SimGym 论文使用视觉语言智能体在真实浏览器中模拟电商店铺的 A/B 测试,并且 报告称其与真实加购变化方向的一致率达到 77%。作者使用方向一致性和 Pearson 相关系数来比较模拟结果与真实变化。正确理解这个数字的方式是:模拟通常能指出正确方向,但有时也会出错。它适合帮助你筛选优先尝试的改动,但并不能替代真实结果。
我是这样区分“发现”与“猜测”的:
- 重复出现的理由。 如果三个模型都指出同一个属性缺失,那就去修复。这属于有效发现。
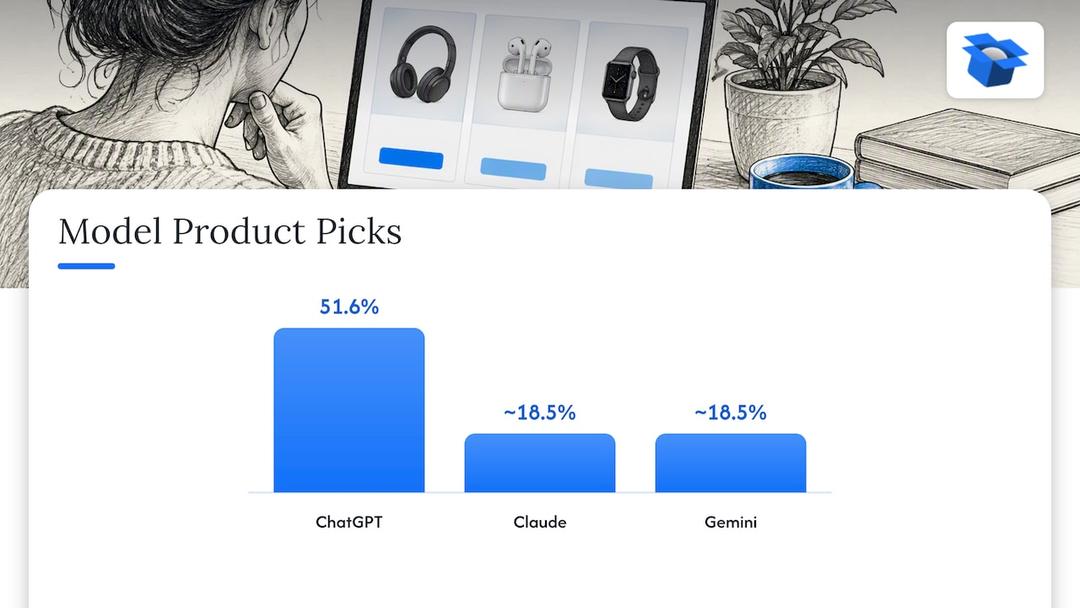
- 模型之间的差异。 在我们的模拟中,截至 2026 年 10 月,基于 36,797 次模拟购买,ChatGPT 在同一商品目录上的选择频率大约是 Claude 或 Gemini 的 3 倍(51.6% 对约 18.5%)。同样的商品,不同模型的偏好习惯差异很大。所以不要把多个模型平均成一个分数,而是分别解读。
- 单次异常选择。 如果一次运行因为奇怪理由偏向竞品,在重复出现之前都只是噪声。
- 关于营收的预测。 模拟不会告诉你最终能卖多少。谁要是这么说,那他就是在卖东西,而我也在卖东西,所以我现在直接说明白。
公平地说,模拟无法替代真实流量数据。它告诉你应该先修什么、为什么修。至于是否真的有效,只有你自己的访问、购物车和订单数据才能说明。
把发现转化为可衡量的修复
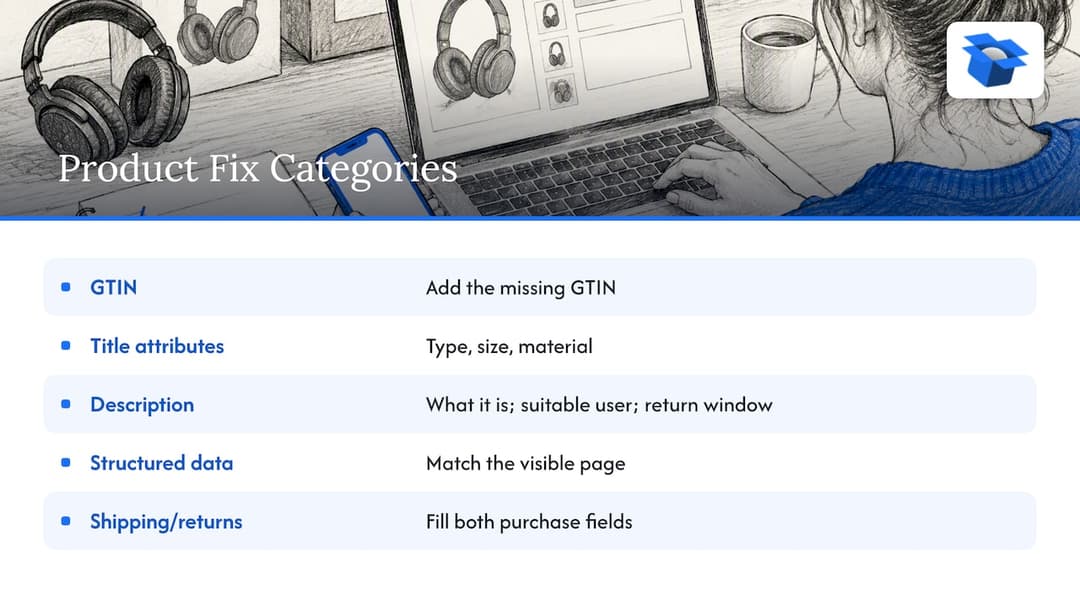
大多数修复都很枯燥,也很具体。补上缺失的 GTIN;在标题中加入商品类型、尺寸和材质;把“氛围感”描述改成明确说明商品是什么、适合谁以及退货期限;让结构化数据与页面内容一致;补全配送和退货字段,让购买流程能顺利完成。
然后分两层来衡量效果。
第一步,重新运行同样的比较。如果智能体现在选择了你,并且理由里提到了你新增的属性,那说明修复生效了。这一步成本低、速度快,也是模拟真正发挥价值的地方。
第二步,观察真实行为。来自 AI 助手的访问量,是你在分析工具里能看到的最早信号。我们的首个试点客户 DUA Flavours,在 2026 年 4 月到 7 月期间,来自 AI 助手的访问量和直接流量都增长了 12%。这是访问量数据,不是销售额,而且单个试点只能说明单个案例。但这种变化至少是你真正可以追踪的,而我们的 AI 智能体流量指南 会告诉你如何搭建追踪。至于商品信息本身的优化,可参考我们的 面向 AI 推荐的商品信息优化.
在 Shopify 上,ecentic 会把修复同步到 Google Merchant Center,并跟踪来自 AI 助手的访问。在 WooCommerce 上,免费的 ecentic 插件允许智能体通过 UCP 搜索商品、加入购物车并完成结账。普通的 feed 工具通常跳过结账部分,而我们的瑞典案例正是在这里损失了所有订单。
关于竞品工具,还要补充一点,因为你肯定会做比较。很多 feed 管理产品在自己的领域做得很好:清洗、映射并把商品目录同步到多个渠道。如果你的主要问题是把一个 feed 分发到二十个 marketplace,它们会很适合你。但它们通常止步于 feed 本身。我们的对比文章 最佳 AI 购物智能体优化工具,会说明不同工具分别适合什么场景。
我们的观点
我认为,大多数品牌把 AI 购物当成排名问题,但它其实更像一次面试。智能体会向你的商品记录提出一系列问题,而无法回答的记录,就会输给能回答的记录。输掉的一方通常甚至不知道自己为什么输。
这也是为什么我们做的是正面对比。只给店铺一个分数,既没意义,也容易让人自我感觉良好。把指定竞品放在你旁边,再让智能体解释为什么选它,虽然不舒服,但很有用。基于这个原则,我们已经运行了 36,797 次模拟购买,而原因几乎从来不复杂。通常只是字段缺失、标题模糊,或者没人测试过的结账设置。
我们也认为,发现问题只完成了一半工作。所以当你点击 Apply 时,ecentic 会重写标题、描述和结构化数据,并直接发布到店铺。至于购买环节,我们希望智能体真正完成下单,而不只是“欣赏”商品。相比再写一份报告,我更愿意帮店铺通过智能体多卖出一个订单。
至于未来会怎样,我并不完全乐观。消费者会把越来越多决策交给智能体,而智能体会优先选择最容易读取的数据。那些不整理数据的店铺,会在从未见到消费者的情况下,直接输给整理过数据的店铺。这句话听起来有点冷酷,但问题其实可以解决。
Xhurian Shaba
从免费检测开始
我们的标语很简单:当 AI 代替用户购物时,拿下这笔销售。想最快了解这对你的店铺意味着什么,可以先做免费检测。它会覆盖你排名前 10 的商品,无需信用卡,并告诉你智能体更偏好哪个竞品商品,以及原因是什么。
如果这个模式确实存在,我们的付费方案列在 价格页面。Compete 每月 $14.90,最多支持 100 个商品。Scale 每月 $44.90,最多支持 1,000 个商品,并提供一键修复。Dominate 每月 $149,额外包含 Google Merchant Center 同步和智能体结账配置。另有按量计费方案,按 AI 归因订单的 3% 收费,每月上限 $500。Enterprise 提供自定义额度、API 和 MCP 访问以及 DPA,未公开定价。

Shopify 商家可以从 Shopify 店铺 AI 方案 页面开始,而 AI 商品信息优化 页面则展示了 Apply 会如何修改商品记录。
FAQ
什么是电商中的 AI 商品信息模拟?
它是一种测试方式:让 AI 模型基于智能体实际读取的数据,在你的商品和指定竞品之间做选择。你会得到一个结果,以及模型给出的理由。这些理由会告诉你应该修复哪些字段、卖点或结账设置。
哪些字段在模拟中最重要?
标题、描述、图片、品牌、SKU、GTIN、价格、货币、库存状态,以及结构化的配送与退货信息。Google 将这些列为其支持的商品属性。建议先从标题和描述入手,因为它们决定了智能体能复述哪些理由。
模拟结果有多准确?
把它当作方向性参考即可。一项学术研究发现,模拟店铺测试与真实加购变化方向的一致率达到 77%。这说明模拟很适合帮助你决定先尝试什么,但并不适合预测销售额。
同时支持 Shopify 和 WooCommerce 吗?
支持。ecentic 可以连接 Shopify、WooCommerce 或普通商品 feed。在 Shopify 上,修复内容还会同步到 Google Merchant Center。在 WooCommerce 上,免费插件允许智能体通过 UCP 搜索商品、加入购物车并完成结账。
不付费也能测试吗?
可以。免费检测会覆盖你排名前 10 的商品,无需信用卡。足以帮助你判断智能体是否更偏好竞品,以及它们给出的原因。
探索相关主题