

面向AI的A/B测试,是指对不同版本的商品信息变体进行受控对比,看看ChatGPT、Gemini、Claude或Perplexity实际会向购物者推荐哪一个版本。先拿少量几个核心SKU,在这些智能体中做模拟,然后在测试开始前先修掉最常导致测试失效的两类问题:缺失的结构化数据和过期的商品数据源字段。优先保证结构化数据完整、商品数据源及时更新以及评价深度,因为智能体展示什么商品时,这三类信号权重最高。
要点速览:
- priceValidUntil、deliveryTime 和 merchantReturnDays 等结构化数据字段经常缺失或过期,会明显影响智能体的推荐结果。
- 商品 feed 新鲜度和实时更新至关重要,因为过期的价格或库存状态会导致商品信息不匹配,并带来销售流失。
- 测试应聚焦于隔离具体的结构化数据或商品 feed 变量,而不是随意修改文案,因为智能体信号主要由数据驱动。
- 变体必须在多个模型上测试,因为不同 AI 智能体对展示位置和属性有不同偏好。
- 在正式上线前先进行基于模拟的检测,可以快速找出结构化数据缺口、提升 AI 可见性,并增加高购买意向购物者带来的流量。
为什么面向 AI 购物智能体的 A/B 测试对 Shopify 和 WooCommerce 商店很重要
AI 购物智能体的浏览方式与人不同。它们读取机器可读信号:结构化数据、Feed 准确性,以及评论和媒体提及等第三方佐证。一个在人类消费者看来设计精美的页面,如果底层标记信息不足,对智能体来说可能完全不可见。
Columbia Business School 进行了模拟购物实验,发现 商品位置、徽章、价格和评分会影响智能体选择哪些商品。不同模型的偏好也不同。GPT-4.1 更倾向于结果列表左侧的商品,Claude 偏好中间位置,Gemini 偏好右侧。仅这一点就说明,不存在适用于所有智能体的“最佳”商品信息。最佳方案是因模型而异,这也正是测试优于猜测的原因。
对商家来说,收益是真实存在的。通过 AI 智能体进入网站的流量通常购买意图更强,因为消费者在进入页面前已经获得了推荐。但关键在于,商品详情页必须能验证智能体所说的信息。如果智能体写着“30 天内免费退货”,而页面可见文案或 schema 中没有对应说明,交易一开始就可能流失。
智能体最看重的因素包括:
- Product、Offer 和 Review schema 类型的结构化数据完整性
- Feed 新鲜度,即价格和库存状态是否与网站实时信息一致
- 通过评论、聚合评分和媒体报道形成的独立佐证
测试什么:属性、Schema 字段与站外信号
开始任何实验前,先明确哪些字段和信号值得调整。随机修改文案只会浪费时间。测试智能体真正会解析的字段,才有意义。
- 核心 JSON-LD 字段。 智能体会直接读取
Product,Offer,AggregateRating以及Reviewschema。在Offer,priceValidUntil的重要性远超大多数商家的认知,而ShippingDeliveryTime.deliveryTime和MerchantReturnPolicy.merchantReturnDays同样关键。一项 Sellarix 对 36 个商品页面的检测 发现,72% 的页面包含 Product JSON-LD,但priceValidUntil仅 6% 包含 priceValidUntil,配送时间仅占 11%,退货天数仅占 6%。接受检测的页面中,没有一个同时具备这三项字段。 - Feed 与协议健康度。 Merchant Center Feed 完整性、AI 智能体商业协议就绪度(ACP、UCP、MCP)以及刷新频率,都会决定智能体获取的数据是否与网站实时内容一致,相关细节可参考这份 Ecommerce AI SEO 指南。如果 Feed 每天只更新一次,而测试过程中价格发生变化,实验结果可能会被悄悄污染。
- 站外证明。 评论数量、最新评论时间和内容具体程度,比单纯的星级评分更重要。零售合作伙伴之间同步的评论,以及任何媒体提及,都会为智能体提供可交叉验证的佐证。
每个测试变体都应该只隔离这三类因素中的一种。改 schema,不改文案;改文案,不改 Feed 刷新频率。混合变量只会让商家最终得到无法解释的结果。
如何为 AI 购物智能体运行 A/B 测试?
这种测试更像一次受控的工程发布,而不是传统营销分流测试。下面这套流程能让结果保持干净可靠。
- 先确定测试 SKU,并提前定义成功标准。 选择 3 到 5 个真正带来营收的商品,而不是整个商品目录。开始前先设定成功指标:AI 声量份额(智能体在被要求推荐某类商品时,推荐你商品的频率)、引用频率,以及智能体引流会话带来的转化提升。
- 设计单变量测试变体。 创建一个只修复 schema 的版本(例如新增
merchantReturnDays),一个调整描述中规格排序的版本,以及一个突出展示评论摘录的版本。不要把两项修改打包进同一个变体。 - 先模拟,再上线。 让每个变体至少在两个模型系列的代表性智能体会话中运行模拟。当前已有大量研究证明模型偏好存在差异,一个在某模型中胜出的变体,可能在另一个模型中失败。
- 谨慎进行线上验证。 当模拟结果显示某个版本更可能胜出后,可通过分阶段提交 Feed,或在平台支持的情况下使用 ACP/UCP 沙盒环境逐步上线。避免第一天就切换 100% 流量。
- 处理好工程细节。 在 Shopify 或 WooCommerce 中,应采用服务端渲染 JSON-LD,而不是通过标签管理器注入;为每个变体分配独立 GTIN,避免智能体或 Feed 将两个版本合并为同一个商品;并编写集成测试,确保智能体关键字段出现在原始 HTML 响应中,而不只是开发预览里。
专业建议: 每次修改主题、Feed schema 或评论管理应用后,都要重新运行模拟。一次模板更新,就可能悄悄删除一个花了数周时间才建立好的 JSON-LD 模块。
像 ecentic 商品信息功能 这样的工具,可以大幅缩短第 5 步的时间,因为它会直接诊断缺失字段,并一次性将修复应用写回商店,而不是依赖人工检测。
哪些指标真正能说明某个变体胜出?
虚荣指标在这里没有意义。真正重要的是,智能体是否展示了你的商品,以及这些展示带来的访问是否完成转化。
需要跟踪的核心 KPI:
- AI 声量份额:在预定义测试提示词集合中,相对于竞品,你的品牌被提及的频率
- 引用频率:智能体引用你的具体商品页面或属性的频率
- 智能体引流转化率:通过已知智能体来源进入的会话转化率,并与自然流量和付费流量分开跟踪
技术健康度指标同样重要,因为一个损坏的 Feed 足以拖垮原本会胜出的变体:
- 整个商品目录中的 schema 覆盖率
- Merchant Center 中 Feed 的通过率与拒登率
- 以下字段的存在率:
priceValidUntil,deliveryTime以及merchantReturnDays
建立一个 面向已知智能体来源的 GA4 分组 ,例如 perplexity.ai、chatgpt.com 和 copilot.microsoft.com,然后为该分组单独建立转化漏斗,而不是合并进整体自然流量。
智能体引流流量的样本量在初期通常较小,这意味着许多测试一开始可能无法得出统计学显著结论。连续一周结果持平,应视为无效结果而不是失败;至少等到完成两轮完整的模拟与线上验证周期,并观察到稳定模式后,再向整个商品目录推广。
常见陷阱、控制方法与专业建议
大多数失败测试都源于少数几个重复出现的问题:
- 客户端价格动态加载。 如果价格是在页面首次渲染后通过 JavaScript 加载,某些智能体可能根本看不到它,导致 Feed 价格与网站实时价格不一致。
- 缺少变体级唯一标识。 如果没有独立 GTIN,智能体(或你的 Feed)会把两个测试变体合并成同一个商品信息。
- Feed 数据不一致。 网站显示一个价格,Feed 显示另一个价格,而智能体会选择它更不信任的那个。
- 退货或配送字段配置错误。
MerchantReturnPolicy与实际政策不一致时,消费者一旦发现,信任会迅速流失。
为每个商品模板建立一个自动化集成测试,在服务器响应中而不是渲染后的 DOM 中检查这些字段。这样能在模板更新悄悄删除六周的 schema 工作成果前,提前发现回归问题。
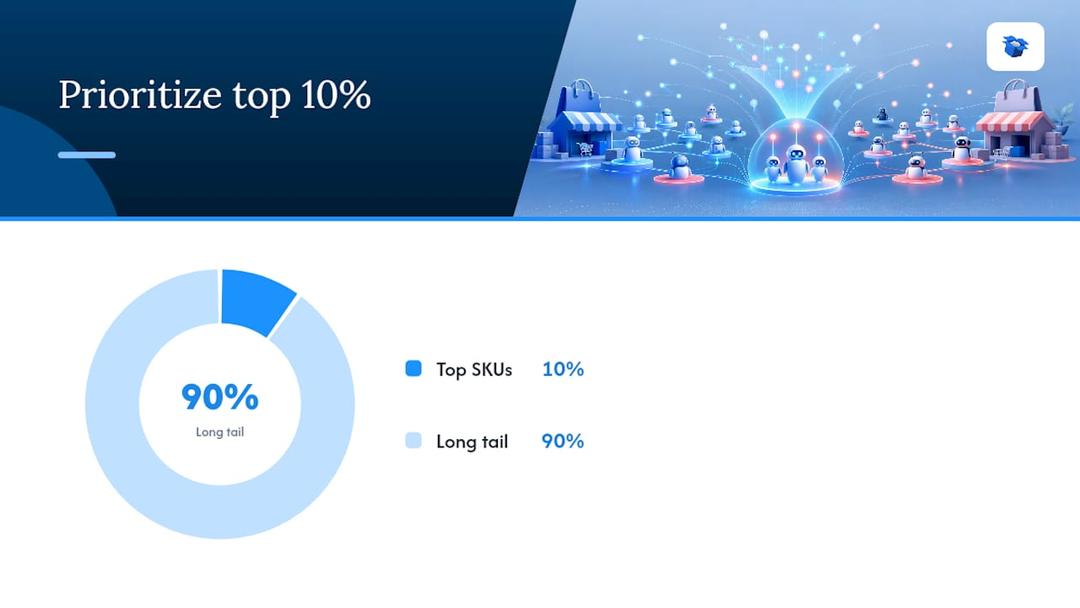
专业建议: 优先处理核心营收 SKU。先修复商品目录中按营收排名前 10% 的商品,再处理长尾商品。同时,引导评论者回答具体问题(例如“你用它做什么?”),而不是仅请求星级评分。场景化评论才是智能体真正会提取的内容。
模拟驱动测试真正改变了什么
当你运行数十次商品页面检测和智能体模拟会话后,对“赢得”商品信息的理解会发生变化。直觉上,人们会觉得需要写更好的文案。但现实是,大多数失败都源于某个 schema 模块中缺失了字段,而这个模块已经八个月没人检查过。
一种在任何内容上线前,先让每个商品信息经过智能体模拟会话测试,再一步发布修复结果回 Shopify 或 WooCommerce,而不是提交耗时数周的开发工单的方法,可以在问题修复后帮助商家提升 AI 驱动访问量和后续销售。
— Xhurian
用 Ecentic 开始您的第一次 A/B 测试
有些平台已经把上述流程变成了可快速运行的工具。它们会针对 ChatGPT、Gemini、Claude 和 Perplexity 模拟你的商品信息,直接用通俗语言解释竞品为什么在对比中胜出,并一键将修复结果写回 Shopify 或 WooCommerce,无需开发工单,也不用等待模板发布。

无需手动检查 priceValidUntil 或 merchantReturnDays 在整个商品目录中的情况,您会获得一份诊断报告,准确标出缺失的智能体关键字段,随后通过自动优化修复这些问题。持续复扫会跟踪每次修改后,各智能体对您商品的选择率是否上升,让您不必再猜测修复是否有效。先进行免费扫描,选出 3 个真正带来营收的 SKU,运行模拟,再发布胜出的版本。套餐起价: Compete 套餐每月 $14.90,随着商品目录和业务目标增长,还可升级到 Scale 和 Dominate。
FAQ
AI 智能体 A/B 测试需要多长时间?
变体准备完成后,一个模拟周期通常 1 到 2 天即可完成,因为它不依赖真实流量规模。线上验证则需要更长时间,通常为 2 到 4 周,因为大多数商店的智能体引流样本量仍然较小。
运行这些测试需要开发资源吗?
需要有人能编辑 JSON-LD 和 Feed 数据,但像 ecentic 这样的平台,可以通过诊断问题并直接将修复发布到 Shopify 或 WooCommerce,大幅减少手动编码工作。
哪些 Schema 字段对 AI 智能体最重要?
Offer.priceValidUntil, ShippingDeliveryTime.deliveryTime以及 MerchantReturnPolicy.merchantReturnDays 是 Sellarix 检测中最常见缺失的三个字段,即使很多商店的 Product schema 本身已经相当完善。
我可以针对不同 AI 模型测试不同商品变体吗?
可以,而且应该这样做。模拟结果显示,不同模型存在特定偏好,一个在某个智能体中胜出的变体,可能在另一个智能体中失败,因此上线前至少针对两个模型进行测试,是值得增加的一步。
ecentic 的价格是多少?
ecentic 的 Compete 套餐起价为每月 $14.90,Scale 为 $44.90,Dominate 为 $149。此外,还提供按效果付费选项,对每笔 AI 归因订单收取 3% 的服务费。正式订阅前可先进行免费检测。