

管理できるすべてのリンクに utm_medium=ai_search を設定し、各サーフェスごとに小文字で管理された utm_source トークンを組み合わせます。たとえば chatgpt、perplexity、gemini、claude、copilot です。この1つの medium が結合キーとなり、分析上で AI エージェント経由の参照を独立したチャネルとして表示できるようになります。UTM は最も信頼度の高いシグナルなので、まずタグを付け、それ以外はフォールバックとして扱ってください。
要点
- 正規化リダイレクト、プロキシ、CDN ルール、購入手続きへの遷移をまたいでも、クエリ文字列全体を保持してください。各エージェントのクリックについて、最終的なランディング URL まで必ずテストします。
- GA4 では、完全一致の ai_search medium ルールを referrer ルールより上に置き、その後にデフォルトの Referral と Organic Search を並べてください。タグのないホスト一致は中程度の信頼度として分類します。
- UTM が消える場合は、user agent やサーバーログの前にまず referrer を確認してください。また、クローラーのアクティビティはクリックを表していない可能性があるため、推定一致には低い信頼度ラベルを付けます。
- eコマースでは、リダイレクトと購入手続きの後も初回流入の UTM が注文レコードに到達していることを最初に確認してください。そのうえで、AI に帰属した訪問とコンバージョンを比較し、商品情報の修正点を特定します。
AI エージェント向けの推奨 UTM 規則とは?
この規則は、意図的にシンプルに設計されています。 AI Search Referrer Attribution Reference Spec では utm_medium=ai_search、UTM に対する制御された語彙として utm_source、リダイレクトを通じて保持される UTM、そして優先順位順に並べた GA4 カスタム チャネル グループを推奨しています。単一の固定 medium トークンを使うことが重要です。そうすることで、すべてのダッシュボード、フィルター、チャネルルールが、多数のバリエーションではなく単一の値を基準に処理できます。
推奨するパターンは次のとおりです。
- utm_medium: 固定文字列として
ai_searchを使用し、モデルやキャンペーンごとに変更しないでください。 - utm_source: 次のいずれかを使用
chatgpt,perplexity,gemini,claude,copilot。すべて小文字で統一します。複数単語のトークンが必要な場合はハイフンを使用してください。 - utm_campaign: 次のような施策名
spring-catalogまたはproduct-feed. - utm_content: 次のような掲載場所
citation-linkまたはstructured-data. - utm_term(任意): 生のプロンプト テキストを公開せずに、プロンプト コホートをグループ化する短いハッシュ値。
そのまま使える例を 2 つ紹介します。
https://example.com/products/trail-shoe?utm_source=chatgpt&utm_medium=ai_search&utm_campaign=spring-catalog
https://example.com/collections/rain-jackets?utm_source=perplexity&utm_medium=ai_search&utm_campaign=product-feed&utm_content=structured-data
Analytics Mania では、細かさよりも一貫性が重要だとしています。ai_search のような広い medium を使用し、プラットフォーム識別は utm_source に持たせます。
管理可能な接点に UTM を追加し、保持するには?
タグは、ランディングページまで維持されて初めて意味を持ちます。まず、どこでパラメータを付与できるかを決めてください。コンテンツ引用、RSS やプラグイン出力、構造化データ フィールド、API 駆動ウィジェットなどです。送信先 URL を管理できる場所では、アトリビューションも管理できます。
Google の URL ビルダー に関するガイダンスでは、utm_source、utm_medium、utm_campaign を常に設定し、命名を一貫させ、可能な場合は utm_id と utm_source_platform を追加してレポート内の “(not set)” を避けるよう推奨しています。その方針に従ってください。
- AI 接点向けにサイトへのリンクが生成されるすべての場所を洗い出します。フィード、プラグイン出力、構造化データ、ウィジェットなどです。
- URL は手作業ではなくビルダーで生成し、語彙を管理された状態に保ちます。
- canonical リダイレクトを設定し、完全なクエリ文字列を最終 URL へ転送するようにします。
- クエリ パラメータを削除するプロキシは削除するか、設定を変更してください。
- CDN のエッジルールでは、クエリ文字列をオリジンへ渡し、削除後 URL ではなくパス単位でキャッシュするよう設定します。
- 各エージェントからクリックテストを行い、最終ランディング URL を確認し、GA4 または BigQuery でセッションレベルの utm 値を検証します。
実践ポイント: 最終 URL ではなく、リダイレクトを含む URL でテストしてください。UTM の消失の多くはリダイレクト経由で発生し、直接ランディングページをテストしても検出できません。
こちらの AI ショッピング トラフィックを追跡する方法 ガイドでは、このチェックリストに追加できる ecommerce 向けテストも紹介しています。
AI 検索向けの GA4 アトリビューション ルールとチャネル優先順位はどう設計すべきですか?
順序がすべてです。カスタム チャネル グループは上から順に評価され、最初に一致したルールが適用されます。汎用的な Referral や Organic のルールが AI ルールより上にあると、AI クリックは独自チャネルに到達しません。
次の優先順位を使用してください。
- 第 1 優先:
utm_mediumが完全一致ai_search。これが最も信頼できる判定です。UTM が存在する場合、Analytics は UTM パラメータを唯一の基準として扱い、クロスチャネル ディメンションもそこからのみ導出します。 - 第 2 優先: UTM がないトラフィック向けのリファラー ホスト許可リスト。
- 第 3 優先: 推定ルール。低信頼として扱います。
リファラー ルールには、次のような regex を使用してください chat\.openai\.com|chatgpt\.com|perplexity\.ai|gemini\.google\.com|copilot\.microsoft\.com|claude\.ai|you\.com。UTM ルールの直後、デフォルトの Referral と Organic Search より上に配置してください。
| 優先順位 | ルール | 信頼度 |
|---|---|---|
| 1 | utm_medium が ai_search に一致 | 最高 |
| 2 | 参照元またはリファラー ホストが許可リスト regex に一致 | 中 |
| 3 | 推定一致(新規 client_id、AI 型ランディング パス、短い鮮度ウィンドウ) | 低 |
推定一致には必ず信頼度ラベルを保存し、レポート側で重み付けできるようにしてください。regex の例を含む具体的な GA4 設定については、 AI リファラー トラフィック追跡に関するこのパートナー解説 が参考になります。
リファラーや UTM が欠落している場合はどうしますか?
一部の AI 接点では、リファラーとパラメータの両方が失われる形でリンクが開かれます。そのため、各レイヤーに正直な信頼度スコアを持たせた多層検出が必要です。 AI トラフィック向け派生フィールドに関する Adobe のドキュメント では、主要シグナルとして user-agent 識別、リファラー分類、クエリ パラメータ検出を挙げています。
- クエリ パラメータ検出(最高信頼度): まず UTM を確認します。サービス側でパラメータが追加される場合や、リンクをタグ付けしている場合は、これが最も明確なシグナルです。
- リファラー分類(中): を保持し
document.referrer、そのホストを検証済み AI ドメイン レジストリと照合します。クライアント側とサーバー側でルールが一致するよう、レジストリは共有ファイル 1 つで管理してください。 - User-agent とサーバーログ(中〜低): サーバー側ログでは、既知のエージェントやクローラー パターンを識別できます。ただし、エージェントがページを取得したことは分かっても、人間によるクリックと同じとは限りません。
- 推定ヒューリスティック(最低): 新しい client_id、AI が引用しやすいページと一致するランディング パス、短い鮮度ウィンドウを組み合わせます。これらは confirmed ではなく inferred としてタグ付けしてください。
これらのチェックはこの順序で実行し、最初に一致した時点で停止します。その後、信頼度の値を下流へ渡し、モデル側で推定値を割り引けるようにします。 Ahrefs の AI トラフィック講座 でも、一部プラットフォームではリファラーが一貫して渡されないため、「どこで知りましたか?」の自己申告フィールドを補助的に使うことを推奨しています。
分析データの分断を防ぐ命名ルールとは?
分断はアトリビューションを静かに壊します。“ChatGPT”“chatgpt”“chat-gpt” が別々の 3 行になれば、誰もレポートを信用しなくなります。
- すべて小文字で統一し、複数単語の値にはハイフンを使用してください。
- utm_source 用には 1 つの管理語彙を維持し、
ai_searchは utm_medium 専用にしてください。 - モデルごとに medium を増やさないでください。プラットフォーム単位の識別は utm_source に持たせます。
- 語彙を文書化し、自動ビルダーで URL を生成し、公開前 QA を追加し、段階的に展開してください。
実践ポイント: 語彙はコードとして扱ってください。レビュー済みの単一ファイルで管理し、リストにない値は URL ビルダーで拒否するようにします。
タグ設定を素早く検証するには?
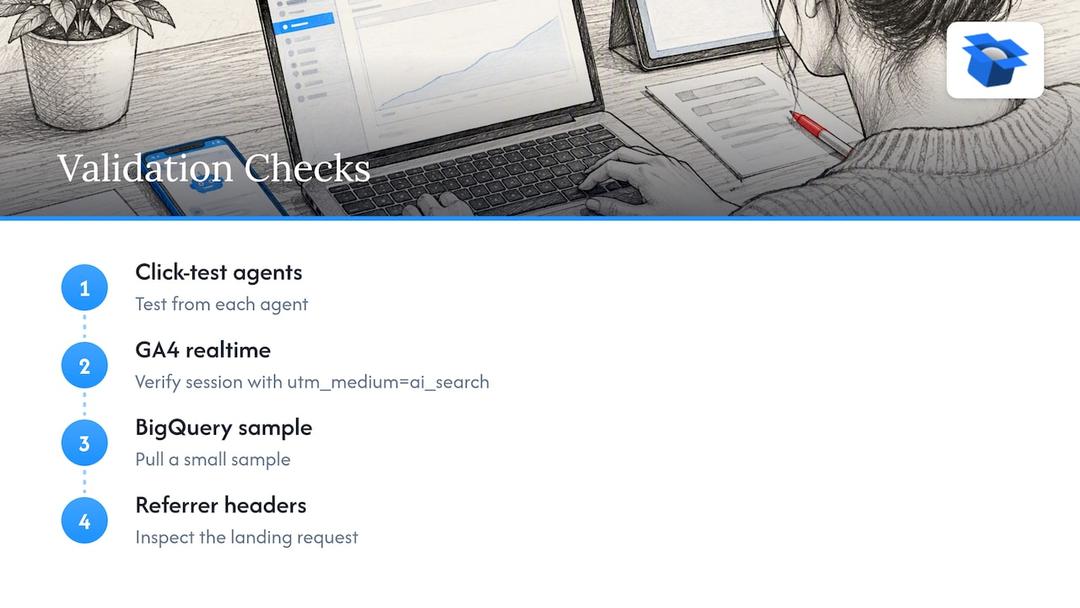
どの設定でも同じ短い手順を使っています。各エージェントからクリックテストを実行し、GA4 リアルタイム レポートで utm_medium=ai_search を持つセッションを確認し、小規模な BigQuery サンプルを取得し、ランディング リクエストの referrer header を確認します。
注意すべき落とし穴は 2 つあります。リファラーを削除するモバイル アプリ内 webview と、チーム間で不一致な source トークンです。シミュレーション駆動のチェック、エージェント アトリビューション分析、そして UCP Playground は、まさにこの種の実地テストのために用意されています。数値を信用する前に、エージェントがページをどのように引用しリンクするかを確認できます。
Shopify と WooCommerce で UTM タグ設定を機能させるには?
ecommerce プラットフォームには独自のリダイレクト、購入手続き遷移、アプリがあり、それぞれがパラメータを削除または上書きする可能性があります。目的は、最初のクリック時に設定したパラメータが、注文記録時点でも保持されていることを確認することです。
Shopify では、送信元で商品 URL にタグを付け、その後の market・言語・通貨リダイレクト後のランディング URL に完全なクエリ文字列が残っているか確認してください。リダイレクトや cart 属性を扱うアプリが URL を書き換えていないかも確認します。first-touch UTM がセッションだけでなく注文データまで到達していることを確認してください。そこが AI 訪問と売上を結び付けるポイントです。
WooCommerce でよくある原因は、キャッシュ プラグインとセキュリティ レイヤーです。ページ キャッシュはクエリ文字列を削除せず、パス単位で分岐するよう設定し、canonical と redirect プラグインがパラメータを転送することを確認してください。headless または API 駆動 storefront を使用している場合は、購入手続き時に UTM 値を注文メタデータへ渡します。
どちらのプラットフォームでも、各エージェントから商品ページ 1 件とコレクション ページ 1 件をテストし、その後テスト注文までクリックを追跡してください。こちらの エージェント駆動トラフィック分析 では、これらの storefront に適した実装パターンと検証方法を紹介しています。アトリビューション レポートを自前で実装せずに利用したい場合は、Shopify と WooCommerce に直接接続できます。
両方で共通ルールを維持してください。medium は ai_searchのまま固定し、プラットフォームごとに変更するのは utm_source のみです。
UTM データは AI 推薦向けの商品情報をどう改善できますか?
AI セッションを明確に分離できるようになると、どこを改善すべきかがデータから見えてきます。まず、AI アトリビューション付きセッション数でランディングページを順位付けし、次に AI アトリビューション付きコンバージョン数で並べ替えます。AI 訪問は多いのにコンバージョンが低いページは商品情報の問題です。コンバージョンは高いのに AI 訪問が少ないページは可視性の問題です。
結果を utm_source ごとに分析してください。perplexity がコレクションページへ流入を送り、chatgpt が個別商品ページを優先する場合、各エージェントがどの形式を表示しやすいかが分かります。utm_content を使って掲載場所を分離し、構造化データ リンクが通常の引用より成果を出しているか確認してください。
そして、見つかった内容に基づいて改善します。トラフィックはあるのにコンバージョンが弱いページでは、タイトル、仕様、説明文を書き換え、AI 会話から来た購買者の質問に答えられるようにします。コンバージョンはあるのに訪問が少ないページでは、エージェントが読む属性を強化します。素材、サイズ、互換性、配送条件、返品条件などを明確にしてください。当社の AI 商品情報最適化 ツールは、このループを前提に設計されています。競合商品との比較でページが選ばれない理由の診断から、書き換え、公開まで対応します。
変更は、短期間で範囲を限定したテストで測定してください。1 セットのページのみ変更し、類似ページ群は固定したまま、同じ期間で AI アトリビューション付きコンバージョンを比較します。こちらの AI トラフィックをコンバージョンにつなげる方法 では、訪問獲得後に何を行うべきかをさらに詳しく解説しています。
適切な UTM タグ設定の実例とは?
ここでは架空の入力を使った例示を紹介します。あるストアで、AI エージェントが 2 つの商品ページを引用しているとします。タグ設定前は、すべての AI クリックが Direct と Referral に混在しており、どのページから来たのかも、注文との関連も分かりません。
ストアが utm_medium=ai_search を導入し、管理された source を使用し、クエリ文字列を削除していたリダイレクトを 1 件修正すると、状況は変わります。チャネル グループに AI Search の行が独立して表示されます。source 別にセッションを分けると、あるエージェントが高意図の商品ページ 1 件へ大半の訪問を送っていることが分かります。チームは、そのページに説明不足と返品ポリシー欠如があることを確認し、内容を書き換え、その後数週間にわたり AI アトリビューション付きコンバージョンを追跡します。
重要なのは増加幅ではありません。重要なのは手順です。タグ付け、保持、分離、診断、修正、再測定。この最初の 3 ステップなしでは、後半 3 ステップは推測に過ぎません。出版社にも同じ考え方が適用できます。OpenAI は、一部フローでは ChatGPT が referral URL に utm_source=chatgpt.com を含める場合があり、OAI-SearchBot のクロールを許可しているサイトは analytics 上で ChatGPT リファラーを追跡できると説明しています。この値 chatgpt.comは、自社の chatgpt トークンとは異なるため、レポート側で正規化してください。調整可能なレポート テンプレートについては、こちらの AI エージェント可視性の測定.
analytics とアトリビューション ツール間の UTM 競合をどうトラブルシュートしますか?
数値がおかしい場合は、クリックから外側へ向かって確認してください。問題の多くは、いくつかのパターンに分類できます。
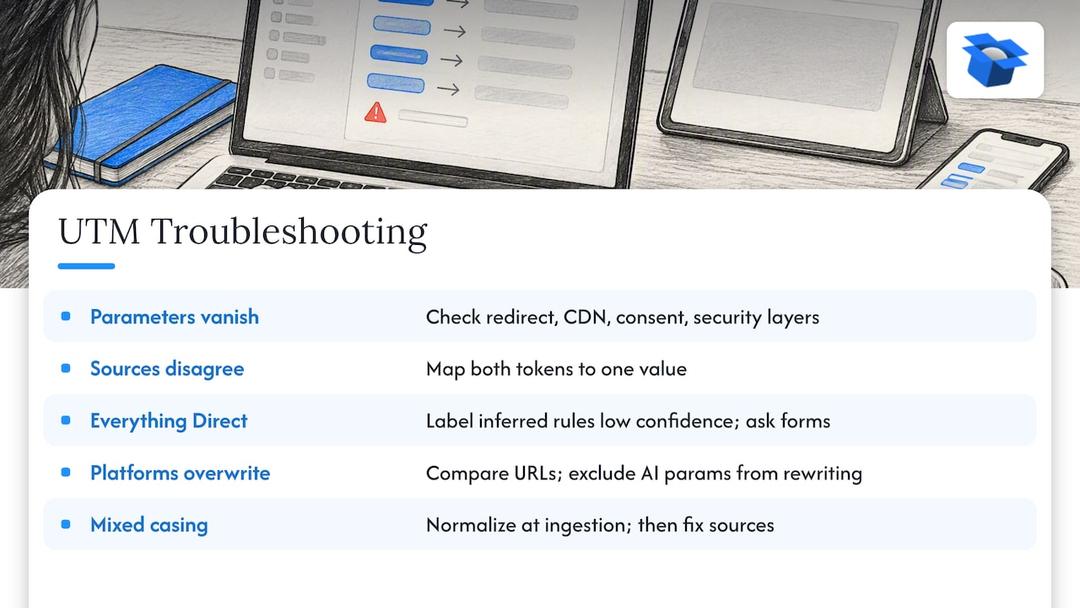
パラメータが消える。 エージェントからクリックし、各遷移で URL を確認してください。クエリ文字列が消える箇所が原因です。リダイレクト ルール、CDN 設定、同意レイヤー、またはセキュリティ レイヤーが考えられます。
2 つの source が食い違う。 GA4 は UTM が存在する場合、それを最優先で扱うため、プラットフォーム側が付与した source が意図した値を上書きすることがあります。chatgpt.com のようなエージェント追加パラメータが、自社トークンと衝突していないか確認し、両方を 1 つのレポート値へ統合してください。
すべて Direct になる。 通常は、リファラーが削除され、UTM も存在しないことが原因です。特にモバイル アプリ内 webview でよく発生します。推定ルールを使用し、低信頼としてラベル付けし、フォームに自己申告 source 質問を追加してください。
アトリビューション プラットフォームがタグを上書きする。 一部ツールはランディング URL を書き換えたり再タグ付けしたりします。ユーザーがクリックした URL と、プラットフォームが記録した URL を比較し、AI パラメータをすべての書き換えルールから除外してください。
大文字小文字の混在で行が分裂する。 すべての source を一度に修正できない場合は、取り込み時に正規化し、その後 source 側を修正してください。
GA4 側の確認方法や追加の検出例については、GA4 での LLM トラフィック追跡に関するこのパートナー記事も参考になります。変更したすべてのリダイレクト、プラグイン、エッジルールについて変更ログを残してください。アトリビューションの不可解な問題の多くは、記録されていない変更に起因します。
今四半期、エージェント アトリビューション対応をどう優先すべきですか?
私見では、多くのチームは計画し過ぎて、実装が不足しています。まずは最もトラフィックの多い商品ページとカテゴリページ、そして単一の ai_search medium から始めてください。medium の分類体系を作り込まないでください。維持できなくなります。
完全に管理できる出力からタグ付けを自動化し、その後プラグインや配信フィードへ広げてください。まず未タグ トラフィックの完璧な検出を目指す必要はありません。タグ付きリンクの方が、より早くクリーンなデータを得られます。
最後に、短期間の A/B コホートを実施し、大規模展開前に AI アトリビューション付きコンバージョンの改善を測定してください。大きくても疑わしい結果より、小さくても信頼できる結果の方が価値があります。
— Xhurian
ecentic でタグ設定と AI での引用を確認してみませんか?
タグが正しく機能している証拠を確認したい場合は、お見せできます。 ecentic では、ChatGPT、Gemini、Claude などのエージェントを模倣したシミュレーション駆動スキャンを実行し、自社の商品ページがどこで引用され、どこで競合商品に負けているかを可視化します。

UCP Playground とエージェント アトリビューション分析により、UTM 検証と AI アトリビューション付きコンバージョンの可視化を 1 か所で行えます。平易な診断結果、商品情報の書き換え提案、Shopify と WooCommerce へのワンクリック公開機能を利用できます。プランは無料の導入スキャンから始まり、有料 プランは料金ページで確認できます。今すぐ無料スキャンを実行するか、Playground を開いてタグ設定をテストしてください。
FAQ
AI トラフィックにはどの utm_medium を使うべきですか?
管理しているすべてのリンクで ai_search を単一の固定値として使用してください。chatgpt や perplexity のようなプラットフォーム識別は utm_source に入れます。これにより、チャネル グループ用のクリーンな結合キーを 1 つ維持できます。
ChatGPT は UTM パラメータを自動追加しますか?
一部フローでは追加されます。OpenAI は publisher FAQ の中で、ChatGPT が referral URL に utm_source=chatgpt.com を含める場合があると説明しています。それでも、管理できるリンクには自分でタグを付け、自動値はレポート内で自社トークンへマッピングしてください。
UTM がない場合、AI トラフィックをどう追跡しますか?
まずリファラー ホスト許可リストを使い、次に user-agent とサーバーログ シグナル、その後に推定ルールを使います。それぞれに信頼度レベルを付け、レポート側で重み付けできるようにしてください。Ahrefs の講座では、フォーム内の自己申告アトリビューションも推奨しています。
AI トラフィックが Direct と表示されるのはなぜですか?
一部の AI 接点やアプリ内 webview ではリファラーが削除され、UTM がない場合は source を識別できません。管理できるリンクにはタグを付け、残りには推定ルールを追加してください。