

エージェント主導型トラフィック分析とは、非人間アクターによるリクエストを取得・分類・アトリビューションし、そのうえで、人間の依頼主体に代わってそれらのエージェントが完了するタスクを測定する実務です。これは測定単位としてのセッションを、よりシンプルなモデル――actor、task、outcome――に置き換えます。
ダッシュボードに「bot traffic」が横ばいで表示される一方、AIエージェントによる訪問が増えているのに、そこにコンバージョンデータがまったく紐づいていないなら、実際にサイトで起きていることを測定できていません。ChatGPT、Gemini、Perplexityのショッピングエージェントは商品ページを読み、仕様を比較し、自分ではファーストビュー以降をほとんど見ない購入者に推奨を渡しています。おそらく、現在の分析スタックはこの動きを把握できていません。
最大の盲点をすばやく埋めるには、次の3つが有効です。
- CDNまたはエッジのログ転送を有効にし、ブラウザが読み込まれずJavaScriptタグも発火しないリクエストを取得します。
- 取り込み時点で
actorプロパティを追加し、データがダッシュボードに到達する前に human、agent、crawler のいずれかとしてタグ付けします。 - これらのログはクライアントサイドのツールではなくデータウェアハウスに送信し、エージェントイベントを時間の経過に沿って成果と結合できるようにします。
エージェントによる読み取りは、購入よりかなり前に発生し、到着した時点ですでに意思決定を終えている購入者に事前知識を与えていることがよくあります。現在の従来型分析設定では、その売上は「ダイレクト」に帰属されるか、まったく把握されていません。
重要ポイント
エージェント主導型トラフィック分析を機能させるには、サーバーサイドでの取得とID連携ログを基盤として、チームがセッション指標を actor・task・outcome モデルに置き換える必要があります。
| ポイント | 詳細 |
|---|---|
| まずエッジで取得する | CDNとエッジのログ転送により、クライアントサイドJavaScriptを完全にスキップするエージェントリクエストの大半を取得できます。 |
| エージェントにはセッション指標を使わない | 直帰率やスクロール深度は非人間アクターには無意味です。代わりに actor、task、outcome を使います。 |
| ページビューではなくタスク完了を報告する | 完了指標を報告する前に、取得、フォームフロー、連携の成功条件を定義します。 |
| 意図的にアトリビューションギャップを埋める | カナリアプロトコルと改ざん不可能でID連携されたログにより、未承認のエージェント行動から生じる法務・監査上のリスクを低減できます。 |
| エージェントが実際に読む内容を最適化する | ecenticは商品ページ上でのAIショッピングエージェントの評価をシミュレーションし、推奨を後押ししている要因、または妨げている要因を具体的にレポートします。 |
エージェント主導トラフィックとは何か、そしてなぜセッション指標では通用しないのか
現在、サーバーにアクセスしている主体は3種類あり、その挙動はまったく異なります。 人間 は、間を取り、スクロールし、マウスを動かしながら対話的に閲覧します。 クローラー は、通常は特定のタスクへの関心なしに、コーパスのためにコンテンツをインデックス化します。 エージェント は人に代わって動作し、ページを取得し、データを抽出し、多くの場合、ページを視覚的にレンダリングすることなく、比較や購入手続きの一部といったタスクを完了します。
標準的なWeb指標は、相手が人間であることを前提にしています。この前提は、エージェントが相手になるとすぐに崩れます。
- 直帰率 は、エージェントが1ページだけ取得し、価格と仕様表を抽出して離脱する場合には意味を持ちません。それは離脱した訪問ではなく、完了したタスクです。
- ページ滞在時間 は、レンダリングも閲覧もスクロールもなくミリ秒で完了するリクエストには当てはまりません。
- スクロール深度 にはビューポートが必要です。生のHTTPコールを行うヘッドレスエージェントでは、そもそも生成されません。
必要なのは、考え方をまったく変えることです: 主体、タスク、結果。誰がリクエストを行ったのかを分類し、何をしようとしていたのかを定義し、成功したかどうかを記録します。この枠組みは、主体が買い物客でも、クローラーでも、購入者に1つを推奨する前に5つの競合商品を比較する自律型エージェントでも機能します。
エージェントの検出と捕捉は実際にどう機能するのか
エージェントの活動の大半は、マーケティングチームがすでに信頼しているツールからは見えません。ここが厄介な点です。Google Analytics、Adobe Analyticsのタグ、そして多くのタグマネージャー構成は、ブラウザ内でのJavaScript実行に依存しています。エージェントトラフィックは、そのステップ自体を完全に飛ばすケースが増えています。
このトラフィックを実際に捉えられるのは、サーバーサイドおよびエッジでの計測です。ベンダーのテレメトリーによれば、ChatGPTエージェントトラフィックの約59%は、スクリプトを一切実行しない生のHTTPクライアント経由で到達しており、つまりクライアントサイドの分析ツールは、偶然ではなく設計上の理由でアクティビティの半分以上を見逃しています。計測手段がタグマネージャー内にしかなければ、実際に起きていることのうち、縮小しつつある一部分しか測定できていません。
CDN とエッジのログは、ブラウザが一ピクセルでも描画したかどうかに関係なく、インフラに届いたすべてのリクエストを記録するため、この問題を解決できます。エージェントによるアクセスの分析は、実際にはこの層から始まります。
生ログを見れば、エージェントを人間や一般的なボットと確実に区別できるシグナルがいくつかあります。
- 申告されたユーザーエージェント文字列。 少なくとも現時点では、多くのエージェントが、リクエストの背後にあるモデルやプラットフォームを示す文字列で、自らを正直に識別しています。
- アセット対リクエスト比率。 人間がページを読み込む場合は、画像、フォント、スクリプトなどを数十件取得します。構造化データを抽出するエージェントは、HTMLかJSONペイロードだけを要求することがよくあります。
- ビーコン不在。 サーバーレベルでは明らかにページビューが発生しているのに、分析用ピクセルが発火していないこと自体がシグナルになります。
- ヘッダーとタイミングのパターン。 エージェントは一般に、通常のブラウザ挙動とは異なるヘッダー順序やタイミングのエントロピーを伴い、機械的な速度でページをリクエストする傾向があります。
- llms.txt と構造化アセット。 現在では、OpenAPI スキーマと並行して llms.txt ファイルを公開するサイトが増えており、エージェント(およびログ)に対して、リクエスト照合用の文書化された宣言済みインターフェースを提供しています。
宣言済みモデルの IP レンジを検証したり、リクエスト文字列を公開済みベンダードキュメントと照合したりすることで、追加の信頼性レイヤーを得られます。ただし、それ単独で完全に保証できるものではありません。
プロのヒント: user-agent 文字列だけに依存しないでください。アセット比率スコアリングと組み合わせることで、リクエストパターンが実際のブラウザセッションと一致しない場合、偽装された文字列でもフラグを立てられます。
エージェントの影響を実際に示す主要指標
ページビューやセッションでエージェントトラフィックをレポートすると、関係者には見栄えの良い、あるいは不安を煽る数字が示されますが、その理由は的外れです。本当に重要なのは、訪問数ではなく、リクエスト、タスク、ビジネス成果を追跡する指標です。
| 指標 | わかること |
|---|---|
| リクエストに占めるエージェント比率 | ページ別・モデル別の総リクエスト比率。エージェントが実際に読んでいるページを把握できます |
| タスク完了率 | エージェントによるデータ取得、フォームフロー、統合呼び出しが正常に完了したかどうか |
| エージェントから人間への引き継ぎ率 | エージェントのセッションが、その後の人間による訪問や購入につながる頻度 |
| アクター別ブロック/エラー率 | 人間と比較して、エージェントがレート制限、ブロック、エラー応答を受ける頻度 |
| モデル単位の運用コスト | インフラにアクセスする各モデルのトークン使用量、レイテンシ、エラー率 |
タスク完了を測定するには、まず現実的な定義が必要です。 取得タスク は、価格や在庫状況など、エージェントが必要なデータを取得できたときに成功とみなされます。 フォームフロータスク は、カート追加のような複数ステップの処理がエラーなしで完了したときに成功とみなされます。 統合タスク は、API 型の呼び出しが有効で利用可能なレスポンスを返したときに成功です。これらを事前に定義しなければ、指標は意味のないノイズになります。
エージェント支援コンバージョンは、すべてのレポートで独立した項目として扱うべきです。適切に追跡しているガイドでは、エージェント経由トラフィックは、区別せず「その他」にまとめるのではなく、正しく分離・測定することで、一般的なオーガニックトラフィックを大きく上回るコンバージョン率になる可能性が示されています。CFO が注目するのは、生のリクエスト数ではなく、その数字です。
- エージェント比率は、単なる集計済みの「bot」カテゴリではなく、個別モデルごとに分類してください。
- タスク完了率と引き継ぎ率はセットでレポートしてください。どちらか一方だけでは、エージェントトラフィックが実際に役立っているか判断できません。
- ブロック率とエラー率は、人間側のエラー率と分けて追跡してください。ここでの急増は、悪意あるトラフィックではなく、ファイアウォールルールの設定ミスを示すことがよくあります。
パイプライン構築: スキーマ、タグ付け、ストレージ
エージェント主導トラフィック分析の実装は、分析の問題というより、まずデータ基盤の問題です。実運用で有効な順序は次のとおりです。
- まず CDN ログ転送を有効にします。 タイムスタンプ、完全な user-agent 文字列、リクエストパス、レスポンスコード、バイトサイズ、および CDN が提供する TLS フィンガープリントデータを含むフィールドを取得してください。
- 取り込み時に
actorとactor_nameプロパティを追加します。 すべてのイベントは、テーブルに格納される前に、人間・エージェント・クローラーとしてタグ付けされ、識別可能な場合は特定名(モデル名やプラットフォーム文字列)も付与されます。 - 分類ロジックを多層化します。 まず宣言済み user-agent を基準にし、アセット比率やタイミングなどの行動シグナルでクロスチェックし、認証トークンや API キーが存在する場合はそれで確認します。単一シグナルだけで判定すべきではありません。
- 可能な限り、エージェントイベントを人間の主体と結び付けます。 認証トークン、セッション Cookie、相関 ID を使えば、エージェントの取得タスクを、そのエージェントを導入した人物に関連付けられます。これにより、「エージェントが訪問した」と「この顧客のエージェントが訪問した」の間のギャップを埋められます。
- すべてをデータウェアハウスに送ります。ダッシュボードツールだけでは不十分です。 BigQuery の agent analytics pipeline は、Storage Write API を使用して生のインタラクションイベントをストリーミングし、後からトレースを再構築できます。これは、3 週間後にエージェントが実際に何をしたかを再現する必要がある場合に重要です。
- ストレージを階層化します。 生の詳細ログは定義済みの監査期間だけ保持し、その後は古いデータをサンプリングまたは集約してください。完全な精度のまま永久保持するとコスト問題につながりますし、ほとんどの監査では最近の期間だけあれば十分です。
プロのヒント: 監査用保持期間は、任意の 30 日や 90 日ではなく、現実的に最長となる異議申し立てやコンプライアンスサイクルに基づいて設定してください。チャージバックや規制上の問い合わせが 6 か月後に発生する可能性があるなら、トレースもその期間保持する必要があります。
アトリビューションギャップを埋める
エージェントがサイトを訪問したことを知るのは簡単です。しかし、そのエージェントをどの人間や組織が導入したのかを証明するのは、はるかに難しい問題であり、コンプライアンスチームを悩ませているのはそこです。
アトリビューションギャップが存在するのは、多くの企業が「エージェントが行動した」ことは記録できても、その行動をどの人間が承認したかを証明できないためです。企業が後に否認または弁護しなければならない行動をエージェントが起こした瞬間、このギャップは現実的な法務・規制リスクになります。
これは Okta の AI コンプライアンスリスク分析の中核的な指摘であり、セキュリティチームだけでなく、監査目的でエージェント主導トラフィック分析を構築するあらゆるチームに当てはまります。
実用的な対策として注目されているのが canary protocol です。これは、エージェントのインタラクションに、発信元アカウントまで追跡可能なマーカーを持たせるベンダー仲介型のアプローチです。 web、communication、cyber agents を対象にこのアプローチを評価した研究では、非対立的な環境では観測された行動を発信元アカウントへ確実に関連付けられることが示されました。ただし、アクターが積極的に検知回避を試みる場合にはギャップが生じるのが現実的です。
運用上のいくつかの習慣で、残るギャップの大半は埋められます:
- エージェントログは、早期に上書きや圧縮を行うものではなく、不変の記録として扱ってください。
- トークン、Cookie、API キーで可能な場合は、すべてのエージェントイベントを ID に関連付けてください。
- インシデントが発生してからではなく、事前にセキュリティ、法務、プラットフォームベンダー間の常設連携体制を構築してください。
実用的なツールとダッシュボード設計
これをすべてゼロから構築する必要はありません。すでにパイプラインの大半をカバーできる具体的なツールがあります。
- BigQuery Agent Analytics は、キャプチャから分析までのパイプラインを処理します。生イベントのストリーミング、トレース再構築、エージェント行動に対する大規模なプログラム評価を実行でき、1 日数千件を超えるエージェントリクエストを扱う段階では重要になります。
- Adobe の Agentic Traffic ダッシュボード は、CDN ログ転送を設定済みであれば、 トラフィック分布、トレンドライン、増減上位・下位を確認するフィルター を市場、カテゴリ、個別エージェント単位で提供する構築済みビューです。
- GA4 のようなタグベースツール は、人間の行動測定には依然として有効ですが、多くのエージェント活動がクライアント側タグを発火しないため、一貫してエージェント活動を過少計測します。有効なパターンは、 GA4 をサーバーサイド計測と併用すること であり、完全に置き換えるのではありません。これにより、人間行動のレポートを維持しながら、その上にエージェントレイヤーを追加できます。
- ベンダーダッシュボードはトレンド監視には実際に役立ちますが、監査や根本原因調査で再現可能な評価が必要な場合、データウェアハウス主導のトレースモデルの代わりにはなりません。
エージェントトラフィックがパフォーマンスとリソース計画に与える変化
エージェントリクエストは、人間のトラフィックとは異なる形でインフラに負荷をかけます。そして、その容量面の影響について、多くのチームはまだ計画できていません。
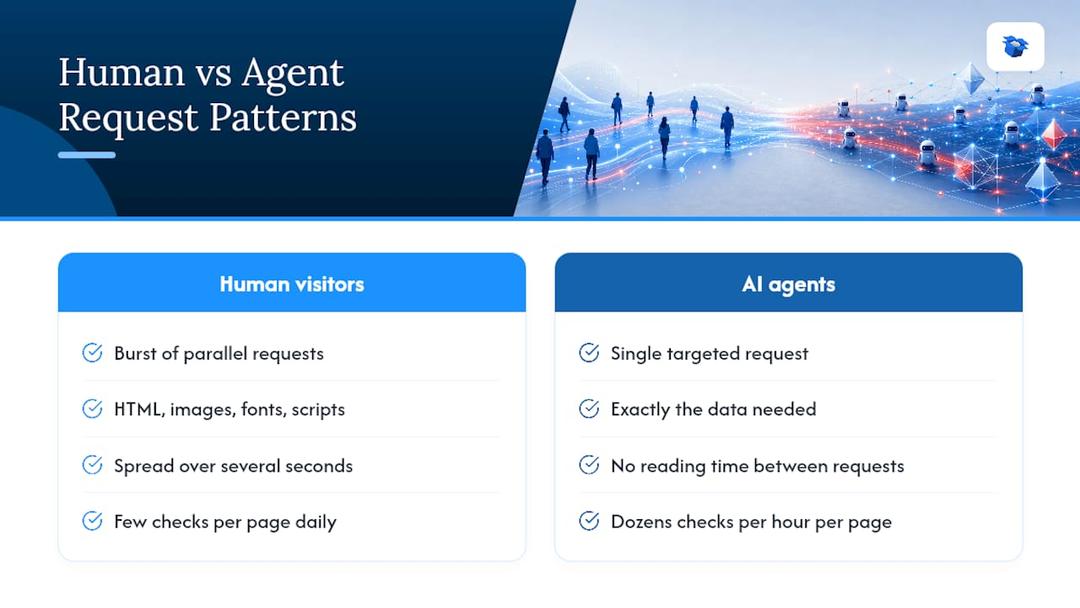
人間の訪問者は、HTML、画像、フォント、スクリプト、分析ビーコンといった並列リクエストを数秒にわたって発生させます。一方、構造化データを取得するエージェントは、必要なものだけを単一かつ効率的にリクエストして次へ進むことが多くあります。紙面上では軽量に見えますが、大規模になるとそうではありません。エージェントは、価格ページや商品詳細ページのような価値の高い同一ページ群に対して、人間には不可能な頻度と量でアクセスできます。リクエスト間に「読む時間」が存在しないためです。
このパターンは、サイト全体に均等に広がるのではなく、特定エンドポイントへの予期しない負荷として現れます。人間の閲覧パターン向けに調整されたレート制限やキャッシュ設定は、エージェントに対して誤作動する可能性があります。本来は販売につながる正当なエージェントトラフィックをブロックしたり、低トラフィックだと思われていたエンドポイントを挙動の悪いエージェントに集中的に叩かせたりすることがあります。
実践的な対応策は、エージェント負荷を独立した容量計画カテゴリとして扱うことです。総トラフィックだけでなくアクター種別ごとのリクエスト率を監視し、エージェント行動パターンを前提にキャッシュとレート制限ルールを設定してください。ショッピングエージェントに 1 時間で何十回も確認される商品ページには、1 日に数回だけ人間が閲覧するページとは異なるキャッシュ戦略が必要です。統合ダッシュボード上の総リクエスト数が似ていても同じではありません。
エージェントトラフィック監視における法的・倫理的境界線
エージェント活動のログ取得には、まだ完全な答えが定まっていない問題があります。それを無視するのは誤りです。
ヘッダー、タイミング、行動フィンガープリントを含む詳細なリクエストデータを取得するということは、場合によっては個人に結び付け可能なデータも取得することを意味します。特に、エージェントが特定顧客アカウントの代理で動作している場合はそうです。そのため、エージェントトラフィックログは、地域のプライバシー法であれ社内データガバナンスポリシーであれ、組織内の他のデータ収集と同じプライバシーフレームワークの対象になります。
倫理的な問題は法的問題と並行して存在します。エージェントを一律にブロックすればサーバーリソースは保護できますが、ブラウザタブではなく AI ショッピングエージェント経由で比較検討する購入者という、成長中のチャネルを遮断することにもなります。一方で、アクセスを許可しすぎると、正当なエージェントトラフィックを装ったスクレイピング悪用を招きます。
現実的な中間策は、エージェントアクセスを他の自動化統合と同様に扱うことです。つまり、文書化し、レート制限し、監視し、許可範囲を明確に定めます。llms.txt ファイルの公開もその一部であり、適切に動作するエージェントに対して、サイト構造を推測させる代わりに文書化されたインターフェースを提供できます。
保持ポリシーは収集ポリシーと同じくらい重要です。詳細なエージェントログは、監査や異議申し立てに実際に必要な期間だけ保持し、行動情報や ID 関連情報を含む他のデータセットと同じアクセス制御を適用してください。
エージェント分析をセキュリティと不正検知に統合する
エージェントトラフィック分析と不正検知は重複する問題を解決しており、別システムとして扱うと双方に死角が生まれます。
悪意あるスクレイパーと正当なショッピングエージェントは、ネットワーク層ではほぼ同じに見えることがあります。自動化リクエスト、JavaScript 非実行、宣言済みまたは偽装された user-agent 文字列などです。宣言 ID、行動シグナル、認証を組み合わせて正当なエージェントを識別する多層分類アプローチは、そのまま悪用検知にも有効です。これを別々ではなく一体のシステムとして構築すれば、不正対策チームが分析チームですでに構築済みのシグナル検知を再発明せずに済みます。
実践的な統合は、共有されたアクター分類体系から始まります。分析パイプラインがリクエストをエージェント、クローラー、人間としてタグ付けしているなら、セキュリティツールも別定義のボット検知レイヤーを動かすのではなく、その同じタグを読み取り利用すべきです。チーム間で分類体系が分断されると、分析側が存在すら知らないセキュリティルールによって正当な AI ショッピングエージェントがブロックされます。
共有アラートも重要です。購入手続きエンドポイントへのエージェントリクエスト急増は、有名ショッピングエージェントによる価格変動確認かもしれませんし、エージェントトラフィックを装った認証情報詰め込み攻撃かもしれません。エージェント関連異常を、セキュリティチームが監視していない分析専用アラートではなく、不正対策で既に使われている同じインシデントワークフローに流すことが、重要なタイミングで違いを見分ける鍵になります。
業界別に変わるエージェント分析の優先事項
エージェント主導トラフィック分析で重視すべき点は業界ごとに異なります。すべてを同一設計で扱うと、重要ではないシグナルにエンジニアリング工数を浪費します。
EC・小売サイトでは、商品ページや価格ページでのタスク完了率と、エージェントから人間への引き継ぎ率が最重要です。これらは、エージェント活動を売上に直接結び付ける指標だからです。小売業者の最大の死角は、比較エージェントに価格ページが大量アクセスされているのに、対応するコンバージョン計測が存在しないケースです。
メディア・出版サイトでは、クローラーとエージェントの区別がより重要になります。ビジネス上の焦点がコンバージョンではなく、ライセンスやコンテンツ再利用にあるためです。コーパス構築用クローラーと、ユーザーの特定質問に対して単一記事を取得するエージェントを区別することで、そのトラフィックの価値評価や管理方法が変わります。
B2B ソフトウェアや SaaS プラットフォームでは、統合タスクカテゴリが優先される傾向があります。これらのサイトとやり取りするエージェントは、単一の人間の購入者ではなく、別システムの代理として API 型呼び出しを行うことが多いためです。ここでは引き継ぎ率よりも、アクター別エラー率やブロック率のほうが重要です。リクエストの先にいる「人間」が何段階も離れている可能性があるからです。
金融サービスサイトは、前述のアトリビューションとガバナンス問題に最も近い領域です。未承認エージェント行動に関する規制リスクが最も高いためです。canary ベースのアトリビューション手法や不変ログは、ほぼどの業界よりも重要になります。
分析チームが実際に変えるべきこと
既存の人間向けレポートは、そのまま維持してください。マーケティング責任者が信頼しているダッシュボードを、エージェントデータを無理に押し込むためだけに作り直す必要はありません。代わりに並行ビューを構築してください。測定対象の構造が異なる以上、見た目が異なって当然です。
より大きな組織的変化は、エージェントテレメトリを日常的にどこで扱うかです。四半期ごとの分析資料に埋もれさせるのではなく、インシデント対応や調達の議論に組み込むべきです。また、エージェントの可読性向上のためにエンジニアリング工数を投じるなら、まず価格ページと商品ページに集中してください。エージェントが購入者の代理として実際に意思決定するのはそこだからです。そして、その改善効果も最も早く現れます。
— Xhurian
エージェント可視化を最適化された商品情報へ変える
エージェントトラフィックを測定すれば、エージェントが商品ページを読んでいることはわかります。しかし、なぜ自社商品ではなく競合商品をエージェントが推薦したのかまではわかりません。そして、そのギャップを埋めるのが ecentic です。

ecentic は、 Shopify または WooCommerce ストアに直接接続し、ChatGPT、Gemini、Claude、Perplexity が競合商品と比較して商品情報を実際にどのように評価するかをシミュレーションします。そして、推薦されない原因を、平易な言葉による診断として返します。ecentic の最適化ツールを利用した顧客からは、提案された 商品情報の書き換えを実装後、AI 主導の訪問数と売上の両方で有意な増加が報告されています。単にエージェントリクエスト数を数えるだけではなく、エージェント可読性について検証済みの UCP プロファイルと、モデル変化に応じた選択率を継続追跡する再スキャンサイクルを利用できます。
すでに CDN ログ転送とアクタータグ付けを行っているなら、次に必要なのは、その可視性をどう活用するかです。 無料の導入スキャン をストアで実行し、すでに商品情報を読んでいるエージェントに対して、どの位置にあるのかを正確に確認してください。
FAQ
エージェント主導トラフィック分析とは?
人間の代理として動作する AI エージェントによるリクエストを取得・分類・関連付けし、セッションベース指標ではなく、完了したタスクを測定する手法です。
なぜセッション指標はエージェントトラフィックに適さないのですか?
直帰率やページ滞在時間などの指標は、人間がページを表示して読んでいる前提ですが、エージェントは単一の効率的なリクエストだけで離脱することが多いため、これらの数値は意味を持ちません。
Web サイト上の AI エージェントトラフィックはどのように検知しますか?
サーバーサイドおよび CDN ログ取得を、user-agent 分析、アセット対リクエスト比率、llms.txt 検証と組み合わせることで、クライアント側ツールでは見逃されるエージェント活動を高精度で検出できます。
エージェント分析におけるアトリビューションギャップとは?
特定エージェントの行動を、どの人間または組織が承認したのかを証明する難しさを指します。これにより法務・コンプライアンスリスクが生じますが、canary ベースのプロトコルや不変ログによって軽減できます。
ecentic はエージェントトラフィック最適化に役立ちますか?
はい。ecentic は、Shopify および WooCommerce ストアの商品情報を AI ショッピングエージェントがどのように評価するかをシミュレーションし、エージェント主導の可視性とコンバージョンを改善するための具体的な提案を提供します。