

Geminiでランクするには、2つの要素を連動させる必要があります。曖昧さのないブランドエンティティと、Geminiが回答にそのまま引用できる文章です。ここでのランキングは掲載順位の数字ではなく、引用です。最も効果の大きい一手は、Geminiが信頼できるほど商品やブランドのアイデンティティを明確にし、そのうえで編集なしに引用できる自己完結型の回答を書くことです。これを毎週、少数の対象プロンプトでテストし、自社ドメインが引用に現れるかを追跡してください。
要点:
- Geminiに引用されるには、Webサイトがインデックスされており、トピックとの関連性が高く、従来の検索結果で競合より上位である必要があります。
- コンテンツは抽出しやすいように構成する必要があり、自己完結した文章と、ユーザープロンプトに沿った疑問形の見出しが必要です。
- schemaマークアップや
sameAsリンクを含む、Web全体で一貫性があり検証可能なエンティティシグナルは、Geminiがブランドを信頼し認識するうえで不可欠です。- 信頼できる第三者サイトでの編集掲載を獲得し、コンテンツの鮮度を維持することで、引用される可能性は大きく高まります。
- 対象プロンプトを使って定期的に引用を監視し、サーバーサイドレンダリングや正確な
dateModified、schema実装といった技術SEOの基本が最適化されていることを確認してください。
Geminiで引用されるとはどういうことか?
Geminiでのランキングは、1位、2位、3位といった順位とは無関係です。Geminiは、ほとんどの会話型クエリで青いリンクのランキング一覧を返しません。返すのは回答であり、その回答が自社ページを引用するか、しないかです。目指すべき「5位」はありません。回答の一部になるか、見えない存在になるかのどちらかです。
SEOチームが最初に切り替えるべき考え方はここです。従来のGoogle検索では、競合をわずかに上回ることに価値がありました。Geminiでは、まず情報源として選ばれるだけの明確さと有用性が求められます。その結果を決めるフィルターは2つあり、両方を通過しなければなりません。
リトリーバルフィルター は、従来の検索とよく似た仕組みです。Gemini は、特に Google の AI Overviews と AI Mode で回答する際、多くの場合、応答を生成する前に最新の検索結果を取り込み、それを根拠にします。この仕組みを説明している業界分析はこちらです: Astral3。ページがインデックスされていない、トピック上の関連性がない、あるいはそのクエリクラスタで従来の検索において完全に負けている場合、第二段階には進めません。ここでは、インデックス状況、サイトの権威性、トピックの深さが依然として重要です。この部分は、人々が思うほど大きくは変わっていません。
抽出フィルター は、そこで本当に違いが生まれます。Geminiは候補ページ群を得ると、それらを順位付けするのではなく、抜き出して使えるパッセージを探します。「答えはXで、その理由はYです」と2つの明快な文で書かれたパッセージは、同じ情報が注意書きや内部参照だらけの400語の段落に埋もれているページより有利です。arXivで公開された大規模言語モデルのリトリーバルとグラウンディングに関する研究でも、こうしたシステムが回答を構成する中核には、パッセージ単位のリトリーバルがあることが示されています。出典は arXivで公開された研究です。モデルは文脈理解のためにページ全体を読んでいるわけではありません。最小限の編集で引用できるまとまりを探しているのです。
両方のフィルターの下には、さらに目立ちにくい第三の関門があります。エンティティの重要度です。Gemini は Google の Knowledge Graph を参照し、「自社ブランド」と「このドメインで言及されている企業」が、同じ検証済みのエンティティかを判断します。エンティティを示す情報が弱い、ウェブ上で企業名が統一されていない、構造化データがない、矛盾する sameAs 参照があると、コンテンツ自体が技術的に優れていても、引用候補から外されることがあります。
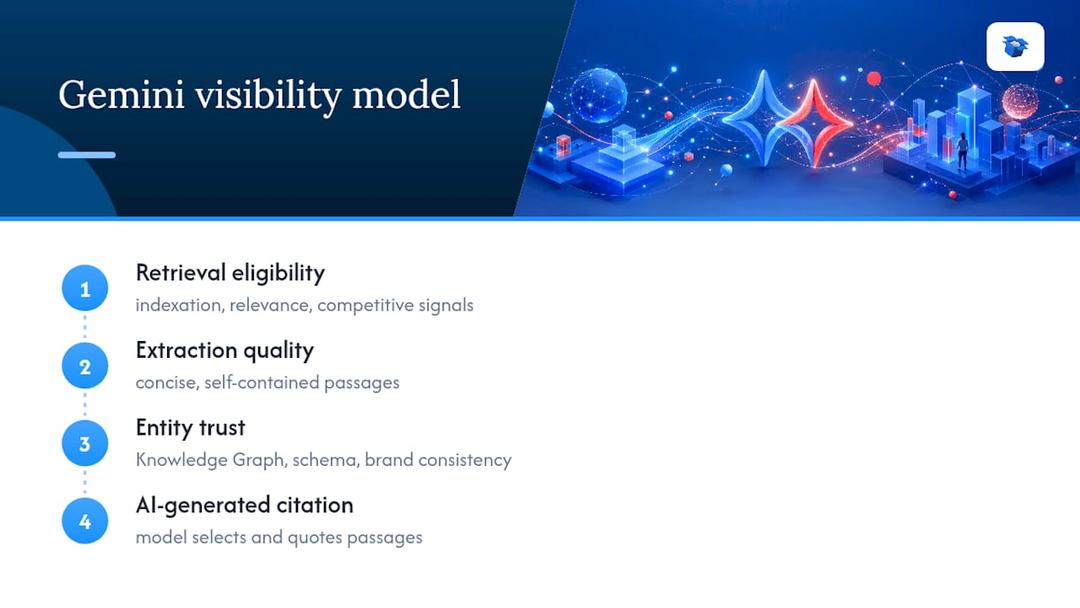
この3つを合わせると、Geminiで引用されることの実際の定義は次のようになります。
- ページが取得可能であること(インデックスされている、トピック上で関連性がある、従来の検索でも競争力がある)。
- コンテンツが抽出可能であること(モデルがそのまま明確に引用できる、自己完結した一節になっていること)。
- エンティティが認識可能であること(一貫性があり、検証されており、Knowledge Graphのノードに結び付いていること)。
この3つのうち1つでも欠ければ、残り2つでは補えません。引用しやすい完璧な段落があっても、ドメインが未インデックスなら何も得られません。十分にインデックスされているページでも、Web全体でブランドの識別シグナルが曖昧で一貫していなければ、Geminiがより信頼する競合に譲ることになります。だからこそ、「とにかく良いコンテンツを書けばいい」という助言はここでは機能しません。抽出テストを通らない良質なコンテンツや、Geminiが確信を持って識別できないエンティティから出たコンテンツは、単純に引用されないのです。
Geminiに引用される確率を高める基本戦略
検索取得、抽出、エンティティへの信頼の3つが関門だと理解すれば、戦略上の優先順位は明確になります。この順番で進めてください。各レイヤーが、その次のレイヤーの効果を高めるからです。
- まずエンティティシグナルを整えてください。 ブランド名、カテゴリ、説明文は、ホームページ、Google Business Profile、SNSのプロフィール、プレスでの言及まで、あらゆる場所で1つに統一してください。サイトにはOrganizationスキーマを追加し、
sameAsには、検証済みのLinkedIn、Wikipedia(該当する場合)、Crunchbase、SNSプロフィールへのリンクを設定してください。この構造化データは、SEOAliveのガイダンスによれば、Geminiがブランドを特定のKnowledge Graphノードと照合するのに役立ちます SEOAlive。スキーマは、魔法のように引用を発生させる仕組みではなく、明確化のためのツールとして扱ってください。これだけで引用を強制することはできませんが、そうでなければ失格になり得る曖昧さを取り除けます。 - Geminiがすでに引用しているカテゴリ内のドメインに掲載を獲得しましょう。 Geminiの引用に占める自社ドメインの割合はごくわずかです。Omniaの調査によると、引用の大半を動かしているのは、第三者による編集記事、比較記事、専門家のまとめ記事です Omnia。ランニングシューズを販売しているなら、「扁平足に最適なランニングシューズ」と質問した際にGeminiがすでに引用している5つのサイトを見つけ、その正確なドメインでゲスト寄稿、専門家コメント、比較記事への掲載を獲得してください。これは、ほぼあらゆるオンページ調整よりも重要です。
- 自社ページを抽出しやすい構成にしましょう。 対象ページでは、回りくどい前置きの前に、核心となる回答を2文以内で冒頭に提示してください。H2やH3見出しは、社内用語ではなく、実際にユーザーがGeminiに入力するプロンプトに近い質問形式にします。
- 孤立したページではなく、トピッククラスターを構築しましょう。 リソースが許す範囲で、あるテーマをあらゆる角度から扱い、相互にリンクした 30 ページ以上の構成を目指してください。テーマに関する深さと広がりは、その分野での権威性を検索フィルターに伝えます。また、モデルの更新後、Gemini は単純な被リンク数よりも、構造化された意味内容の深さを重視する方向に進んでいます。この変化について述べているのは、次の分析です: InstaRank.
- 更新サイクルを決めて継続しましょう。 主要なエバーグリーンページは最低でも四半期ごとに更新してください。変化の速い競合と争うクエリでは、統計、日付、事例を毎月更新することで、
dateModifiedタイムスタンプを飾りではなく意味のあるものに保てます。
ゲスト投稿や専門家コメントは、多くのチームが現在与えている以上に、ロードマップ内で重視する価値があります。Omniaの追跡データによると、Geminiが積極的に引用しているドメインでの編集掲載は、公開後2〜3週間以内に測定可能な引用変動を生む傾向があります。これは、推測ではなく実際の実験を回せるほど十分に速いフィードバックループです。
引用頻度という観点では、レビュー記事や比較記事はFAQや商品ページよりも高い成果を出します。同じOmniaの分析によれば、Geminiは単に仕様を列挙するページよりも、選択肢を比較しトレードオフを説明するコンテンツを好む傾向があります。商品ページや薄いFAQばかりのコンテンツ計画では、最適化するフォーマットを間違えています。
プロのヒント: 新しいページを書く前に、まず優先キーワードで従来のGoogle検索1ページ目にすでにランクインしている既存ページを洗い出してください。それらのページはすでにリトリーバルフィルターを通過しているため、冒頭段落を抽出しやすい形に書き換えるほうが、ゼロから始めるよりも速く進みます。
とはいえ、基本を置き換えるものではありません。 生成エンジン最適化 のアプローチでも、土台となる堅牢なトピック構造は必要です。ただし順序が重要です。エンティティの明確化が入口を開き、編集掲載が引用プールへの参加を可能にし、抽出しやすいフォーマットが最終的な決め手になります。
Geminiのリトリーバルとインデックス登録の技術チェックリスト
Gemini は、正しく読み取れない内容を引用できません。内容自体は優れていても、技術面で気づかないうちに失敗しているケースが多くあります。文章を一語でも修正する前に、このリストを確認してください。
- サーバーサイドレンダリングまたは事前レンダリング済みスナップショットを確認する 。対象となる回答パッセージを含むページでは必須です。回答テキストがクライアントサイドJavaScript実行後にしか表示されない場合、Geminiのインデックスに供給されるクローラーが実際にレンダリング完了まで待つかどうかに賭けることになります。
- インデックス登録を直接確認しましょう。 更新済みXMLサイトマップを送信し、Google Search Consoleのカバレッジレポートで優先URLを確認してください。「検出 - インデックス未登録」のままのページは、どれだけ優れた内容でもリトリーバルプールに入れません。
- robotsディレクティブを確認する。特に、
Google-ExtendedがAI機能関連のクローラーカテゴリをブロックしていないか確認してください。別のボットをブロックしようとして、誤って自分自身を除外しているサイトは少なくありません。 - レイヤー化されたスキーマを追加する。ブランドにはOrganizationスキーマ、コンテンツにはArticleスキーマ、著者にはPersonスキーマを使用します。一貫した
sameAsリンクと組み合わせることで、これはエンティティ照合のための最も明確な施策の1つになります。 - 公開する
dateModifiedをISO 8601形式で 、かつ実際に正確な状態に保ってください。最新だと主張するページに古いタイムスタンプが付いていると、送ろうとしている鮮度シグナルを損ないます。 - Core Web Vitalsを健全に保ちましょう。 遅く不安定なページは、従来型のランキングを損なうだけでなく、クローラーが回答全文を取得する前にタイムアウトする可能性も高めます。
- 重要な回答テキストをクライアント専用JavaScriptレンダリングの背後に置かない。Cookie同意ツールや、主要パッセージの表示を遅らせる遅延読み込みスクリプトで挿入されるコンテンツも含みます。
モデル更新によって、技術面の重み付けはすでに一度変化しています。InstaRankの追跡によると、更新後の分析では、Geminiの引用と従来のオーガニック順位との重なりは減少し、構造化シグナルと意味的シグナルへの依存が高まっています。これは重要な兆候です。現在構築する技術基盤は、モデルがスキーマや意味マークアップへの依存を今後さらに強めていく中でも耐えられる必要があります。関連するクロール性や構造化データ対応をより広く理解したい場合は、2026年向けecommerce SEO基礎の解説も参照してください。
Geminiが実際に抽出できるパッセージを書くには?
抽出しやすさは、曖昧な品質シグナルではなく、執筆上の規律です。モデルが単独でそのまま引用できる段落と、意味を理解するために周囲の文脈が必要な段落との差でもあります。
- 各対象セクションは1〜2文の直接的な回答から始めましょう。 結論に向けて引っ張らないでください。まず結論を述べ、その後で補足します。「Geminiの引用はFAQページより比較コンテンツを好む」は、そこに至るまでに3文の前置きを置くよりも優れています。
- H2とH3見出しは実際の質問形式で書く。検索ボックスやチャットプロンプトに人が実際に入力する言い回しにしてください。「パッセージ抽出はどのように機能するのか?」は、「抽出メカニズム概要」よりもはるかにユーザー意図に合っています。
- 各段落を独立して理解できるようにしましょう。 「前述の通り」や「前のポイントを踏まえると」といった表現は避けてください。前の段落とセットでなければ意味が通らない段落は、Geminiが単独で抽出できず、抽出しようともしません。
- 数値や比較情報には短いリストや小さな表を使いましょう。 モデルは、密集した文章内に埋もれた事実よりも、構造化された事実をより確実に抽出します。同じ3つのデータポイントを説明するなら、段落よりも3行の表のほうが優れています。
- 公開前に抽出性テストを実施しましょう。 候補となる段落をGeminiに貼り付け、「追加情報なしで対象クエリに回答できているか」を直接確認してください。 The GEO Lab の実務ガイドでは、これを最もシンプルで信頼性の高い検証ステップと位置付けています。必要なのは2分だけで、コストもかかりません。
プロのヒント: テスト対象の段落が、「前述の通り」や「このアプローチ」といった表現なしでは意味を成さない場合、その段落は抽出性テストに失敗しています。読者がそれしか読まない前提で、完全に独立して成立するよう書き直してください。
この規律は人間の読者にも効果があります。「こんなに短い回答でいいのか」と関係者から反発を受けたときは、その点を思い出してください。結論を先に示し、その後で詳細を補足する構成のほうが、要点を探して読む読者にとっては、長い前置きの後に結論が出てくる文章よりも読みやすくなります。 AI回答最適化プレイブック では、この手法を単一ページテンプレート以上に広げたい場合に使える追加のフォーマットパターンも紹介しています。
編集掲載と信頼シグナルによって引用を獲得する
Geminiに引用されるかどうかは、多くのSEOチームが最初に考えるほど自社サイトだけでは決まりません。第三者による編集コンテンツ、ゲスト寄稿、専門家コメント、独立比較記事が引用変動の大半を動かしており、その事実は時間配分を見直す必要があることを意味します。
まず、Geminiがすでに自社カテゴリで引用しているドメインを洗い出してください。優先プロンプトを実行し、参照されるソースをすべて記録し、出現頻度でドメインを順位付けします。その後、その場所で掲載を狙います。ゲスト投稿、まとめ記事向け専門家コメント、既存比較記事へのデータ提供などです。自社ブログに投稿するより時間はかかりますが、実際に成果を動かすチャネルです。
どの種類の掲載を狙うか決める際は、単なる構造化された商品ページよりも、出典が明確な編集記事や比較コンテンツを優先してください。Omniaの調査によると、引用プール分析では、GeminiはFAQや仕様ページよりもレビューや比較記事から不均衡なほど多く情報を取得しています。機能を箇条書きにした商品ページは作るのは簡単ですが、Geminiに無視されるのも簡単です。一方、実際のトレードオフを含めながら複数の代替商品と比較する記事は、Geminiが引用しやすい典型的なフォーマットです。
掲載数よりも、すべての掲載先で一貫性を保つことが重要です。自社サイトの商品説明と、レビュー記事、マーケットプレイス掲載文がそれぞれ異なる内容なら、自らエンティティの明確性を損なっています。主要な差別化要素、ユースケース、カテゴリ用語は、どこでも同じにしてください。Is My Brand In AIの知見によると、複数の独立ソースで一貫して繰り返されるエンティティ表現は、Geminiが正しいブランドを識別する確信を強めます。
直接的なコンテンツソースではなく、検証レイヤーとして機能するプラットフォームも見落とさないでください:
- ブランド名が自然な形で話題に上がるRedditスレッド。
- 正当かつ十分な掲載理由がある場合のWikipedia記事。
- 商品に言及またはレビューしているYouTube動画。
Neil Patelの実務観察によると、Geminiはこれらのプラットフォームをより広い引用エコシステムの一部として頻繁に参照しており、そこでの自然な参加は、宣伝目的の言及よりも検証シグナルとして効果があります。Reddit上で人工的に存在感を作ろうとしないでください。顧客がすでにいる場所に現れ、誠実に質問へ回答し、信頼シグナルを自然に積み上げましょう。
Geminiでの引用を継続的に測定するには?
ここでの測定は必然的に手動になりますが、再利用可能な仕組みを作れば、それほど時間はかかりません。
- 優先プロンプトリストを作成する 。最も価値の高いトピックに対応する15〜30件のクエリを、実際のユーザーが入力する形で作成してください。このセットをGeminiで毎週または毎月実行し、すべての引用を記録します。どのURLか、どのドメインか、自社か競合かも含めます。
- Google Search Consoleと照合しましょう。 同じクエリ群のインプレッション数とクリック率を監視してください。AI Overviewの表示増加と同時にCTRが低下している場合、ユーザーがクリックする前にGeminiが回答している可能性があります。
- 3つの指標を分けて追跡する。引用頻度(どの程度表示されるか)、ソース多様性(自社以外も含め、いくつの異なるドメインが引用するか)、抽出忠実度(Geminiが実際のパッセージを引用したのか、それとも競合の内容を緩く言い換えたのか)です。
- 掲載実験は意図的に行いましょう。 対象ドメインにゲスト投稿や比較記事掲載を行い、その2〜3週間後に再度プロンプトセットを確認してください。この期間があれば、掲載が引用率に影響したか通常は確認できます。
他のテストプログラムと同じように扱ってください。結果を記録し、ベースラインと比較し、一度に5つの変数を変えないことが重要です。
Google Geminiとそのランキング要因の概要
GeminiはGoogleの大規模言語モデル群であり、現在ではAI Overview、Search内のAI Mode、単体のGeminiアプリ全体で会話型回答を支えています。固定されたシグナル群で動作する従来型ランキングアルゴリズムとは異なり、Geminiはリアルタイムで回答を生成し、その場でどのソースを根拠に使い、どのパッセージを引用するかを決定します。
ランキング要因と呼ぶなら、それは前述した3つのカテゴリに分かれます。リトリーバル適格性、抽出品質、エンティティ信頼性です。リトリーバルは依然として、インデックス登録状況、トピック関連性、従来検索での競争力といった馴染みあるシグナルに依存しています。抽出は新しい領域であり、長大な文章よりも簡潔で独立性の高いパッセージが評価されます。エンティティ信頼性は、Knowledge Graphデータ、スキーママークアップ、ウェブ全体でのブランドアイデンティティの一貫性から形成されます。
Gemini が通常のランキングアルゴリズムと異なるのは、固定されたリストに縛られない点です。同じプロンプトを二回実行しても、参照する情報源の組み合わせが少し変わることがあります。キャッシュされた順位を取り出すのではなく、回答を生成しているためです。この変動は、安定した SERP の追跡に慣れたチームには厄介ですが、同時に、常に参入の余地があることも意味します。入り込むべき固定の上位十件はありません。選定条件を満たし、内容を抽出でき、信頼できる情報源の集合が、常に再計算されています。その中に残り続けることが重要です。
Geminiのランキングと従来のGoogle検索ランキングの違い
従来のGoogleランキングでは、被リンク、オンページ関連性、ユーザーエンゲージメントデータ、サイト権威性など、数百の重み付けシグナルに基づいてページ位置が決まります。その順位は日々追跡でき、変動も確認でき、変更要因もある程度の確度で特定できます。
Geminiのランキングはその仕組みではありません。競合の10位下から追い越すような順位は存在しません。ある回答で引用されるか、されないかだけです。そして、その結果は、表現、文脈、その瞬間にモデルが取得した情報によって、クエリ実行ごとに変わる可能性があります。
両システムの重なりは依然存在しますが、縮小しています。従来順位は、Geminiのリトリーバル段階への主要入力であるため、今でも重要です。しかしInstaRankの分析によると、更新後の追跡では、従来検索上位とGemini引用の相関は弱まり、構造化データやトピックの深さの相対的重要性が以前より高まっています。あるクエリでGoogle検索3位のページがGeminiに引用され、1位ページがスキップされることもあります。抽出フィルターが重視するのは順位ではなく、パッセージの明確さだからです。
実務的な結論として、従来SEOは引き続き重要であり、リトリーバルプールに入るためのチケットです。ただし、1ページ目順位が引用を保証すると考えるのはやめましょう。今では、抽出性とエンティティの明確性が方程式の後半を決めています。そして、その後半は5年前には独立した分野として存在していませんでした。
AI生成コンテンツがGeminiランキングに与える影響
AI生成コンテンツだからという理由だけでGeminiからペナルティを受けることはありません。Googleは繰り返し、重視しているのは制作方法ではなくコンテンツの品質と有用性だと述べています。ただし、それはAIコンテンツが自動的に引用プールへ入れるという意味ではありません。
多くのAI生成コンテンツの本当の問題は、倫理ではなく構造にあります。曖昧な表現、冗長さ、一般論によって実際の回答を埋もれさせがちであり、まさに抽出性テストに失敗する特徴です。文字数を満たすためにフィラー段落を生成すると、別のモデルがきれいに抽出しにくい文章になります。抽出すべき単一で明確かつ独立した主張が存在しないためです。
さらに、AI生成コンテンツがウェブに溢れるほど、画一性そのものがリスクになります。同じテーマについてほぼ同じAI下書き説明を10サイトが公開しても、Geminiには自社を優先する強い理由がありません。その場合、決め手になるのはエンティティ信頼性です。出典が明確で編集掲載された独自性のある記事は、どれだけ速く作られたかに関係なく、汎用的なAI生成ページを常に上回ります。
コンテンツ制作でAIツールを使うチームへの実務的な指針は、下書きに使い、その後で抽出性、具体性、独自視点を徹底的に編集することです。冒頭文を引き締め、曖昧表現を削除し、具体例やデータポイントを追加する人間による編集工程は、単なるAI出力量の増加よりも引用確率に大きく寄与します。
Gemini向けにコンテンツを最適化するベストプラクティス
ここまでのプレイブックをまとめると、引用されるコンテンツと無視されるコンテンツを分ける実践は、ある程度共通しています。
毎回必ず、最初に答えを書いてください。ビジネス記事で引っ張る必要はありません。それは小説の役目です。各主要セクションの最初の文で結論を示し、その後で裏付けを加えます。
見出しは実際の質問形式で書きましょう。ユーザーがチャットインターフェースに実際に入力する言い回しを使い、社内SEO用語や気の利いた言葉遊びは避けてください。
エンティティシグナルを徹底的に整えましょう。ブランド名は1つ、説明文も統一し、スキーマを一致させ、検証済みの sameAs リンクをウェブ全体の実際のプロフィールへ向けて設定してください。
新しいコンテンツ制作を決める際は、静的な商品ページやFAQページよりも、比較記事やレビュー形式を優先してください。この形式は、測定可能なほど高い引用率を示しています。
一度公開して放置するのではなく、継続的に更新してください。主要ページは四半期ごと、最も競争の激しいキーワードは毎月更新することで、 dateModified タイムスタンプの信頼性と情報の最新性を保てます。
リソースをすべて自社ブログに注ぎ込むのではなく、カテゴリ内ですでに信頼されているドメインでの編集掲載を目指してください。その外部検証は、自社ドメイン内の追加記事を何十本出すよりもエンティティ信頼性に寄与します。
Geminiでの順位獲得を目指す際に避けるべき一般的な落とし穴
Geminiでの可視性を追うチームには、いくつか繰り返し見られるミスがあります。その大半は、従来SEOの感覚を、同じようには動作しないシステムへそのまま適用していることから生まれています。
引用の有無ではなく順位を追いかけること。 追跡すべき順位は存在しません。「Geminiで何位か」を尋ね続けるチームは、そもそも質問を間違えており、自分たちの進捗を誤読します。
スキーマを万能策として扱うこと。 SEOAliveのガイダンスによれば、構造化データはエンティティ照合の基盤ですが、それ自体が主要な引用トリガーではありません。抽出性やエンティティの一貫性を改善せずにスキーマだけ追加しても、大きな変化は期待できません。
第三者掲載を完全に無視すること。 Geminiが実際に引用している編集サイトを無視し、自社ドメインだけにすべてのリソースを注ぎ込むのは、最も一般的で高コストな失敗の1つです。
冗長で曖昧表現の多いコンテンツを公開すること。 長い段落で結論を引き延ばす文章は、情報自体が正確でも抽出テストに失敗します。
ウェブ全体で不一致なブランド説明を積み上げること。 プラットフォームごとに少しずつ異なる商品説明は、Geminiが自信を持って引用するために必要なエンティティの明確性を静かに損ないます。
測定を省略すること。 継続的なプロンプトセットと引用結果ログがなければ、手探りで最適化することになり、どの変更が実際に効果を出したのか分からなくなります。
Geminiと従来アルゴリズムのランキングシグナルの違い
古いランキングアルゴリズム、たとえばPageRank時代のGoogleや2010年代半ばのより高度なシステムでは、被リンク、キーワード関連性、ドメイン権威性が強く重視されていました。それらのシグナルによって固定順位が決まり、一度獲得すれば、何かが変わるまで比較的安定して維持されていました。
Geminiのシグナル群にもそのDNAは引き継がれていますが、重み付けは大きく変わっています。被リンクやドメイン権威性はリトリーバル段階では依然重要ですが、候補プールに入った後の引用を保証するものではありません。パッセージ単位の明確さは、古いアルゴリズムではほとんど評価手段がなかった要素ですが、今では引用されるかどうかを左右します。また、Knowledge Graphとの照合に結び付くエンティティ顕著性は、キーワード密度よりもはるかに大きな役割を果たしています。
もう一つの大きな変化は、変動の大きさです。従来の順位は日々比較的安定していましたが、Gemini の引用結果は、同じプロンプトを実行しても変わる場合があります。キャッシュされた順位リストを返すのではなく、回答を生成しているからです。そのため、週に一回順位追跡ツールを確認して終わりにする従来のやり方は通用しません。一度の観測結果ではなく、自然な変動を考慮したサンプリングが必要です。
これらすべての違いに共通するのは、古いアルゴリズムが「見つけられること」を評価していたのに対し、Geminiは「引用しやすいこと」と「特定の信頼できるエンティティとして明確に識別できること」を評価している点です。関連はしていますが同じスキルではありません。そして両者を同一視するところで、多くのチームが後れを取っています。
限られたSEO時間をどこに使うべきか?
チームが次の四半期でどこに時間を投資するか選ばなければならないなら、量より順序が重要です。まずエンティティの明確性を整えてください。一貫した命名、Organizationスキーマ、検証済みの sameAs リンクです。Geminiが誰なのかを確信を持って識別できなければ、その後の施策は機能しません。次に、最もトラフィックの多いページを抽出しやすい形へ書き換えてください。既存のリトリーバル適格性を実際の引用へ変える最速手段だからです。編集掲載は3番目です。重要性が低いからではなく、実行に時間がかかり、自社基盤を整えた後のほうが効果を発揮するためです。
モデルの更新を個別に追いかけるのはやめましょう。代わりに、内容を抽出できるかを確認する軽量な自動チェックと、定期的にプロンプトを監視する運用を整えてください。時間とともに Gemini の重み付けが変わっても、その仕組みで変動に対応できます。EC ブランドでは、ここでシミュレーションによるアプローチが力を発揮します。AI ショッピングエージェントがどの商品属性や説明文を表示するかを推測せず、選定の過程を直接モデル化し、流入を失う前に不足を修正できます。
— Xhurian
AIエージェントが商品情報をどう読み取るか無料スキャンで確認
ここまでの内容は編集記事や情報ページに当てはまりますが、ecommerceの商品情報では同じ問題がさらに深刻になります。GeminiのようなAIショッピングエージェントは、どれだけ長い説明文を書いたかではなく、商品情報が購入者の質問にどれだけ明確に答えているかで推薦を決めます。まさにその判断プロセスを、自社のライブecommerceカタログに対してシミュレーションし、どの商品情報が選ばれ、どれが除外され、その理由が何かを平易な言葉で表示します。

商品説明がAIエージェントに引用されるのに十分抽出しやすいかを推測する代わりに、直接的な診断結果を得られます。強み、弱み、具体的な書き換え提案です。プラットフォームは再スキャンごとの継続的な選択率も追跡するため、単に期待するのではなく、変更が実際に成果へつながったか確認できます。Shopifyストアを運営している場合は、まず 無料の商品情報スキャン を試し、AIショッピングエージェントに対して現在のカタログがどの位置にあるのかを正確に確認してください。
参考ソース
独自のテストプロセスを構築する際に、ブックマークしておく価値のある外部リソースをいくつか紹介します:
FAQ
Geminiの順位とは何ですか?
Geminiは、従来のGoogle検索のようにコンテンツへ数値順位を付けません。生成された回答内でソースとしてページを引用するかしないかで決まるため、ここでの「順位」とはリスト位置ではなく引用の有無を意味します。
なぜGeminiはChatGPTより上位とされるのですか?
AIアシスタントの利用状況や検索統合の比較は、指標によって異なり、頻繁に変化します。そのため、あらゆる状況に当てはまる固定的な答えはありません。ただし、GeminiはGoogle SearchやAndroidへ深く統合されているため、多くのユーザーに対して単体チャットアシスタントより広いデフォルト露出を持っています。
Google Geminiのレベルには何がありますか?
Googleは複数のGeminiモデル階層を提供しており、一般的には高速応答向けの軽量版、複雑な推論タスク向けの高性能版、さらにコーディング向けに調整された特化版があります。ただし、ランキングや引用の観点で最も重要なのは、どの基盤モデルが回答したかではなく、GeminiがSearchやAI Overview内でどのように展開されているかです。
Googleで順位を獲得するとはどういう意味ですか?
従来のGoogle検索では、順位とは特定クエリに対するオーガニック検索結果内の位置を意味し、通常は関連性、権威性、技術シグナルによって決まります。一方GeminiやAI Overviewでは、その概念は「生成回答内でコンテンツが取得され、引用されるかどうか」へ移行しています。
コンテンツがGeminiに引用されているか確認するには?
対象プロンプトを一定のセットとして定期的にGeminiで実行し、どのドメインが引用に現れるかを記録してください。ecenticがecommerce商品情報向けに提供しているようなツールは、この原理を商品ページへ直接適用し、エージェントの選択をシミュレーションすることで、可視性を失う前にギャップを確認できるようにします。