

ECにおける生成エンジン最適化とは、ChatGPT、Gemini、Claude のようなAIショッピングエージェントが競合商品ではなく自社SKUを選び、推奨できるように商品情報を構造化することです。最初に行うべきことは、Product と Offer のデータ(価格、在庫状況、GTIN)がサーバーサイドでレンダリングされているか、あるいはクリーンな Merchant Center フィードを通じて流れているかを監査することです。エージェントがそのデータを数ミリ秒で解析できなければ、商品は読み飛ばされます。E-GEOベンチマークと Columbia の ACES 実験による研究は、これが理論上の話ではないことを裏づけています。「人には読める」が「エージェントには読めない」というギャップが、いまや売上の問題になっているからこそ、Ecentic のようなツールが存在します。
- 今すぐ売れ筋上位のPDPを3件開いて、価格と在庫状況が、読み込み後にJavaScriptでレンダリングされるだけでなく、生のHTMLにも出ているか確認してください。
重要なポイント
生成エンジン最適化で成果を出すには、商品データをフィールド単位で機械可読にし、静的なマーケティングコピーのまま放置せず、実際のエージェントの挙動に照らして検証する必要があります。
| ポイント | 詳細 |
|---|---|
| ECにおけるGEOの対象範囲 | スキーマ、レビュー、FAQ、動画の文字起こし、フィードを最適化し、エージェントが自社SKUを選べるようにします。 |
| エージェントはシグナルを均等には評価しない | ACES では、バッジ、表示位置、モデルの選択(GPT-4.1、Claude Sonnet 4、Gemini 2.5 Flash)によって、選定への影響が異なることがわかりました。 |
| 書き換えは順位を測定可能な形で動かす | E-GEO では、プロンプト最適化された書き換えが、7,000件超のクエリで15のヒューリスティックなベースラインを上回りました。 |
| 粗利とギャップで優先順位を付ける | まず取り組むべきなのは、売れ筋商品ではなく、現在AI上での可視性が弱い高粗利SKUです。 |
| ecentic は検証を迅速化 | エージェントの挙動をシミュレーションし、商品情報やデータの不足を診断して、修正内容をワンクリックで Shopify と WooCommerce に公開します。 |
商品情報における Generative Engine Optimization とは?
eコマースチームにとって、GEO は、ほかで見かける広義の「AI に引用される」ための施策よりも対象が絞られています。焦点は、リアルタイムで SKU を取得・比較・推奨するショッピングエージェントにとって、個々の商品ページやフィードを読み取りやすくすることです。つまり、一般的な AI 検索での露出を狙うブログコンテンツ戦略は含まれません。対象範囲には次が含まれます。
- 商品属性とスキーマ:商品名、ブランド、GTIN、価格、在庫状況、素材、寸法。
- レビューとレビュースキーマ:AggregateRating と Review のマークアップ。実在し、日付のあるフィードバックを含みます。
- FAQPage マークアップ:購入時の懸念に答える、構造化された質問と回答のペア。
- 動画の文字起こしと VideoObject スキーマ:エージェントが引用できる、タイムスタンプ付きの記述。
- 比較表:自社商品と競合商品をエージェントが比較できる構造化データ。
- 商品フィード:GTIN が一致している、整理された最新の Merchant Center フィード。
多くのエージェントは検索拡張生成で動作し、ページ全体を読むのではなく、構造化された断片を取得します。3段落のブランドストーリーより、整理された仕様表のほうが毎回優先されます。
なぜ今、AIショッピングエージェントに GEO が重要なのか?
ここでの根拠は推測ではありません。Columbia Business School の ACES experiments では、複数の AI モデルに対して模擬ストアフロントを提示し、実際に何が商品の推奨選択を変えたのかを追跡しました。掲載位置は影響しました。バッジも影響しました。そして、どのモデル向けに最適化するかは、多くのマーチャントが想定する以上に重要でした。GPT-4.1、Claude Sonnet 4、Gemini 2.5 Flash はいずれも、推奨商品を選ぶ際に異なる列や配置の好みを示しました。
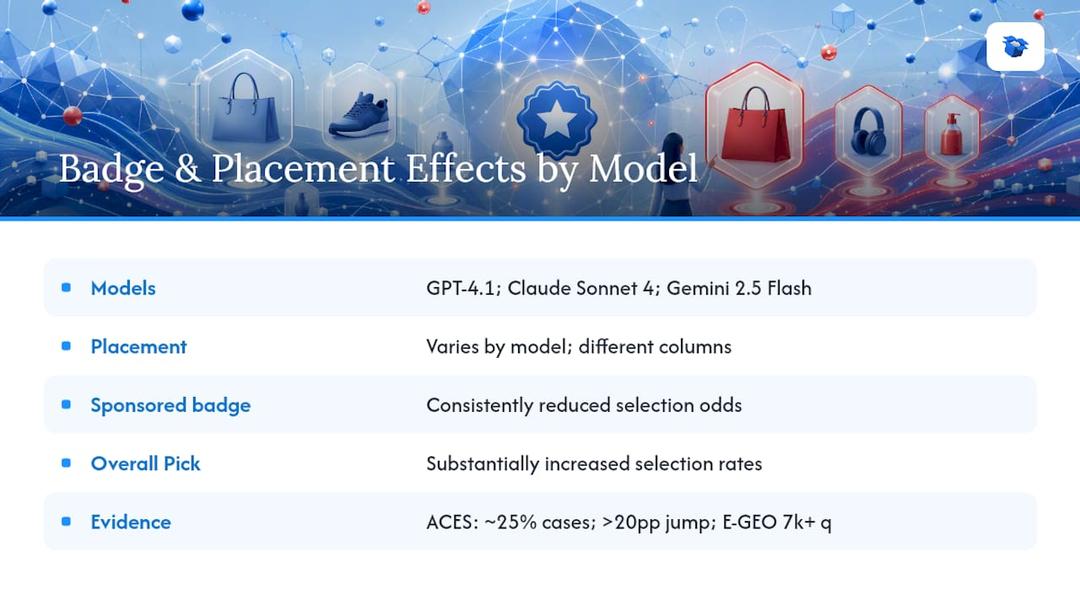
バッジはプラスにもマイナスにも働きます。“Sponsored” タグは、商品が選ばれる確率を一貫して下げる一方で、“Overall Pick” の推奨表示は、価格と評価を一定にした条件で、選定率を大きく押し上げました。マーチャンダイジングで有料掲載ラベルに頼っている場合、“sponsored” を信頼シグナルではなく警戒サインとして読むエージェントに対して、気づかないうちに逆効果になっている可能性があります。
注目データ: ACES 型のシミュレーションでは、対象を絞った書き換えによって、テストしたケースのおよそ四分の一で、選択シェアに統計的に有意な改善が見られました。少なくとも一件の書き換えでは、一回のシミュレーション対決で市場シェアが 20 パーセントポイントを超えて上昇しました。
別の E-GEO ベンチマークでは、7,000 件超のクエリと 52,000 点超の商品を対象に、リライトとプロンプトのメタ最適化を検証し、最適化されたリライトが順位変動で 15 のヒューリスティックなベースラインを上回ることが示されました。つまり、これは勘ではありません。小さくても意図的なコピー変更が、測定可能かつ再現可能な形で順位を動かします。
たとえば、中価格帯のキッチン家電ブランドが、主力 SKU の説明文を、一般的なマーケティング表現ではなく、具体的な利用シーン(少量調理、食洗機対応パーツ)を前面に出す形に書き換えたとします。
プロのヒント: まずは売れ筋商品ではなく、利益率が最も高いカテゴリから始めてください。$200 の商品で選定シェアが上がるリライトは、$20 のアクセサリーに同じ労力をかけるより早く回収できます。
GEO のために、すべての商品ページに何を載せるべきか?
これは、そのままエンジニアやコンテンツ担当に渡せる実装シートとして捉えてください。
スキーマ層:
- 完全な Product スキーマ:商品名、ブランド、GTIN、SKU、価格、在庫状況、色、素材、寸法。
- Offer スキーマ:価格、通貨、状態、販売者名、配送詳細。
- AggregateRating スキーマと Review スキーマ:実際のレビュー件数、日付、確認済みのレビュー本文。
- FAQPage スキーマ:購入者からの質問を少なくとも3〜5件、直接的な回答付きで掲載。
- VideoObject スキーマ:完全な文字起こしと、
hasPart主要な主張に対応するタイムスタンプ付きセグメントを組み合わせます。
レンダリングとフィード層:
- 価格、在庫状況、主要スペックはサーバー側でレンダリングします。AIショッピングエージェントのクローラーが実行しない可能性のあるクライアントサイド JavaScript の裏に隠さないでください。
- Merchant Center フィードは最低でも毎日同期し、サイトとフィードの両方で GTIN を一致させます。
- エージェントクローラーの user-agent に対して、ブロックではなく 200 レスポンスが返ることを確認します。
robots.txtと、llms.txtファイルに意図しない除外がないか確認してください。
検証の頻度: Google の Rich Results Test とスキーマバリデーターは、リリース時だけでなく、売上上位の SKU を対象に毎週実行します。開発者が無関係なテーマ更新を反映すると、スキーマは気づかれないまま壊れることがあります。壊れたスキーマブロックは人間の買い物客には見えませんが、エージェントへの可視性には致命的です。
プロのヒント: レビューを依頼する際は、一般的な星評価の依頼ではなく、「この商品はどんな課題を解決しましたか?」のような具体的な質問を1つ投げかけます。具体的で、日付があり、裏づけのあるレビューは、 エージェントが重視する最も強いシグナルの一部です 。似た商品同士から選ぶ際に影響します。
よくある落とし穴は、チームが Product スキーマを追加しただけで止まり、FAQPage や VideoObject を「任意項目」と考えて空のままにしてしまうことです。実際には任意ではありません。「これは X と互換性がありますか」に答える比較表や文字起こしの該当箇所をエージェントが見つけられなければ、その回答を用意した競合他社を引用します。各タイプに必要な最小限のスキーマを項目別に確認するには、ecentic の 構造化データチェックリスト で、各タイプに必要な最小限のスキーマを項目ごとに確認できます。
GEO をカタログ全体にどう展開するか
計画なしにカタログ全体へ展開すると、四半期を費やしても成果が出ない事態を招きます。次の順序で進めてください。
- 1時間のチェックを実施する 上位5件の SKU を選び、スキーマの完全性、フィードの正確性、ページのレンダリングを確認します。
- 利益率と可視性ギャップで優先順位を付ける 現在の AI 可視性が弱い高利益率カテゴリを最優先にし、すでに強いベストセラーは後回しにします。
- テストセットを作る タイトル、説明文、FAQ コンテンツについて、対照用の商品情報とリライト版を組み合わせて比較します。
- 本番公開前にシミュレーションする 可能であれば、本番の商品コピーを変更する前に、E-GEO の手法に近いプロンプトベースのシミュレーションを実行し、順位変動を見積もります。
- 管理された本番 A/B テストを実施する 単日ではなく、定義した期間内での選択シェアと順位変動を測定します。
- 勝ちパターンを展開し、負けパターンは廃止する どのリライトがどの改善につながったか分かるよう、変更履歴を残します。
重み付けする価値のある優先順位付け基準としては、商品あたりの利益率、既存レビューの充実度、フィードの準備状況、その SKU が現在比較結果の上位からどれだけ離れているか、が挙げられます。
チーム体制はチェックリストと同じくらい重要です:
- プロダクトオーナー がロードマップと優先順位付けを担います。
- エンジニア がスキーマ実装とフィードの健全性を担います。
- コンテンツライター がリライト用テンプレートと FAQ コピーを作成します。
- アナリスト が選択シェア、順位変動、エージェント経由売上を追跡します。
中規模カタログの多くでは、隔週のスプリントで進め、毎月フルスキャンを実施する運用が適しています。こうした作業に特化したプラットフォームを使うと、ここで実際に時間を節約できます。ecentic は ChatGPT、Gemini、Claude 系のエージェントに対してシミュレーション主導の診断を実行し、その修正を Shopify または WooCommerce にワンクリックで直接反映できるため、通常ならエンジニアリングのスプリント単位でかかる作業を数時間まで短縮できます。
GEO が機能しているかはどう測定するのか?
曖昧な「AIでの可視性」ではなく、具体的な指標セットを追跡します。
- エージェント経由の訪問数:既知のエージェント参照元や UTM タグ付きエージェントリンク経由で流入したセッション数。
- 選択シェアと平均順位の変化:固定されたクエリセット全体で商品がどの程度の頻度・順位で表示されるかを測定します。評価には、E-GEO が中核指標として採用している順位変化メトリクスを使用します。
- エージェント経由流入の CTR:エージェントが表示した商品カードでのクリック率。
- エージェント経由トラフィックのコンバージョン率:エージェント経由の流入が実際に購入につながっているか。
- 訪問あたりの売上:分析環境で可能な場合は、エージェントの流入元ごとに分けて確認します。
統計的なポイント: E-GEO の評価では、プロンプトのメタ最適化は、静的なヒューリスティックベースのリライトと比べて、7,000 件超のクエリセット全体で一貫した順位改善を示しました。一部のケースだけで成果が出たわけではありません。
テスト手順としては、可能であればまずシミュレーション実験を実施し、その後で商品説明やタイトル変更についてライブ環境でランダム化 A/B テストを行って確認します。プラットフォーム全体のアルゴリズム変更をリライトの効果と誤認しないよう、カタログレベルでホールドアウトのコントロールセットを用意してください。結論を出す前に、どのテストも最低 2〜3 週間は継続する必要があります。エージェントの挙動は通常の Web SEO より日々の変動が大きく、1 日だけの急増は持続しないケースがほとんどです。アトリビューションについては、Merchant Center のフィードログとサイト上のリファラートラッキングを組み合わせてください。 ChatGPT 検索が商品をどのように順位付けするか では、構造化されたフィードデータとリアルタイムのページコンテンツの両方が使われています。そのため、古いフィードスナップショットを参照すると、実際に選択に影響している要因を誤って判断する可能性があります。ecentic の エージェントトラフィック追跡ガイド では、タグ設定についてさらに詳しく解説しています。
GEO を数サイクル回すと何が見えてくるのか?
モデルの選好は固定ではありません。ACES の研究で GPT-4.1 と後続モデル世代を比較したところ、順位付けの重み付けがバージョン間で完全に逆転する場合があることが示されました。そのため、あるエージェント向けに最適化したリライトが、次のモデル更新では効果を失ったり、逆効果になったりする可能性があります。単一エージェントの癖を追いかける戦略は、長期的には得策ではありません。
より重要な教訓は、小さな変更でも想像以上に結果が動くということです。そして、それは良い方向にも悪い方向にも働きます。商品情報のコピーはコードと同じようにバージョン管理し、すべてのリライトを公開前テストで確認し、少なくとも毎月は再スキャンしてください。エージェントが解析できない商品画像の中に重要情報を埋め込まず、有料プロモーションのように見えるバッジにも依存しないことです。裏付けがあり具体的なレビューは、見た目の整え方より一貫して高い成果を出します。
このプレイブックを ecentic がどう実行支援するか
ecentic は、この記事で説明したワークフローを、複数スプリント規模のエンジニアリング工数なしで実行できるよう設計されています。ChatGPT、Gemini、Claude 系エージェントが商品ページをどう評価するかをシミュレーションし、エージェントに選ばれない原因となっているスキーマ、フィード、コンテンツの具体的な欠落を特定し、勝敗理由を平易な英語で添えて商品情報を書き換えます。

修正内容を承認すると、ecentic は Shopify または WooCommerce へワンクリックで直接反映します。その後も継続的に再スキャンを行うため、モデル更新によってエージェントが評価する要素が変化した場合でも把握できます。プラットフォーム利用企業からは、推奨内容を実装後に AI 主導のサイト訪問数とその後の売上の両方で測定可能な増加が報告されています。詳細な仕組みは 仕組み紹介ページで確認できます。ACES や E-GEO の背景にあるテスト手法を、シミュレーションエンジンがどのように再現しているかも説明しています。
今すぐ 商品情報の無料スキャン を実行して、主要 SKU が AI ショッピングエージェントにどう評価されているか、そして改善に何が必要かを確認してください。
参考情報
- AI が買い物を代行すると何が起きるのか? | Columbia Business School
- ChatGPT 検索は商品とマーチャントをどう順位付けするのか | Search Engine Land
まずは 1 つの商品ページで、シンプルな E-GEO スタイルのプロンプトテストを再現してみてください。あるいは、ecentic の無料スキャンを使えば、環境構築なしで診断結果を取得できます。
FAQ
eコマース向け Generative Engine Optimization とは?
ChatGPT や Gemini のような AI ショッピングエージェントが SKU を抽出・評価・推奨できるように、商品情報、スキーマ、フィードを構造化する取り組みです。
GEO は従来の SEO とどう違うのか?
従来の SEO は Web ページの検索順位を対象とします。一方、eコマース向け GEO は、AI エージェントが候補商品の中から特定の商品を選択するかどうかを対象とします。
AI ショッピングエージェントで特に重要なスキーマタイプは?
eコマース GEO のガイダンスによると、Product、Offer、AggregateRating、Review、FAQPage、VideoObject の各スキーマは、エージェントが依存するフィールドレベルの情報を提供します。
一回の書き換えだけで、本当に AI に選ばれる率は変わりますか?
はい。ACES 型のシミュレーションでは、対象を絞った書き換えによって、テストしたケースのおよそ四分の一で、選択シェアに大きな改善が見られました。あるケースでは、市場シェアの変化が 20 ポイントを超えました。
GEO のために商品情報を再監査する頻度は?
エージェントの挙動はモデルバージョンごとに変化するため、少なくとも毎月は再スキャンしてください。ecentic の継続的な再スキャン機能を使えば、手動で再チェックしなくても問題を検出できます。
関連トピックを確認