

Google で検索する場合でも、Amazon に行く場合でも、チャットボットに尋ねる場合でも、今は AI が商品を含む回答を返します。しかし、多くのECブランドは、どうすれば自社商品がその回答に選ばれるのか把握できていません。AI向けの商品データ品質とは、商品名、仕様、識別子、価格、在庫状況が完全で、掲載されるすべての場所で一貫しており、ソフトウェアが読み取れる状態にあることです。そこを直せば、エージェントは自社商品を競合商品と比較し、自社商品を選びます。
いちばん皮肉なのは、みんなで長いことホームページを磨き込んできたことかもしれません。AIエージェントは自社のホームページを見ません。読むのは商品フィード、カタログ、商品ページ上の構造化データで、何かが欠けていればそのまま次へ進みます。ヒーローバナーがどれだけ魅力的でも、見ている相手はいません。
要点
- AIエージェントは、ホームページやブランドストーリーではなく、フィード項目、カタログデータ、商品ページ上の構造化データを使って商品を比較します。
- 項目の欠落、不一致、古い情報(仕様、識別子、価格、在庫状況)は、AIエージェントが商品をスキップする最も一般的な理由です。
- フィードとページのマークアップは同じ内容でなければなりません。Google は両方を使い、相互に照合します。
- まずは、購入者が誤った選択をしかねない不一致から監査してください。商品同一性、適合性、オファー内容、遷移先です。
- 小さく始めましょう。無料の ecentic スキャンでは上位10商品を対象に、どの競合商品に負けているのか、その理由は何かを確認できます。
AIエージェントが買い手になると、商品データ品質は何を意味するのか
人にとって商品ページは、写真を使ったストーリーです。AIエージェントにとっては、商品情報の記録です。AIエージェントが問うのはシンプルです。この商品情報から、それが何で、要求に合っていて、いくらで、在庫があり、どこで買えるのかが分かるか、ということです。
AIショッピングにおける商品発見に関する2026年の記事は、 慎重な指摘を示しています。完全な商品データは、AI支援システムが商品を評価し、表示する可能性を高めることはあっても、知名度の低い商品がより大きなブランドに勝てることの証明にはなりません。私はこの捉え方に賛成です。きれいなデータは入場券です。保証ではありません。
LogicBrokerのJager Robinsonは、 商品データ品質に関する2026年の投稿で有益な指摘をしています。AI主導の商品発見で選ばれるのは、必ずしもマーケティング予算が最も大きい商品ではなく、モデルが読み取り、信頼できるほどデータが整っていて、構造化され、一貫している商品であることが多いという点です。多くのカタログは、完全性をあれば望ましい追加要素として扱い、まずは商品を素早く公開するために作られてきました。このトレードオフは以前は安く済みました。今はもう違います。
エージェントが確認する4つのこと
私は4つの問いで考えるのが最もわかりやすいと感じています。これはFirst Brandの AIショッピング対応状況レポート:
- 識別。 これはどの正確な商品・バリエーションか。識別子とメイン画像がそれに答えます。
- 適合性。 買い手が求めた条件に合っているか。属性、互換性、裏付け情報がそれに答えます。
- オファー。 価格はいくらか、通貨は何か、在庫があるか、どの条件で購入できるか。
- 遷移先。 リンク先は正しい商品ページで、購入までの導線は機能しているか。
4つのうち1つでも誤っていれば、エージェントは推測するか、離脱します。推測のほうが不利です。なぜなら、買い手に誤った価格や誤ったサイズが表示されると、返品される注文か、失注になるからです。
欠落があるとエージェントに選ばれない理由
LogicBrokerは、こうした不具合は規模が大きくなると予測しやすいものだと説明しています。 仕様が不完全、説明文がキーワードの詰め込みになっている、属性の入力にSKUごとのばらつきがある、同じ商品でもチャネルによって名前が異なる。要点を率直に言えば、モデルは欠落を補ってはくれず、そのまま次に進むということです。
Googleも別の言い方で同様のことを述べています。Googleの Merchant Centerの商品データ仕様 では、誤った、不正確な、または欠落した商品情報によって、不承認、掲載対象の制限、誤表示が発生する可能性があるとされています。また、正確で正しい形式の商品データは、AIを活用したフォーマットでの広告や無料掲載に不可欠だと述べています。
もう一つ、気づきにくい問題があります。人にはアクセスできても、エージェントにはアクセスできないデータです。Core dna は、Clark Rubber のサイトで行ったテストについて、 商品レベルの情報は取得できた一方で、店舗レベルの在庫は取得経路で一度も露出しない操作の先にあったと説明しています。人は店舗セレクターをクリックして在庫を確認します。エージェントは何もクリックしません。ロボットなのだから当然とも言えますが、それでも誰が売上を取るかは決めています。
自社のシミュレーションで見えていること
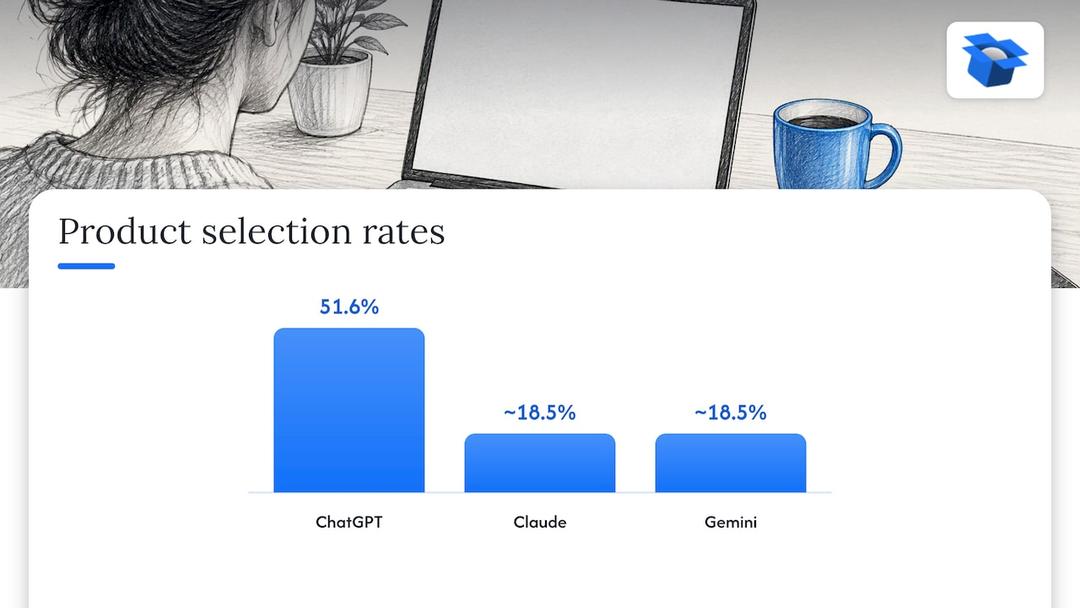
これはecenticの数値であり、自社で実行した結果です。その前提で見てください。2026年10月までに、36,797件の購入シミュレーションを実施しました。同じカタログでも、ChatGPTはClaudeやGeminiの約3倍の頻度で商品を選び、51.6%に対して後者はおよそ18.5%でした。つまり、「AI」は1人の買い手ではありません。各モデルは商品データの重み付けが異なり、あるモデルで勝つ商品情報が、別のモデルでは負けることがあります。
ある匿名の監査では、年間約€70Mを売り上げる蒸留酒マーケットプレイスで、9,699商品のうち88%に、エージェントが読むデータの不具合が見つかりました。そのマーケットプレイスが在庫している2本のボトルをどこで買えるかをエージェントに尋ねると、20回中0回しか選ばれませんでした。サイトの見た目が優れていたため、誰も気づいていませんでした。
別の監査では、スウェーデンのスキンケアブランドについて、エージェントによる購入手続きが6か国中0か国でしか決済まで到達しないことがわかりました。配送設定で電話番号の入力が求められていたためです。カートを埋めるエージェントは顧客の電話番号を持っていません。小さな設定ですが、すべての注文を止めていました。
どの仕様と属性を提供すべきか
まずは、プラットフォーム自身が求めているものから始めてください。OpenAIの 商品フィード仕様 では、item_id、title、description、url、brand、seller_name、image_url、availability、priceが必須です。condition、product_category、material、color、size、gender、age_group、dimensions、weightは任意項目として挙げられています。任意というのは穏当な言い方です。2つの商品が競合するとき、materialやdimensionsが埋まっているほうが、具体的な要求に照合しやすくなります。
Xorosoftは、 ショッピングエージェント向けデータガイドで実務的な論点を示しています。重要なのは販促的な表現より事実としての完全性であり、構造化された属性があると、ソフトウェアが文章から詳細を推測する必要がないため比較しやすくなります。例として挙げているのは、幅50インチ未満のウォールナット製デスクを探す買い手です。materialやwidthが段落中の形容表現ではなくフィールドになっているほうが、その一致ははるかに信頼できます。
Photoroomは、 7層の商品情報構造 を提案しており、私はこれを便利なチェックリストだと感じています。
| レイヤー | 含める内容 |
|---|---|
| タイトル | 商品タイプ、ブランド、モデル、素材、色、サイズ、容量 |
| 構造化属性 | 色、サイズ、素材、性別、状態、互換性、寸法 |
| 説明文 | 構造、性能、同梱物、想定用途、メンテナンス |
| 識別子 | GTIN、MPN、SKU、item group ID |
| オファーデータ | 価格、通貨、在庫状況、状態、配送、返品 |
| 画像 | メイン、別角度、詳細、利用シーン |
| ページとフィードの整合性 | 価格、在庫、タイトル、バリエーション、画像、URLの一致 |
ここで注目したいのは、欠けているものです。スローガンは含まれていません。「これさえあれば一生使えるマグ」のようなタイトルでは、エージェントには何も伝わりません。「ストーンウェア製コーヒーマグ、12 oz、マットブラック、食洗機対応」なら、比較可能な情報がすべて伝わります。タイトルや説明文をどう見直すかを詳しく知りたい場合は、 商品情報の最適化 のガイドで、書き換えの実務を解説しています。
フィードとページのマークアップは一致している必要があります
多くのストアは、商品フィードと、商品ページ上の構造化データ(機械が読み取れる JSON-LD のブロック)という二つの形で事実情報を管理しています。両者は、誰も認めたがらないほどの速さで食い違っていきます。
GoogleのSearch Centralドキュメントでは、 構造化データとMerchant Centerフィードの両方を提供すると、掲載対象が最大化され、Googleによるデータ検証にも役立つとされています。一部の表示体験ではこの2つが組み合わされるため、ページのマークアップに価格がない場合、商品スニペットはフィードから価格を取得することがあります。さらに、Merchant Center自身のヘルプページには、多くの人がつまずくルールが挙げられています。 マークアップはJavaScriptで生成するのではなくサーバーが返すHTML内に存在している必要があり、ユーザーに見えている内容と一致していなければならず、ページにはネストされたOfferを含むProductオブジェクトが必要で、価格の小数点区切りにはピリオドを使います.
Universal Commerce Protocolのブログでは、 エージェントコマース向けの最小限のProduct Schemaプロパティとして、name、description、skuまたはgtin13、brand、image、priceとavailabilityを含むoffers、aggregateRatingが挙げられています。さらに、商品タイプ固有の属性には、weight、height、width、depth、color、size、category、additionalPropertyの追加を推奨しています。マークアップ自体にまだ慣れていない場合は、 構造化データのマークアップの仕組み を平易に解説した記事が役立ちますし、商品向け構造化データのマークアップを追加する手順を段階的に説明した記事には、そのまま使えるサンプルもあります。
| 商品フィード | ページの構造化データ | |
|---|---|---|
| 掲載場所 | Merchant Centerなどのチャネルにアップロード | 各商品ページのHTML内 |
| 得意なこと | 価格、在庫、識別情報を大規模に鮮度を保って管理すること | ページがフィードと一致しているかをシステムで検証できるようにすること |
| 典型的な不具合 | 古い価格や在庫 | Offerの欠落、JavaScriptのみのマークアップ |
| 通常の担当者 | グロースチームまたはチャネルチーム | 開発者またはテーマ側 |
BBQ Growth Labはこれを、 4つのレイヤーとしてうまく整理しています。元データ(PIM、ERP、在庫、価格設定)、正規化された商品モデル、チャネル出力(ページHTML、JSON-LD、フィード)、そしてステータス・警告・却下のフィードバック層です。彼らのルールは、どのプラットフォームのフィードも元データを黙って上書きしてはならない、というものです。これは正しいと思いますし、小規模ストアで誰かが販売チャネル内でタイトルを直接編集したときに最初に破りがちなルールでもあります。
ただし、公平のために付け加えると、構造化データがあっても推薦は保証されません。Core dnaも妥当な表現で、AIシステムが扱える商用情報をより良く提供できるようになる一方で、見つけてもらえるかどうかは依然として関連性、文脈、その他のシグナルに左右されると述べています。また、APIがあることと、エージェントから利用可能であることは同じではありません。エージェント側に対応した利用方法がなければ、到達可能とは言えません。
マークアップについての見解は、 商品ページ向け構造化データのチェックリスト と、 シミュレーションに裏づけられた商品schema.
カタログを点検する方法
初日に10,000商品すべてを修正する必要はありません。不一致によって買い手が誤った選択をしてしまう商品から直してください。First Brandが 準備状況チェックで提案している優先順位もこれで、妥当な絞り込みです。
- フィードをエクスポートし、売れ筋上位20商品を選びます。小さなサンプルでも、傾向はすぐに見えてきます。
- 各商品について識別情報を確認します。バリエーションごとに固有の識別子があり、タイトルがサイト、フィード、マーケットプレイスですべて一致していますか。
- 適合性を確認します。素材、サイズ、寸法、互換性、用途が文章に埋もれておらず、項目として入力されていますか。
- オファー内容を確認します。フィード内の価格、通貨、在庫状況が、実際の商品ページとJSON-LDの内容と一致しているか比較します。
- 遷移先を確認します。フィードのURLをクリックし、正しいバリエーションの商品ページが開くか、またログインや電話番号入力なしで購入手続きに進めるか確認します。
- 買い手と同じ聞き方でいくつかのチャットボットに商品を尋ね、自社ではなくどの競合ブランドや競合商品が挙げられるか記録します。
多くのチームが止まりやすいのがステップ6です。手作業では時間がかかり、答えもモデルごとに変わるためです。これが、ecenticでシミュレーション機能を構築した理由です。詳しくは以下で説明します。
商品データが十分かどうかを測る方法
業界共通の単一スコアはないため、シンプルなスコアカードを作り、毎月追跡するのがよいでしょう。見るべき指標は次の4つです。
- 完全性: 必須項目と推奨項目がすべて入力されている商品の割合。
- 一貫性: タイトル、価格、在庫状況がフィード、商品ページ、マーケットプレイス間で一致している商品の割合。
- 正確性: サンプル商品を実物、パッケージ、仕入先資料と照合して確認するスポットチェック。
- 鮮度: システム内で価格や在庫が変更されてから、同じ変更がフィードに反映されるまでの時間。
既存のツールも役立ちます。Merchant Centerでは商品単位の警告や不承認を確認でき、Google独自ルールに対する無料の一貫性チェックになります。また、どのチームが何を担当するかも重要です。BBQ Growth Labは、商品定義はプロダクトチーム、価格と在庫の正確性は商用システム、配信はエンジニアリング、プラットフォームごとのマッピングと品質ゲートはグロースチームが担うべきだとしています。管理すべきなのは、価格、在庫、識別子、バリエーション、画像があらゆる場所で正しく表現されているかであり、誰がファイルをアップロードするかではありません。
より長期的な展開については、 AI向け商品ページ最適化の30〜90日プラン と AIショッピングで使われるデータソース の記事で手順を整理しています。
今後についての私たちの見解
私たちは、商品データそのものがストアフロントになりつつあると考えています。誰かがエージェントにギフト探し、ミキサー2機種の比較、コーヒーの再注文を依頼すると、エージェントが読むのは商品レコードです。ブラウジングはせず、バナーに惹かれることもなく、サイズ情報の欠落も見逃しません。
そのためecenticは、ストア自体、つまり商品フィード、カタログ、そしてエージェントが購入に使う決済部分に取り組んでいます。Shopify、WooCommerce、または商品フィードに接続でき、ChatGPT、Claude、Geminiが各商品を指定した競合商品と比較し、なぜ負けるのかを平易な英語で表示します。Applyをクリックすると、タイトル、説明文、構造化データを書き換えてストアに反映します。
チェックアウト部分は重要です。AIの回答内での購入は、Googleのエージェント向け決済オープン標準であるUCPを通じて、米国のGoogle AI ModeとGeminiですでに提供されています。WooCommerceでは、無料のecenticプラグインにより、エージェントがUCP経由で商品検索、カート投入、決済まで行えます。Shopifyでは、Google Merchant Centerへの修正反映と、AIアシスタント経由の訪問追跡を行います。ChatGPTはストア独自の決済ページへリンクするため、こちらでは商品ページと決済フローの両方がエージェント向けに機能する必要があります。OpenAIにはACP、GoogleにはUCPがあり、Amazonは閉鎖的です。
最初のパイロット導入先であるDUA Flavoursでは、2026年4月から7月にかけて、AIアシスタント経由とダイレクト流入の訪問数が12%増加しました。これは売上ではなく訪問数の指標であり、その点は明確にしておきます。私たちはまだ初期段階で、現在もパイロット運用中です。
Xhurian Shaba
まずは無料スキャンから
説明を読むより実際の問題点を確認したい場合は、無料のecenticスキャンを利用してください。上位10商品を対象に、カード登録不要で、各AIモデルがどの競合商品を選び、その理由は何かを確認できます。また、ストア向けの 無料のWebMCPショッピング診断 を実行し、 仕組み を読んでから接続することもできます。

修正内容を公開したい場合、Competeプランは100商品まで月額$14.90です。Scaleは1,000商品まで月額$44.90で、ワンクリック修正機能が追加されます。Dominateは月額$149で、Google Merchant Center同期とエージェント向け決済設定が追加されます。また、AI経由注文の3%を課金する従量課金オプションもあり、上限は月額$500です。最新の条件は 料金ページで確認でき、大規模カタログ向けには Enterprise.
FAQ
AI向けの商品データ品質とは何ですか?
商品レコードがどれだけ完全で、一貫性があり、正確かつ最新であり、さらにソフトウェアが読み取れる状態かを指します。エージェントは、タイトル、属性、識別子、価格、在庫状況などの項目で商品を比較します。情報に欠けがあるレコードは簡単に除外されるため、情報が充実した商品のほうが推薦されやすくなります。
AIショッピングエージェントにとって重要な商品仕様は何ですか?
まずはプラットフォームが必須とする項目から始めましょう。タイトル、説明文、ブランド、画像、価格、在庫状況に加え、GTINやSKUなどの識別子です。 OpenAIの商品フィード仕様 では、素材、色、サイズ、寸法、重量も任意項目として挙げられています。これらは説明文だけでなく、個別の項目として入力してください。
商品フィードと構造化データの両方が必要ですか?
はい。それぞれ役割が異なるためです。Googleのドキュメントでは、両方を提供することで掲載対象が最大化され、相互検証も可能になるとされています。価格、在庫状況、タイトル、バリエーションは完全に一致させ、マークアップはサーバーが返すHTML内に保持してください。
データを整備すれば、AIに商品を推薦してもらえますか?
いいえ。データを整備することで商品は読み取りやすく比較しやすくなりますが、関連性、文脈、その他のシグナルも依然として重要です。ただし、見落とされる原因のうち、回避可能なものは取り除けます。そして、それらは多くの場合、最も低コストで修正できます。
参考情報
- AIショッピングディスカバリー:商品データが重要な理由
- AIが商品を見つけられない理由:商品データ品質
- AIショッピング対応:推薦のための商品データ
- 商品データ仕様 - Google Merchant Center ヘルプ
- AIショッピングとAI検索向けの商品フィード最適化
- OpenAI 商品フィード仕様
- AIショッピング向け商品データ:ショッピングエージェントへの備え方
- AIショッピングエージェント向けの商品情報構造化方法
- Googleの商品構造化データ入門
- Merchant Center向け構造化データの設定
- AIエージェント向け構造化データ:schema.org、JSON-LD、UCP
- 商品構造化データとフィードの比較
- 構造化データマークアップ解説
関連トピックを確認