

現在商品を推奨しているAIシステムは、4つの層から情報を取り込んでいます。加盟店のフィードとAPI、商品ページ上の構造化データ、小売業者およびマーケットプレイスの商品情報、そしてレビューとファーストパーティの購買行動データです。加盟店が直ちに優先すべきことは3つあります。安定したIDを持つ正規カタログ、厳密に同期された価格と在庫状況、そして属性が充実した明確な商品説明です。その後、プロンプトベースのテストによって、そうした修正が実際にAIエージェントの推奨内容を変えるかどうかを確認できます。
要点:
- 加盟店のフィードには、安定したID、同期された価格、豊富な商品属性を含める必要があります。これにより、推奨時の不整合を防ぎ、AIの信頼を高められます。
- 構造化データのマークアップは、サーバーサイドでレンダリングされ、最新の状態に保たれ、表示されているページ内容と一致している必要があります。これにより、AIが正確に理解できます。
- ショッピングプロンプトと実際のAIシミュレーションによる定期的なテストは、商品データや説明が原因で推奨に失敗している箇所の特定に役立ちます。
- 単一の信頼できる情報源を維持し、常にフィード、ページ、購入手続きのデータを一致させることで、古い情報や不一致による推奨低下を最小限に抑えられます。
- ファーストパーティの行動シグナルやレビューシグナルはパーソナライズを支えますが、在庫状況や価格のような中核となる商品情報を上書きすることはできません。そうした情報には、信頼できるフィードデータが必要です。
概要:AIショッピングエージェントが取り込む商品情報の事実レイヤー
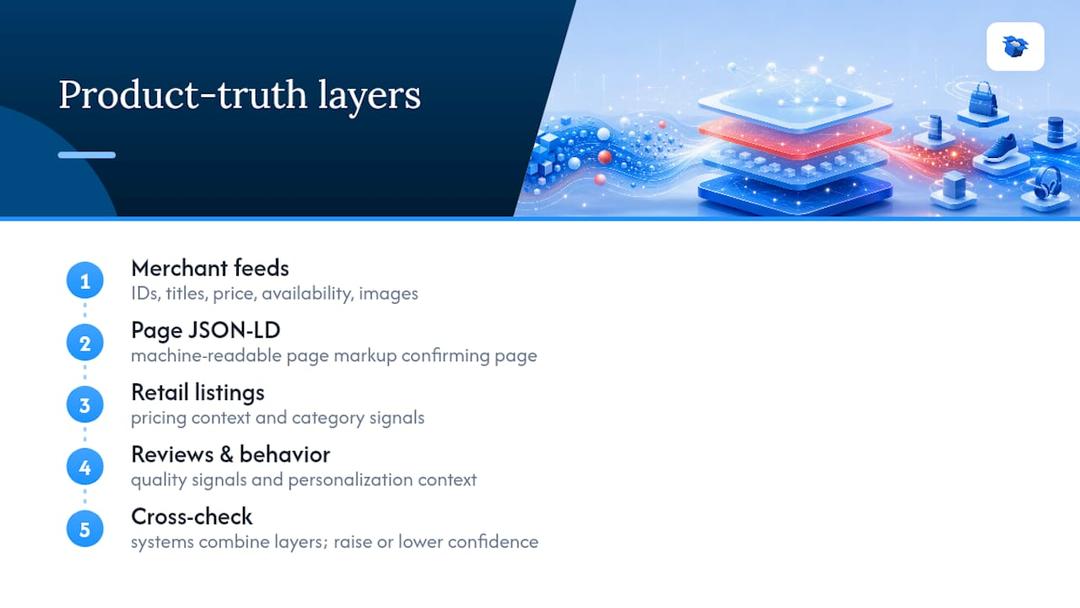
AIショッピングエージェントは、買い物客のように商品ページを見ることはありません。見るのはつぎはぎのレコード群で、そのどれを信頼するかを判断しなければなりません。各レイヤーは、事実の異なる一面を提供します。
マーチャントのフィードとAPI は、基盤となるデータを担います。安定した識別子、タイトル、説明、価格、通貨、在庫状況、バリエーション、画像、販売者情報です。これは OpenAI のコマース仕様 が、ChatGPT内の商品に関する事実の一次ソースとして扱うレイヤーです。
商品ページの構造化データ (JSON-LD マークアップ)は、ページにすでに表示されている内容を、クローラーが読み取れる形で提供します。フィードの記載内容を、別の情報から裏付ける役割を果たします。
小売業者やマーケットプレイスの商品掲載情報 は、特に同じ商品が複数チャネルに出ている場合に、価格の文脈やカテゴリシグナルを補います。
レビューとファーストパーティの行動データ は、品質シグナルやパーソナライズの文脈を加えて全体像を補完しますが、在庫状況のような確定的な事実の代わりには決してなりません。
商品を推奨するシステムは、4つすべてのレイヤーを組み合わせて相互照合します。フィードでは「在庫あり」なのにページのマークアップでは「在庫切れ」になっている場合、その不一致は単にアルゴリズムを混乱させるだけではありません。商品レコード全体への信頼も低下させます。 Googleの商品データ仕様によると.
マーチャントが守るべき商品フィードとAPIのベストプラクティス
管理できる資産の中で最もレバレッジが高いのはフィードであり、必要なのは曖昧な網羅性ではなく、具体的な項目です。
- 中核となる識別項目を含める:安定したidまたはSKU、タイトル、説明、正規リンク、画像URL、価格、通貨、在庫状況、バリエーション属性、ブランド。
- OpenAIのフラットファイルスキーマに合わせる ことが、ChatGPT の掲載対象になるための要件です。Agentic Commerce の商品仕様では、少なくとも id、title、description、link、image_link、availability、price、brand が必要です。
- 適格性フラグは意図して設定します。
is_eligible_searchとis_eligible_checkoutは別々のスイッチです。商品レコードがどれほど完全でも、これらのフラグが設定されていなければChatGPTには表示されません。 - Google Merchant Centerの中核要件に合わせる:安定した商品ID、機能するランディングページリンク、正確な価格と在庫状況、そして正しいカテゴリ項目と識別子項目です。
- フィードの値は、ランディングページおよび購入手続きの値と完全に一致させます。 ここでの不一致は、非承認や気づかれないまま起きる推奨機会の損失の最も一般的な原因の1つです。
実務ヒント: 毎週、無作為に選んだ20件のSKUについて、フィード、商品ページ、購入手続きを突き合わせてスポットチェックしてください。フィードのずれの多くは、価格更新や在庫同期が1回ずつ積み重なる中で静かに発生し、AIショッピングエージェントが買い物客に誤った価格を提示するまで誰も気づきません。
更新頻度について:変動の大きいカテゴリ(再入荷が多いアパレル、価格が動的な家電など)では、当日中または毎時の更新が必要です。動きの遅いカテゴリは日次同期でも許容できますが、それより長くしてはいけません。
商品ページの構造化データ:Schema.org項目とよくある落とし穴
構造化データは、使ってほしい正確な事実を、AIシステムが推測せずに済む形式で渡す方法です。
あらゆる商品ページに必要なSchema.orgプロパティは次のとおりです。
Productに、name、description、image を含めるOfferをネストし、その中にprice,priceCurrency、およびavailabilitygtin(または適切なGTINバリアント)を含め、グローバルな商品識別に使うskuを内部識別子として使うitem_group_idで、同じ商品のバリエーション同士を関連付ける
Googleのサポート対象構造化データ属性に関するガイダンスでは、このマークアップはJavaScriptがクライアント側で実行された後にだけ挿入するのではなく、サーバーでレンダリングされたHTML内に存在しなければならないと明確に示されています。多くのクローラーやエージェントはJavaScriptをまったく実行しないため、JSだけのマークアップは事実上見えません。
最もよくある落とし穴は、マークアップ自体が欠けていることではありません。以前は正しかったマークアップが、通常は価格変更やフロントエンド表示だけを更新した販促差し替えの後で、可視ページとの同期から静かにずれてしまうことです。
実務のヒント: schema バリデーターを通過しても、構文に問題がないと分かるだけです。AI が実際に商品を正しく説明できるかどうかは分かりません。バリデーターでの確認に加えて、実際のプロンプト監査を行い、その SKU がどう説明されるかを確認してください。
レビュー、販売者シグナル、ファーストパーティの行動データ
レビューと行動データは、AI システムがレコメンドをどうパーソナライズするかに影響しますが、土台ではなく補助的な役割です。
- レビューは、品質評価や用途の根拠を示し、エージェントが どの 在庫のある商品が、購入者の明示したニーズに合っているかを判断する助けになります。
- 同意を得て自社で収集した行動データを使うと、プラットフォームは、状況、購入履歴、閲覧パターンに合わせて推薦を調整できます。これを示しているのが、次の調査です: Klaviyo の AI と消費者行動に関する調査.
- どちらのデータタイプも安定した SKU 識別子に結び付いている必要があります。そうでないと、レビューの根拠と現在の商品情報が時間とともにずれていきます。
- レビューや行動シグナルが、正規の価格フィードや在庫フィードを上書きしてはいけません。星5のレビューで「お買い得」とされていても、フィードで在庫切れになっているなら、優先されるのはフィードです。
鮮度・同期・同一性: レコメンド機会の損失を避けるためのルール
古い価格データや在庫データは、購入者をいら立たせるだけではありません。AI システムは誤った回答のリスクを避けるため、その SKU のレコメンド自体を静かにやめてしまいます。
- フィード、構造化データ、ランディングページ、購入手続きの値は常に一致させる Google の Merchant Center のガイダンスによると、不一致があると、承認されなかったり、表示機会を失ったりするリスクが高まります。
- 運用中の SKU を途中で改名・再発行しない 同一性のずれ、つまりサイト刷新やカタログ移行の際に識別子を変更してしまうことは、商品の価格履歴、レビュー、現在の商品情報のつながりを断ってしまう、最もよくある原因の1つです。
- モデルバリエーションを明示する には
item_group_idを使い、色やサイズの違いを分断された別商品として存在させないようにします。 - 更新頻度は変動性に合わせて設定する 変動の速い在庫は毎時の確認が必要です。安定したカタログ商品なら日次サイクルで運用できます。
- 正常系だけでなく例外ケースもテストする 予約注文、取り寄せ、在庫切れの状態も、通常の在庫あり商品情報と同じ厳密さで検証する必要があります。
実務のヒント: フィード価格とページ価格の不一致が2時間を超えた SKU を検知する小さなダッシュボードを作ってください。この差は、上流のどこかで問題が起きた最初の兆候であることがほとんどです。
テストと測定: プロンプト、シミュレーション、トラフィック帰属
schema バリデーターがグリーンで通っても、実際の購入者が質問したときに ChatGPT や Gemini が商品を本当に推薦するかどうかは分かりません。このギャップがあるため、テストには基盤となるデータ構造だけでなく、AI の実際の出力も含める必要があります。
- 代表的なプロンプトセットを作成する カテゴリープロンプト(「扁平足向けのおすすめランニングシューズ」)、用途別プロンプト、予算制約付きプロンプト、競合商品との直接比較プロンプトを含めてください。
- エージェントのシミュレーションでプロンプトを実行する そして、自社 SKU が言及されるか、提示価格が実際と一致しているか、説明の切り口が購入者の明示したニーズに合っているかを記録してください。
- AI 経由トラフィックを分析でタグ付けする そして、オーガニック流入や広告流入とは分けてコンバージョン率を追跡してください。
- 定期的に再スキャンする レコメンドはプロンプト、市場、在庫状況によって変わるため、今日の良い結果1件が来週も同じ結果になる保証にはなりません。
AI から好意的な回答を一件得ただけでは、順位レポートにはなりません。結果は、プロンプトの言い回し、言語、市場、現在の在庫によって変わります。だからこそ、 NIQ の AI 活用ショッピングに関する分析 では、戦略上の本当の変化を、検索シェアから推薦シェアへの移行と捉えています。これは、一度で済ませず、繰り返し測定する必要があります。
実行チェックリスト: 今後 7〜30 日で優先すべき対応
- 安定した ID を基準にカタログを点検する そして、壊れている、または重複しているバリエーション関係を修正してください。
- フィード、ページ、購入手続きの値を同期する 対象は価格、通貨、在庫状況です。
- JSON-LD マークアップを修正する サーバーサイドでレンダリングされ、可視ページの内容と一致するようにしてください。
- 情報の薄い商品説明を充実させる 具体的な属性情報と用途表現を加えてください。
- 基本的なシミュレーションテストを実施する 上位20件のSKUを対象に、現在のAIレコメンド挙動を確認してください。
| タスク | 主な担当者 | 成功指標 |
|---|---|---|
| 安定IDの監査 | カタログ管理者 | 重複または名称変更されたSKUがゼロ |
| フィード・ページ・決済の同期 | 開発担当 | 価格・在庫一致率 |
| JSON-LD修正 | 開発担当 | マークアップが表示ページと一致 |
| 説明文の強化 | カタログ管理者 | SKUごとの属性情報の充実度 |
| シミュレーションテスト | マーケティング/EC責任者 | プロンプト群全体でのSKU言及率 |
AIシステムにおける適格性制御と商品情報の使い分け
完全かつ正確な商品情報と、適格な商品であることは別物であり、多くのマーチャントがこの2つを混同しています。
商品情報、価格、在庫状況、画像、説明文は、「この商品は何か、そして現時点で原則として販売可能か」という問いに答えるものです。一方で適格性フラグは、より限定的で別の問いに答えます。「この特定のシステムが、この特定の商品を今表示または取引すべきか」です。OpenAIのAgentic Commerceドキュメントでは、これらを意図的に区別しており、 is_eligible_search は表示可能性を制御し、 is_eligible_checkout はエージェント内で実際に取引を完了できるかを制御します。
この違いは、多くのマーチャントが「フィードを修正すれば表示も自動的に改善される」と考えてしまう原因になっています。しかし実際にはそうではありません。データが完璧でも、適格性フラグが未設定または誤設定であれば、その商品は表示されません。商品情報がどれほど優れていても同じです。逆もまた然りで、技術的には適格でも説明が不十分な商品は、比較時にほとんど表示されなかったり、すぐ除外されたりします。
実務上重要なのは、適格性の確認をデータ品質レビューとは別のチェック項目として扱うことです。クリーンなカタログなら自動的に満たされる前提ではなく、明示的に確認すべきゲートとして扱ってください。複数市場で運営するマーチャントは、市場ごとに適格性フラグを確認する必要があります。ある地域向けフィード送信で正しく設定されたフラグが、同じカタログを配信している他地域にも自動適用されるとは限りません。
AIとショッピングデータソースにおけるプライバシーとデータコンプライアンスの考慮事項
ファーストパーティの行動データは、AIショッピングシステムが利用できるパーソナライズ入力の中でも特に価値が高く、同時に法的な機微性も最も高いデータです。
基盤となるのは同意です。行動シグナル、閲覧履歴、購入パターン、サイト内行動は、利用者がその用途に実際に同意した場合にのみパーソナライズモデルへ利用できます。また、適用ルールは法域ごとに異なります(EUのデータ保護制度、米国州法のプライバシー法など、それぞれ独自の基準があります)。複数市場で運営するマーチャントは、単一の包括的ポリシーを適用するのではなく、どの顧客セグメントにどの同意基準が適用されるかを把握する必要があります。
データ最小化も重要です。パーソナライズ用途で実際に必要な範囲を超えて行動データをAIシステムへ投入しても、レコメンド品質が大幅に向上するわけではありません。単にコンプライアンス上のリスクが増えるだけです。同じ考え方はレビュー情報にも当てはまります。レビュー由来のシグナルをレコメンドパイプラインへ投入する前に集約・匿名化することで、有用性を大きく損なわずにリスクを低減できます。
サードパーティへのデータ共有には特に慎重な確認が必要です。フィードやAPIによって外部AIプラットフォームへ顧客データを送信する場合、その転送自体が、プラットフォームや法域によっては開示義務や契約要件の対象になる可能性があります。マーチャントは、新しいAIショッピングプラットフォームとの連携を、新しい決済代行サービス導入と同じように扱うべきです。ローンチ後ではなく、事前にデータ共有レビューを実施してください。
AIショッピングモデルで複数データソースを組み合わせる際の統合課題
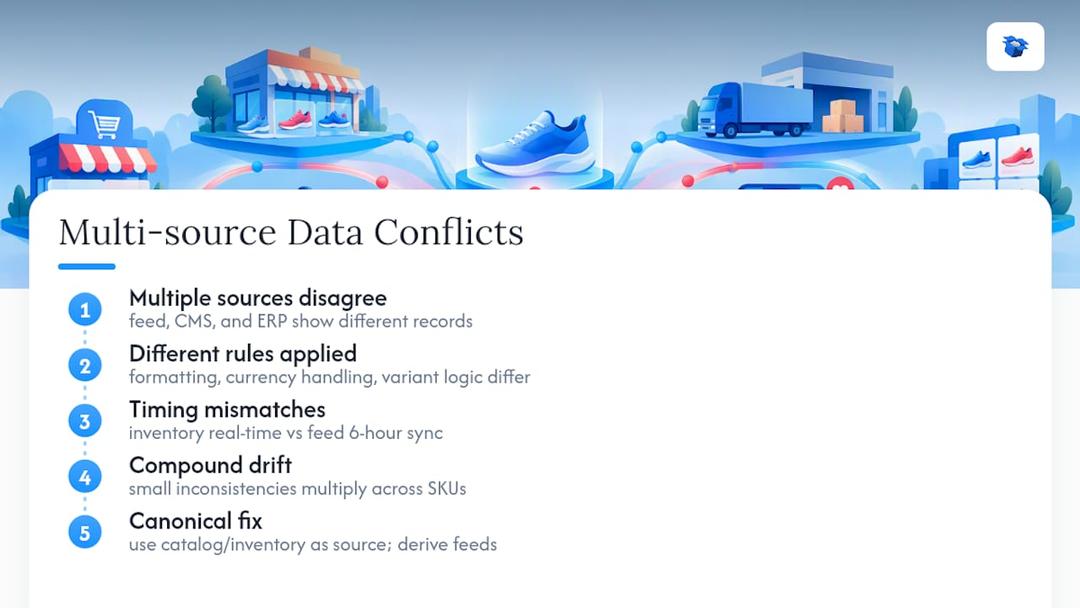
どのマーチャントも最終的には同じ壁に突き当たります。フィードではある内容になっていても、CMSでは別の内容になっており、ERPシステムはその両方と食い違っている、という状況です。
本質的な課題はデータ収集ではありません。目的ごとに構築され、そもそも整合する前提で設計されていないレコード同士を整合させることです。Google Shopping向けフィードとAIコマースプラットフォーム向けフィードは、同じ元データベースを参照していても、フォーマットルール、通貨処理、バリエーションのグルーピングロジックが異なる場合があります。こうした小さな不整合は、数千SKU規模のカタログでは急速に積み重なります。
タイミングのずれによって問題はさらに深刻になります。在庫システムがリアルタイム更新でも、フィード同期が6時間ごとであれば、その間AIエージェントはすでに誤ったデータを基に動作することになります。Googleの構造化データと自動更新に関するガイダンスは明確です。鮮度は必須であり、システム間で更新タイミングが一致していないことが、商品情報に対するAIの信頼を損なう原因になります。
実務的な解決策は、通常は在庫管理またはカタログ管理システムを唯一の正規データソースとして定義し、下流のすべてのフィードを独立管理されたレコードではなく派生出力として扱うことです。元システムを更新せずにフィードファイルだけを手動編集すると、後から追跡がほぼ不可能なデータ乖離が発生します。ShopifyやWooCommerceで複数販売チャネルを運営している場合は、システム同期を前提にする前に、価格と在庫データが実際に何カ所で管理されているか監査してください。
サードパーティ集約データプロバイダーの役割と信頼性
複数小売業者の商品データを収集し、単一フィードへ正規化するアグリゲーターは、AIショッピングエコシステムで実際に重要な役割を果たしています。ただし、その信頼性は多くのマーチャントが想定する以上にばらつきがあります。
魅力は明快です。チャネルごとに別々のフィードを維持する代わりに、1つのフィードをアグリゲーターへ送信し、正規化データを各チャネルへ再配信してもらえます。ただし、正規化は翻訳プロセスであり、翻訳には常に誤りの可能性が伴います。自社側での価格更新が、直接フィードよりもアグリゲーター経由では反映に時間がかかる場合があり、その遅延こそがAIレコメンドの信頼性を損なう典型的な鮮度低下です。
信頼性は、アグリゲーター自体が元データとどの頻度で再同期するかにも大きく左右されます。しかし、その更新頻度はマーチャント側から常に見えるわけではありません。AIショッピングでの表示性向上を目的にアグリゲーターを主要配信チャネルとして利用する前に、「リアルタイム同期」というマーケティング表現だけでなく、自社の商品変動頻度に見合った更新頻度か確認する価値があります。
より安全なのは、アグリゲーター配信データを、自社の直接フィードやページマークアップと整合すべき二次チャネルとして扱うことです。それらを維持する代替手段として考えるべきではありません。3者間で不一致がある場合、AIシステムが最も信頼しにくいのはアグリゲーター側の情報です。元データソースから最も離れているためです。
ショッピングシナリオにおけるAIレコメンドへのデータ品質の影響
データ品質は、AIシステムが商品を見つけられるかだけに影響するわけではありません。競合の商品情報より優先してレコメンドするだけの信頼を、そのシステムが持てるかを左右します。
商品は、技術的には発見可能で、インデックスされ、フィード適格で、構造的にも有効であっても、属性情報の不足、バリエーションの曖昧さ、価格情報の陳腐化によって、レコメンド機会を失うことがあります。OpenAIのcommerce specもこの点を明確に示しています。データ妥当性の測定だけでは不十分であり、実際のレコメンド結果は、単純なスキーマ検証で予測される内容と乖離する場合があります。
情報源ごとに記録が矛盾していると、問題はさらに大きくなります。フィード、ページのマークアップ、小売店の商品情報が同じ商品を少しずつ違う形で説明していても、AI システムはその差を平均化しません。不一致を信頼できないという兆候として扱い、その SKU に関連するすべての項目への全体的な信頼度を下げます。Google の Merchant Center の仕様が情報源間の一貫性を重視していることも、実質的にこれを裏付けています。
ここで重要なのは、こうした影響が積み重なることです。1つの弱い属性項目だけで商品情報全体が大きく不利になることは通常ありません。しかし、古い価格情報、欠落したバリエーション属性、主要用途に触れていない説明文など、小さな不整合が多数あるカタログは、AIシステムが優先度を下げるパターンとして学習していきます。データ品質の改善は一度きりのクリーンアップ作業ではありません。維持を続けるほど効果が積み上がる継続的な運用です。
パブリッシャー視点: なぜシミュレーションは単純な検証より有効なのか
スキーマバリデーターは構文を確認できます。しかし、購入者が実際に尋ねた属性情報が説明文の奥に埋もれているために、AIエージェントが商品をスキップしていることまでは分かりません。シミュレーションはそのギャップを可視化し、診断、書き換え、公開、再テストのループによって、静的監査よりも迅速に改善できます。このサイクルを継続的に回しているマーチャントは、データのずれ、価格不一致、情報不足の説明文、曖昧なバリエーションを、シーズン単位のレコメンド損失が発生した後ではなく、その前に検知する傾向があります。
— Xhurian
ecenticがデータ修正をAIレコメンド獲得につなげる方法
ChatGPT、Gemini、Perplexityが現在のカタログに実際どう反応しているかを確認できなければ、フィードやマークアップを個別に修正しても推測に過ぎません。一部のプラットフォームはこのループを閉じています。実際のショッピングプロンプトを使ってストアをシミュレーションし、どこで競合商品に勝ち、どこで負けているかを平易な言葉で表示し、その修正をワンクリックでShopifyやWooCommerceへ反映できます。

UCP Playgroundでは、書き換えに着手する前に任意のストアをAIショッピングエージェントでテストできるため、推測ではなく、どのSKUに対応が必要か把握できます。課題を確認した後は、ecenticの 商品情報最適化ツール が修正内容を生成して公開し、その後再スキャンしてレコメンド率が実際に改善したか確認できます。
まずは無料スキャンで現在のカタログ状況を確認し、その後 料金ページでプランを比較してください。各種サブスクリプションオプションに加え、AI経由注文ごとの成果報酬手数料も掲載されています。
次に参照すべき主要仕様とドキュメント
このガイドを超える実装詳細については、一次情報を直接確認してください。OpenAIのAgentic Commerce specではフィード構造と適格性を扱い、Googleの構造化データガイダンスでは、商品発見の精度を高めるためのマークアップ検証と必須プロパティを解説しています。
参考資料
画像や自由記述の説明文には、AIシステムが利用する実際の情報が含まれています。しかし、それらは構造化された価格項目より検証が難しく、そのギャップがマーチャントが見落としがちな盲点を生みます。
商品画像は単なる装飾ではありません。マルチモーダルAIシステムは、構造化属性項目が欠落または不完全な場合、画像から直接属性を抽出できます。色、素材感、フレーム内の他オブジェクトとの相対サイズなどです。これは便利ですが、同時に低品質または汎用的なストック画像が、明確なテキスト属性の方が信頼できた場面で、曖昧または誤解を招く視覚シグナルを供給し、逆効果になる可能性も意味します。
自由記述の説明文にも、逆の方向で同じようなリスクがあります。属性を明確に書くよりも SEO キーワードの密度を重視した説明文、たとえば「高品質、クラス最高、驚くほどお得」といった文章からは、AI システムが抽出できる具体的な情報はほとんど得られません。一方、素材、寸法、具体的な用途を明記した説明文なら、それを裏付ける構造化項目が一つもなくても、十分な情報を渡せます。
実務的には、非構造化コンテンツは構造化データを補完するものとして扱い、置き換えには使わないことです。説明文では具体的な属性を平易な言葉で記載し、カテゴリ上重要な属性が明確に分かる画像を使用してください。家具ならサイズ感、布製品なら質感、電子機器ならスケール感です。構造化項目が存在する場合は、テキストや画像内容がそれらと矛盾しないよう確認してください。
FAQ
商品フィードと構造化データマークアップの両方が必要ですか?
はい。フィードと構造化データは異なるシステム向けに機能し、相互検証の役割も果たします。どちらか一方だけに依存すると、AIエージェントが不整合と判断する余地が残ります。Googleの商品データ仕様では、両者間で値が一致していることを、任意ではなく基本要件として扱っています。
価格と在庫データはどのくらいの頻度で更新すべきですか?
更新頻度は、データの変動の大きさに合わせてください。在庫の動きが速い商品は毎時または当日中に、安定した商品でも少なくとも毎日更新します。Google の Merchant Center のガイダンスによると、古い値は、AI の推薦を逃す特に一般的な原因です。
レビューは正確なフィードデータの代わりになりますか?
いいえ。レビューは品質や用途に関する根拠を提供しますが、正確な価格や在庫データの代替にはなりません。レビューシグナルがどれほど強くても、それらは引き続きフィード側の役割です。
AIエージェントが実際に自社商品をどうレコメンドしているか、どうテストすればよいですか?
カテゴリ、予算、比較シナリオを含む代表的なショッピングプロンプト群を作成し、ecenticのUCP Playgroundのようなエージェントシミュレーションで実行してください。SKUの言及状況や価格精度を直接確認できます。
小規模ECストア向けのecenticの料金はいくらですか?
ecenticのCompeteプランは月額$14.90から、Scaleは$44.90、Dominateは$149です。加えて、AI経由注文ごとに3%の従量課金オプションもあり、すべて料金ページに掲載されています。
関連トピックを確認