

La parité des prix sur tous les canaux de vente, des prix plancher ajustés aux seuils et des données produit complètes et lisibles par l’IA sont les trois leviers qui font le plus sûrement entrer vos SKU dans les recommandations des agents d’achat IA. Maîtrisez les trois et vous entrez dans la grille d’évaluation. Omettez-en un seul et vous êtes écarté avant même que l’agent ne vous compare à un concurrent.
Les trois actions immédiates :
- Imposer la parité des prix sur votre boutique Shopify ou WooCommerce, votre flux Google Shopping et toutes vos fiches sur les marketplaces. L’incohérence des prix entre les canaux peut réduire les taux de finalisation d’achat d’environ 23 %.
- Définir des prix plancher ajustés aux seuils pour que vos SKU passent juste sous les filtres de requête courants (« moins de $50 », « moins de $100 ») au lieu de les dépasser d’un dollar.
- Publier des données produit structurées et complètes (JSON-LD, champs d’attributs complets, titres propres) afin que les agents puissent tout simplement évaluer votre fiche produit.
Points clés à retenir
La parité des prix, des prix plancher ajustés aux seuils et des données structurées complètes sont les trois fondations non négociables pour faire entrer vos SKU dans les recommandations des agents d’achat IA.
| Point | Détails |
|---|---|
| Imposer d’abord la parité des prix | L’incohérence des prix entre les canaux réduit la finalisation des achats d’environ 23 %, selon l’analyse de marchands sur Perplexity. |
| Définir des prix plancher ajustés aux seuils | Positionnez le prix juste sous les filtres de requête courants (« moins de $50 ») afin que les agents incluent votre SKU au lieu de l’exclure. |
| Publier des données structurées complètes | Le JSON-LD et des champs d’attributs complets sont des critères préalables ; avec des données manquantes, les agents omettent souvent complètement d’évaluer votre fiche produit. |
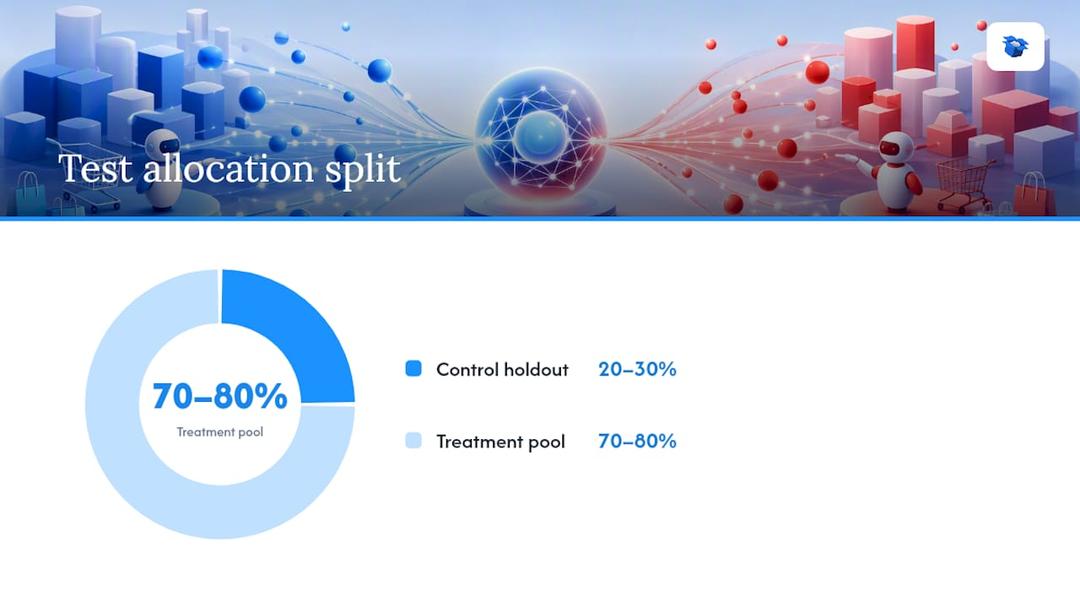
| Tester une seule variable à la fois | Menez des tests randomisés sur des ensembles de choix pendant au moins deux semaines avec un groupe témoin de 20 % à 30 % afin d’isoler les effets dus aux agents. |
| Utiliser ecentic pour un suivi continu | ecentic simule l’évaluation des agents sur ChatGPT, Gemini, Claude et Perplexity, puis relance automatiquement une analyse après toute modification de fiche produit. |
Que requiert réellement la tarification pour les agents IA ?
Cette checklist couvre les leviers qui influencent la sélection par les agents. Indiquez pour chacun s’il est terminé, en cours ou non commencé, puis avancez de haut en bas.
Gains rapides (de quelques minutes à quelques heures) :
- Vérification de la parité tarifaire. Récupérez votre prix en direct depuis votre boutique en ligne, votre flux Google Shopping et toute place de marché active. S’ils diffèrent, corrigez d’abord le flux.
- Audit des seuils planchers. Identifiez les filtres de prix les plus courants dans votre catégorie (« moins de 30 $ », « moins de 75 $ », « moins de 150 $ »). Positionnez votre prix au niveau de chaque seuil pertinent ou juste en dessous, jamais au-dessus.
- Note supérieure à 4,0 étoiles. Les agents accordent un poids important aux notes. Si votre moyenne est inférieure à 4,0, donnez la priorité à la collecte d’avis avant tout autre travail sur la fiche produit.
- Seuil minimal de volume d’avis. Un faible nombre d’avis nuit à la probabilité de sélection. Même passer de 3 à 25 avis produit un gain mesurable dans les expériences d’évaluation par les agents.
- Exhaustivité du titre. Incluez la marque, le modèle, la caractéristique clé et le principal cas d’usage dans le titre du produit. Les agents analysent les titres comme des signaux structurés.
Nécessite des outils ou de l’automatisation (de quelques jours à quelques semaines) :
- Balise JSON-LD sur chaque page produit. Sans elle, de nombreux agents ne peuvent pas évaluer votre fiche produit.
- Visibilité des mentions et des badges. « Overall Pick », « Best Seller » et les mentions similaires créent une marge de manœuvre sur le prix. Faites-les remonter dans votre flux et dans le balisage de la page.
- Suivi continu de la parité. Les vérifications manuelles dérivent avec le temps. Mettez en place une comparaison automatisée des flux ou utilisez une plateforme qui relance des analyses à intervalles réguliers.
- Suivi de l’attribution aux agents. Vous ne pouvez pas optimiser ce que vous ne pouvez pas mesurer. Instrumentez votre boutique pour distinguer le trafic généré par les agents du trafic organique et payant.
Conseil de pro : Fixez votre prix plancher à $X.99, juste sous le seuil, et non au seuil lui-même. Un agent qui filtre sur « moins de $50 » inclura un SKU à $49.99 et exclura un SKU à $50.00. Une logique fondée uniquement sur le coût majoré vous placera du mauvais côté de ce filtre plus souvent que vous ne l’imaginez.
Comment les agents IA évaluent-ils réellement vos produits ?
Les agents ne naviguent pas comme les humains. Ils appliquent des grilles d’évaluation structurées aux attributs extraits de votre flux et du balisage de vos pages, puis classent les candidats à l’aide d’un modèle proche d’un modèle d’utilité pondérée. Les recherches de Columbia Business School confirment que différents modèles d’agents accordent des poids différents aux mêmes attributs, ce qui signifie qu’optimiser pour un seul agent en ignorant les autres constitue un risque réel.
Le prix a un poids négatif dans tous les modèles testés. Les notes et le nombre d’avis ont un poids positif. La position dans l’ensemble de résultats et les mentions de recommandation ajoutent de l’utilité, ce qui peut compenser un prix plus élevé.
Constat clé : Les expériences randomisées ACES rapportent des estimations d’élasticité-prix allant approximativement de −1.6 à −2.8 selon les modèles d’agents et les cohortes de produits. À conditions égales par ailleurs, une hausse de prix de 10 % réduit la probabilité de sélection de 16 % à 28 % selon le modèle.
| Attribut | Effet directionnel sur la sélection | Source des données à l’appui |
|---|---|---|
| Prix | Négatif (fort) | Expériences ACES / arXiv |
| Note par étoiles | Positif (fort) | Expériences ACES / arXiv |
| Nombre d'avis | Positif (modéré) | Expériences ACES / arXiv |
| Position dans les résultats | Positif (dépend du modèle, important) | Columbia Business School |
| Tag de recommandation (« Overall Pick ») | Positif (très important, dépend du modèle) | Expériences ACES / arXiv |
| Exhaustivité des données structurées | Condition bloquante (requise pour être évalué) | Synthèse pratique d'AgentMint |
Les travaux de Columbia montrent clairement une chose : les agents s'appuient d'abord sur l'exhaustivité des données avant de prendre le prix en compte. Une fiche produit à laquelle il manque des attributs n'est pas moins bien évaluée. Bien souvent, elle n'est tout simplement pas évaluée du tout.
Le plan d'action tarifaire : sept tactiques classées par impact
Commencez par la parité. Tout le reste passe au second plan tant que vos prix ne sont pas alignés sur tous les canaux.
Tactiques prioritaires :
- Appliquez d'abord la parité de prix entre les canaux. Une analyse marchande de Perplexity a constaté que les incohérences de prix entre une boutique DTC, Google Shopping et des fiches produit sur les marketplaces font baisser le taux de finalisation d'achat d'environ 23 %. Corrigez cela avant tout autre travail sur les prix.
- Définissez des prix planchers tenant compte des seuils. Repérez les filtres de requête les plus courants dans votre catégorie et positionnez votre prix juste en dessous de chacun. Il ne s'agit pas de faire une remise. Il s'agit de rester dans le filtre.
- Utilisez des labels de recommandation pour gagner de la marge de manœuvre sur le prix. Les expériences ACES montrent que des labels de type « Overall Pick » créent une marge de manœuvre estimée très importante sur le prix, suffisante dans certains modèles pour compenser un écart de prix significatif par rapport à des concurrents sans label. Faites remonter chaque badge obtenu dans le balisage de votre flux.
- Utilisez les offres groupées comme ancrage. Une offre groupée à 89 $ placée à côté d'un produit vendu seul à 59 $ fait apparaître le produit vendu seul comme une bonne affaire pour un agent qui analyse la valeur relative. Les agents lisent les signaux d'ancrage dans les données structurées.
- Lancez des promotions limitées dans le temps, calées sur les fenêtres de requête des agents. Les agents interrogés pendant les pics d'achat accordent plus de poids à la récence des changements de prix. Une remise temporaire active au moment où l'agent scanne est plus performante qu'un prix permanent fixé il y a six mois.
- Ne vous repositionnez durablement que si l'élasticité le justifie. Utilisez la plage d'élasticité de −1.6 à −2.8 comme donnée de planification. Si une baisse de prix de 10 % génère moins de 16 % de hausse de sélection dans votre catégorie, le sacrifice de marge n'en vaut pas la peine.
- Appliquez une révision des prix pilotée par des agents IA avec des garde-fous. La révision autonome des prix peut réagir plus vite que des règles manuelles, mais elle exige des données propres sur les concurrents et les stocks. Définissez des planchers de marge stricts avant d'activer toute tarification dynamique automatisée.
C'est une vraie marge de manœuvre, même si la fourchette est large et dépend du modèle.
Comment tester des ajustements de prix face aux agents IA
Menez des tests randomisés sur des ensembles de choix. Présentez aux agents des ensembles de produits miroirs dans lesquels seule la variable testée change (prix, badge, description), puis mesurez le taux de sélection, le taux de conversion et les commandes attribuées à l'IA.
Plan de test numéroté :
- Définissez une seule variable par test. Prix, tag de recommandation ou réécriture de la description. N'en modifiez jamais deux à la fois.
- Constituez un groupe témoin. Conservez 20 % à 30 % des SKU au prix de contrôle afin de disposer d’une base de référence fiable.
- Exécutez le test pendant au moins deux semaines complètes. Des périodes plus courtes sont trop sensibles aux variations selon les jours de la semaine et au bruit promotionnel.
- Randomisez au niveau du SKU, et non au niveau de la catégorie, afin d’éviter les biais liés au positionnement.
- Mettez en place le suivi d’attribution des agents avant de commencer. Sans suivi du trafic des agents, vous mesurez la conversion totale, pas la conversion générée par les agents.
| Indicateur | Définition | Méthode de mesure |
|---|---|---|
| Taux de sélection par les agents | % de requêtes d’agents où votre SKU est sélectionné | Balises de champ UCP/profil + journaux d’attribution des agents |
| Taux de conversion des agents | Commandes issues de sessions référées par des agents / sessions d’agents | Paramètres UTM + source de référence des agents |
| Revenus attribués à l’IA | Revenus provenant de commandes confirmées générées par des agents | Tableau de bord d’attribution avec filtre par source d’agent |
| Marge de manœuvre tarifaire | Variation du taux de sélection par % de variation de prix | Modèle logit conditionnel sur les données du groupe de test |
Pièges fréquents : les changements de positionnement pendant un test faussent les résultats liés au prix. Les promotions saisonnières lancées en parallèle gonflent les conversions dans les deux groupes. Évitez de lancer des tests pendant les grands événements promotionnels.
Checklist d’implémentation pour Shopify et WooCommerce
Déployez un schéma produit lisible par l’IA, appliquez la parité des flux et activez les rescans continus. Voilà la version courte. Voici maintenant comment l’exécuter.
Jour 1 :
- Installez ou vérifiez un plugin de schéma JSON-LD. Sur Shopify, des applications comme Schema Plus ou TinySEO s’en chargent. Sur WooCommerce, Yoast SEO ou Rank Math génèrent automatiquement le schéma produit lorsqu’ils sont correctement configurés. Suivez la checklist des données structurées pour vérifier chaque champ requis.
- Contrôlez votre flux produit pour détecter les attributs manquants : GTIN, marque, état, disponibilité et prix. Les agents utilisent ces champs comme critères de filtrage.
- Configurez un système de surveillance de la parité des prix. Exportez vos prix actuels depuis Shopify ou WooCommerce et comparez-les à votre flux Google Shopping ainsi qu’à tous les flux marketplace actifs.
Semaine 1 :
- Renseignez les champs UCP (Universal Commerce Profile) si votre plateforme les prend en charge. Ces champs permettent aux agents de lire un contexte produit structuré au-delà du schéma standard.
- Ajoutez des balises de badge et de recommandation aux fiches produit. Si vous avez obtenu une distinction comme « Best Seller » ou « Overall Pick », elle doit apparaître dans vos données structurées, pas seulement visuellement sur la page.
- Connectez votre boutique à un système d’attribution des agents. Pour WooCommerce, l’intégration WooCommerce d’Ecentic gère la connexion des flux et la planification des rescans.
Mois 1 :
- Activez la surveillance automatisée de la parité avec des alertes en cas d’écart de prix au-delà d’un seuil défini (1 % à 2 % constitue un déclencheur raisonnable).
- Planifiez des rescans continus afin que les scores de vos fiches soient mis à jour après chaque modification de prix ou de description.
- Consultez les diagnostics IA des fiches produit pour identifier quels attributs pénalisent votre tableau de scores.
Que se passe-t-il lorsque les modèles d’agents sont mis à jour ?
Les mises à jour de modèles modifient la pondération des attributs. Un biais de positionnement favorisant les fiches placées en première position dans une version du modèle peut s’atténuer ou s’inverser dans la suivante. Les marchands qui ont fortement optimisé pour la pondération d’un seul modèle sans surveiller les autres sont ceux qui perdent de la visibilité du jour au lendemain.
Principaux risques à surveiller :
- Évolution des biais de positionnement. Les recherches de Columbia Business School documentent des effets de position importants et dépendants du modèle. Lorsqu’un modèle est mis à jour, la valeur de votre positionnement peut changer sans aucune action de votre part.
- Échecs de parité entraînant une suppression. Si votre prix sort de la parité après la fin d’une période promotionnelle, les agents peuvent rétrograder votre fiche ou l’exclure.
- Faux négatifs dus à de faibles écarts de prix. Un écart de 0,50 $ entre votre boutique et votre flux peut suffire à déclencher une alerte de parité dans certains modèles d’agents.
- Descriptions obsolètes. Les agents effectuent des rescans périodiques. Une description optimisée il y a six mois peut obtenir un score différent après une mise à jour du modèle modifiant l’interprétation des signaux textuels.
Checklist des alertes :
- Chaque semaine : vérifiez la parité des prix sur tous les canaux actifs.
- Toutes les deux semaines : exécutez une requête d’agent simulée sur vos 10 principaux SKU et comparez les taux de sélection à la période précédente.
- Chaque mois : analysez les données d’attribution des agents pour détecter les baisses inexpliquées des sessions référées par des agents.
- Après toute annonce de mise à jour de modèle : relancez votre suite complète de simulations avant de considérer vos scores comme stables.
Lorsqu’une mise à jour de modèle modifie le paysage concurrentiel, vous devez disposer d’une marge suffisante pour ajuster vos prix sans passer en négatif. Les marchands qui fixent des seuils minimums trop serrés se retrouvent incapables de réagir sans intervention manuelle.*
Quels résultats pouvez-vous attendre ?
Des résultats réalistes, pas garantis. C’est le bon cadre pour aborder le sujet.
Les expériences ACES montrent que les réécritures de descriptions et de titres produisent des gains à deux chiffres en part de sélection sur certaines combinaisons de catégories et de modèles, certaines modifications faisant progresser la part de plus de 30 points de pourcentage. Mais de nombreuses modifications ne produisent aucun effet mesurable. Les gains sont hétérogènes : ce qui fonctionne dans l’électronique grand public peut ne rien changer dans l’habillement.
Fourchette de référence : Les estimations d’élasticité-prix issues des expériences ACES vont de −1,6 à −2,8. Pour un marchand vendant à 45 $ dans une catégorie où l’élasticité est de −2,0, une baisse de prix de 5 $ (11 %) devrait augmenter la probabilité de sélection d’environ 22 %, toutes choses égales par ailleurs.
Ce que les données confirment réellement :
- L’application de la parité produit des gains constants et mesurables sur la finalisation des achats. Le chiffre de suppression de 23 % issu de l’analyse marchands de Perplexity est la donnée la plus claire de la littérature pratique.
- Les tags de recommandation créent une marge de manœuvre tarifaire qui peut être importante, mais son ampleur varie selon le modèle et la catégorie.
- L’exhaustivité des données structurées est un prérequis, pas un facteur de différenciation. Vous en avez besoin pour être compétitif, mais leur présence ne garantit pas la sélection.
- De nombreuses optimisations individuelles ne produisent aucun effet lorsqu’elles sont isolées. Cette méthode fonctionne comme un système, pas comme un ensemble de leviers indépendants.
Les résultats varient selon la catégorie, le modèle d’agent et l’intensité concurrentielle. Effectuez vos propres tests au lieu de supposer que les moyennes expérimentales s’appliquent à vos SKU spécifiques.
Comment nous abordons ce sujet chez ecentic
Les marchands qui tirent le plus de cette méthode sont ceux qui considèrent l’optimisation pour les agents comme un processus continu, et non comme une correction ponctuelle. Chez Ecentic, le moteur de simulation exécute des tests d’ensembles de choix sur ChatGPT, Gemini, Claude et Perplexity simultanément, afin que vous puissiez voir où vos fiches gagnent et où elles perdent avant qu’une véritable requête d’agent ne le fasse. Les rescans continus signifient qu’une modification de prix ou de description déclenche automatiquement un nouveau diagnostic. La combinaison simulation + surveillance de la parité + rescan automatique réduit le risque qu’une mise à jour de modèle efface des mois de travail d’optimisation. C’est cette boucle que la méthode ci-dessus vise à boucler.
Ecentic vous apporte la couche de simulation dont cette méthode a besoin
La plupart des marchands exécutent cette méthode manuellement : exportation des flux, vérification de la parité, réécriture des descriptions, puis espoir que les prochains exemples de sessions d’agents donnent de meilleurs résultats. Ecentic remplace cette approche approximative par un système structuré. Connectez votre boutique Shopify ou WooCommerce, et Ecentic simule comment ChatGPT, Gemini, Claude et Perplexity évaluent vos fiches en ce moment même, puis fournit des diagnostics clairs sur les éléments qui pénalisent votre tableau de scores.

La surveillance de la parité fonctionne en continu. Des réécritures de descriptions et de titres sont suggérées et peuvent être publiées en un clic. L’attribution des agents vous montre quels SKU sont réellement recommandés et achetés via des sessions d’agents. Pour les marchands qui ont lu cette méthode et souhaitent disposer de l’infrastructure de mesure nécessaire pour l’appliquer correctement, le scan produit gratuit est le moyen le plus rapide de voir où vous en êtes aujourd’hui.
FAQ
Comment les agents IA décident-ils quels produits recommander ?
Les agents évaluent les fiches à l’aide d’attributs structurés : prix, note étoilée, nombre d’avis, positionnement de la fiche et tags de recommandation. L’exhaustivité de votre flux produit est un prérequis ; des champs manquants signifient souvent que votre fiche n’est même pas évaluée.
Quelle est la plus grande erreur de tarification qui nuit aux recommandations des agents IA ?
L’incohérence des prix entre les canaux. Corrigez la parité avant toute autre optimisation tarifaire.
Quel impact le prix a-t-il sur la probabilité de sélection par les agents IA ?
Les expériences randomisées ACES rapportent des estimations d’élasticité-prix allant de −1,6 à −2,8 selon les modèles d’agents.
Des tags de recommandation comme « Overall Pick » peuvent-ils compenser un prix plus élevé ?
Oui, et de manière significative dans certains modèles. Les expériences ACES montrent que les tags de recommandation créent une marge de manœuvre tarifaire mesurable : un produit avec tag peut être vendu plus cher qu’un concurrent sans tag tout en restant sélectionné. L’ampleur de cet effet dépend du modèle.
Comment Ecentic aide-t-il les marchands à optimiser leurs performances auprès des agents d’achat IA ?
Ecentic simule comment ChatGPT, Gemini, Claude et Perplexity évaluent vos fiches, fournit des diagnostics clairs et effectue automatiquement des rescans après les changements de prix ou de description. La plateforme surveille également la parité des prix entre les canaux et prend en charge les mises à jour de fiches en un clic pour les boutiques Shopify et WooCommerce.