

Que les gens fassent une recherche sur Google, aillent sur Amazon ou interrogent un chatbot, l’IA leur renvoie une réponse avec un produit, et la plupart des marques e-commerce ne savent pas comment faire pour que ce soit leur produit qui soit choisi. L’attribution omnicanale par IA consiste à utiliser l’apprentissage automatique pour déterminer comment chaque canal, en ligne et hors ligne, a contribué à une commande. Elle nécessite des données de points de contact propres, quelques mois d’historique et un moyen de vérifier que ses réponses sont causales, et pas seulement plausibles.
Voici mon point de vue : l’attribution a toujours été un récit que les données produisent sur le passé, et l’IA rend surtout ce récit plus fluide. C’est utile, à condition de ne pas oublier qui l’a écrit. Entre-temps, un nouveau canal est apparu : celui où l’assistant d’un acheteur lit votre flux produit, choisit un produit et, parfois, l’achète. La plupart des tableaux de bord d’attribution n’ont aucune colonne pour cela.
TL;DR
- L’attribution omnicanale rassemble tous les points de contact, y compris les canaux hors ligne et vos propres canaux, dans une seule vue. L’attribution multicanale compare généralement les canaux numériques un par un.
- Les modèles d’IA ont besoin de données de points de contact et de conversion au niveau utilisateur. Adobe indique qu’un bon modèle a besoin d’au moins 90 jours de données et de 1 000 conversions.
- L’attribution décrit ce qui s’est passé. Seules les expériences vous disent ce que votre marketing a causé ; calibrez donc le modèle avec des groupes témoins.
- Déployez-la par étapes : définissez les KPI, auditez les données, centralisez-les, testez les modèles, puis modifiez les dépenses et observez le résultat.
- Les assistants IA sont désormais une source de visites et de commandes. Identifiez-les comme un canal à part entière et corrigez les données produit qu’ils lisent.
Ce que l’attribution omnicanale signifie en pratique
L’attribution multicanale répartit le crédit entre les canaux numériques que vous exploitez : recherche payante, réseaux sociaux, e-mail, affiliation. Chacun reçoit une part de la commande. L’attribution omnicanale essaie d’aller plus loin. Elle considère l’acheteur comme une seule personne qui voit une publicité sur TV connectée, se rend en magasin, ouvre un e-mail puis achète sur le site, et elle cherche à comprendre comment ces canaux se renforcent mutuellement.
La définition change légèrement d’un fournisseur à l’autre, et c’est important, car les règles de données du fournisseur déterminent ce que « omnicanal » couvre réellement. Prenez Klaviyo. Sa documentation du centre d’aide sur l’attribution omnicanale décrit la combinaison des sessions de site identifiées avec les interactions liées aux messages Klaviyo. Elle peut inclure l’activité anonyme une fois l’acheteur identifié par la suite, lorsque ce paramètre est activé. Les sessions provenant d’autres sources ne comptent que si elles comportent des paramètres d’attribution et entrent dans la fenêtre configurée. C’est une conception tout à fait raisonnable pour une plateforme d’e-mail et de SMS. C’est aussi une conception plus étroite de l’« omnicanal » que celle qu’utiliserait un planificateur TV.
Le test pratique est simple : lorsqu’un outil parle d’omnicanal, demandez quels points de contact il peut réellement voir, et lesquels il déduit. Une enseigne avec un POS, une présence sur une marketplace et un site Shopify a trois sources de données qui sont rarement d’accord sur l’identité du client. La couche d’attribution n’est aussi cohérente que la couche d’identité sur laquelle elle repose.
Ce que la partie IA ajoute
Les règles classiques sont simples. Le premier contact attribue le crédit à la première interaction, le dernier contact à la dernière, et le modèle linéaire le répartit à parts égales. Les modèles fondés sur l’IA apprennent plutôt les pondérations à partir des données.
La documentation d’Adobe fournit un bon exemple concret. Sa vue d’ensemble d’Attribution AI indique que le service calcule l’influence et l’impact incrémental des interactions client à travers les canaux et les étapes du parcours, y compris les impressions display, les envois et ouvertures d’e-mails, ainsi que les clics sur la recherche payante. La même page liste aussi les scores basés sur des règles qu’il prend en charge : premier contact, dernier contact, linéaire, en U et décroissance temporelle. Donc même le produit d’IA conserve les anciens modèles à des fins de comparaison, ce qui me semble être la bonne approche.
Le deuxième élément, c’est la portée hors ligne. La documentation d’Adobe sur la modélisation unifiée décrit un modèle d’IA causale qui combine une modélisation du mix marketing agrégée avec une attribution multitouch au niveau des événements. La partie au niveau des événements explique le parcours. La partie agrégée capte les canaux hors ligne, les rendements décroissants et la façon dont les canaux interagissent. Aucune des deux ne suffit à elle seule, et c’est la principale raison d’être des approches hybrides.
Alors, qu’apporte l’IA ? Trois choses, d’après mon expérience de lecture de ces systèmes :
Elle gère de nombreux points de contact sans que vous ayez à choisir manuellement les pondérations. Elle peut modéliser des effets différés, ce qui compte pour un achat réfléchi. Et elle réestime les paramètres quand les comportements changent. En revanche, elle ne vous donne pas la vérité. Elle vous donne une estimation mieux ajustée.
Les données nécessaires
C’est là que la plupart des projets se bloquent, généralement avant même la construction du moindre modèle.
La documentation des entrées et sorties d’Attribution AI d’Adobe est précise. Le modèle a besoin de champs d’identité et d’horodatage pour les points de contact et les conversions, de champs de canal et de marketing pour les points de contact, ainsi que de données de conversion e-commerce. Un bon modèle a besoin d’au moins 90 jours de données et d’au moins 1 000 conversions, et les paramètres par défaut d’entraînement et de fenêtre d’analyse nécessitent 236 jours de données en entrée. Adobe recommande aussi d’inclure autant de colonnes de conversion et de points de contact que possible.
Relisez cela à l’aune d’une petite boutique. Si vous faites 200 commandes par mois, vous n’atteindrez pas 1 000 conversions dans le minimum de 90 jours. Ce n’est pas un jugement sur votre marketing, seulement sur ce produit en particulier. Les petites équipes s’en sortent mieux avec des modèles plus simples et transparents, complétés par quelques tests avec groupe témoin bien menés.
Les données peuvent venir des analyses du fournisseur lui-même ou de sources externes, comme l’indique la même vue d’ensemble d’Adobe . Les approches neuronales fondées sur des graphes sont plus gourmandes. La documentation technique de Kumo sur l’attribution des conversions indique qu’elles exigent des données de parcours au niveau utilisateur, des horodatages et des événements de conversion clairement définis, et qu’elles ne conviennent pas si vous ne disposez que de données de canal agrégées.
En clair, il vous faut trois choses avant qu’un modèle ne devienne utile :
| Ce que vous avez | Ce qui convient |
|---|---|
| Dépenses et ventes agrégées par semaine, sans parcours au niveau utilisateur | Modélisation du mix marketing et tests simples avec groupe témoin |
| Données web et e-mail au niveau utilisateur, avec une identité unique | Attribution multitouch fondée sur des règles et sur les données |
| Données au niveau utilisateur sur le web, l’app, le magasin et les publicités, avec en plus du volume | Attribution par apprentissage automatique, calibrée par des expérimentations |
Ce tableau reflète les exigences en matière de données présentées dans la documentation Adobe et Kumo ci-dessus. Choisissez la ligne dans laquelle vous êtes, pas celle dans laquelle vous voudriez être.
L’attribution n’est pas l’incrémentalité
Si vous ne lisez qu’une seule chose avant d’acheter un outil d’attribution, lisez la différence entre ces deux notions.
Les directives de l’IAB sur la mesure incrémentale dans les médias commerce, publiées en novembre 2025, distinguent clairement ces deux notions. L’attribution et le ROAS décrivent une contribution observée, c’est-à-dire ce qui s’est passé. L’incrémentalité estime le résultat supplémentaire causé par le marketing, par rapport à un scénario crédible sans marketing. Les directives listent les méthodes qui permettent d’en produire une estimation : groupes de contrôle randomisés, groupes témoins ou ghost ads, marchés appariés et contrôles synthétiques. Elles avertissent aussi que la saisonnalité, les prix, les promotions, les concurrents, les campagnes simultanées, le biais de sélection, la multicolinéarité et un lien incomplet avec les expositions peuvent fausser l’estimation.
Cette dernière liste explique pourquoi les chiffres du Black Friday sont difficiles à interpréter. Tout bouge en même temps.
Les chercheurs essaient de réduire cet écart. Une étude publiée dans Management Science, Predicted Incrementality by Experimentation, publiée le 8 octobre 2026, a utilisé 2 226 expériences Meta pour apprendre une correspondance entre des expériences et des campagnes non expérimentales. Elle rapporte un R² hors échantillon de 0,88 pour les conversions incrémentales par dollar, contre 0,19 pour l’attribution au dernier clic sur sept jours. Elle indique aussi que sa méthode était en désaccord avec les décisions fondées sur des expériences dans 8 % à 12 % des campagnes, contre 12 % à 20 % pour le dernier clic.
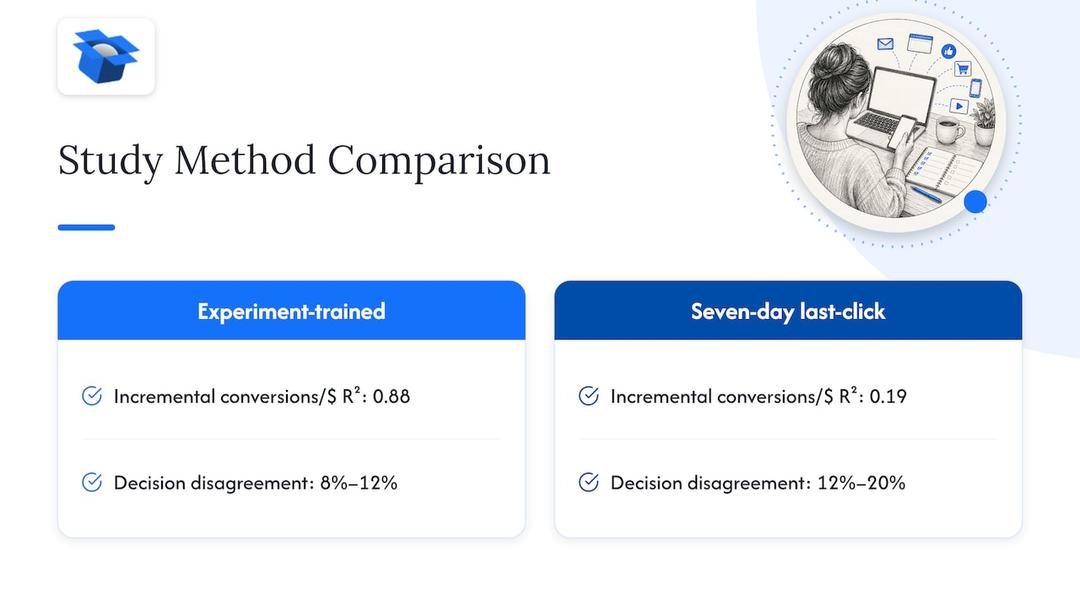
J’en retiens deux choses. Le dernier clic prédit mal ce que les publicités provoquent réellement, ce que la plupart d’entre nous soupçonnaient déjà. Et l’approche la plus performante s’appuyait toujours sur des expériences randomisées. L’IA n’a pas remplacé l’expérience, elle l’a étendue.
Précision importante : cette étude porte sur des campagnes publicitaires sur une seule plateforme. Elle ne dit rien sur le comportement de vos e-mails, du trafic en magasin ou des canaux organiques. Considérez-la comme une preuve de la méthode, pas comme une référence pour vos propres chiffres.
Un déploiement réalisable ce trimestre
Le guide de mesure cross-canal de l’IAB présente une séquence adaptée aux équipes e-commerce de la plupart des tailles. Voici l’ordre recommandé :
- Définir l’objectif et les KPI. Choisissez la décision que le modèle doit influencer, par exemple déplacer du budget entre le social payant et l’e-mail. Si aucune décision ne dépend de la réponse, abandonnez le projet.
- Cartographier les canaux et points de contact. de Dataiku guide d’attribution de Dataiku recommande de répertorier chaque point de contact et de documenter sa source de données et ses limites, car des données mal comprises dégradent à la fois la précision et la confiance des parties prenantes.
- Centraliser les données. Le guide de l’IAB décrit la consolidation de tous les canaux dans un entrepôt de données ou un data lake, l’application de règles de gouvernance et l’automatisation des ETL (les tâches qui déplacent et nettoient les données) lorsque c’est possible.
- Tester plusieurs modèles en parallèle. Le même guide recommande une attribution pilotée par les données via le machine learning, en complément des modèles mono-point de contact et multi-touch fondés sur des règles. Lorsqu’ils divergent, c’est une information en soi.
- Définir honnêtement la fenêtre d’attribution. Adobe Mix Modeler permet aux équipes de définir des fenêtres de rétrospection de 1 à 52 semaines et de configurer l’adstock et le délai par canal, afin que les canaux lents ne soient pas traités comme des canaux instantanés.
- Vérifier la confidentialité et le consentement. Faites-le avant la mise en œuvre, pas après le lancement.
- Modifier les dépenses, puis observer. Dataiku explique que les modèles d’attribution ne peuvent pas être évalués comme des prédicteurs classiques, car il n’existe pas d’étiquette de référence connue pour la comparaison. Le test pratique consiste à déplacer le budget en fonction du modèle et à observer les résultats commerciaux.
L’étape sept est celle que les équipes sautent le plus souvent. Un modèle sur lequel personne n’agit n’est qu’un tableau de bord.
Limites et confidentialité, sans détour
Le guide de bonnes pratiques de l’IAB pour la mesure cross-canal identifie comme obstacles les silos de données, la complexité de l’attribution, les barrières technologiques et les préoccupations liées à la confidentialité. Les réponses recommandées sont des données centralisées, des enregistrements granulaires au niveau des impressions, des modèles d’attribution adaptés à la question posée, des analyses prédictives, des tableaux de bord et une gestion du consentement. Rien dans cette liste n’a d’exotique. Il s’agit surtout d’organisation, et c’est cette organisation qui détermine si un modèle fonctionne.
Le étude State of Data 2026, une étude américaine de février 2026, indique que les réglementations sur la confidentialité et les changements de plateformes ont fragmenté les données entre des systèmes déconnectés. Il cite les contraintes juridiques, de sécurité, de précision, de qualité des données, d’accessibilité, de mise en place, de coût et de biais comme principaux freins à l’adoption de l’IA dans la mesure.
Les techniques préservant la confidentialité ont un coût. Une revue systématique de 108 études publiée en 2026 indique que la confidentialité différentielle réduisait la précision de 2 % à 33 %, selon le budget de confidentialité dans les configurations documentées. La même revue indique que les approches fédérées conservaient environ 90 % à 95 % des performances centralisées dans les déploiements documentés, tandis que la généralisation et la validité causale restent encore peu testées. Elle conclut aussi que l’attribution par deep learning peut améliorer la précision prédictive, mais que son lien causal ne peut pas être établi sans calibration expérimentale.
En résumé, de façon honnête : davantage de confidentialité signifie généralement un modèle plus flou, et un modèle plus précis n’est pas automatiquement plus juste. Ces deux raisons suffisent à garder des expériences dans la boucle.
Le canal que la plupart des configurations d’attribution ignorent
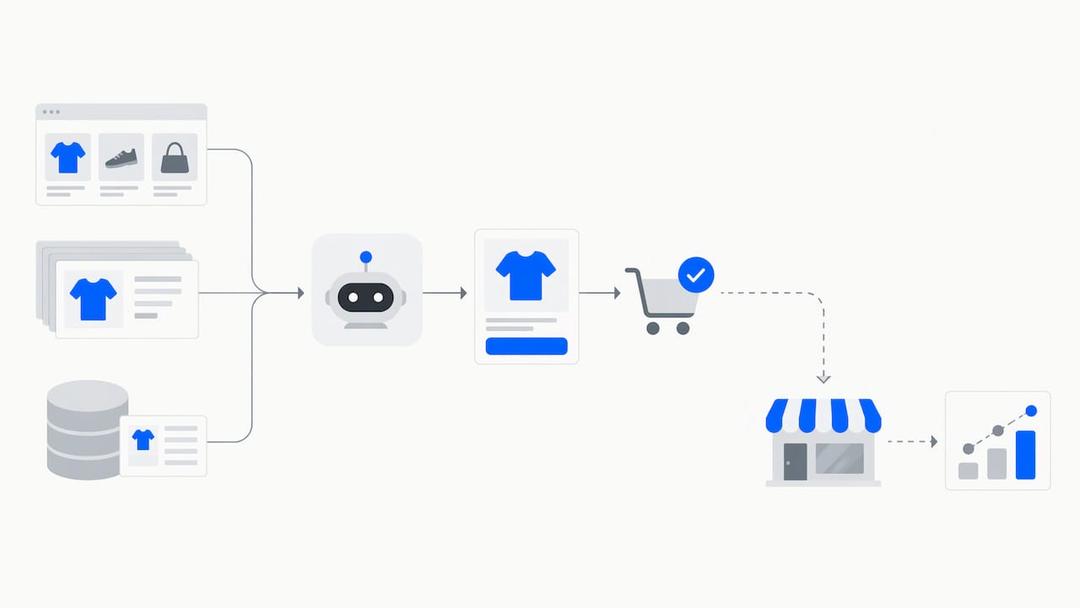
C’est ici que je commence à diverger du guide classique. Il suppose que c’est l’acheteur qui clique. Une part croissante de la découverte produit passe désormais par un assistant qui lit vos données pour le compte de l’acheteur. L’assistant ne voit jamais votre page d’accueil. Il lit le flux produit, le catalogue et les données structurées des fiches produit (les balises lisibles par machine qui indiquent ce qu’est un produit, son prix et ses modalités de livraison).
Avec AI Mode de Google et Gemini aux États-Unis, un agent peut même finaliser le paiement pour l’acheteur via UCP, le standard ouvert de Google pour le paiement par agent. ChatGPT, à l’inverse, renvoie vers le paiement du marchand. OpenAI a ACP, Google a UCP, Amazon a un système fermé.
Pour l’attribution, cela crée deux problèmes. D’abord, les visites issues des assistants finissent souvent dans les catégories « direct » ou « referral », ce qui rend le canal invisible. Ensuite, le choix de l’assistant intervient avant tout point de contact mesurable. Si vos données produit perdent la comparaison, vous n’obtenez jamais la visite à attribuer.
Nous avons constaté à quel point ce choix est déséquilibré. Sur nos propres achats simulés à partir du même catalogue, ChatGPT a choisi le produit environ trois fois plus souvent que Claude ou Gemini, 51,6 % contre environ 18,5 %. Chaque assistant est en pratique son propre canal, avec ses propres règles. Si vous voulez approfondir la partie mesure, ces pages la couvrent : comment suivre le trafic provenant des assistants d’achat IA, ce que l’attribution IA permet de mesurer pour l’e-commerce et l’attribution sans cookies avec l’IA. Si vous choisissez un logiciel, notre comparatif des outils d’attribution IA présente les alternatives et les profils auxquels chacune convient.
Précision importante : ecentic n’est pas une suite complète d’attribution omnicanale. Il ne modélise ni vos dépenses TV ni la fréquentation de vos magasins physiques. Sur Shopify, il suit les visites provenant des assistants IA, ce qui comble le manque décrit plus haut, et il ne suit ni le chiffre d’affaires ni les ventes. Gardez votre pile d’attribution principale pour le reste.
Notre vision de l’avenir de l’attribution
Selon nous, le prochain grand débat sur l’attribution ne portera pas sur les cookies. Il portera sur qui est choisi avant le clic. Lorsqu’un agent IA répond à un acheteur avec un seul produit, les marques qui perdent cette comparaison n’apparaissent dans aucun rapport, quel que soit le niveau du modèle.
Nous travaillons donc sur la boutique elle-même : le flux produit, le catalogue et le paiement qu’un agent utilise pour acheter. ecentic se connecte à Shopify, WooCommerce ou à un flux produit, fait comparer chaque produit par ChatGPT, Claude et Gemini face à celui d’un concurrent nommé, puis montre pourquoi il perd. Lorsque le marchand clique sur « Apply », ecentic réécrit le titre, la description et les données structurées, puis les publie dans la boutique.
Sur Shopify, ecentic envoie les corrections vers Google Merchant Center et suit les visites provenant des assistants IA. Sur WooCommerce, le plugin gratuit ecentic permet aux agents de rechercher, remplir un panier et finaliser la commande via UCP. Cette partie paiement est précisément ce que les simples outils de flux ne font pas.
Les chiffres sont encore préliminaires, et nous le précisons. Lors de notre premier pilote, DUA Flavours, les visites provenant des assistants IA et le trafic direct ont augmenté de 12 % entre avril et juillet 2026. Il s’agit d’un chiffre de visites, pas d’un chiffre de ventes, et nous ne le présentons pas autrement.
L’ordre logique me semble être le suivant : continuez à mesurer vos canaux classiques, calibrez avec des expériences, puis assurez-vous avant tout que les agents peuvent lire votre boutique et y acheter. Mesurer un canal que vous êtes en train de perdre est une manière très précise de vous regarder perdre.
Xhurian Shaba
Essayez-le sur vos propres produits
Si vous voulez voir comment les assistants comparent vos produits à ceux d’un concurrent nommé, commencez par l’analyse gratuite. Elle couvre vos 10 principaux produits et ne nécessite pas de carte bancaire. Elle montre pourquoi un agent choisit l’autre produit, en anglais clair, afin que vous sachiez quoi modifier dans le titre, la description et les données structurées.

Les offres payantes commencent avec Compete à 14,90 $ par mois pour jusqu’à 100 produits. Scale coûte 44,90 $ par mois pour jusqu’à 1 000 produits avec corrections en un clic. Dominate coûte 149 $ par mois et ajoute la synchronisation Google Merchant Center ainsi que la configuration du paiement par agent. Une option au paiement à l’usage existe aussi à 3 % des commandes attribuées à l’IA, plafonnée à 500 $ par mois. Les conditions actuelles figurent sur la page des tarifs d’ecentic, et comment ça marche explique les étapes de simulation, diagnostic et optimisation.
FAQ
Quelle est la différence entre l’attribution omnicanale et multicanale ?
L’attribution multicanale répartit le crédit entre les canaux numériques que vous utilisez, généralement canal par canal. L’attribution omnicanale tente de relier tous les points de contact, y compris les canaux hors ligne et propriétaires, autour d’un même client. En pratique, la différence dépend des données que l’outil est réellement capable de relier ; vérifiez donc quels points de contact il voit.
De combien de données l’attribution IA a-t-elle besoin ?
Cela dépend du produit. La documentation d’Adobe Attribution AI indique qu’un bon modèle nécessite au moins 90 jours de données et 1 000 conversions, et que les paramètres par défaut demandent 236 jours de données en entrée. Les boutiques en dessous de ce volume obtiennent généralement de meilleurs résultats avec des modèles plus simples et des tests avec groupe témoin.
L’attribution IA peut-elle prouver quel canal a provoqué une vente ?
Non, pas à elle seule. Les directives de l’IAB indiquent que l’attribution décrit ce qui s’est passé, tandis que l’incrémentalité nécessite un scénario contrefactuel crédible, comme un groupe témoin ou des marchés appariés. Utilisez le modèle pour formuler des hypothèses et l’expérience pour les confirmer.
L’attribution omnicanale couvre-t-elle le trafic provenant des assistants IA ?
Uniquement si vous la configurez pour cela. De nombreuses configurations classent les visites des assistants dans le trafic direct ou le trafic référent. Identifiez les assistants comme une source distincte et assurez-vous que les données produit qu’ils lisent sont complètes, afin qu’ils puissent choisir vos produits dès le départ.
Sources
- Comprendre l’attribution omnicanale, Centre d’aide Klaviyo
- Présentation d’Attribution AI, Adobe Experience Platform
- Unified Modeling, Adobe Marketing Campaign Analytics
- Entrées et sorties dans Attribution AI, Adobe Experience Platform
- Attribution des conversions pour l’Ad Tech, Kumo
- Directives pour la mesure incrémentale dans les médias commerce, IAB
- Predicted Incrementality by Experimentation, Management Science
- Mise en œuvre de la mesure cross-canal pour les responsables marketing, IAB
- Améliorer l’attribution marketing avec le machine learning, Dataiku
- Créer des modèles dans Mix Modeler, Adobe
- Bonnes pratiques de mesure cross-canal pour les responsables marketing, IAB
- IAB State of Data 2026
- Une IA fiable pour la mesure marketing : revue systématique, SSRN
Sujets à explorer