

Gemini et Perplexity trouvent les produits via des pipelines presque entièrement différents. Gemini s’appuie sur votre flux produit, Merchant Center et le Universal Commerce Protocol (UCP) émergent ; Perplexity s’appuie sur des pages explorables et sur la fréquence à laquelle d’autres sites vous citent. Les deux vérifient toutefois les mêmes signaux de base : un balisage schema complet, des prix et stocks cohérents, et de vrais avis. Si vous ne corrigez qu’un seul point en priorité, faites-en un Product JSON-LD rendu côté serveur, avec parité du flux sur vos SKU les plus vendus.
En bref :
- Donnez la priorité à un Product JSON-LD rendu côté serveur avec un balisage schema complet, des prix cohérents et des mises à jour quotidiennes du flux pour assurer votre visibilité dans Gemini et Perplexity.
- Corrigez les incohérences de stock et de prix, en particulier sur les SKU à fort chiffre d’affaires, afin d’éviter que vos produits ne disparaissent des résultats des agents à cause des signaux de confiance.
- Évitez l’injection de balisage schema côté client et les mesures strictes de blocage des bots, qui peuvent exclure silencieusement vos produits de l’indexation par les agents IA.
- Utilisez des outils de simulation pour repérer les lacunes du balisage schema et tester les correctifs sur les produits à fort impact avant de déployer des mises à jour à l’échelle du catalogue.
- Suivez régulièrement des métriques opérationnelles comme l’exhaustivité des attributs et les incohérences de stock afin de maintenir et d’améliorer dans le temps la visibilité auprès des agents IA.
Comment Gemini et Perplexity trouvent les produits (et pourquoi cela change tout)
Les résultats shopping de Gemini proviennent d’un pipeline de données, et non d’une page qu’il aurait simplement explorée. Il puise dans votre flux Merchant Center, fait correspondre ces données avec le Shopping Graph de Google et interroge de plus en plus directement des endpoints UCP lorsqu’une boutique les prend en charge. Si votre flux ne contient pas les GTIN, affiche des prix obsolètes ou fait l’objet de refus, Gemini n’affichera tout simplement pas le produit, quelle que soit la qualité de votre fiche produit.
Perplexity fonctionne davantage comme un assistant de recherche que comme un moteur shopping. Il effectue des recherches web en direct, lit votre HTML réel, analyse les données structurées présentes sur la page et évalue la fréquence à laquelle des sites indépendants, des avis et des forums mentionnent votre produit. Perplexity privilégie la recherche web en direct et les citations de sites tiers, ce qui signifie qu’un produit sans aucune mention dans la presse et avec des données structurées minimales sur la page peut être dépassé par un concurrent au prix moins avantageux mais mieux couvert par des contenus éditoriaux.
Au final, les deux agents s’appuient sur les données structurées plutôt que de lire une page comme le ferait un acheteur. Les agents interrogent les flux structurés, les données structurées produit et les données de catalogue indexées et mettent ces données en correspondance avec les contraintes indiquées par l’acheteur, comme « moins de 50 $ » ou « livré d’ici vendredi ». Là où ils divergent :
- Gemini valorise l’exhaustivité des flux, la bonne tenue de Merchant Center et la prise en charge du protocole UCP.
- Perplexity valorise un HTML explorable, les données structurées au niveau de la page et les citations de sites tiers.
- Les deux vérifient les données structurées Product, les données Offer, le statut de disponibilité et les scores agrégés d’avis.
- Gemini se rapproche davantage d’une requête de base de données ; Perplexity se rapproche davantage d’une recherche en direct.
Voici le point important pour établir les priorités : ces agents se recoupent à environ 80 % sur ce qu’ils exigent réellement. Des données structurées propres, des flux exacts et des avis légitimes servent les deux.
La liste de priorités : données structurées, flux, stock et avis
Traitez ces points dans cet ordre. Chaque étape débloque la suivante, et brûler les étapes ne fait que vous obliger à refaire le travail plus tard.
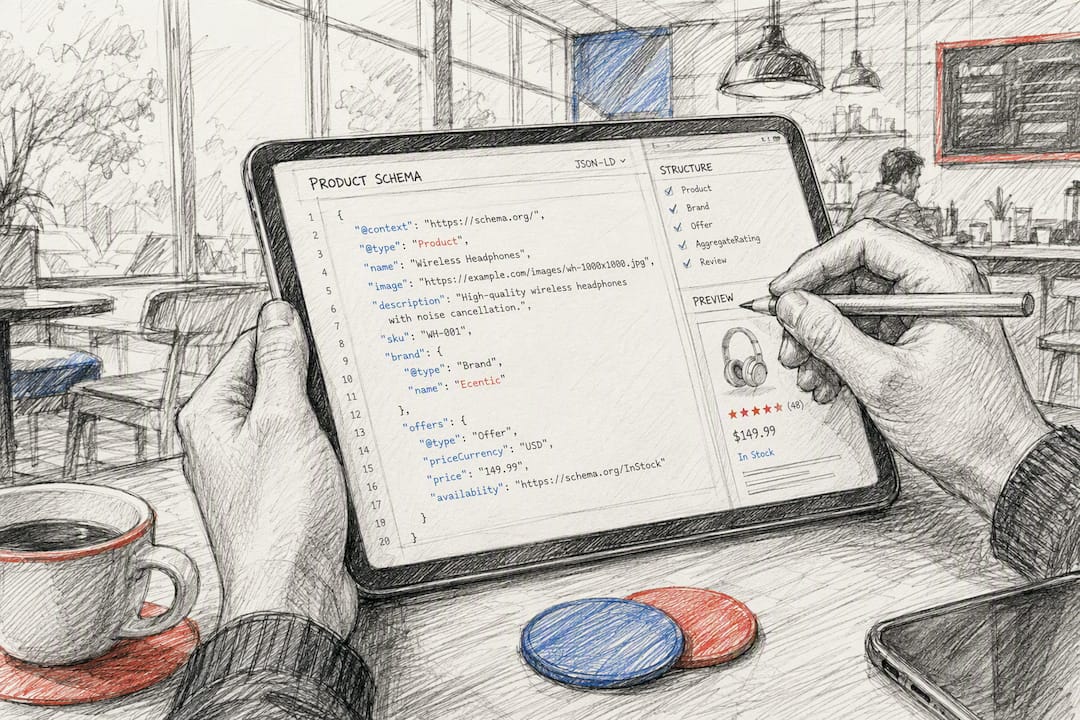
- Déployez un Product JSON-LD rendu côté serveur. Chaque SKU prioritaire doit inclure
name,description,sku,brand,offers,aggregateRating,image, ainsi queGTINouMPNprésents dans la réponse HTML brute, pas injectés après le chargement de la page. Des données structurées Product complètes, rendues côté serveur, sont nécessaires pour une analyse fiable par les agents, et un champ manquant suffit souvent à écarter totalement un produit. - Alignez le prix partout. Votre flux, votre fiche produit et votre paiement doivent afficher le même montant. Les agents comparent le prix du flux, de la PDP et du paiement, et un écart est interprété comme un défaut de confiance, pas comme une erreur d’arrondi.
- Actualisez votre flux au minimum une fois par jour. Les catégories à rotation rapide, les tailles dans l’habillement, les drops limités et les ventes flash exigent des mises à jour quasi en temps réel. Une actualisation quotidienne est un minimum, pas l’objectif.
- Exposez la disponibilité réelle. Renseignez
Availabilityles données structurées de façon exacte, et si vous pouvez proposer un endpoint d’API catalogue, faites-le. Les marchands qui exposent un endpoint compatible UCP bénéficient d’un avantage précoce en découvrabilité, simplement parce que peu de concurrents ont encore pris la peine de le faire. - Standardisez la taxonomie et renseignez les attributs de catégorie. Taille, matière, couleur, coupe — tout ce qu’exige votre catégorie — doit être présent et cohérent, pas dispersé dans des descriptions en texte libre.
- Publiez les données structurées
MerchantReturnPolicyetShippingDeliveryTime. Ces deux éléments sont constamment ignorés, alors que les agents s’en servent pour répondre exactement aux questions que posent les acheteurs : « puis-je le retourner ? » et « arrivera-t-il d’ici vendredi ? »
Commencez tout ce processus avec vos produits qui génèrent le plus de chiffre d’affaires, pas avec l’ensemble du catalogue. Auditer d’abord les 20 % de SKU qui génèrent le plus de revenus produit rapidement des résultats visibles et vous donne un modèle à automatiser sur le reste du catalogue.
Conseil pro : Ici, la qualité des données structurées l’emporte à chaque fois sur une refonte visuelle. Une fiche produit visuellement datée mais avec des données structurées irréprochables sera plus souvent recommandée qu’une page magnifiquement conçue avec un balisage approximatif, car les agents évaluent la couche de données, pas votre palette de couleurs.
Shopify vs WooCommerce : étapes d’implémentation et pièges fréquents
La checklist ci-dessus est indépendante de la plateforme. Son exécution ne l’est pas.
Avec Shopify, vérifiez si votre forfait prend en charge les fonctionnalités émergentes d’Agentic Storefronts, puis confirmez que votre thème rend le JSON-LD côté serveur plutôt que via une application qui l’injecte côté client après le chargement de la page. Synchronisez votre flux produit avec Merchant Center directement depuis l’interface d’administration Shopify plutôt que via un export tiers exécuté selon son propre calendrier. Vérifiez aussi les règles de votre CDN et de votre pare-feu ; certains paramètres de protection contre les robots bloquent par défaut les robots d’exploration des agents, ce qui vous retire discrètement des résultats de Perplexity sans aucun message d’erreur.
Sur WooCommerce, privilégiez un plugin de schéma PHP côté serveur ou une injection directe dans le template plutôt qu’une solution reposant uniquement sur Google Tag Manager. Mettez en place une automatisation du flux de données à laquelle vous faites réellement confiance : les exports CSV manuels deviennent vite obsolètes, et c’est précisément ce décalage qui détruit la parité des flux. Si la taille de votre catalogue le permet, exposez un endpoint d’API catalogue afin que les agents interrogeant directement l’UCP puissent accéder à votre inventaire sans attendre un cycle de rafraîchissement du flux.
Trois erreurs reviennent constamment sur les deux plateformes :
- Injection de schéma uniquement côté client. Les balises déclenchées après le chargement initial de la page sont souvent totalement invisibles pour les crawlers d’agents, car beaucoup n’exécutent pas JavaScript comme un navigateur.
- Décalage du flux créant des incohérences d’inventaire. Un flux mis à jour toutes les 48 heures affichera régulièrement des produits comme disponibles alors qu’ils sont déjà en rupture de stock.
- Couches anti-bot excessivement agressives. Les barrières CAPTCHA et les règles strictes de
robots.txtconçues pour bloquer les scrapers bloquent fréquemment les agents par lesquels vous essayez justement d’être recommandé.
Un générateur gratuit de schéma JSON-LD permet de vérifier rapidement que la structure de votre balisage est correcte avant d’investir du temps d’ingénierie dans un déploiement complet. Exécutez également votre propre checklist des données structurées sur un échantillon de pages avant de supposer que le correctif a fonctionné.
Tester et mesurer la visibilité des agents
Corriger les schémas et les flux ne représente que la moitié du travail. Vous avez besoin de preuves que cela fonctionne, ainsi que d’une méthode reproductible pour détecter les régressions avant qu’elles ne vous coûtent du trafic.
- Exécutez d’abord des simulations. Testez vos SKU prioritaires dans un outil comme UCP Playground et vérifiez si l’agent renvoie des données exactes de prix, de disponibilité et de citation pour chaque requête.
- Effectuez des requêtes manuelles pour vérifier la cohérence. Sélectionnez 10 à 15 SKU à forte valeur, interrogez directement Gemini et Perplexity à leur sujet, puis comparez les réponses avec votre PDP et votre flux en production.
- Segmentez vos analyses par source d’agent. Créez des segments GA4 pour des référents connus comme perplexity.ai, chatgpt.com et copilot.microsoft.com (sources de trafic d’agents couramment utilisées), et utilisez un marquage UTM sur tous les référencements au niveau protocole que vous pouvez capturer.
- Suivez chaque semaine les indicateurs de santé opérationnelle, pas seulement les chiffres de conversion.
| Indicateur | Ce qu’il vous indique |
|---|---|
| Taux de refus du flux | Combien de produits sont actuellement invisibles pour Gemini |
| % de complétude des attributs | À quel point votre catalogue se rapproche d’une couverture complète du schéma |
| Incidents de décalage d’inventaire/semaine | Si votre cadence de rafraîchissement tient réellement |
| Taux d’ajout au panier provenant des agents | Si la visibilité se convertit réellement, et ne se contente pas de générer des visites |
Suivre correctement le trafic shopping issu de l’IA transforme cette initiative ponctuelle en un programme continu que vous pouvez défendre lors d’une réunion budgétaire.
Pourquoi la simulation surpasse les suppositions
La plupart des marchands découvrent que leurs produits sont invisibles pour les agents IA de la pire manière : en constatant l’absence de trafic plutôt qu’en identifiant la véritable cause. Pour ecentic, c’est une approche à l’envers. Vous devriez savoir quel champ de schéma, quel attribut de flux ou quel écart de parité provoque l’exclusion avant de passer des heures d’ingénierie à deviner.
Les tests pilotés par simulation révèlent le point exact de défaillance. Exécutez une requête sur un produit dans un environnement contrôlé et vous voyez précisément ce qu’un agent voit, et non ce que vous supposez qu’il voit. Cette différence détermine si vous corrigez les cinq bons champs sur vos 20 SKU les plus importants cette semaine, ou si vous déployez une mise à jour globale du schéma le trimestre prochain en espérant qu’elle fonctionne. Les clients qui utilisent cette approche constatent des augmentations mesurables des visites et ventes générées par l’IA une fois les problèmes spécifiques identifiés par simulation corrigés.
La séquence opérationnelle qui fonctionne : lancer une simulation ciblée sur vos SKU les plus rentables, vérifier que les correctifs modifient réellement la réponse de l’agent, puis automatiser le même modèle de correction sur le reste du catalogue. Sauter l’étape de validation conduit les équipes à reconstruire deux fois le même schéma.
— Xhurian
Être recommandé par Gemini et Perplexity sans avancer à l’aveugle
Interroger manuellement les agents pour chaque SKU ne passe pas à l’échelle, et les conseils SEO génériques ne vous diront pas quel champ précis vous coûte une recommandation. ecentic exécute des requêtes d’agents simulées sur vos véritables pages produit, puis vous fournit une liste claire de ce qui ne fonctionne pas : un champ aggregateRatingmanquant, un prix dans le flux qui ne correspond pas à votre PDP, un champ de schéma qu’un agent ignore silencieusement.

La plateforme se connecte directement à Shopify ou WooCommerce, analyse vos fiches produit, et génère des correctifs que vous pouvez publier en un clic au lieu de les envoyer dans une file d’attente d’ingénierie. Vous bénéficiez également d’un accès direct à UCP Playground pour tester comment Gemini et Perplexity répondent réellement à vos SKU prioritaires avant et après vos modifications, afin de mesurer le comportement réel des agents plutôt que de supposer que vos correctifs ont fonctionné.
Commencez par l’analyse gratuite, identifiez les correctifs ayant le plus d’impact, puis testez-les sur des requêtes d’agents réelles avant de déployer les changements sur l’ensemble du catalogue.
Sources
- Optimiser pour les agents IA de shopping : comment rendre vos produits visibles pour les assistants IA
- Comparatif des agents IA de shopping : ChatGPT, Gemini, Perplexity, Copilot, Claude et Rufus (2026)
- Agentic Commerce: A Practitioner’s Guide to Making Your Products Visible, Buyable, and Recommended by AI Shopping Agents - YesTupa
FAQ
Perplexity est-il meilleur que Gemini pour les recommandations produit ?
Aucun n’est strictement meilleur. Gemini fonctionne surtout lorsque votre flux et vos données Merchant Center sont propres, tandis que Perplexity privilégie les pages bien structurées soutenues par des citations tierces. Le meilleur choix dépend donc du signal que votre boutique gère actuellement le mieux.
Quelle est la différence entre ChatGPT et Gemini pour le shopping ?
ChatGPT et Gemini s’appuient tous deux sur des données de catalogue structurées, mais les résultats shopping de Gemini sont beaucoup plus étroitement liés au flux Merchant Center et au Shopping Graph de Google, tandis que ChatGPT s’appuie davantage sur l’exploration générale du web et les citations, dans une approche plus proche de celle de Perplexity.
Ai-je besoin d’une optimisation distincte pour Gemini et Perplexity ?
Globalement non. Les deux agents partagent environ 80 % des mêmes exigences sous-jacentes : schémas propres, flux précis et vrais avis clients. Corriger ces éléments couvre donc l’essentiel du travail pour les deux.
À quelle fréquence dois-je mettre à jour mon flux produit ?
Des rafraîchissements quotidiens constituent le minimum pour des catalogues stables, et des stocks à rotation rapide comme l’habillement ou les éditions limitées nécessitent des mises à jour quasi en temps réel pour éviter que les agents n’indiquent des produits épuisés comme disponibles.
Puis-je tester la manière dont Gemini et Perplexity voient mes produits avant de déployer des modifications ?
Oui. Faire passer vos SKU prioritaires dans un outil de simulation comme le UCP Playground vous montre exactement comment un agent interprète vos données actuelles de schéma et de flux avant de lancer un déploiement complet.