

Lancez un audit de préparation fondé sur la simulation, associé à un test de taux de victoire multi-moteurs. Cette combinaison repère ce que les check-lists SEO génériques laissent passer : les signaux lisibles par machine que ChatGPT, Gemini, Claude et Perplexity utilisent réellement pour décider quels produits recommander. Ecentic propose cette approche aux marchands sur Shopify et WooCommerce, et c’est la plateforme que nous vous conseillerions en premier, car elle corrige les mêmes signaux qu’elle mesure.
Voici pourquoi c’est important dès maintenant :
- Les agents ignorent les pages où le prix et la disponibilité ne s’affichent qu’après le chargement du JavaScript
- Un auditeur de préparation comme CatalogReady attribue à votre page une note de 0 à 100 et vous indique précisément ce qui ne va pas
- Le moyen le plus rapide d’obtenir un diagnostic, c’est un scan gratuit, pas une supposition
Lancez un audit dès aujourd’hui. Tout ce qui suit explique ce qu’il mesure et pourquoi.
À retenir
Être choisi dans les recommandations des agents d’achat IA dépend davantage de la cohérence lisible par machine entre votre page, votre flux et votre schéma que d’un texte produit convaincant.
| Point | Détails |
|---|---|
| Corrigez la structure avant le texte | Assurez le rendu côté serveur du prix et de la disponibilité, et complétez vos données structurées Product et Offer en JSON-LD avant de réécrire les descriptions. |
| Vérifiez l’accès des robots d’exploration | Confirmez que robots.txt et llms.txt autorisent OAI-SearchBot, PerplexityBot et les robots d’exploration d’agents similaires. |
| Alignez chaque surface | Vérifiez la cohérence du prix et de la disponibilité entre votre page, votre flux et votre schéma ; les écarts disqualifient les produits. |
| Testez sur plusieurs moteurs | Lancez des requêtes identiques sur ChatGPT, Perplexity et Gemini avant et après les correctifs pour confirmer de vrais gains, et pas seulement une hausse du score. |
| Utiliser ecentic pour un diagnostic continu | Ecentic exécute des audits de préparation déterministes, fournit des correctifs JSON-LD prêts à coller et suit les visites générées par les agents pour les boutiques Shopify et WooCommerce. |
Que sont les simulateurs d’agents IA et pourquoi les marchands en ont-ils besoin ?
Un simulateur d’agent d’achat IA reproduit exactement le processus que ChatGPT, Gemini ou Perplexity utilise pour évaluer votre fiche produit, puis indique ce que l’agent a vu, ce qu’il a ignoré et pourquoi il a choisi un concurrent à la place. Il s’agit d’une catégorie d’outils différente des frameworks généraux de test d’agents conçus pour les ingénieurs qui déboguent des workflows multi-agents. Les simulateurs d’agents d’achat ont un seul objectif : dire aux marchands si leurs fiches produit résistent au contact d’un acheteur IA.
Ce contact se déroule en trois étapes, selon l’analyse des protocoles de commerce par agents, ce contact se déroule en trois étapes. D’abord, la récupération : le crawler de l’agent peut-il seulement récupérer votre page et en analyser les données structurées ? Ensuite, la confiance : vos avis, vos politiques et vos affirmations de prix sont-ils cohérents sur toutes les surfaces que l’agent vérifie ? Enfin, l’action : l’agent peut-il confirmer le stock et mener le parcours d'achat à son terme sans tomber sur une impasse ? Un produit qui échoue sur une seule de ces couches est écarté, quelle que soit la qualité du texte pour un humain.
Un simulateur peut mesurer si votre JSON-LD est correctement analysé, si votre prix correspond à votre flux et si une requête donnée fait ressortir votre produit dans un moteur donné à une date donnée. Il ne peut pas promettre un classement élevé permanent. Les sorties des agents évoluent avec les mises à jour des modèles, les changements chez les concurrents et la formulation des requêtes ; considérez donc chaque simulation comme un instantané, pas comme une garantie.
Comment évaluer un simulateur d’agent IA ?
Tous les outils présentés comme des applications de simulation IA ne testent pas réellement ce qui compte pour un agent d’achat. Avant de faire confiance à un score de préparation, vérifiez que l’outil couvre ces cinq domaines.
- Validation du schéma et des données rendues côté serveur. L’outil doit vérifier votre JSON-LD Product et Offer pour le titre, le GTIN ou le SKU, le prix, la devise et la disponibilité, et confirmer que ces champs sont rendus dans le HTML statique plutôt qu’après l’exécution de JavaScript uniquement. l’analyse d’AgentMint sur l’anatomie des pages produit note que de nombreux crawlers IA ne récupèrent que le HTML statique ; les données uniquement côté client leur sont donc invisibles.
- Vérifications d’accès des crawlers. Il doit lire vos fichiers robots.txt et llms.txt et confirmer que des bots spécifiques comme OAI-SearchBot et PerplexityBot ne sont pas bloqués.
- Garantissez la cohérence sur tous les supports. Un auditeur fiable recoupe le prix et la disponibilité sur votre page avec votre flux produit et vos données structurées, en signalant les écarts qui disqualifient immédiatement les produits.
- Diagnostics déterministes. Recherchez des IDs de règle et des correctifs JSON-LD prêts à coller, plutôt que des conseils vagues du type « améliorez votre SEO ». CatalogReady, un auditeur open source, note les pages de 0 à 100 et rattache chaque défaut à une règle précise pouvant être corrigée.
- Simulation multi-moteur avec attribution. Un test sur un seul moteur vous dit comment ChatGPT voit votre page, mais ne dit rien de Gemini ou Perplexity, qui pondèrent différemment la fraîcheur et les citations.
Conseil pro : Demandez à chaque fournisseur si son score de préparation est déterministe (fondé sur des règles, reproductible) ou s’il s’agit d’une estimation générée par un modèle. Les scores déterministes vous permettent de reproduire le même résultat demain ; les scores générés par un modèle peuvent varier d’une exécution à l’autre pour des raisons qui n’ont rien à voir avec votre page.
Comment exécuter un test de taux de victoire sur vos fiches produit ?
Ce protocole prend moins d’une journée et vous donne une comparaison avant/après exploitable immédiatement.
- Récupérer votre page sans JavaScript. Récupérez le HTML brut et vérifiez que votre titre, votre prix, votre disponibilité et vos identifiants apparaissent dans la réponse statique, pas seulement dans le DOM rendu.
- Valider votre JSON-LD Product et Offer. Vérifiez que priceCurrency, price, availability et le GTIN ou le SKU sont bien présents et correspondent à ce qu’un acheteur voit sur la page.
- Vérifier robots.txt et llms.txt. Confirmez que vous ne bloquez pas les robots d’exploration utilisés par les agents, et ajoutez un fichier llms.txt si ce n’est pas déjà fait ; l’analyse de StoreSEO considère cela comme l’une des corrections techniques les plus efficaces à la disposition des marchands Shopify.
- Exécuter un audit déterministe et exporter les résultats. Récupérez vos IDs de règle et les correctifs prêts à coller, puis appliquez directement les correctifs de rendu côté serveur et de schéma.
- Interroger le même produit sur ChatGPT, Perplexity et Gemini avant et après vos correctifs. Consignez si l’agent recommande votre produit, l’ignore ou choisit un concurrent.
- Suivre l’évolution du score de préparation en parallèle des visites générées par les agents. L’évolution du score est un indicateur avancé ; les vraies visites et conversions issues du trafic généré par les agents restent le véritable test.
| Indicateur | Éléments à consigner |
|---|---|
| Score de préparation | Score de 0 à 100 avant et après les correctifs, avec les IDs de règle validés |
| Victoires par moteur | Si ChatGPT, Perplexity et Gemini ont recommandé le produit sur des requêtes identiques |
| Visites générées par les agents | Sessions attribuées au trafic de référence des agents, suivies chaque semaine |
| Conversions | Commandes finalisées à partir de sessions attribuées aux agents |
Les recommandations des praticiens sur ce type de test convergent sur un point : l’évolution du score de préparation, à elle seule, ne prouve rien. Le vrai test consiste à vérifier si la recommandation réelle d’un agent change pour une même requête avant et après vos correctifs.
Conseil pro : Lancez vos requêtes avant/après au même moment de la journée et avec une formulation identique. Les réponses des agents peuvent varier d’une session à l’autre même sans aucun changement de votre côté, donc une seule paire de requêtes ne prouve rien. Exécutez chaque requête trois fois par moteur et retenez le résultat majoritaire.
Que doit contenir votre checklist de préparation aux agents IA ?
Passez cette liste en revue sur chaque fiche produit avant toute autre intervention. L’ordre reflète la fréquence à laquelle chaque élément bloque une recommandation d’agent, pas la facilité de correction.
- Nom du produit, marque et identifiants (GTIN, MPN ou SKU) présents à la fois dans le HTML et le JSON-LD
- Prix total et devise rendus côté serveur, correspondant exactement à votre flux
- Statut de disponibilité à jour et cohérent entre la page, le schéma et le flux
- Au moins une image produit référencée dans votre schéma, et pas seulement affichée visuellement
- Nombre d’avis et note exposés dans les données structurées, et non enfouis dans un widget tiers
Les six correctifs qui débloquent le plus souvent les agents, approximativement par ordre de fréquence : rendre le prix et la disponibilité côté serveur au lieu de les charger via JavaScript, ajouter un JSON-LD Product et Offer complet, aligner votre flux avec les prix affichés sur vos pages en direct, lier vos politiques de livraison et de retour depuis la fiche produit elle-même, ajouter un court bloc FAQ répondant aux questions fréquentes des acheteurs et fournir à l’agent des éléments de comparaison (matériaux, tailles, différences entre cette variante et une autre similaire). Priorisez selon l’impact par rapport à l’effort : les correctifs de schéma et de rendu côté serveur prennent un après-midi et débloquent entièrement la récupération des données, tandis que le contexte de comparaison demande plus de rédaction mais détermine rarement si un agent peut vous trouver.
Comparer les meilleurs simulateurs d’agents IA par prix et profondeur d’analyse
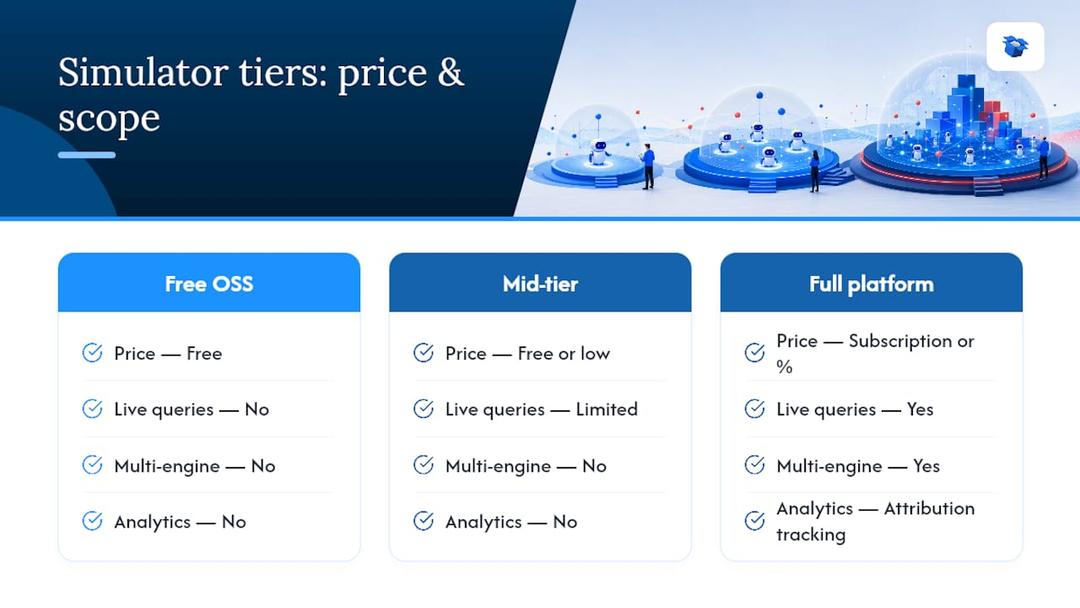
Les outils de simulation se répartissent en trois catégories. Les auditeurs gratuits et open source comme CatalogReady fournissent un score déterministe de 0 à 100, des IDs de règle et des correctifs JSON-LD, entièrement hors ligne et sans clé API. C’est un excellent point de départ : aucun coût, aucune friction liée à l’inscription et des résultats exploitables le jour même. Le compromis concerne le périmètre. Un auditeur local vérifie votre schéma et votre rendu côté serveur, mais il n’exécute pas de requêtes en direct sur ChatGPT ou Perplexity pour montrer ce qu’un agent recommande réellement aujourd’hui.
Les outils de vérification intermédiaires, souvent gratuits ou peu coûteux et accessibles via le web, analysent une seule page et signalent les blocages évidents comme les champs de schéma manquants ou les robots d’exploration bloqués. Ils sont utiles pour une vérification rapide, mais s’arrêtent généralement avant les tests multi-moteurs ou le suivi continu.
Les plateformes complètes, dont ecentic fait partie, combinent l’audit déterministe d’un outil open source avec des simulations en direct sur plusieurs moteurs, des analyses d’attribution suivant les visites réelles générées par les agents et la publication des correctifs en un clic dans Shopify ou WooCommerce. La tarification prend ici la forme soit d’un abonnement mensuel fixe, soit d’un pourcentage des commandes attribuées au trafic généré par les agents, avec un scan gratuit comme point d’entrée. La différence entre les catégories ne tient pas vraiment à la précision d’un contrôle isolé. Elle dépend du fait que vous testiez manuellement une seule page ou que vous exécutiez des diagnostics continus sur tout un catalogue tout en suivant si le trafic des agents convertit réellement.
L’interface de l’outil rend-elle les données réellement exploitables ?
Un score de préparation ne sert à rien si vous ne pouvez pas le transformer en correctif avant votre prochain lancement produit. Les meilleurs simulateurs présentent les résultats sous forme de liste priorisée, avec les problèmes les plus critiques en premier, des explications claires à côté de chaque ID de règle plutôt qu’un mur de sortie technique.
Les auditeurs open source en ligne de commande comme CatalogReady nécessitent d’être à l’aise avec un terminal et la lecture directe de sorties JSON, ce qui convient à un membre d’une équipe technique mais crée des frictions pour un marchand DTC gérant seul sa boutique. Les plateformes web échangent une partie de ce contrôle brut contre un tableau de bord : un score de préparation bien visible, une liste des vérifications échouées juste en dessous et un bouton ou un extrait de code pour appliquer le correctif plutôt qu’un patch manuel à copier dans les fichiers de votre thème.
Deux détails d’interface distinguent un outil réellement utile d’un outil simplement soigné visuellement. D’abord, vous montre-t-il pourquoi une vérification a échoué, avec le champ précis ou la ligne de balisage concernée, ou seulement le fait qu’elle a échoué ? Ensuite, pouvez-vous relancer cette même vérification après un correctif sans recommencer tout l’audit ? Un outil qui impose une nouvelle analyse complète pour chaque petite modification transforme un correctif de cinq minutes en un cycle de vingt minutes, et la plupart des marchands abandonnent après le troisième tour. Les plateformes conçues pour un usage continu, plutôt qu’un audit ponctuel, séparent généralement « réanalyser l’ensemble » de « revérifier cette règle uniquement », ce qui devient bien plus important qu’il n’y paraît dès que vous gérez plus d’une poignée de SKU.
À quel point ces simulations reflètent-elles le comportement réel des agents ?
La réponse honnête : suffisamment réalistes pour détecter les blocages structurels, mais imparfaites pour prédire les classements exacts. Un simulateur qui vérifie votre schéma, l’accès des robots d’exploration et la cohérence des prix teste les mêmes barrières mécaniques qu’un agent réel. Si votre JSON-LD manque d’un champ requis ou que votre robots.txt bloque PerplexityBot, l’échec est déterministe. Il se reproduira de la même manière à chaque fois, en simulation comme en production.
Là où la simulation devient plus floue, c’est à l’étape de la recommandation finale. Les agents pondèrent la fraîcheur des données, la formulation de la requête de l’acheteur et le contexte concurrentiel de manière variable selon les sessions et les mises à jour de modèles. Une requête qui fait ressortir votre produit aujourd’hui peut ne plus le faire demain, même sans changement de votre côté. C’est pourquoi un simple test victoire/défaite prouve peu de choses. Exécuter la même requête trois fois par moteur et suivre le résultat majoritaire, comme expliqué plus haut, donne une lecture plus fiable qu’un test unique.
Les tests multi-moteurs comptent également parce que ChatGPT, Gemini et Perplexity ne se comportent pas de façon identique. Perplexity, en particulier, privilégie les contenus récents et citables et valorise une attribution claire, selon des recherches sur les signaux de crédibilité orientés agents, qui montrent que l’ajout de citations, de verbatims et de statistiques à une page peut augmenter sa visibilité dans les réponses génératives jusqu’à 40 %. Un simulateur qui ne teste qu’un seul moteur passera complètement à côté de cette différence, et vous optimiserez les mauvais signaux sans vous en rendre compte.
Que faut-il attendre du support et de la documentation ?
Les outils open source comme CatalogReady s’accompagnent d’un readme GitHub et de l’activité communautaire entourant le projet. Cela convient si vous êtes à l’aise pour lire des définitions de règles dans le code et corriger vous-même les erreurs JSON-LD, mais cela vous laisse sans interlocuteur lorsqu’un correctif ne se comporte pas comme prévu.
Les plateformes commerciales varient énormément sur ce point, et la différence apparaît très vite lorsqu’un correctif ne fonctionne pas. Une bonne documentation dans cette catégorie va bien au-delà d’une simple page de fonctionnalités. Elle doit expliquer précisément ce que vérifie chaque ID de règle, montrer un exemple de JSON-LD avant et après correction et proposer un canal de support qui comprend spécifiquement le comportement des agents plutôt que le SEO ecommerce général. Une équipe support capable d’expliquer pourquoi PerplexityBot se comporte différemment de OAI-SearchBot a plus de valeur qu’une équipe qui se contente de suivre un script générique de tickets.
Renseignez-vous sur la fréquence des mises à jour avant de vous engager avec une plateforme. Le comportement des agents évolue lorsque les fournisseurs mettent à jour leurs modèles, et un outil dont la documentation n’a pas suivi la version actuelle de ChatGPT Shopping ou de la recherche produit de Gemini teste une cible mouvante avec une carte obsolète. L’approche par checklist des données structurées , qui consiste à maintenir les recommandations d’implémentation à jour avec les évolutions de schema.org, compte ici davantage que dans la plupart des catégories logicielles, car les agents sous-jacents évoluent plus vite que les recommandations SEO classiques.
À quoi ressemblent concrètement les vrais correctifs ?
Le schéma qui revient dans les correctifs réussis est presque toujours le même : une page qui semblait complète pour un acheteur humain était discrètement invisible pour un agent à cause d’un écart précis et corrigeable. Un prix affiché seulement après un appel JavaScript. Un flux indiquant un produit en stock alors que le schéma de la page disait le contraire. Un GTIN manquant empêchant l’agent d’effectuer une comparaison de prix entre plusieurs marchands.
Les marchands qui ont commencé par un audit déterministe, plutôt que de deviner des correctifs de type SEO, ont constaté de manière constante que le vrai blocage était structurel et non lié au contenu. Réécrire les descriptions produit résout rarement un problème d’accès des robots d’exploration. Aligner votre flux avec les prix affichés sur vos pages, si. Les clients d’ecentic ont signalé des augmentations mesurables à la fois des visites générées par l’IA et des ventes globales après avoir réalisé ce type d’audit et appliqué les correctifs correspondants, ce qui confirme la tendance générale : corriger d’abord la couche lisible par les machines, puis les améliorations du taux de recommandation suivent généralement, parce que l’agent peut enfin lire ce que vous proposez.
La leçon dépasse tous les cas particuliers : les incohérences entre votre page, votre flux et votre schéma constituent un facteur d’exclusion plus important qu’un contenu faible. Les marchands qui poursuivent des ajustements de contenu au niveau des mots-clés avant de corriger ce décalage optimisent la mauvaise couche.
Qu’est-ce qui fait réellement bouger les résultats ?
La plupart des conseils sur la visibilité dans les achats IA la traitent encore comme du SEO traditionnel avec un nouvel acronyme. Ce n’est pas le cas. Le SEO traditionnel récompense des signaux de pertinence accumulés sur plusieurs mois. La visibilité auprès des agents récompense une exactitude structurelle que vous pouvez corriger cet après-midi : votre JSON-LD est-il valide, votre prix correspond-il à votre flux, le robot d’exploration peut-il seulement accéder à la page. C’est un problème fondamentalement différent, et la plupart des marchands continuent de résoudre le mauvais problème.
L’élément souvent négligé est la cohérence, pas le contenu. Une page peut avoir un excellent texte et perdre malgré tout face à un concurrent parce que le prix dans le flux ne correspond pas au prix sur la page. Les agents considèrent cette incohérence comme un problème de confiance et passent à autre chose. Aucun texte persuasif ne peut corriger un désaccord structurel entre vos propres sources de données.
S’il ne fallait faire qu’une chose en premier, lancez un audit déterministe avant de modifier le moindre mot de votre contenu. Corrigez ce que l’audit signale comme défaillant, alignez votre flux, puis testez la même requête sur plusieurs moteurs pour voir si le correctif a réellement changé le résultat. Si vous ignorez le test du taux de victoire, vous optimisez à l’aveugle. Le UCP Playground existe précisément parce qu’un score de préparation ne suffit pas à dire si la recommandation réelle d’un agent a changé, et c’est dans cet écart entre « le score s’est amélioré » et « l’agent m’a choisi » que la plupart des marchands arrêtent leurs analyses trop tôt.
Transformez votre score de préparation en véritable trafic généré par les agents
Réaliser votre propre audit vous indique ce qui est défaillant. Corriger ces problèmes à l’échelle d’un catalogue complet puis prouver que les correctifs fonctionnent, c’est là que la plupart des marchands manquent de temps. ecentic boucle ce processus : la plateforme se connecte directement à Shopify ou WooCommerce, exécute les mêmes diagnostics déterministes décrits plus haut sur l’ensemble de votre catalogue et fournit des correctifs JSON-LD prêts à coller avec des IDs de règle plutôt que des suggestions vagues.

Au-delà de l’audit, le UCP Playground d’ecentic vous permet de simuler la manière dont ChatGPT, Gemini, Claude et Perplexity évaluent n’importe quelle fiche produit en ligne et de tester des modifications avant de les publier. La publication en un clic envoie les correctifs directement dans votre boutique, et les analyses d’attribution suivent les visites et commandes générées par les agents afin de vérifier si un correctif a réellement modifié votre taux de victoire, et pas seulement votre score de préparation. Des clients ont signalé des augmentations mesurables à la fois des visites générées par l’IA et des ventes après avoir suivi ce processus.
Si votre boutique fonctionne sur Shopify, la configuration spécifique à la plateforme se connecte en quelques minutes ; les marchands WooCommerce bénéficient du même parcours d’intégration. Commencez par un scan gratuit de vos fiches produit pour connaître votre score de préparation actuel avant de décider quoi corriger en priorité.
Sources
Pour des tests pratiques au-delà de cet article, CatalogReady propose un auditeur de préparation gratuit, hors ligne, avec score de 0 à 100 et correctifs prêts à coller. Checklist des fiches produit de CrawlConsole détaille les champs exacts vérifiés par les agents. Pour une vue plus large du rôle de l’IA dans l’ecommerce, le récapitulatif des cas d’usage de l’IA par BabyLoveGrowth constitue un bon point de départ.
FAQ
Qu’est-ce qu’un simulateur d’agent d’achat IA ?
C’est un outil qui reproduit la manière dont ChatGPT, Gemini ou Perplexity lisent et évaluent une fiche produit, en vous montrant ce que l’agent voit, ignore et pourquoi il peut choisir un concurrent à la place.
Les simulateurs d’agents IA gratuits sont-ils suffisants pour les petites boutiques ?
Les auditeurs open source comme CatalogReady fonctionnent bien pour vérifier une seule page et ne coûtent rien, mais ils n’exécutent pas de requêtes multi-moteurs en direct et ne suivent pas le trafic généré par les agents dans la durée comme le fait une plateforme complète.
À quelle fréquence faut-il relancer un audit de préparation ?
Relancez votre audit après toute modification de prix, de stock ou de schéma, et au minimum une fois par mois, car le comportement des agents évolue à mesure que ChatGPT, Gemini et Perplexity mettent à jour leurs modèles.
Un simulateur peut-il garantir que mon produit sera recommandé ?
Aucun outil ne peut garantir un classement permanent ; les recommandations des agents évoluent selon la formulation des requêtes et les mises à jour de modèles. Considérez donc toute simulation comme un instantané plutôt qu’une promesse durable.
ecentic fonctionne-t-il avec Shopify et WooCommerce ?
Oui, ecentic se connecte directement aux boutiques Shopify et WooCommerce et applique les correctifs via une publication en un clic après un audit.