

Que les gens cherchent sur Google, aillent sur Amazon ou interrogent un chatbot, l’IA leur donne désormais une réponse avec un produit, et la plupart des marques e-commerce n’ont aucune idée de la manière de devenir ce produit. Le taux de sélection par l’IA est le chiffre qui indique à quelle fréquence c’est le cas. Vous comptez les scénarios d’achat dans lesquels un agent d’achat IA a choisi votre produit comme choix final, vous divisez par l’ensemble des scénarios testés, puis vous multipliez par 100.
À mon sens, c’est la mesure la plus honnête de toute la discussion autour des agents d’achat IA, surtout parce qu’elle est difficile à truquer. Une mention ne coûte pas grand-chose. Un produit peut être cité dans chaque réponse et pourtant perdre la vente à la dernière étape, un peu comme être invité à tous les mariages sans jamais être celui qui se marie. La sélection, c’est le moment où l’agent cesse de lister et commence à choisir.
L’essentiel
- Le taux de sélection par l’IA est le pourcentage de scénarios d’achat testés dans lesquels un agent d’achat IA choisit votre produit comme option finale.
- Définissez ce qui compte comme une sélection avant de mesurer : meilleur choix, gagnant d’une liste restreinte, ajout au panier, début du paiement ou commande finalisée.
- Présentez-le par modèle et avec les dates. Un score agrégé masque le fait que les assistants ne sont pas d’accord entre eux.
- Les petites variations d’une semaine à l’autre relèvent généralement du bruit. Répétez exactement les mêmes requêtes plusieurs fois avant de conclure qu’il y a un changement.
- Le levier le plus rapide, ce sont les données que l’agent lit : flux produit, catalogue et données structurées sur les fiches produit.
Ce que mesure le taux de sélection par l’IA
Un agent d’achat IA ne parcourt pas votre page d’accueil. Il lit votre flux produit, votre catalogue et les données structurées de vos fiches produit, compare ce qu’il trouve aux offres concurrentes, puis répond avec un produit, ou avec une courte liste assortie d’un favori. Le taux de sélection mesure à quelle fréquence ce favori est le vôtre.
La formule est simple :
taux de sélection = scénarios où votre produit a été sélectionné / nombre total de scénarios analysés × 100
Un scénario est une demande d’achat, par exemple « un sérum à la vitamine C pour peau sensible à moins de 40 $ » ou « deux bouteilles d’un single malt précis, livrées au Texas ». Vous en rédigez une série pour vos produits, vous les exécutez, puis vous enregistrez le résultat.
Voici un exemple fictif, juste pour montrer le calcul. Vous testez un produit sur 40 scénarios. L’agent le choisit dans 8 cas. Le taux de sélection de ce produit est donc de 20 %. Si votre concurrent le plus proche est choisi dans 18 cas, son taux est de 45 %, et les autres scénarios sont allés vers d’autres vendeurs ou vers personne. C’est sur cet écart qu’il faut travailler.
Notez bien ce que ce chiffre n’est pas. Ce n’est ni du trafic ni une commande. C’est la décision de l’agent, c’est-à-dire l’étape qui arrive juste avant l’un ou l’autre.
Décider de ce qui compte comme une sélection
C’est là que la plupart des équipes deviennent approximatives, et c’est là que le chiffre cesse d’avoir du sens. « Sélectionné » peut vouloir dire au moins cinq choses différentes :
- L’agent cite votre produit comme la meilleure option.
- L’agent choisit votre produit dans une liste restreinte d’offres.
- L’agent ajoute votre produit au panier.
- L’agent démarre le paiement.
- L’agent finalise un achat pour l’acheteur.
Ce sont les étapes d’un même entonnoir, et elles donnent des taux très différents. La première est large. La dernière est stricte et, aujourd’hui, n’est possible que dans quelques endroits. L’achat directement dans la réponse de l’IA est déjà actif sur Google AI Mode et Gemini aux États-Unis via UCP, le standard ouvert de Google pour le parcours de paiement par agent. ChatGPT redirige l’acheteur vers le paiement propre à la boutique ; pour ChatGPT, l’événement final réaliste est donc que l’agent choisisse votre produit et que l’acheteur clique.
Mon conseil : choisissez une seule définition, consignez-la par écrit et ne la changez jamais en cours de trimestre. Si vous déclarez « meilleure option citée » ce mois-ci puis « ajout au panier » le mois suivant, vous prendrez une baisse pour une hausse, ou l’inverse.
Comment le calculer et le suivre
Vous n’avez pas besoin d’une équipe de data science. Vous avez besoin de rigueur. Voici les étapes que je suivrais.
- Choisissez vos produits. Commencez par les dix plus importants, selon la marge ou le volume.
- Rédigez les scénarios. Pour chaque produit, rédigez des demandes d’achat réalistes, formulées comme le feraient vos acheteurs. Incluez les limites de prix, les cas d’usage, les lieux de livraison et les variantes. Figez la liste avant de la lancer, pour ne pas pouvoir écarter discrètement les requêtes qui ont mal tourné.
- Identifiez le concurrent. Les agents choisissent entre plusieurs options : chaque scénario doit donc inclure un produit concurrent. Utilisez ceux que vos clients comparent réellement.
- Exécutez chaque scénario plusieurs fois, sur chaque modèle. Une seule exécution ne prouve rien, car le même prompt peut produire une réponse différente à l’essai suivant.
- Consignez le modèle, sa version et la date à côté de chaque résultat. Les mises à jour des modèles peuvent rebattre les cartes du jour au lendemain.
- Calculez le taux par modèle et par produit. Vous pouvez ensuite ajouter, si vous le souhaitez, une vue d’ensemble du portefeuille.
- Corrigez les données, puis relancez les mêmes scénarios. Comparez ce qui est comparable.
Le faire à la main fonctionne pour une poignée de produits. On s’en lasse vite. Dans ecentic, l’équivalent est automatisé : l’outil se connecte à Shopify, WooCommerce ou à un flux produit, fait comparer chaque produit par ChatGPT, Claude et Gemini face à celui d’un concurrent nommé, et montre pourquoi votre produit perd. Précision importante : il s’agit d’acheteurs simulés, pas réels. Un meilleur taux dans une simulation indique donc comment les agents lisent vos données, pas une prévision de commandes.
Taux de sélection versus mentions, visites référées et conversions
Les équipes les confondent en permanence, donc voici la différence, côte à côte.
| Indicateur | Ce qu’il mesure | Proximité avec l’achat |
|---|---|---|
| Taux de mention | La fréquence à laquelle votre marque ou produit est cité dans une réponse | Loin. Citer n’est pas choisir |
| Taux de recommandation | La fréquence à laquelle il est suggéré comme bonne option | Plus proche, mais une liste peut avoir cinq gagnants |
| Taux de sélection | La fréquence à laquelle c’est le choix final parmi les options | Proche. C’est la décision |
| Visites référées par une IA | Les visites provenant d’un assistant IA | Après la décision, si l’acheteur clique |
| Conversion | Les commandes issues de ces visites | Le résultat |
Un produit peut apparaître dans de nombreuses réponses et tout de même perdre à l’étape finale. Les raisons sont généralement banales : un prix plus élevé, une livraison plus lente, une variante manquante, des conditions de retour moins avantageuses, des avis moins solides ou des données produit incomplètes ou obsolètes. Une marque peut très bien se classer dans la recherche classique et pourtant être exclue de la décision de l’IA ; c’est l’écart que des exemples d’IA dans l’e-commerce abordent lorsqu’ils décrivent comment la recherche et les réponses générées par l’IA se recoupent désormais.
Une autre distinction importante : une sélection simulée n’est pas une vente. Les visites de référence sont réelles, la sélection simulée est un test, et le chiffre d’affaires est une mesure distincte. Gardez-les dans des colonnes séparées. Si vous voulez une analyse plus détaillée de la mesure du trafic provenant des agents, je l’ai développée dans notre guide sur l’analytics IA pour l’e-commerce.
Pourquoi il faut un taux par modèle, et non un score unique
Les assistants ne sont pas d’accord entre eux, et ils ne sont même pas cohérents entre leurs propres versions. Une étude universitaire de 2025, What Is Your AI Agent Buying?a fait passer des agents par le même assortiment de produits. Dans la catégorie des montres connectées de fitness, Claude Sonnet 4 a choisi un modèle Fitbit 45 % du temps, tandis que GPT-4.1 et Gemini 2.5 Flash l’ont choisi environ 25 % du temps. La part est ensuite montée à 77 % avec Claude Opus 4.5 et tombée à 6 % avec GPT-5.1.
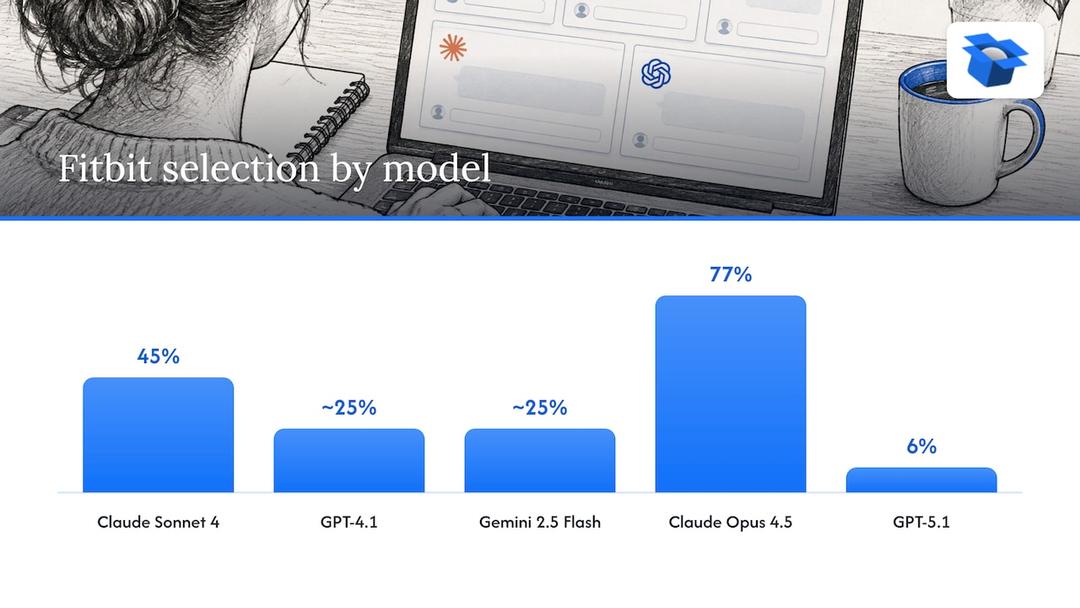
Relisez cela deux fois. Mêmes produits, même rayon, gagnants complètement différents selon le modèle interrogé. Une moyenne agrégée de ces chiffres ne décrirait aucun acheteur réel.
Nos propres simulations montrent la même fragmentation. En octobre 2026, nous avions exécuté 36 797 achats simulés. Sur le même catalogue, ChatGPT choisissait le produit environ 3 fois plus souvent que Claude ou Gemini, avec 51,6 % contre environ 18,5 %. Je ne prétendrai pas connaître la raison à chaque fois. Je pense qu’une partie de l’explication vient du fait que chaque modèle pondère différemment le prix, les noms de marque et l’exhaustivité des données. Le point pratique est simple : rapportez chaque assistant sur sa propre ligne, avec une date.
Cela change aussi ce que vous faites ensuite. Si vous perdez sur un modèle et gagnez sur un autre, vous avez un diagnostic précis au lieu d’une vague impression que « l’IA ne nous aime pas ».
Ce qui fait évoluer le taux
L’agent ne connaît que ce que vos données lui indiquent. Les principaux facteurs sont donc les moins spectaculaires.
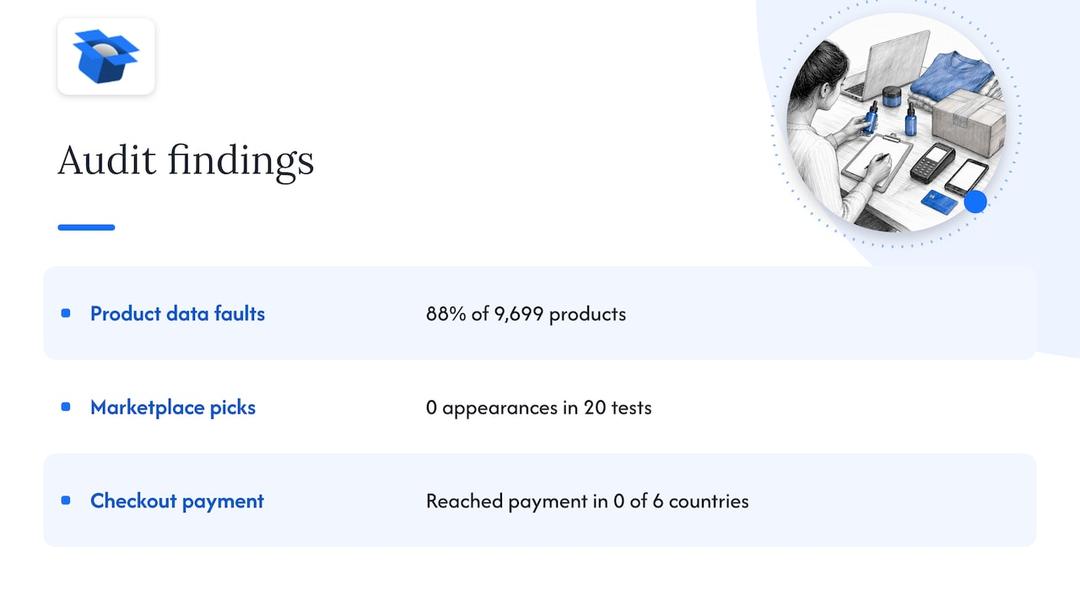
Défauts dans les données produit. Un titre qui indique « Sérum 30ml » ne donne à un agent aucun élément pour répondre à une demande concernant les peaux sensibles. Une description rédigée pour une affiche plutôt que pour aider à une décision pose le même problème. Lors d’un audit anonyme, une marketplace de spiritueux réalisant environ 70 M€ par an présentait un défaut dans les données lues par les agents sur 88 % de ses 9 699 produits. Lorsque des agents ont demandé où acheter deux bouteilles qu’elle stocke, elle est apparue 0 fois sur 20. Excellent catalogue, rayon invisible.
Données structurées. C’est la couche lisible par machine d’une fiche produit : prix, disponibilité, marque, identifiants, détails de livraison et de retour. Les agents s’y appuient parce qu’elle est sans ambiguïté. Des champs manquants ou contradictoires font vite perdre.
Comparaison avec les concurrents. Les agents évaluent rarement votre produit seul. Ils le mettent à côté d’un autre. Si la fiche du concurrent indique un cas d’usage, un matériau et une politique de retour, et que la vôtre ne le fait pas, le concurrent gagne. C’est pourquoi nous demandons aux modèles de comparer chaque produit à un concurrent nommé et d’expliquer le résultat en langage clair.
Position et ordre. Les recherches sur la sélection par les agents ont montré que les modèles peuvent être influencés par la position d’un produit dans la liste. Si vous testez, randomisez l’ordre des options, sinon vous mesurerez la mise en page et non le produit.
Le paiement lui-même. La sélection ne s’arrête pas au choix. Lors d’un autre audit anonyme, les parcours de paiement par agent d’une marque suédoise de soins de la peau ont atteint l’étape du paiement dans 0 des 6 pays, parce qu’un paramètre de livraison demandait un numéro de téléphone. Un agent ne peut pas en inventer un ; la commande a donc échoué. Si votre objectif est de vendre et pas seulement d’être choisi, le parcours d'achat fait partie des données produit.
Pour comprendre le fonctionnement de ces agents, comment les agents d’achat IA recommandent des produits explique ce qu’ils lisent et dans quel ordre. Pour la partie fiche produit, voir Optimisation des fiches produit par IA.
Comment interpréter une variation du taux
Votre taux est passé de 20 % à 25 %. Bonne nouvelle ou simple bruit statistique ? Généralement du bruit, jusqu’à preuve du contraire.
Trois habitudes aident. D’abord, utilisez un échantillon suffisant : si chaque scénario n’a été exécuté qu’une seule fois, une variation de quelques points revient à lancer une pièce. Exécutez de nombreux essais indépendants par modèle. Ensuite, regardez l’ampleur du changement et sa variabilité potentielle, pas seulement s’il est « significatif ». Une variation minime avec une large marge d’erreur ne vous apprend rien. Enfin, associez chaque comparaison à une version de modèle. Si un fournisseur a mis à jour son modèle entre vos deux tests, vous comparez peut-être deux acheteurs différents.
Quand vous modifiez quelque chose, par exemple 20 titres réécrits, relancez les mêmes scénarios fixes sur les mêmes modèles et comparez uniquement ces produits. Si les produits modifiés évoluent et que les autres restent stables, vous avez un vrai signal. C’est ce qui se rapproche le plus d’une expérience contrôlée pour un propriétaire de boutique.
Notre point de vue
Je pense que le taux de sélection deviendra une ligne standard des rapports e-commerce dans les prochaines années, et je pense que la plupart des marques le découvriront d’abord de manière désagréable : en constatant qu’elles obtiennent un score proche de zéro.
Nous avons construit ecentic autour d’une conviction. L’agent ne voit jamais votre page d’accueil. Il lit le flux produit, le catalogue et les données structurées, et sur Google AI Mode et Gemini aux États-Unis il peut même finaliser l’achat pour l’acheteur via UCP. Le travail doit donc se faire dans la boutique elle-même, pas dans un tableau de bord qui signale un problème sans le résoudre.
C’est pourquoi notre processus se termine par une action. Nous faisons comparer chaque produit par ChatGPT, Claude et Gemini à celui d’un concurrent identifié, montrons pourquoi le vôtre perd, et lorsque vous cliquez sur Apply, ecentic réécrit le titre, la description et les données structurées puis les publie dans votre boutique. Sur Shopify, nous envoyons les corrections vers Google Merchant Center et suivons les visites provenant des assistants IA. Sur WooCommerce, le plugin gratuit ecentic permet aux agents de rechercher, d’ajouter des produits au panier et de finaliser un achat via UCP. La finalisation de l’achat est précisément ce que les outils de flux classiques ne font pas.
Je vais être clair sur les limites. Nous en sommes au début, nous menons des pilotes, et notre premier client, DUA Flavours, a vu les visites provenant des assistants IA et le trafic direct augmenter de 12 % entre avril et juillet 2026. Il s’agit d’un chiffre de visites, pas d’un chiffre de ventes, et je préfère le préciser plutôt que vous laisser en déduire davantage.
OpenAI a ACP, Google a UCP, Amazon a un mur. Quelle que soit l’issue, la boutique avec des données produit propres et complètes sera celle auprès de laquelle un agent pourra réellement acheter.
Xhurian Shaba
Trouvez votre propre chiffre
Le moyen le plus rapide de savoir où vous en êtes est de lancer l’analyse. ecentic aide les boutiques en ligne à vendre lorsque les agents IA font les achats : la plateforme optimise leur flux produit et leur catalogue pour que ces agents choisissent leurs produits et puissent réellement les acheter. Décrochez la vente lorsque l’IA fait les achats.
L’analyse gratuite couvre vos 10 meilleurs produits et ne nécessite pas de carte bancaire. Si vous souhaitez corriger ce qu’elle détecte, les offres sont publiées sur la page des tarifs d’ecentic : Compete coûte 14,90 $ par mois pour jusqu’à 100 produits, Scale coûte 44,90 $ par mois pour jusqu’à 1 000 produits avec corrections en un clic, et Dominate coûte 149 $ par mois et ajoute la synchronisation avec Google Merchant Center ainsi que la configuration du paiement par agent. Une option de paiement à l’usage est également disponible à 3 % des commandes attribuées à l’IA, plafonnée à 500 $ par mois.

Si vous voulez voir comment fonctionne le processus avant de vous inscrire, comment fonctionne ecentic présente étape par étape la simulation, le diagnostic et l’optimisation.
FAQ
Qu’est-ce qu’un bon taux de sélection par IA ?
Il n’existe pas de référence universelle crédible, car le taux dépend de votre catégorie, de vos concurrents, des scénarios que vous avez rédigés et du modèle que vous testez. Un objectif plus utile consiste à dépasser le concurrent nommé contre lequel vous perdez le plus souvent, sur chaque assistant, et à voir votre propre chiffre progresser après correction des données. Considérez avec prudence toute « moyenne sectorielle » unique.
Quelle différence entre le taux de sélection par IA et la visibilité IA ?
La visibilité signifie généralement que vous êtes mentionné ou listé. La sélection signifie que l’agent a choisi votre produit plutôt que les autres options. Une marque peut être souvent citée et tout de même perdre au moment du choix final ; la sélection est donc beaucoup plus proche de la décision d’achat.
À quelle fréquence faut-il vérifier son taux de sélection par IA ?
Vérifiez après chaque modification et conservez des scénarios identiques entre les tests. Les modèles évoluent ; datez donc chaque résultat et notez la version du modèle. Les variations hebdomadaires sans changement de votre côté relèvent principalement du bruit statistique.
Un taux de sélection plus élevé signifie-t-il plus de ventes ?
Pas automatiquement. Une sélection simulée teste la manière dont les agents lisent vos données, pas une vente réelle. C’est un indicateur avancé solide, mais les commandes dépendent aussi du prix, de la livraison, du paiement et du fait que l’acheteur termine ou non son achat. Mesurez séparément les visites de référence et les commandes.
Articles recommandés
Sujets à explorer