

L’analyse concurrentielle par IA s’appuie sur les grands modèles de langage, les embeddings et des pipelines de données automatisés pour extraire des signaux concurrentiels depuis des dizaines de sources, les synthétiser en insights rédigés en langage clair, puis envoyer directement ces insights dans les canaux Slack, les tableaux de bord et les battle cards que votre équipe consulte réellement. Elle remplace le PDF trimestriel que personne ne lit par quelque chose qui ressemble davantage à un flux en direct. Si vous démarrez aujourd’hui, faites trois choses dans l’heure qui vient :
- Choisissez cinq sources de données auxquelles vous pouvez accéder légalement dès maintenant (site concurrent, page de prix, avis App Store, un site d’offres d’emploi, une bibliothèque publicitaire).
- Lancez un seul crawl ou une collecte manuelle sur un concurrent, puis collez le texte brut dans ChatGPT ou Claude avec un prompt de synthèse.
- Transformez cette synthèse en note d’une page et envoyez-la à la personne responsable du positionnement dans votre équipe.
Cette dernière étape est le gain rapide à tester cette semaine : prenez un concurrent, une heure et une synthèse IA, puis vérifiez si le résultat change réellement une décision. Si c’est le cas, vous aurez validé l’approche avant de dépenser le moindre dollar en outils.
À retenir
L’analyse concurrentielle par IA fonctionne lorsque la collecte structurée des données alimente un système de scoring qui n’envoie que les signaux prioritaires dans des formats que les équipes utilisent déjà, comme les battle cards et les alertes Slack.
| Point | Détails |
|---|---|
| Commencez avec cinq sources | Choisissez les prix, les avis, les publicités, les pages produit et les offres d’emploi avant d’en ajouter d’autres. |
| Normalisez avant d’automatiser | Structurez le texte extrait dans des champs cohérents pour que les synthèses de votre LLM restent précises. |
| Évaluez les signaux, ne réagissez pas à tous | Utilisez une formule pondérée afin que seuls les changements à fort impact déclenchent une revue transversale. |
| Intégrer les insights aux workflows existants | Les battle cards et alertes Slack sont utilisées ; les rapports statiques, beaucoup moins. |
| Analyser séparément la visibilité auprès des agents IA | ecentic simule la manière dont ChatGPT, Gemini, Claude et Perplexity évaluent vos fiches produit face à celles des concurrents, un signal que les outils de veille concurrentielle généralistes ne couvrent pas. |
Qu’est-ce que l’IA apporte réellement à l’analyse concurrentielle ?
La réponse est simple : de la vitesse et de la synthèse, pas de la magie. Une tâche qui prenait auparavant deux jours à un analyste (lire dix sites concurrents, catégoriser les fonctionnalités, rédiger une synthèse) ne demande plus que quelques minutes à un LLM une fois les données collectées. Le goulot d’étranglement passe de « tout lire » à « s’assurer que les données d’entrée sont propres ».
Voici ce que l’analyse concurrentielle pilotée par l’IA améliore réellement par rapport à une recherche manuelle :
- Analyses comparatives plus rapides. Un LLM peut comparer les listes de fonctionnalités, les niveaux tarifaires et les messages marketing de cinq concurrents dans un seul prompt, au lieu de cinq documents séparés.
- Synthèse multi-sources. La génération augmentée par récupération (RAG) permet de poser une seule question et d’extraire simultanément des informations depuis des pages tarifaires, des avis et des offres d’emploi, au lieu d’assembler manuellement les sources.
- Surveillance automatisée. Les crawls programmés détectent un changement de prix ou une nouvelle fonctionnalité le jour même où cela arrive, et non quand quelqu’un pense à vérifier.
- Battle cards exploitables. Au lieu d’un mur de puces, un modèle correctement guidé peut produire des formulations du type « si un prospect mentionne X, répondez Y », directement utilisables par les équipes commerciales.
- Contexte persistant. Une base de données vectorielle permet de comparer automatiquement chaque nouvelle donnée à l’historique, afin de voir des tendances et pas seulement des instantanés.
Rien de tout cela n’est gratuit. Deux modes d’échec reviennent constamment, et il vaut mieux les signaler avant de construire quoi que ce soit.
Qualité des données et éthique du scraping. Scraper fréquemment le site d’un concurrent peut enfreindre ses conditions d’utilisation, et récupérer des avis depuis des plateformes qui limitent la collecte automatisée peut créer un risque juridique. Vérifiez toujours le fichier robots.txt, les limites de requêtes et les conditions d’utilisation avant d’automatiser la collecte, et privilégiez les API officielles lorsqu’elles existent.
Risque d’hallucination. Les LLM peuvent inventer avec assurance une fonctionnalité ou se tromper sur un prix si le texte source est ambigu ou incomplet. C’est la principale raison pour laquelle l’analyse concurrentielle par IA échoue en pratique : les équipes font confiance à un résumé généré par IA sans le vérifier par rapport à la page source réelle.
Une validation humaine reste indispensable pour tout contenu destiné à une battle card utilisée face aux clients ou à une présentation de direction. Considérez les résultats de l’IA comme un brouillon relu par un analyste, pas comme un produit final. Les tests d’Orbit Media sur les méthodes rapides de scoring par IA ont montré que cette approche fonctionne bien pour des comparaisons relatives mais bénéficie toujours d’une vérification humaine de cohérence sur les affirmations sous-jacentes.
Comment mettre en place un workflow d’analyse concurrentielle piloté par l’IA ?
Le workflow comporte huit étapes, et ignorer celles du milieu (normalisation, embeddings) explique pourquoi la plupart des équipes finissent avec une pile de captures d’écran plutôt qu’un système opérationnel.
- Découverte. Listez tous les concurrents qui méritent d’être suivis, classés par niveau de menace. Ne suivez pas vingt entreprises avec la même rigueur que vos trois principaux concurrents.
- Collecte des données. Collectez les données depuis les sources de la section suivante, selon une fréquence adaptée au rythme de changement de chacune.
- Normalisation. Convertissez le HTML scrapé, les PDF et les captures d’écran en texte structuré avec des champs cohérents (nom du concurrent, date, type de source, contenu brut).
- Embeddings et indexation RAG. Découpez le texte normalisé, générez des embeddings et stockez-les dans une base de données vectorielle afin qu’un LLM puisse récupérer le contexte pertinent à la demande au lieu de tout relire à chaque fois.
- Synthèse par LLM. Demandez à un modèle de générer des synthèses, des comparaisons de fonctionnalités ou des diagnostics de gains/pertes à partir des segments récupérés.
- Scoring. Appliquez une formule de scoring pondérée (détaillée ci-dessous) pour décider quels signaux méritent une attention immédiate et lesquels peuvent attendre un digest mensuel.
- Diffusion. Envoyez les résultats prioritaires vers Slack ou Teams ; orientez les éléments moins prioritaires vers un tableau de bord ou un email hebdomadaire.
- Rythme de revue. Une réunion hebdomadaire ou bimensuelle réunissant marketing, produit et ventes pour examiner les éléments signalés par le système et décider des actions à mener.
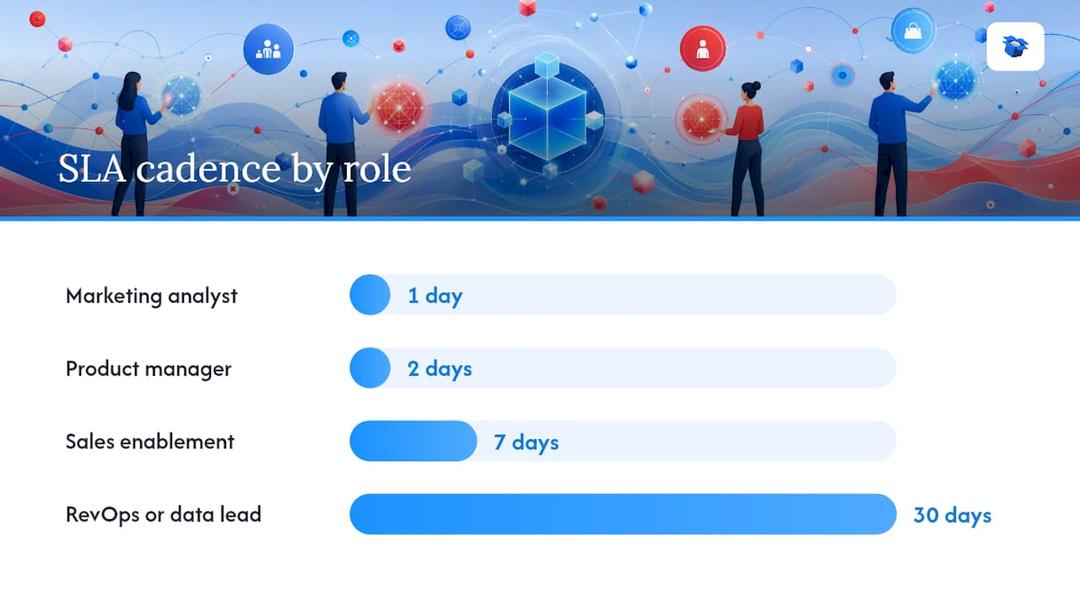
Une matrice simple des responsabilités évite que tout le monde parte du principe que quelqu’un d’autre surveille le sujet :
| Rôle | Tâche | SLA typique |
|---|---|---|
| Analyste marketing | Responsable de la collecte et de la normalisation des données | Vérifications quotidiennes, rapport hebdomadaire |
| Chef de produit | Examine les écarts de fonctionnalités détectés | Réponse sous 48 heures sur les écarts signalés |
| Aide à la vente | Transforme les diagnostics en battle cards | Cycle de mise à jour hebdomadaire |
| Responsable RevOps ou data | Maintient la base vectorielle et les automatisations | Audit mensuel du pipeline |
Chaque sprint doit produire un ensemble cohérent de livrables : une ou deux battle cards mises à jour, une analyse d’une page pour tout concurrent ayant effectué un mouvement majeur, des alertes Slack en temps réel sur les changements de prix ou de fonctionnalités, ainsi qu’une carte de tableau de bord affichant les tendances des 30 derniers jours.
Conseil pratique : Définissez le planning de vos crawlers en fonction de la volatilité, pas de la commodité. Les pages tarifaires et les bibliothèques publicitaires changent vite et méritent des vérifications quotidiennes voire horaires ; les offres d’emploi et les classements SERP évoluent lentement et peuvent être suivis chaque semaine. Vérifier tout chaque heure ne fait qu’augmenter les coûts de calcul et noyer vos alertes dans le bruit.
Quels modèles IA et quels schémas de prompts fonctionnent le mieux ?
L’architecture qui fonctionne réellement ressemble à ceci : des scrapers et API alimentent une couche ETL qui normalise les formats, ce texte normalisé est vectorisé et stocké dans une base de données vectorielle, une couche RAG récupère les segments pertinents lors des requêtes, puis un LLM réalise la synthèse finale avant qu’un outil d’orchestration n’envoie le résultat vers Slack, un tableau de bord ou un CRM.
Utilisez les embeddings et le RAG lorsque vous interrogez une archive importante et en croissance de contenus concurrents (le modèle ne récupère alors que les segments pertinents au lieu de tout traiter à chaque requête). Utilisez un prompting direct du LLM sans récupération pour des tâches ponctuelles, comme résumer une page unique que vous venez de coller. Réindexez votre base vectorielle au même rythme que votre source la plus volatile, généralement chaque jour si vous suivez les prix.
Voici des schémas de prompts qui méritent d’être repris tels quels :
Prompt de synthèse exécutive : « Résumez le contenu de cette page concurrente en un paragraphe destiné à un VP marketing. Concentrez-vous sur les changements de positionnement, les évolutions tarifaires et toute nouvelle affirmation concernant les performances ou le ROI. Signalez tout élément qui semble exagéré ou impossible à vérifier. »
Prompt de génération de battle card : « En utilisant la liste de fonctionnalités et les tarifs ci-joints pour [Competitor], générez une battle card avec les sections suivantes : leurs points forts, leurs points faibles, notre comparaison sur [specific feature], et un argument commercial à utiliser lorsqu’un prospect mentionne ce concurrent dans une négociation. »
Prompt d’extraction de fonctionnalités : « Extrayez un tableau structuré des fonctionnalités à partir de cette page produit. Colonnes : nom de la fonctionnalité, description, disponibilité par niveau d’offre, et indication si elle est nouvelle depuis [last date checked]. »
Prompt de diagnostic gains/pertes : « À partir de cette liste de notes sur des opportunités perdues mentionnant [Competitor], identifiez les trois objections les plus fréquentes et classez-les par fréquence. »
Prompt d’alerte Slack automatisée : « Si le prix indiqué sur cette page a changé par rapport à la dernière valeur enregistrée, générez une alerte Slack en deux phrases indiquant l’ancien prix, le nouveau prix et le pourcentage de variation. »
Les tests d’Orbit Media ont montré que demander à un chatbot IA de noter des concurrents sur une échelle simple de 1 à 10 selon quelques critères produit des comparaisons étonnamment cohérentes et défendables, à condition d’utiliser la même grille d’évaluation à chaque fois. Le secret n’est pas un modèle plus sophistiqué, mais une structure de prompt stable et reproductible que vous ne réécrivez pas chaque semaine.
Comment noter et prioriser les signaux concurrentiels ?
Chaque mouvement d’un concurrent ne mérite pas une alerte Slack et une cellule de crise. Un système de scoring pondéré simple évite à votre équipe de traiter un article de blog mineur comme une baisse de prix majeure.
Attribuez un score à chaque signal entrant selon une échelle pondérée par l’impact potentiel sur l’activité :
- Lancement d’une fonctionnalité correspondant à un cas d’usage clé : poids de 8 à 10 (impact élevé si elle cible votre persona d’acheteur principal).
- Changement de prix : poids de 7 à 9 (plus élevé si cela sous-cote votre offre principale).
- Lancement d’une campagne publicitaire majeure : poids de 5 à 7 (signale un changement dans la génération de demande, intéressant à surveiller mais rarement urgent).
- Hausse soudaine des avis négatifs : poids de 4 à 6 pour les concurrents (signal d’opportunité), de 9 à 10 si cela concerne votre propre produit.
- Nouveau schéma de recrutement (par exemple une forte hausse des recrutements commerciaux) : poids de 3 à 5 (signal précoce, rarement urgent à lui seul).
Définissez des seuils pour transformer le score en action : un score inférieur à 4 part dans un digest mensuel, de 4 à 7 déclenche une synthèse d’une page sous 48 heures, et tout score supérieur à 7 déclenche une revue transverse immédiate avec les équipes produit et ventes.
Une fois moyenné et ajusté pour les cooccurrences, ce signal atteint environ 8,5, bien au-dessus du seuil de revue. La bonne réponse n’est pas une réaction emoji sur Slack. C’est un échange organisé dans la semaine entre les responsables produit, pricing et commerciaux pour décider s’il faut s’aligner, se différencier ou maintenir la position.
Quels outils utiliser pour l’analyse concurrentielle par IA ?
Le bon outil dépend de la partie du workflow que vous cherchez à résoudre, et acheter une suite enterprise tout-en-un dès le premier jour est généralement une erreur pour les petites équipes. Les recommandations de la U.S. Chamber pour les petites entreprises vont dans le même sens : commencez avec une stack légère et ciblée, puis élargissez-la à mesure que votre processus mûrit.
Voici comment se répartissent les catégories d’outils et ce qu’il faut vérifier avant d’engager un budget :
- Scrapers et API : la couche de collecte. Vérifiez la transparence sur les limites de requêtes et s’ils proposent une sortie JSON structurée plutôt qu’un HTML brut que vous devrez parser vous-même.
- Jeux de données SEO et trafic : des outils comme Ahrefs et Semrush fournissent des profils de backlinks, des classements de mots-clés et des estimations de trafic. Semrush, en particulier, regroupe les données de trafic, mots-clés et publicité avec des alertes de suivi intégrées.
- Benchmarking trafic et marché : Similarweb est la référence standard pour estimer les volumes de trafic et comparer les répartitions par canal entre concurrents.
- Social listening : Sprout Social couvre le suivi de l’engagement et du sentiment sur les réseaux sociaux, utile pour détecter l’élan d’une campagne concurrente avant qu’il n’apparaisse ailleurs.
- Fournisseurs de LLM : ChatGPT et Claude sont les deux solutions les plus utilisées pour la synthèse, l’extraction et la rédaction de battle cards, et gèrent suffisamment bien les documents à long contexte pour la plupart des analyses concurrentielles détaillées.
- Plateformes d’analyses automatisées : des outils comme Competely mettent en avant des rapports concurrentiels instantanés et continuellement mis à jour sur un large ensemble de données, ce qui donne un bon aperçu de ce que signifie « automatisé » au niveau reporting.
- Bases de données vectorielles et orchestration : la couche technique qui relie vos données à votre LLM et à vos canaux de diffusion (Slack, tableaux de bord, CRM).
Pour les lecteurs qui évaluent les options, le comparatif d’outils de Zapier constitue une bonne première sélection, et vérifier ensuite cette shortlist avec les avis G2 avant d’engager un budget permet de repérer des signaux d’alerte absents des pages marketing des éditeurs. Si votre activité repose sur l’ecommerce et que votre enjeu principal est de savoir si des agents d’achat IA recommandent vos produits plutôt que ceux d’un concurrent, cela relève d’une catégorie distincte des outils classiques de veille concurrentielle, et c’est précisément là qu’une plateforme comme ecentic entre en jeu.
Assembler l’ensemble : les crawlers et API alimentent la couche ETL, les données normalisées arrivent dans la base vectorielle, la couche RAG récupère le contexte pertinent pour chaque requête, et les outils d’orchestration envoient les résultats du LLM vers le canal où votre équipe les verra réellement.
Comment transformer les insights IA en actions d’équipe ?
Un insight sur lequel personne n’agit ne vaut rien, quelle que soit la qualité du modèle qui l’a généré. L’écart entre « l’IA a signalé quelque chose » et « quelqu’un a changé une décision » est l’endroit où la plupart des programmes de veille concurrentielle meurent discrètement.
Une battle card doit contenir des champs précis pour être utilisable lors d’un appel commercial en direct, et pas seulement informative dans un document : nom et catégorie du concurrent, nos trois principaux différenciateurs, leurs trois principaux atouts, un aperçu comparatif des prix, les objections courantes avec leurs réponses, et une date de dernière mise à jour afin que les commerciaux sachent si le contenu est obsolète. Une approche défensive répond directement à la force d’un concurrent (« ils mettront en avant un onboarding plus rapide, voici notre contre-argument »). Une approche offensive met en avant un avantage qu’ils ne peuvent pas égaler (« mettez en avant notre attribution en temps réel, qu’ils ne proposent dans aucune offre »).
Pour les alertes Slack ou Teams, la structure compte davantage que le volume. Une bonne alerte indique le concurrent, le changement détecté, le lien source et une recommandation d’action en une ligne, envoyée vers le canal responsable de cette décision (les changements tarifaires vont dans un canal pricing, pas dans le canal marketing général).
Attribuer clairement les responsabilités évite que les alertes deviennent un bruit que tout le monde ignore :
- Attribuez un responsable par concurrent, et non un seul responsable de la « veille concurrentielle » dans son ensemble.
- Définissez un SLA de réponse : les alertes prioritaires doivent être reconnues sous 24 heures, les alertes moyennes sous une semaine.
- Exigez qu’à chaque alerte traitée corresponde une note de résultat en une ligne (ce que nous avons fait, ou pourquoi nous avons choisi de ne pas agir).
- Examinez chaque mois le ratio alertes/actions. Si 90 % des alertes sont ignorées, vos seuils de scoring doivent être recalibrés, pas le volume d’alertes augmenté.
Le constat qui revient chez les praticiens du secteur est toujours le même : la veille concurrentielle fonctionne lorsqu’elle est intégrée aux outils déjà utilisés par les équipes, et non stockée dans un dossier que personne n’ouvre.
À quoi cela ressemble-t-il appliqué à l’ecommerce ? Mini étude de cas
Une marque DTC de vêtements de taille intermédiaire a abordé ce problème sous un angle inhabituel : elle ne perdait pas face à ses concurrents dans les résultats Google, mais face à eux dans ChatGPT et Gemini lorsque des acheteurs demandaient des recommandations de produits. L’analyse concurrentielle traditionnelle (classements SEO, dépenses publicitaires, engagement social) ne lui apprenait rien sur les raisons pour lesquelles un agent d’achat IA recommandait systématiquement le produit quasi identique d’un concurrent plutôt que le sien.
La marque a connecté sa boutique Shopify à ecentic afin de lancer des simulations sur la manière dont les agents d’achat IA évaluent ses pages produit face à des concurrents identifiés. Les diagnostics de la plateforme ont mis en évidence des lacunes précises : attributs structurés manquants sur lesquels les agents IA s’appuient pour comparer les matériaux et les tailles, descriptions produit trop légères ne donnant au modèle aucun élément concret à citer, et informations tarifaires difficilement interprétables sur la page.
Grâce aux diagnostics de gains/pertes en langage clair, l’équipe a priorisé les corrections sur ses dix pages produit générant le plus de trafic, plutôt que de tenter une refonte complète du catalogue. Les suggestions de réécriture ont été publiées directement via la publication en un clic d’ecentic dans le back-office Shopify, et les rescans continus de la plateforme ont suivi l’évolution des taux de sélection par les IA sur ces pages lors des cycles de revue suivants.
Résultat indicatif rapporté par les premiers clients de la plateforme : hausse mesurable à la fois des visites générées par les agents IA et des ventes en aval après la mise en œuvre des modifications des fiches produit, même si les chiffres exacts varient selon la boutique et la catégorie, et que chaque marque devrait considérer son propre scan de référence comme point de comparaison, et non une moyenne du secteur.
Les détails d’intégration comptent autant que le résultat. Comme les réécritures étaient publiées directement sur la boutique en ligne, il n’y avait pas d’étape CMS séparée où les recommandations attendaient un développeur. Les rescans se lançaient automatiquement après chaque publication, ce qui permettait à l’équipe de voir en quelques jours, et non en plusieurs mois, si une modification précise d’une page produit améliorait la sélection par les agents IA. Cette boucle de retour est précisément ce que les outils généralistes d’analyse concurrentielle n’offrent pas, car ils n’ont pas été conçus pour simuler la façon dont un LLM lit et classe une page spécifique.
À quoi devraient ressembler vos 90 premiers jours ?
Le déploiement fonctionne mieux en trois phases plutôt qu’en essayant de construire tout le pipeline dès le premier jour.
Jours 1 à 30 (responsable : lead marketing) : Choisissez vos trois à cinq principaux concurrents. Collectez manuellement des données depuis cinq sources clés. Exécutez vos premières synthèses LLM à la main en collant directement le contenu dans ChatGPT ou Claude. Produisez une première battle card.
Jours 31 à 60 (responsable : lead marketing avec une ressource data ou ops) : Automatisez la collecte pour vos deux sources les plus volatiles (généralement les prix et les publicités). Mettez en place une base vectorielle simple. Créez votre première règle d’alerte Slack. Installez la réunion de revue hebdomadaire.
Jours 61 à 90 (responsable : équipe transverse incluant produit et ventes) : Étendez la couverture automatisée à toutes les sources clés. Implémentez la formule de scoring et la cartographie seuil/action. Formalisez les responsabilités et les SLA. Présentez le premier rapport mensuel de tendances à la direction.
Une banque compacte de prompts à garder sous la main couvre les cinq schémas déjà détaillés ci-dessus (synthèse exécutive, génération de battle cards, extraction de fonctionnalités, diagnostics de gains/pertes et génération d’alertes) plus un autre utile dès que vous automatisez : un prompt de normalisation demandant au modèle de convertir le texte scrapé dans une structure JSON cohérente avant son intégration dans votre base vectorielle.
Pour cette structure, un schéma simple convient à la plupart des équipes :
| Champ | Exemple de valeur |
|---|---|
| competitor_name | « Acme Co. » |
| source_type | « pricing_page » |
| source_url | “https://example.com/pricing” |
| date_collected | “2026-02-14” |
| raw_content | “Full extracted text…” |
| change_detected | « true » |
| score | “7.5” |
Alimentez cette structure de manière cohérente et vos synthèses LLM comme votre recherche vectorielle resteront fiables plusieurs mois plus tard, lorsque vous aurez oublié le contexte derrière chaque point de donnée.
Mieux vaut commencer petit que d’attendre le système parfait
La plupart des équipes surconstruisent avant d’avoir prouvé que le workflow apporte de la valeur. Je préfère voir un marketeur faire tourner une version bricolée pendant deux semaines plutôt que passer un mois à évaluer des fournisseurs de bases vectorielles. Commencez avec un concurrent, cinq sources et un seul prompt de synthèse ChatGPT. Si cela ne change aucune décision réelle, aucune automatisation ne résoudra le problème, car le souci n’est pas la vitesse : c’est que personne n’allait agir sur cet insight de toute façon.
Le piège des petites équipes n’est pas le manque d’outillage, mais la dérive progressive de la qualité des données. Vous démarrez avec des enregistrements propres et horodatés provenant de trois sources, et six mois plus tard vous avez un dossier rempli de captures d’écran à moitié étiquetées et un canal Slack plein d’alertes que personne ne lit. La solution n’est pas plus d’automatisation, mais plus de discipline : chaque nouvelle source doit avoir un champ de provenance et une fréquence de collecte définie avant d’être ajoutée, pas après.
Passer d’une seule personne à un programme transverse se fait naturellement dès qu’une première battle card modifie réellement une conversation commerciale ou qu’une première alerte tarifaire déclenche une vraie revue des prix. C’est le signal qu’il faut intégrer officiellement les équipes produit et ventes comme parties prenantes plutôt que simples destinataires de vos rapports. Essayer de construire la matrice de responsabilités avant d’avoir obtenu un seul résultat concret ajoute simplement des processus à un système auquel personne n’adhère encore.
Comment ecentic s’intègre à votre workflow d’analyse concurrentielle par IA
Tout ce guide traite de veille concurrentielle au sens large, mais il existe un champ de bataille pour lequel les outils généralistes n’ont pas été conçus : la manière dont des agents d’achat IA comme ChatGPT, Gemini, Claude et Perplexity décident quel produit recommander lorsqu’un acheteur en demande un. Ecentic simule précisément cette décision et vous montre où vos fiches produit gagnent ou perdent face à des concurrents identifiés dans l’évaluation d’un agent IA, et pas seulement dans un classement de recherche traditionnel.

Ecentic se connecte directement aux boutiques Shopify ou WooCommerce et s’intègre directement au workflow décrit ci-dessus : la plateforme exécute la simulation (collecte des données et scoring, gérés pour vous), fournit des diagnostics de gains/pertes en langage clair (votre couche de synthèse LLM, déjà prête) et vous permet de publier des réécritures de fiches produit en un clic (sans attendre qu’un développeur déploie la correction). Les rescans continus suivent l’évolution de votre taux de sélection par les IA après chaque modification, vous offrant une boucle de retour que les outils SEO ou de social listening généralistes ne mesurent tout simplement pas.
Pour les équipes ecommerce qui appliquent déjà le workflow plus large décrit dans cet article, ecentic gère la source de signal facile à manquer et qui détermine de plus en plus l’origine des ventes : la façon dont vous apparaissez dans les recommandations produit des agents IA. Lancez un scan gratuit de vos fiches produit pour voir comment vos pages actuelles se positionnent face à la concurrence avant de décider quoi corriger en priorité.
Quelle suite donner à votre analyse concurrentielle par IA
Quelques ressources méritent d’être mises de côté pendant la construction de votre propre processus, chacune couvrant une pièce différente du puzzle :
- Le comparatif d’outils d’analyse concurrentielle de Zapier permet de constituer rapidement une première shortlist d’outils par catégorie.
- Le guide de la U.S. Chamber sur les outils IA pour petites entreprises est utile si vous démarrez avec peu de moyens et ne souhaitez pas encore investir dans une suite enterprise.
- Le guide d’Orbit Media sur le scoring alimenté par l’IA fournit des exemples concrets de prompts pour comparer rapidement des marques.
- La suite de recherche concurrentielle de Semrush mérite d’être examinée si vous avez besoin d’un suivi intégré du trafic, des mots-clés et des publicités au même endroit.
- Le guide de Babylovegrowth sur l’analyse du contenu concurrent explique comment extraire systématiquement des signaux SEO et contenu.
Avant d’automatiser un scraper, vérifiez les conditions d’utilisation et le fichier robots.txt du site cible, ainsi que les limites de requêtes API de l’outil choisi, afin d’éviter une révocation d’accès en cours de projet.
Sources
Toutes les sources ne méritent pas le même niveau d’attention. Les pages tarifaires et bibliothèques publicitaires évoluent rapidement ; les offres d’emploi et profils de backlinks beaucoup plus lentement. Adapter votre fréquence de collecte au rythme réel de changement de chaque source est ce qui rend le système utile plutôt que bruyant.
- AI Tools Small Businesses Need for Competitive Analysis | CO
- The AI-Powered Competitive Analysis: 3 Quick Ways to Score Your …
Quelques bonnes pratiques de collecte distinguent les systèmes fiables de ceux qui dérivent discrètement vers des données inutilisables :
Les plateformes d’avis et annuaires d’acheteurs méritent une mention particulière ici. Les sites d’avis comme G2 et Capterra sont utiles non seulement pour votre propre positionnement produit, mais aussi pour comprendre comment les acheteurs parlent des concurrents avec leurs propres mots, ce qui correspond exactement au type de texte non structuré que les LLM traitent bien.
FAQ
Qu’est-ce que l’analyse concurrentielle par IA ?
Il s’agit d’utiliser des LLM, des embeddings et des pipelines de données automatisés pour collecter des signaux concurrentiels à partir de sources comme les pages tarifaires, les avis et les publicités, puis les synthétiser en livrables priorisés et exploitables comme des battle cards et des alertes.
Quels outils IA sont les plus adaptés à l’analyse concurrentielle ?
ChatGPT et Claude sont efficaces pour la synthèse et l’extraction, Semrush et Ahrefs couvrent les données SEO et trafic, Similarweb compare les estimations de trafic, Sprout Social couvre le social listening, et Competely automatise les rapports d’analyse détaillée.
En quoi l’analyse concurrentielle par IA est-elle différente pour l’ecommerce ?
Les marques ecommerce se battent de plus en plus pour leur visibilité au sein d’agents d’achat IA comme ChatGPT et Gemini, et plus seulement dans les classements de recherche. Cela nécessite des outils comme ecentic capables de simuler la manière dont ces agents évaluent et recommandent des fiches produit.
À quelle fréquence faut-il mettre à jour les données concurrentielles ?
Les signaux très volatils comme les prix et les créations publicitaires méritent des vérifications quotidiennes ou hebdomadaires, tandis que les signaux plus lents comme les backlinks et les offres d’emploi peuvent être suivis mensuellement.
Le scraping de sites concurrents est-il légal ?
Cela dépend des conditions d’utilisation du site, des données collectées et de votre juridiction. Vérifiez toujours le fichier robots.txt et les conditions d’utilisation, et privilégiez les API officielles lorsqu’elles sont disponibles.
Les petites équipes peuvent-elles faire cela sans outils enterprise ?
Oui. Combiner des sources publiques comme les données SERP, les bibliothèques publicitaires et les offres d’emploi avec une couche de synthèse pilotée par LLM permet déjà d’obtenir des signaux utiles sans suite enterprise tout-en-un dès le premier jour.