

L’analytique du trafic piloté par des agents consiste à capter, classifier et attribuer les requêtes effectuées par des acteurs non humains, puis à mesurer les tâches que ces agents accomplissent pour le compte de mandants humains. Elle remplace la session comme unité de mesure par un modèle plus simple : acteur, tâche, résultat.
Si vos tableaux de bord affichent encore une ligne plate pour le « trafic bot » à côté d’une part croissante de visites d’agents IA sans aucune donnée de conversion associée, vous ne mesurez pas ce qui se passe réellement sur votre site. Les agents d’achat de ChatGPT, Gemini et Perplexity lisent des pages produit, comparent des caractéristiques et transmettent des recommandations à des acheteurs qui, eux-mêmes, ne font jamais défiler la page au-delà de la ligne de flottaison. Votre pile analytique ignore probablement totalement que cela se produit.
Trois actions corrigent rapidement les plus gros angles morts :
- Activez le transfert des logs CDN ou edge afin de capter les requêtes qui ne chargent jamais de navigateur et ne déclenchent aucun tag JavaScript.
- Ajoutez une propriété
actorau point d’ingestion, étiquetée comme humaine, agent ou crawler, avant même que les données n’atteignent un tableau de bord. - Acheminez ces logs vers un entrepôt de données plutôt que vers un outil côté client, afin de pouvoir relier les événements des agents à leurs résultats dans le temps.
Les lectures par des agents ont souvent lieu bien avant un achat et pré-informent un acheteur qui arrive avec une décision déjà prise. C’est un chiffre d’affaires que votre configuration analytique historique attribue actuellement au trafic « direct » ou ne voit pas du tout.
À retenir
L’analytique du trafic piloté par des agents fonctionne lorsque les équipes remplacent les métriques de session par un modèle acteur, tâche et résultat, soutenu par une capture côté serveur et une journalisation liée à l’identité.
| Point | Détails |
|---|---|
| Capturer d’abord en périphérie | Le transfert des logs CDN et des journaux en périphérie capte la majorité des requêtes d’agents qui contournent entièrement le JavaScript côté client. |
| Abandonner les métriques de session pour les agents | Le taux de rebond et la profondeur de défilement n’ont aucun sens pour des acteurs non humains ; utilisez plutôt acteur, tâche et résultat. |
| Mesurer l’accomplissement des tâches, pas les pages vues | Définissez les critères de réussite pour la récupération, les parcours de formulaire et les intégrations avant de publier la moindre métrique d’accomplissement. |
| Combler délibérément l’écart d’attribution | Des protocoles canary et des logs immuables liés à l’identité réduisent l’exposition juridique et d’audit liée aux actions d’agents non autorisées. |
| Optimiser ce que les agents lisent réellement | Ecentic simule les évaluations d’agents IA d’achat sur les pages produit et signale les facteurs précis qui favorisent ou bloquent les recommandations. |
Ce qu’est le trafic piloté par des agents et pourquoi les métriques de session échouent
Trois types d’acteurs sollicitent aujourd’hui vos serveurs, et leur comportement n’a rien de comparable. Un humain navigue de façon interactive, avec des pauses, du défilement et des mouvements de souris. Un crawler indexe du contenu pour alimenter un corpus, généralement sans intérêt pour une tâche spécifique. Un agent agit au nom d’une personne, récupère une page, extrait des données et accomplit souvent une tâche comme une comparaison ou une étape d’achat, sans jamais afficher visuellement la page.
Les métriques web standard supposent qu’un humain se trouve à l’autre bout. Cette hypothèse s’effondre immédiatement avec les agents.
- Taux de rebond ne signifie rien lorsqu’un agent récupère une seule page, extrait le prix et le tableau des caractéristiques, puis repart. La tâche est accomplie, ce n’est pas une visite abandonnée.
- Temps passé sur la page ne peut pas s’appliquer à une requête qui se termine en quelques millisecondes puisqu’il n’y a ni rendu, ni lecture, ni défilement.
- Profondeur de défilement nécessite une fenêtre d’affichage. Les agents headless qui effectuent des appels HTTP bruts n’en génèrent jamais.
La solution consiste à adopter un tout autre modèle mental : acteur, tâche, résultat. Vous classez l’auteur de la requête, définissez ce qu’il essayait de faire et enregistrez s’il a réussi. Ce cadre fonctionne que l’acteur soit un acheteur, un crawler ou un agent autonome comparant cinq concurrents avant de recommander un produit à un acheteur.
Comment fonctionnent réellement la détection et la capture des agents
La plupart des activités des agents sont invisibles pour les outils auxquels les équipes marketing font déjà confiance. C’est la partie inconfortable. Google Analytics, les tags Adobe Analytics et la plupart des configurations de gestionnaire de tags dépendent de l’exécution de JavaScript dans un navigateur. Le trafic des agents contourne de plus en plus complètement cette étape.
La capture côté serveur et en edge est ce qui intercepte réellement ce trafic. Les données télémétriques des fournisseurs montrent qu’environ 59 % du trafic des agents ChatGPT arrive via des clients HTTP bruts qui n’exécutent jamais de script, ce qui signifie que les outils d’analyse côté client manquent plus de la moitié de l’activité par conception, et non par accident. Si toute votre instrumentation se trouve dans un gestionnaire de tags, vous ne mesurez qu’une part de plus en plus réduite de ce qui se passe réellement.
Les logs CDN et edge résolvent ce problème parce qu’ils enregistrent chaque requête qui atteint votre infrastructure, qu’un navigateur affiche ou non le moindre pixel. C’est à ce niveau que commence réellement l’analyse du trafic piloté par des agents.
Quelques signaux permettent de distinguer de façon fiable les agents des humains et des bots génériques lorsque vous analysez les logs bruts :
- Chaînes user-agent déclarées. De nombreux agents s’identifient honnêtement, du moins pour l’instant, avec des chaînes faisant référence au modèle ou à la plateforme à l’origine de la requête.
- Ratios ressources/requêtes. Lorsqu’un humain charge une page, des dizaines d’images, polices et scripts sont récupérés. Un agent qui extrait des données structurées ne demande souvent que le HTML ou une charge utile JSON.
- Absence de beacon. L’absence de déclenchement d’un pixel analytics lors d’une vue de page pourtant clairement visible côté serveur constitue en soi un signal.
- Modèles d’en-têtes et de timing. Les agents ont tendance à demander des pages à vitesse machine, avec des ordres d’en-têtes et une entropie temporelle différents du comportement typique d’un navigateur.
- llms.txt et ressources structurées. Un nombre croissant de sites publient désormais un fichier llms.txt aux côtés de schémas OpenAPI, offrant aux agents (et à vos logs) une interface documentée et déclarée permettant de vérifier les requêtes.
La validation des plages IP déclarées des modèles ou la comparaison des chaînes de requête avec la documentation publiée des fournisseurs ajoute une couche de confiance supplémentaire, même si cela n’est jamais totalement fiable à lui seul.
Conseil pro : Ne vous fiez pas uniquement aux chaînes user-agent. Associez-les à un scoring fondé sur le ratio ressources/requêtes afin qu’une chaîne falsifiée soit tout de même signalée si le modèle de requête ne correspond pas à une véritable session de navigateur.
Les métriques clés qui montrent réellement l’impact des agents
Créer des rapports sur le trafic des agents avec des pages vues et des sessions donne aux parties prenantes des chiffres impressionnants ou alarmants pour de mauvaises raisons. Les métriques pertinentes suivent les requêtes, les tâches et les résultats métier, pas les visites.
| Métrique | Ce qu’elle indique |
|---|---|
| Part des requêtes provenant d’agents | Pourcentage des requêtes totales par page et par modèle, révélant quelles pages les agents consultent réellement |
| Taux d’achèvement des tâches | Indique si la récupération, le parcours de formulaire ou l’appel d’intégration d’un agent s’est terminé avec succès |
| Taux de relais agent-vers-humain | Fréquence à laquelle la session d’un agent se transforme en visite ou achat effectué par un humain |
| Taux de blocage/erreur par acteur | Fréquence à laquelle les agents sont limités, bloqués ou reçoivent des erreurs par rapport aux humains |
| Coût opérationnel au niveau du modèle | Utilisation des tokens, latence et taux d’erreur par modèle accédant à votre infrastructure |
L’achèvement des tâches nécessite une définition concrète avant de pouvoir être mesuré. Une tâche de récupération réussit lorsqu’un agent extrait les données recherchées, comme le prix ou la disponibilité. Une tâche de parcours de formulaire réussit lorsqu’un processus en plusieurs étapes, comme l’ajout au panier, se termine sans erreur. Une tâche d’intégration réussit lorsqu’un appel de type API renvoie une réponse valide et exploitable. Définissez ces notions dès le départ, sinon la métrique ne sera qu’un bruit sans valeur.
Les conversions assistées par des agents méritent leur propre ligne dans chaque rapport. Les guides qui les suivent correctement montrent que le trafic référé par des agents peut convertir plusieurs fois mieux que le trafic organique générique une fois isolé et mesuré correctement, au lieu d’être fondu dans une catégorie « autre » indifférenciée. C’est ce chiffre qui attire l’attention d’un CFO, pas le volume brut de requêtes.
- Détaillez la part des agents par modèle individuel, et pas seulement dans une catégorie agrégée de type « bot ».
- Présentez ensemble le taux d’achèvement des tâches et le taux de relais. L’un sans l’autre masque si le trafic des agents produit réellement quelque chose d’utile.
- Suivez séparément les taux de blocage et d’erreur des agents et ceux des humains. Un pic à ce niveau signale souvent une règle de pare-feu mal configurée, et non un trafic malveillant.
Construire le pipeline : schéma, balisage et stockage
Déployer une analyse du trafic piloté par des agents est avant tout un problème d’infrastructure avant d’être un problème d’analyse. Voici l’ordre qui fonctionne en pratique.
- Activez d’abord le transfert des logs CDN. Capturez des champs comme l’horodatage, la chaîne user-agent complète, le chemin de requête, le code de réponse, la taille en octets et toute donnée d’empreinte TLS exposée par votre CDN.
- Ajoutez
actoretactor_namecomme propriétés lors de l’ingestion. Chaque événement reçoit un tag humain, agent ou crawler, plus un nom spécifique lorsqu’il est identifiable (une chaîne de modèle ou de plateforme), avant d’être enregistré dans une table. - Superposez vos logiques de classification. Commencez par le user-agent déclaré, vérifiez-le avec des signaux comportementaux comme le ratio ressources/requêtes et le timing, puis confirmez avec des tokens d’authentification ou des clés API lorsqu’ils existent. Aucun signal ne doit à lui seul porter toute la décision.
- Reliez autant que possible les événements des agents aux identités humaines. Les tokens d’authentification, cookies de session et ID de corrélation permettent de rattacher la tâche de récupération d’un agent à la personne qui l’a déployé, comblant l’écart entre « un agent a visité » et « l’agent de ce client a visité ».
- Dirigez tout vers un entrepôt de données, pas seulement vers un outil de tableau de bord. Le pipeline d’analytics d’agents de BigQuery diffuse les événements d’interaction bruts via la Storage Write API et prend en charge la reconstruction des traces après coup, ce qui est essentiel lorsque vous devez reconstituer ce qu’un agent a réellement fait trois semaines plus tard.
- Hiérarchisez votre stockage. Conservez des logs bruts et granulaires pendant une fenêtre d’audit définie, puis échantillonnez ou agrégez les données plus anciennes. Une conservation intégrale indéfinie devient rapidement un problème de coûts, et la plupart des audits n’ont besoin que d’une fenêtre récente.
Conseil pro : Définissez votre fenêtre de rétention d’audit selon votre cycle de litige ou de conformité le plus long réaliste, et non selon une limite arbitraire de 30 ou 90 jours. Si une rétrofacturation ou une question réglementaire peut surgir six mois plus tard, vos traces doivent survivre aussi longtemps.
Combler le déficit d’attribution
Savoir qu’un agent a visité votre site est une chose. Prouver quel humain ou quelle organisation a déployé cet agent est un problème bien plus complexe, et c’est celui qui empêche les équipes conformité de dormir.
Le déficit d’attribution existe parce que la plupart des entreprises peuvent enregistrer qu’un agent a agi, sans pouvoir prouver quel humain a autorisé cette action. Cet écart devient une véritable exposition juridique et réglementaire dès qu’un agent fait quelque chose qu’une entreprise doit ensuite désavouer ou défendre.
C’est la conclusion centrale de l’analyse d’Okta sur les risques de conformité liés à l’IA, et elle s’applique directement à toute équipe qui construit une analyse du trafic piloté par des agents à des fins d’audit, pas uniquement aux équipes sécurité.
Une mesure d’atténuation pratique qui gagne du terrain est le protocole canari : une approche médiée par le fournisseur dans laquelle les interactions des agents portent un marqueur traçable jusqu’au compte d’origine. Des recherches évaluant cette approche sur des agents web, de communication et cyber ont montré qu’elle relie de manière fiable le comportement observé à un compte source dans des contextes non adversariaux, même s’il est réaliste de s’attendre à des lacunes dès qu’un acteur cherche activement à échapper à la détection.
Quelques pratiques opérationnelles réduisent l’essentiel de l’écart restant :
- Traitez les logs des agents comme des enregistrements immuables, et non comme des données à écraser ou à compacter prématurément.
- Reliez chaque événement d’agent à une identité lorsqu’un token, un cookie ou une clé API le permet.
- Mettez en place un point de coordination permanent entre la sécurité, le juridique et vos fournisseurs de plateforme avant qu’un incident n’impose la conversation.
Outils et modèles de tableaux de bord qui fonctionnent
Vous n’avez pas besoin de tout construire à partir de zéro. Quelques outils concrets couvrent déjà la majeure partie du pipeline.
- BigQuery Agent Analytics gère le pipeline de la capture à l’analyse : diffusion des événements bruts, reconstruction des traces et exécution d’évaluations programmatiques du comportement des agents à grande échelle, ce qui devient essentiel dès que vous dépassez quelques milliers de requêtes d’agents par jour.
- Le tableau de bord Agentic Traffic d’Adobe vous offre une vue prête à l’emploi une fois le transfert des logs CDN activé, avec des filtres sur la distribution du trafic, les courbes de tendance et les plus fortes hausses et baisses sur différents marchés, catégories et agents individuels.
- Les outils basés sur des tags comme GA4 gardent leur utilité pour mesurer le comportement humain, mais ils sous-estiment systématiquement l’activité des agents parce qu’une grande partie de celle-ci ne déclenche jamais de tag côté client. Un modèle utile consiste à superposer GA4 à une capture côté serveur plutôt qu’à le remplacer complètement, afin de conserver les rapports sur le comportement humain tout en ajoutant la couche agent par-dessus.
- Les tableaux de bord des fournisseurs sont réellement utiles pour surveiller les tendances, mais ils ne remplacent pas un modèle de traces centré sur l’entrepôt de données lorsque vous avez besoin d’évaluations reproductibles pour un audit ou une analyse des causes racines.
Comment le trafic des agents modifie les performances et la planification des ressources
Les requêtes des agents sollicitent votre infrastructure différemment du trafic humain, et cela a de vraies implications de capacité que la plupart des équipes n’ont pas encore anticipées.
Un visiteur humain déclenche une rafale de requêtes parallèles : HTML, puis images, polices, scripts et beacons analytics, répartis sur plusieurs secondes. Un agent qui extrait des données structurées effectue souvent une seule requête efficace pour obtenir exactement ce dont il a besoin, puis passe à autre chose. Sur le papier, cela semble plus léger, mais à grande échelle ce n’est pas le cas. Les agents peuvent solliciter le même ensemble de pages à forte valeur, comme les pages de prix ou les fiches produit, avec un volume et une fréquence qu’aucun humain ne produirait jamais, puisqu’il n’y a aucun temps de lecture entre les requêtes.
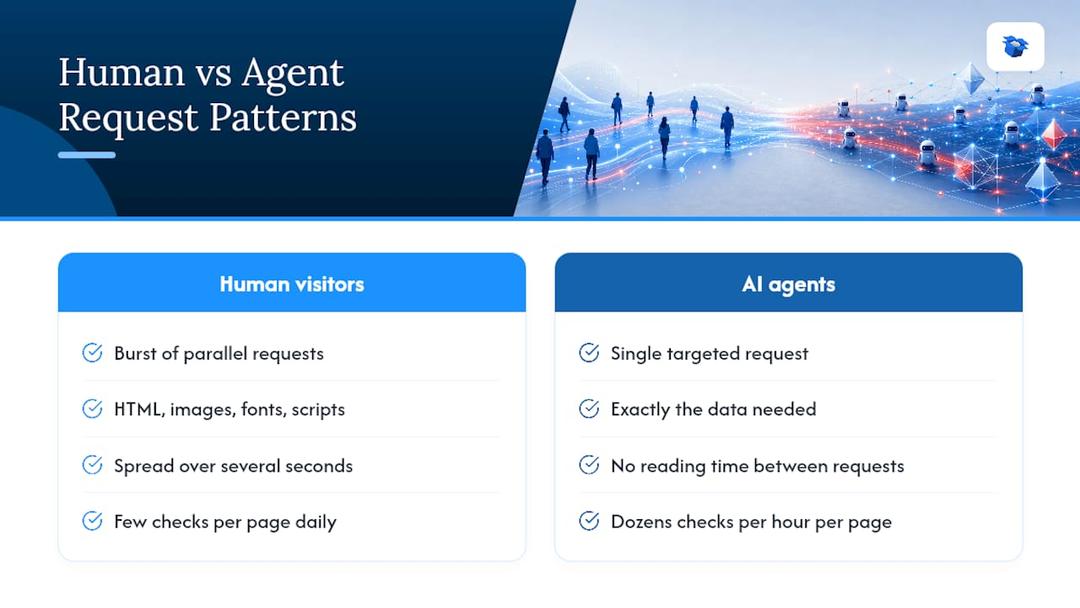
Ce modèle se traduit par une charge inattendue sur certains endpoints plutôt que par une répartition uniforme sur le site. Les décisions de limitation de débit et de mise en cache réglées pour les habitudes de navigation humaines peuvent mal réagir face aux agents, soit en bloquant un trafic d’agent légitime qui aurait généré une vente, soit en laissant un agent mal conçu saturer un endpoint que votre équipe pensait peu sollicité.
La réponse pratique consiste à traiter la charge des agents comme une catégorie distincte de planification de capacité. Surveillez les taux de requêtes par type d’acteur, et pas seulement le trafic agrégé, puis définissez les règles de cache et de limitation de débit en tenant explicitement compte des modèles de comportement des agents. Une fiche produit consultée des dizaines de fois par heure par des agents d’achat nécessite une stratégie de cache différente de celle consultée quelques fois par jour par des humains, même si le nombre total de requêtes semble similaire dans un tableau de bord combiné.
La frontière juridique et éthique de la surveillance du trafic des agents
La journalisation de l’activité des agents soulève des questions dont les réponses ne sont pas encore totalement établies, et prétendre le contraire serait une erreur.
Capturer des données détaillées sur les requêtes, y compris les en-têtes, le timing et les empreintes comportementales, signifie également capturer des données pouvant parfois être reliées à des individus, en particulier lorsqu’un agent agit au nom d’un compte client identifié. Les logs de trafic des agents entrent donc dans les mêmes cadres de confidentialité que toute autre collecte de données opérée par votre organisation, qu’il s’agisse d’une loi régionale sur la protection des données ou d’une politique interne de gouvernance des données.
Les questions éthiques accompagnent les questions juridiques. Bloquer tous les agents peut protéger les ressources serveur, mais cela peut aussi couper un canal croissant d’acheteurs qui effectuent désormais leurs comparaisons via un agent IA plutôt qu’un onglet de navigateur. À l’inverse, un accès trop permissif ouvre la porte à des abus de scraping déguisés en trafic d’agent légitime.
Une approche intermédiaire viable consiste à traiter l’accès des agents comme n’importe quelle autre intégration automatisée : documentée, limitée en débit et surveillée, avec des règles claires sur ce qui est autorisé. La publication d’un fichier llms.txt fait partie de cette approche, en offrant aux agents bienveillants une interface documentée au lieu de les forcer à deviner la structure de votre site.
La politique de rétention compte autant que la politique de collecte. Conservez les logs détaillés des agents uniquement pendant la durée réellement nécessaire à vos audits ou litiges, et appliquez à ces logs les mêmes contrôles d’accès qu’à tout autre jeu de données contenant des informations comportementales ou liées à une identité.
Intégrer l’analyse des agents à la sécurité et à la détection de fraude
L’analyse du trafic des agents et la détection de fraude résolvent des problèmes qui se recoupent, et les traiter comme des systèmes séparés crée des angles morts des deux côtés.
Un scraper malveillant et un agent d’achat légitime peuvent sembler presque identiques au niveau réseau : requêtes automatisées, absence d’exécution JavaScript, chaîne user-agent déclarée ou falsifiée. L’approche de classification multicouche qui identifie les agents légitimes, en vérifiant conjointement l’identité déclarée, les signaux comportementaux et l’authentification, est la même que celle qui permet de détecter les abus. Construire un système unique au lieu de deux évite à votre équipe fraude de réinventer des mécanismes de détection de signaux déjà développés par votre équipe analytics.
L’intégration pratique commence par une taxonomie commune des acteurs. Si votre pipeline analytics étiquette une requête comme agent, crawler ou humain, vos outils de sécurité doivent lire et exploiter ce même tag au lieu d’exécuter leur propre couche distincte de détection de bots avec des définitions différentes. Les taxonomies divergentes entre équipes sont la raison pour laquelle un agent IA d’achat légitime finit bloqué par une règle de sécurité dont personne côté analytics ne connaissait l’existence.
Les alertes partagées constituent l’autre moitié du dispositif. Une hausse soudaine des requêtes d’agents vers un endpoint de paiement peut venir d’un agent d’achat connu qui teste des variations de prix dans votre catalogue, ou d’une tentative de credential stuffing déguisée en trafic d’agent. Faire remonter les anomalies liées aux agents dans le même workflow d’incident que celui déjà utilisé par la sécurité pour la fraude, plutôt que dans une alerte analytics isolée que personne dans l’équipe sécurité ne surveille, est ce qui permet réellement de faire la différence à temps.
Comment les priorités d’analyse des agents évoluent selon les secteurs
Tous les secteurs n’ont pas besoin du même niveau d’attention dans une configuration d’analyse du trafic piloté par des agents, et appliquer une approche unique à tous fait perdre du temps d’ingénierie sur les mauvais signaux.
Les sites ecommerce et retail s’intéressent surtout à l’achèvement des tâches sur les pages produit et de prix, ainsi qu’au taux de relais agent-vers-humain, puisque c’est la métrique qui relie directement l’activité des agents au chiffre d’affaires. Le plus grand angle mort d’un distributeur est généralement une page de prix fortement sollicitée par des agents de comparaison sans aucun suivi de conversion correspondant.
Les sites médias et d’édition accordent davantage d’importance à la distinction entre crawler et agent, car la question métier concerne souvent les licences et la réutilisation de contenu plutôt que la conversion. Distinguer un crawler construisant un corpus d’un agent récupérant un article unique pour répondre à la question spécifique d’un utilisateur change la manière dont ce trafic doit être valorisé et gouverné.
Les plateformes logicielles B2B et SaaS ont tendance à privilégier la catégorie des tâches d’intégration, car les agents interagissant avec ces sites effectuent fréquemment des appels de type API pour le compte d’un autre système plutôt que d’un acheteur humain unique. Les taux d’erreur et de blocage par acteur y comptent davantage que le taux de relais, car l’« humain » à l’autre bout peut se trouver plusieurs étapes en amont de la requête elle-même.
Les sites de services financiers sont les plus concernés par les enjeux d’attribution et de gouvernance décrits plus haut, car l’exposition réglementaire liée aux actions d’agents non autorisées y est particulièrement élevée. L’approche d’attribution basée sur des canaris et la journalisation immuable y sont plus importantes que dans presque tous les autres secteurs.
Ce que les équipes analytics devraient réellement changer
Conservez vos rapports par défaut orientés humains exactement tels qu’ils sont. Ne reconstruisez pas un tableau de bord auquel un responsable marketing fait déjà confiance simplement pour y forcer des données d’agents. Créez plutôt une vue parallèle, autorisée à être différente puisqu’elle mesure quelque chose de structurellement différent.
Le changement organisationnel le plus important concerne l’endroit où la télémétrie des agents vit au quotidien. Elle doit faire partie des discussions sur la réponse aux incidents et les achats, pas rester enfouie dans un deck analytics trimestriel que personne ne lit avant qu’un problème survienne. Et si vous devez consacrer du temps d’ingénierie à optimiser quelque chose en priorité pour la lisibilité des agents, concentrez-vous sur les pages de prix et les fiches produit. C’est là que les agents prennent réellement des décisions pour le compte des acheteurs, et c’est là que le retour sur investissement apparaît le plus vite.
— Xhurian
Transformer la visibilité des agents en fiches produit optimisées
Mesurer le trafic des agents vous indique que des agents lisent vos pages produit. Cela ne vous dit pas pourquoi un agent a recommandé un concurrent plutôt que vous, et c’est précisément l’écart que ecentic comble.

Ecentic se connecte directement à votre boutique Shopify ou WooCommerce et simule la manière dont ChatGPT, Gemini, Claude et Perplexity évaluent réellement vos fiches produit face à celles des concurrents, puis fournit des diagnostics en langage clair sur ce qui vous coûte précisément une recommandation. Les clients utilisant les outils d’optimisation de Ecentic ont signalé des hausses significatives des visites et des ventes pilotées par l’IA après avoir mis en œuvre les réécritures de fiches produitsuggérées. Au lieu de simplement compter les requêtes d’agents, vous obtenez un profil UCP validé pour la lisibilité par les agents et un cycle de rescans qui suit votre taux de sélection au fil du temps à mesure que les modèles évoluent.
Si vous transférez déjà des logs CDN et étiquetez les acteurs, il vous manque surtout la capacité de savoir quoi faire de cette visibilité. Lancez un scan d’introduction gratuit sur votre boutique et voyez exactement où se situent vos fiches produit auprès des agents qui les consultent déjà.
FAQ
Qu’est-ce que l’analyse du trafic piloté par des agents ?
Il s’agit de la pratique consistant à capturer, classifier et attribuer les requêtes effectuées par des agents IA agissant pour le compte d’humains, puis à mesurer les tâches qu’ils accomplissent plutôt que de s’appuyer sur des métriques basées sur les sessions.
Pourquoi les métriques de session échouent-elles pour le trafic des agents ?
Des métriques comme le taux de rebond et le temps passé sur la page supposent qu’un humain affiche et lit une page, mais les agents effectuent souvent une seule requête efficace puis repartent, ce qui rend ces chiffres dénués de sens.
Comment détecter le trafic d’agents IA sur un site web ?
La capture côté serveur et des logs CDN, combinée à l’analyse des user-agents, aux ratios ressources/requêtes et à la validation llms.txt, permet d’identifier de manière fiable l’activité des agents que les outils côté client manquent.
Qu’est-ce que le déficit d’attribution dans l’analyse des agents ?
C’est la difficulté à prouver quel humain ou quelle organisation a autorisé l’action d’un agent spécifique, créant des risques juridiques et de conformité que les protocoles basés sur des canaris et la journalisation immuable contribuent à réduire.
Ecentic peut-il aider à optimiser le trafic des agents ?
Oui. Ecentic simule la manière dont les agents IA d’achat évaluent les fiches produit sur les boutiques Shopify et WooCommerce et fournit des recommandations précises pour améliorer la visibilité et les conversions pilotées par les agents.