

Les tests A/B pour l’IA consistent à mener des comparaisons contrôlées entre les variantes de vos fiches produit pour voir quelle version ChatGPT, Gemini, Claude ou Perplexity recommande réellement à un acheteur. Commencez par simuler une poignée de vos principaux SKU face à ces agents, puis corrigez les deux points qui font échouer le plus de tests avant même de démarrer : les données structurées manquantes et les champs de flux obsolètes. Donnez d’abord la priorité à l’exhaustivité du schéma, à la fraîcheur des flux et à la profondeur des avis, car ce sont les trois signaux qui pèsent le plus dans ce qu’un agent met en avant.
En bref :
- Des champs de données structurées comme priceValidUntil, deliveryTime et merchantReturnDays sont souvent absents ou obsolètes, ce qui affecte fortement les recommandations des agents.
- La fraîcheur des flux et les mises à jour en temps réel sont cruciales, car des prix ou des disponibilités obsolètes peuvent entraîner des fiches produit incohérentes et des ventes perdues.
- Les tests doivent viser à isoler des variables précises de schéma ou de flux plutôt que des modifications aléatoires du texte, car les signaux utilisés par les agents sont avant tout pilotés par les données.
- Les variantes doivent être testées sur plusieurs modèles, car différents agents IA ont des préférences distinctes en matière de présentation et d’attributs.
- Lancer des audits basés sur la simulation avant un déploiement en conditions réelles permet d’identifier rapidement les lacunes du schéma, d’améliorer la visibilité auprès de l’IA et d’augmenter le trafic provenant d’acheteurs à forte intention.
Pourquoi les tests A/B centrés sur les agents sont importants pour les boutiques Shopify et WooCommerce
Les agents d’achat IA ne naviguent pas comme les humains. Ils lisent des signaux interprétables par machine : données structurées, exactitude des flux et corroboration tierce comme les avis et les mentions éditoriales. Une page qui paraît excellente à un acheteur humain peut être invisible pour un agent si le balisage sous-jacent est insuffisant.
Columbia Business School a mené des sessions d’achat simulées et constaté que le positionnement, les badges, le prix et la note modifiaient les produits choisis par les agents. Les préférences variaient selon les modèles. GPT-4.1 penchait vers les articles placés à gauche dans un ensemble de résultats, Claude favorisait le centre, Gemini la droite. Cela seul montre qu’il n’existe pas de fiche produit « idéale » pour tous les agents. Elle existe par modèle, et c’est précisément pourquoi tester vaut mieux que deviner.
Pour les marchands, le bénéfice est réel. Le trafic qui arrive via un agent IA a tendance à avoir une forte intention d’achat, car l’acheteur a déjà reçu une recommandation avant d’arriver sur votre page. Le point de vigilance, c’est que votre fiche produit doit confirmer ce qu’a affirmé l’agent. Si l’agent dit « retours gratuits sous 30 jours » et que votre page ne le confirme pas dans le texte visible ou dans les données structurées, vous perdez la vente dès l’arrivée.
Ce que les agents pondèrent le plus :
- L’exhaustivité des données structurées dans les types de schéma Product, Offer et Review
- La fraîcheur du flux, c’est-à-dire des prix et une disponibilité conformes à ce qui est en ligne sur le site
- Une corroboration indépendante via les avis, les notes syndiquées et la couverture éditoriale
Que tester : attributs, champs de données structurées et signaux hors site
Avant de lancer la moindre expérience, verrouillez les champs et signaux précis qui valent la peine d’être modifiés. Tester des retouches de texte au hasard gaspille du temps. Tester les champs que les agents analysent réellement, non.
- Champs JSON-LD clés. Les agents lisent directement
Product,Offer,AggregateRating, etReviewdans les données structurées directement. DansOffer,priceValidUntilcompte davantage que la plupart des marchands ne l’imaginent, tout commeShippingDeliveryTime.deliveryTimeetMerchantReturnPolicy.merchantReturnDays. Un un audit de Sellarix sur 36 pages produit a constaté la présence de Product JSON-LD sur 72 % des pages, mais depriceValidUntilsur seulement 6 %, du délai de livraison sur 11 % et du nombre de jours de retour sur à peine 6 %. Aucune des pages auditées ne comportait les trois. - Santé du flux et du protocole. L’exhaustivité du flux Merchant Center, la préparation aux protocoles du commerce piloté par des agents (ACP, UCP, MCP) et la cadence de rafraîchissement déterminent toutes si les données d’un agent correspondent bien à votre site en ligne, comme détaillé dans ce guide SEO IA pour l’ecommerce. Un flux mis à jour une fois par jour peut discrètement fausser une expérience si un prix change au milieu du test.
- Preuves hors site. Le volume d’avis, leur fraîcheur et leur précision pèsent davantage qu’une simple note en étoiles. Les avis syndiqués chez les partenaires retail et toute mention éditoriale ajoutent une corroboration qu’un agent peut recouper.
Chaque variante que vous créez doit isoler l’une de ces trois catégories. Modifiez le schéma, pas le texte. Modifiez le texte, pas la cadence du flux. Mélanger les variables est la meilleure façon pour les marchands d’obtenir des résultats qu’ils ne savent pas expliquer.
Comment mener un test A/B pour des agents d’achat IA ?
Ce type de test ressemble moins à un test A/B marketing qu’à un déploiement d’ingénierie contrôlé. Voici la séquence qui permet de garder des résultats propres.
- Choisissez vos SKU de test et définissez le succès en amont. Choisissez 3 à 5 produits qui génèrent du chiffre d’affaires, pas l’ensemble de votre catalogue. Définissez vos indicateurs de succès avant de commencer : part de voix dans l’IA (fréquence à laquelle votre produit apparaît lorsqu’un agent est sollicité pour une recommandation dans votre catégorie), fréquence de citation et hausse de conversion des sessions référées par un agent.
- Concevez des variantes à variable unique. Créez une version avec une correction de schéma (par exemple, en ajoutant
merchantReturnDays), une avec des spécifications réordonnées dans la description, une avec un extrait d’avis mis en avant. N’associez jamais deux changements dans une seule variante. - Simulez avant la mise en ligne. Faites passer chaque variante dans des sessions d’agent représentatives sur au moins deux familles de modèles. À ce stade, les biais propres aux modèles sont bien documentés, et une variante qui gagne avec un modèle peut perdre avec un autre.
- Validez en conditions réelles, avec soin. Une fois que la simulation désigne un gagnant probable, déployez-le via des soumissions de flux échelonnées ou, lorsque votre plateforme le permet, dans un environnement sandbox ACP/UCP. Évitez de basculer 100 % du trafic dès le premier jour.
- Gérez les détails d’ingénierie. Sur Shopify ou WooCommerce, rendez le JSON-LD côté serveur plutôt que de l’injecter via un tag manager, attribuez des GTIN par variante afin que les agents et les flux ne fusionnent pas deux versions en un seul produit, et rédigez un test d’intégration qui vérifie la présence des champs critiques pour les agents dans la réponse HTML brute, pas seulement dans un aperçu de développement.
Conseil de pro : Relancez votre simulation chaque fois que vous modifiez le thème, le schéma du flux ou l’application qui gère vos avis. Une mise à jour de modèle peut supprimer discrètement un bloc JSON-LD qui a mis des semaines à s’imposer.
Des outils comme la fonctionnalité de fiches produit d’ecentic peuvent considérablement raccourcir l’étape 5 : les champs manquants sont identifiés et la correction est appliquée directement dans votre boutique en une seule opération, au lieu de passer par un audit manuel.
Quels indicateurs montrent réellement qu’une variante a gagné ?
Les indicateurs trompeurs ne servent à rien ici. Ce qui compte, c’est de savoir si un agent a mis votre produit en avant et si cette visite a converti.
Principaux KPI à suivre :
- Part de visibilité dans l’IA : fréquence à laquelle votre marque apparaît dans un ensemble défini de requêtes de test par rapport aux concurrents
- Fréquence de citation : fréquence à laquelle un agent renvoie à votre page produit précise ou à ses attributs
- Taux de conversion du trafic référé par les agents : conversion des sessions provenant d’un référent d’agent connu, suivies séparément du trafic organique et payant
Les indicateurs de santé technique comptent tout autant, car un flux défaillant fera perdre une variante par ailleurs gagnante :
- Taux de couverture des données structurées sur l’ensemble de votre catalogue
- Taux d’acceptation et de refus du flux dans Merchant Center
- Taux de présence de
priceValidUntil,deliveryTime, et demerchantReturnDays
Configurez un segment GA4 pour les référents d’agents connus comme perplexity.ai, chatgpt.com et copilot.microsoft.com, puis créez un tunnel de conversion distinct pour ce segment au lieu de l’intégrer au trafic organique global.
Les volumes de trafic référé par les agents ont tendance à être faibles au début; cela signifie qu’au départ, de nombreux tests reviendront avec des résultats non concluants sur le plan statistique. Considérez une seule semaine de résultats plats comme un résultat nul, pas comme un échec, et attendez d’observer une tendance sur au moins deux cycles complets de simulation et de mise en ligne avant de déployer une variante sur l’ensemble de votre catalogue.
Pièges courants, contrôles et conseils pratiques
La plupart des tests ratés viennent d’une poignée d’erreurs récurrentes :
- Chargement du prix côté client. Si votre prix se charge via JavaScript après le rendu initial de la page, certains agents ne le voient jamais, et le prix du flux finit par diverger du prix réel.
- Identifiants manquants par variante. Sans GTIN distincts, un agent (ou votre propre flux) fusionne deux variantes de test en une seule fiche produit.
- Incohérence entre le site et le flux. Votre site affiche un prix, votre flux en affiche un autre, et l’agent choisit celui auquel il fait le moins confiance.
- Champs de retour ou de livraison mal renseignés. Une
MerchantReturnPolicyqui ne correspond pas à votre politique réelle fait rapidement perdre confiance dès qu’un acheteur s’en aperçoit.
Créez un test d’intégration automatisé par modèle de fiche produit pour vérifier la présence de ces champs dans la réponse du serveur, et non dans le DOM rendu. Il détecte les régressions avant qu’une mise à jour de modèle n’efface discrètement six semaines de travail sur les données structurées.
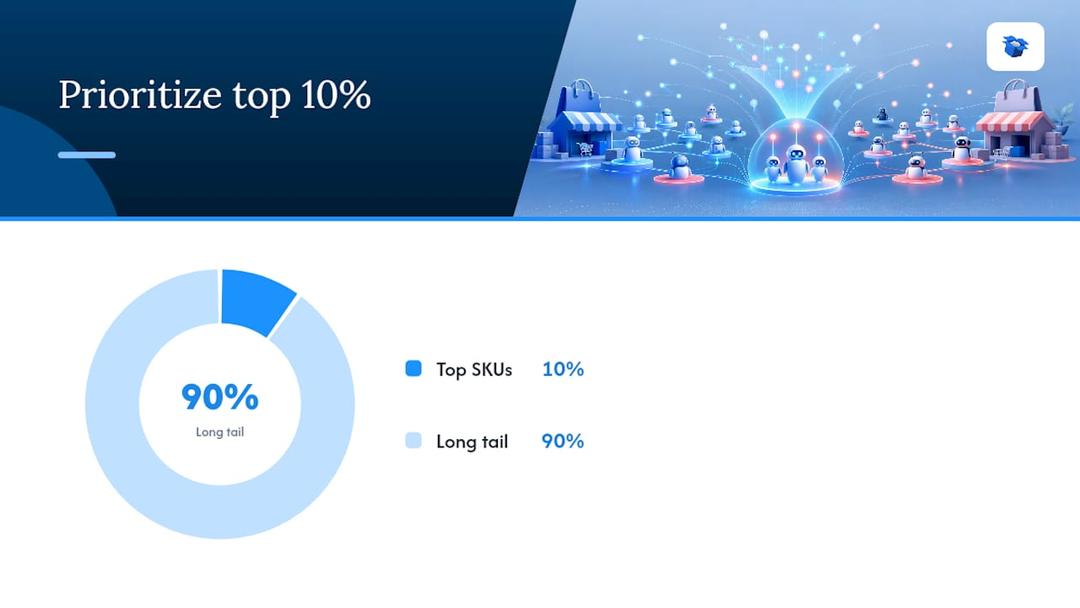
Conseil de pro : Donnez la priorité à vos SKU qui génèrent du chiffre d’affaires. Corrigez d’abord les 10% de votre catalogue qui génèrent le plus de chiffre d’affaires avant de toucher à la longue traîne. Posez aussi aux clients une question précise (« À quoi l’avez-vous utilisé ? ») plutôt qu’une simple demande générique de note par étoiles. Ce sont les avis spécifiques à un scénario que les agents récupèrent réellement.
Ce que change réellement un test piloté par simulation
Faire des dizaines d’audits de pages produit et de sessions d’agent simulées change votre façon de penser le fait de « gagner » une fiche produit. Le réflexe, c’est d’écrire un meilleur texte. En réalité, la plupart des échecs viennent d’un champ manquant dans un bloc de données structurées que personne n’a vérifié depuis huit mois.
Une approche qui fait passer chaque fiche produit par des sessions d’agent simulées avant toute mise en ligne, puis republie les correctifs vers Shopify ou WooCommerce en une étape au lieu d’un ticket de développement sur plusieurs semaines, peut aider les marchands à améliorer les visites issues de l’IA et les ventes en aval une fois les lacunes comblées.
— Xhurian
Lancez votre premier test A/B avec ecentic
Certaines plateformes transforment le processus ci-dessus en un outil que vous pouvez utiliser rapidement. Elles simulent vos fiches produit face à ChatGPT, Gemini, Claude et Perplexity, expliquent en anglais clair pourquoi la fiche produit d’un concurrent a remporté une comparaison, et appliquent le correctif dans Shopify ou WooCommerce en un clic — sans ticket de développement ni attente d’un déploiement de modèle.

Au lieu de vérifier manuellement priceValidUntil ou merchantReturnDays dans l’ensemble de votre catalogue, vous obtenez un diagnostic qui signale précisément les champs critiques pour les agents manquants, puis une phase d’optimisation automatique qui les corrige. Des rescans continus suivent l’évolution de votre taux de sélection par chaque agent après chaque modification, afin de ne pas avoir à deviner si une correction a fonctionné. Commencez par un scan gratuit, choisissez trois SKU qui génèrent un vrai chiffre d’affaires, lancez la simulation et publiez la variante gagnante. Les offres commencent à 14,90 $ par mois avec l’offre Compete, avec Scale et Dominate disponibles à mesure que votre catalogue et vos ambitions grandissent.
FAQ
Combien de temps prend un test A/B pour agent IA ?
Un cycle de simulation peut être exécuté en un ou deux jours une fois les variantes créées, puisqu’il ne dépend pas du volume de trafic en direct. La validation en conditions réelles prend plus de temps, généralement de deux à quatre semaines, car les tailles d’échantillon des recommandations d’agents restent faibles pour la plupart des boutiques.
Ai-je besoin de ressources de développement pour exécuter ces tests ?
Vous avez besoin d’une personne capable de modifier les données JSON-LD et les flux produits, mais une plateforme comme ecentic supprime la majeure partie du codage manuel en diagnostiquant les lacunes et en publiant directement les corrections sur Shopify ou WooCommerce.
Quels champs de schéma comptent le plus pour les agents IA ?
Offer.priceValidUntil, ShippingDeliveryTime.deliveryTime, et MerchantReturnPolicy.merchantReturnDays sont les trois champs que les audits identifient le plus souvent comme manquants, même sur des boutiques disposant par ailleurs d’un schéma Product solide, selon l’audit de Sellarix.
Puis-je tester différentes variantes de produits pour différents modèles d’IA ?
Oui, et vous devriez le faire. Les simulations montrent des préférences propres à chaque modèle, ce qui signifie qu’une variante gagnante pour un agent peut perdre avec un autre. Tester au moins deux modèles avant un déploiement en conditions réelles vaut donc l’étape supplémentaire.
Combien coûte ecentic ?
L’offre Compete d’Ecentic démarre à 14,90 $ par mois, avec Scale à 44,90 $ et Dominate à 149 $, ainsi qu’une option de frais de performance de 3 % par commande attribuée à l’IA pour une tarification à l’usage. Un scan gratuit est disponible avant de souscrire à une offre.