

Ja, Produktbewertungen beeinflussen, ob KI-Einkaufsagenten Ihr Produkt empfehlen. Agenten wie ChatGPT, Gemini, Claude und Perplexity gewichten Aktualität, den Status als verifizierter Kauf, Authentizitätssignale und den eigentlichen Text einer Bewertung, wenn sie entscheiden, welche Belege sie zitieren. Am schnellsten beginnen Sie, indem Sie Ihre Bewertungsverteilung und Kennzeichnungen für verifizierte Käufe klar sichtbar machen und dann strukturierte Zusammenfassungen ergänzen, die konkrete Vor- und Nachteile herausstellen.
Kurz gesagt:
- Baymard empfiehlt, Bewertungsverteilungen auszublenden, bis ein Produkt fünf Bewertungen hat; unterhalb dieser Schwelle sollten Sie repräsentative schriftliche Bewertungen zeigen, um Käufer und Agenten nicht irrezuführen.
- Ein Produkt mit 40 detaillierten Bewertungen kann mehr Erwähnungen erhalten als eines mit 400 allgemeinen Bewertungen, wenn Rezensenten Anwendungsfälle, Abwägungen und Risiken erläutern.
- Antworten Sie öffentlich auf negative Bewertungen und dokumentieren Sie Lösungen, damit Käufer Belege für die Servicequalität sehen und Agenten durchsuchbaren Kontext dazu erhalten, wie Beschwerden bearbeitet wurden.
- Koppeln Sie Anreize für Bewertungen nicht an positive Stimmungslagen; die FTC-Regeln schränken diese Praxis ein, und Plattformen können Feedback filtern, das sie als unauthentisch einstufen.
- Testen Sie Änderungen in Phasen, vergleichen Sie Agentenzitationen mit unveränderten Produktseiten und verfolgen Sie Sitzungen und Bestellungen, die von Agenten stammen, um Änderungen der Sichtbarkeit zu messen.
Wie KI-Einkaufsagenten Bewertungen und Rezensionen nutzen
KI-Einkaufsagenten bilden nicht einfach einen Durchschnitt aus Sternebewertungen, wie es ein Sortieralgorithmus tun würde. Sie führen Bewertungsinhalte aus vielen Quellen mithilfe trainierter Modelle zusammen, die beurteilen, welche Informationen für die Frage eines Käufers tatsächlich relevant sind. Die Shopping-Dokumentation von OpenAI weist darauf hin, dass ChatGPT Preis, Bewertungen, Verfügbarkeit und Händler-Metadaten gemeinsam berücksichtigt, wenn Produktzusammenfassungen und Kennzeichnungen erstellt werden. Dabei greift es oft auf Bewertungsdaten von Drittanbietern statt nur auf einen einzelnen Sterne-Score zurück.
Dadurch entsteht das, was Forschende als „Decision-Usefulness Ranking“ bezeichnen. Anstatt standardmäßig die neueste oder am häufigsten positiv bewertete Rezension hervorzuheben, bevorzugen Agenten Bewertungen mit konkretem Nutzwert: spezifische Vorteile, konkrete Nachteile und Risikohinweise, die Käufer vor dem Kauf kennen möchten. Forschung zur Auswahl von Evidenz bei Shopping-Frage-Antwort-Systemen auf Basis von Rezensionen, darunter Arbeiten zu Methoden zur Evidenzauswahl durch Agentenzeigt, dass Modelle, die sowohl unterstützende als auch risikobezogene Bewertungsinhalte erhalten, vertrauenswürdigere Zusammenfassungen erzeugen als Modelle mit oberflächlichem, generischem Lob.
Metadaten sind genauso wichtig wie der Text selbst. Agenten gewichten Informationen anhand von Aktualität, Verifizierungskennzeichen für Käufe, Hilfreichkeitsbewertungen und Merkmalen der Rezensenten neu. Eine Fünf-Sterne-Bewertung von einem nicht verifizierten Konto, die vor Jahren veröffentlicht wurde, hat weniger Aussagekraft als eine aktuelle, verifizierte Bewertung mit einem konkreten Nutzungsszenario. Diese Gewichtung bleibt Händlern weitgehend verborgen, weshalb viele Bewertungsprogramme auf Masse statt auf die Signale optimieren, die Agenten tatsächlich verwenden.
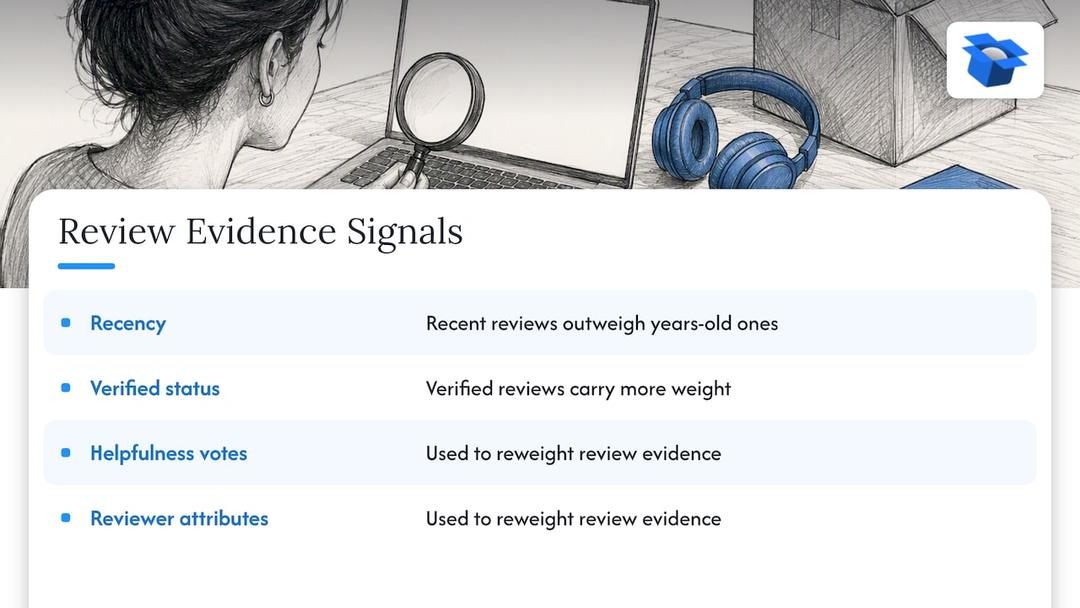
Bewertungsmerkmale, die für KI-Agenten und Käufer am wichtigsten sind
Eine reine Durchschnittsbewertung sagt Käufern und Agenten nur wenig. Die Forschung des Baymard Institute zur Verteilung von Nutzerbewertungen zeigt, dass Käufer stark darauf achten, die vollständige Verteilung zu sehen – also wie viele Bewertungen auf jede Sterne-Stufe entfallen. Dadurch wird erkennbar, ob ein Durchschnitt von 4,5 aus überwiegend positiven Bewertungen entsteht oder aus einer Mischung extremer Fünf- und Ein-Sterne-Wertungen. Dieselbe Logik gilt für Agenten bei der Evidenzauswahl: Eine Verteilung mit sichtbarer Varianz signalisiert Authentizität, während ein auffällig einheitlicher Satz an Fünf-Sterne-Bewertungen schnell künstlich wirkt.
Auch die Anzahl der Bewertungen spielt eine Rolle. Die Empfehlungen von Baymard raten dazu, Verteilungsübersichten auszublenden, wenn ein Produkt weniger als fünf Bewertungen hat, da kleine Stichproben sowohl Käufer als auch Modelle in die Irre führen. Sinnvoller ist es, einige repräsentative qualitative Bewertungen hervorzuheben, bis genügend Volumen vorhanden ist.
Über die Zahlen hinaus verbessern einige Merkmale auf Seitenebene nachweislich sowohl das Vertrauen von Menschen als auch die Evidenzauswahl von Agenten:
- Kennzeichnungen für verifizierte Käufe und Zeitstempel mit denen Leser und Modelle nachvollziehen können, dass eine Bewertung auf einer echten, aktuellen Transaktion basiert.
- Aussagekräftige Rezensionstexte die einen konkreten Vorteil, einen konkreten Nachteil und den Nutzungskontext des Produkts nennen.
- Von Rezensenten hochgeladene Fotos oder Videosdie zusätzliche bestätigende Details liefern, die Text allein nicht vermitteln kann.
- Sichtbare Antworten auf negative Bewertungen, die laut Forschung zur UX von E-Commerce-Produktseiten mit höheren Konversionsraten zusammenhängen, weil Käufer daran ablesen, wie eine Marke mit Beschwerden umgeht, und dies als Hinweis auf die Servicequalität werten.
Der öffentliche Umgang mit negativem Feedback stärkt nicht nur das Vertrauen von Menschen. Er liefert Agenten auch dokumentierte Lösungen, auf die sie verweisen können – und macht aus einem möglichen Warnsignal einen Hinweis auf einen reaktionsstarken Händler.
Praktische Checkliste: So werden Bewertungen für KI-Agenten nützlicher
Der Großteil der Arbeit besteht darin, Informationen sichtbar zu machen, die Sie vermutlich bereits erfassen – in einem Format, das sowohl Käufer als auch Agenten nutzen können. Gehen Sie die folgenden Punkte in den nächsten 30 bis 90 Tagen durch:
- Prüfen Sie Ihren Prozess zur Einholung von Bewertungen anhand der FTC-Regel zu gefälschten und incentivierten Bewertungendie den Kauf oder Verkauf gefälschter Bewertungen verbietet und Anreize einschränkt, die an positives Feedback gekoppelt sind.
- Machen Sie Bewertungsverteilungen und die Anzahl der Bewertungen sichtbar sowohl auf Übersichtsseiten als auch auf Produktdetailseiten, statt nur den Durchschnittswert anzuzeigen.
- Fügen Sie kurze Umfragen oder geführte Eingabeaufforderungen hinzu die Rezensenten bitten, einen Vorteil, einen Nachteil und den Nutzungskontext des Produkts zu nennen.
- Fördern Sie Fotos und kurze Videos von Rezensenten mit einer einfachen Upload-Aufforderung direkt nach der Kaufbestätigung.
- Ergänzen Sie vollständige menschliche Bewertungen um KI-generierte Zusammenfassungenwobei die menschliche Bewertung zuerst und die Zusammenfassung danach angezeigt wird, da die Forschung zu hybriden Bewertungssystemen diese Reihenfolge mit höher wahrgenommenem Vertrauen verbindet.
- Antworten Sie öffentlich auf negative Bewertungen und dokumentieren Sie die Lösung. Behandeln Sie sie als durchsuchbaren Nachweis, statt sie zu verbergen.
- Führen Sie Änderungen schrittweise ein und prüfen Sie die Agentenzitate vor und nach jeder Phase, statt alles gleichzeitig zu ändern.
Profi-Tipp: Stellen Sie in der Nachverfolgung nach dem Kauf lieber eine Frage zu Vor- und Nachteilen statt nur nach einer allgemeinen Sternebewertung zu fragen. Strukturierte Antworten enthalten deutlich häufiger die Risikohinweise, nach denen Agenten suchen.
Compliance ist nicht nur ein rechtlicher Pflichtpunkt. Plattformen und Agenten filtern zunehmend nach Authentizität. Deshalb erzielt ein Programm mit echtem, nicht durch Anreize beeinflusstem Feedback meist nachhaltigere Sichtbarkeit als ein Programm, das nur auf Masse setzt.
Wirkung messen: Kennzahlen und Experimente für KI-Agenten
Sie müssen nicht raten, ob eine Bewertungsänderung geholfen hat – es gibt konkrete Dinge, die sich messen lassen. Forschung zu KI-generierten Bewertungszusammenfassungen zeigt, dass Zusammenfassungen in Bewertungssystemen sowohl die Anzahl neuer Bewertungen als auch deren Informationsgehalt erhöhten, weil Nutzer ergänzende Details hinzufügten statt nur bereits Gesagtes zu wiederholen. Dadurch erhalten Sie ein integriertes Vorher-Nachher-Signal zur Erfolgsmessung.
Einige praktische Möglichkeiten, um zu prüfen, ob eine Bewertungsänderung das Verhalten von Agenten tatsächlich beeinflusst hat:
- Stichproben von Agentenzusammenfassungen für Ihre wichtigsten Produkte vor und nach einer Änderung erstellen und prüfen, ob sich die zitierte Evidenz verändert.
- Agentengesteuerte Attribution messen, also Sitzungen und Bestellungen, die aus von Agenten angezeigten Ergebnissen stammen, und erfassen Sie diese über Ihren Analytics-Stack.
- Schrittweise Rollouts durchführen mit einer Kontrollgruppe unveränderter Produktseiten, damit sich der Effekt der Bewertungsänderungen isolieren lässt.
- Frühindikatoren beobachtenwie die Wachstumsrate der Bewertungsanzahl, die Form der Aktualitätskurve, Veränderungen in der Sterneverteilung und Hilfreichkeitsbewertungen.
Regelmäßige Prüfungen von Zitaten – also Stichproben dessen, was ein Agent als Evidenz nennt, und Vergleiche über die Zeit – gehören zu den effizientesten Methoden, mit denen Praktiker feststellen, ob eine Bewertungsänderung tatsächlich berücksichtigt wurde. Unser Leitfaden zum Erhalt von Zitationen im KI-Shopping erklärt detailliert, wie sich solche Tests strukturieren lassen, und unser Beitrag zur Messung agentengesteuerter Sichtbarkeit zeigt, welche Dashboards sich dafür lohnen.
Warum Simulationen besser sind als Bauchgefühl bei der Optimierung von Bewertungen
Die meisten Händler behandeln Bewertungsstrategien als Spiel um Masse: mehr Sterne sammeln und hoffen, dass der Agent es bemerkt. Dieser Ansatz greift zu kurz. Agenten, die Produktempfehlungen treffen, belohnen nicht bloß Volumen, sondern Evidenz, die konkrete Kaufhemmnisse auflöst. Ein Produkt mit 40 Bewertungen, die Nutzungsszenarien und Kompromisse klar benennen, wird daher oft häufiger zitiert als ein Produkt mit 400 generischen Fünf-Sterne-Bewertungen.
Viele Marken unterschätzen die Lücke zwischen dem, was Bewertungsplattformen versprechen („mehr Bewertungen bedeuten mehr Vertrauen“), und dem, was das Verhalten von Agenten tatsächlich verändert. Sie können nicht allein anhand Ihres eigenen Shops erkennen, welches Bewertungssignal ein Agent besonders stark gewichtet. Deshalb sollte Bewertungsoptimierung gegen die Agenten selbst getestet werden – nicht gegen Annahmen aus klassischer SEO.
— Xhurian
Analysieren Sie Ihre Bewertungslücken, bevor Sie auf Verdacht Änderungen vornehmen
Wir haben eine Plattform entwickelt, die exakt simuliert, was ChatGPT, Gemini, Claude und Perplexity sehen, wenn sie Ihre Produktseiten bewerten – einschließlich der Bewertungssignale, die im Vergleich zu Wettbewerbern fehlen oder schwach ausgeprägt sind. Statt zu raten, welches Bewertungsmerkmal Sie zuerst optimieren sollten, zeigen wir konkrete Gewinn- oder Verlustdiagnosen für jedes Produktangebot und erstellen veröffentlichungsreife Umschreibungen, die Sie mit einem Klick direkt an Shopify oder WooCommerce übertragen können.

Die Tarife beginnen mit einem kostenlosen Scan. Die kostenpflichtigen Stufen (Compete für $14.90 pro Monat, Scale für $44.90 pro Monat und Dominate für $149 pro Monat) ergänzen tiefere Wettbewerbsanalysen und kontinuierliche erneute Scans. Alle Details finden Sie auf unserer Preisseite. Wenn Sie zuerst die Funktionen zur Optimierung von Produktangeboten sehen möchten, erklärt unsere Seite zur KI-Optimierung von Produktangeboten den Simulations- und Veröffentlichungsworkflow im Detail.
FAQ
Lesen KI-Einkaufsagenten tatsächlich Rezensionstexte oder nur Sternebewertungen?
Agenten lesen Rezensionstexte und nutzen sie zur Evidenzauswahl, nicht nur den Sterndurchschnitt. Die Shopping-Dokumentation von OpenAI bestätigt, dass ChatGPT Bewertungen zusammen mit Preis- und Händler-Metadaten berücksichtigt, wenn Produktzusammenfassungen erstellt werden. Forschung zur Evidenzauswahl zeigt außerdem, dass Modelle Rezensionstexte mit konkreten Vorteilen, Nachteilen und Risikohinweisen gegenüber allgemeinem Lob bevorzugen.
Wie viele Bewertungen braucht ein Produkt, bevor die Bewertungsverteilung hilfreich wird?
Die Forschung des Baymard Institute empfiehlt, Verteilungsübersichten auszublenden, wenn ein Produkt weniger als fünf Bewertungen hat, da kleine Stichproben Käufer und Modelle gleichermaßen irreführen können. Unterhalb dieser Schwelle sind repräsentative qualitative Bewertungen hilfreicher als ein Verteilungsdiagramm.
Können durch Anreize beeinflusste Bewertungen meiner KI-Shopping-Sichtbarkeit schaden?
Bewertungen mit an Stimmung oder Bewertung geknüpften Anreizen sind unter der FTC-Regel zu gefälschten und incentivierten Bewertungeneingeschränkt. Gleichzeitig filtern Plattformen zunehmend nach Authentizität, weshalb an positives Feedback gekoppelte Anreize sowohl rechtliche als auch Sichtbarkeitsrisiken schaffen. Ethisch eingeholte, nicht konditionierte Bewertungen bleiben als Evidenz, die Agenten zitieren möchten, meist belastbarer.
Ersetzen KI-generierte Bewertungszusammenfassungen menschliche Rezensionen?
Nein. Kontrollierte Studien zu KI-generierten Zusammenfassungen zeigen, dass sie das Bewertungsvolumen erhöhen und Rezensenten dazu anregen, ausführlichere ergänzende Details hinzuzufügen, statt menschliche Bewertungen zu ersetzen. Wenn zuerst menschliche Bewertungen und danach eine KI-Zusammenfassung angezeigt werden, stärkt das das Vertrauen meist stärker, als sich nur auf eine der beiden Varianten zu verlassen.
Wie erkenne ich, ob eine Bewertungsänderung meine KI-Shopping-Zitate tatsächlich verbessert hat?
Die direkteste Methode besteht darin, Agentenzusammenfassungen derselben Produkte vor und nach Ihrer Änderung stichprobenartig zu vergleichen und zu prüfen, ob sich die zitierte Evidenz verändert. Das Tracking agentengesteuerter Sitzungen und Bestellungen, wie in unserem Leitfaden zur Messung der KI-Suchsichtbarkeit beschrieben, liefert zusätzlich zum Zitat-Check ein konkretes Attributionssignal. In Kombination mit einem 90-Tage-Plan für Sichtbarkeitstests lässt sich der Zeitplan des Experiments besser strukturieren.
Quellen
Dies sind die wichtigsten Quellen hinter den oben genannten Aussagen – hilfreich zum Speichern, wenn Sie ein Bewertungsprogramm aufbauen oder prüfen.
- FTC-Leitfaden: Kundenbewertungen und Testimonials
- Shopping mit ChatGPT (OpenAI Help Center)
- Baymard Institute: Zusammenfassung zur Verteilung von Nutzerbewertungen
- INFORMS: KI-generierte Zusammenfassungen erhöhen Bewertungsvolumen und Informationsgehalt
- DEEP-Agent und Evidenzauswahl für Shopping-QA auf Basis von Rezensionen
Diese Themen entdecken