

Preisparität über alle Vertriebskanäle hinweg, schwellenwertbewusste Mindestpreise und vollständige, KI-lesbare Produktdaten sind die drei Maßnahmen, mit denen Ihre SKUs am zuverlässigsten in Empfehlungen von KI-Shopping-Agenten landen. Wenn alle drei stimmen, kommen Sie in die Bewertung. Fehlt auch nur eine davon, werden Sie herausgefiltert, bevor der Agent Sie überhaupt mit einem Wettbewerber vergleicht.
Die drei sofortigen Maßnahmen:
- Preisparität durchsetzen über Ihren Shopify- oder WooCommerce-Shop, den Google-Shopping-Feed und alle Marketplace-Produktangebote hinweg. Uneinheitliche Preise über verschiedene Kanäle hinweg können die Kaufabschlussrate um rund 23% senken.
- Schwellenwertbewusste Mindestpreise festlegen damit Ihre SKUs knapp unter gängigen Suchfiltern ("unter $50", "unter $100") liegen statt einen Dollar darüber.
- Vollständige strukturierte Produktdaten veröffentlichen (JSON-LD, vollständige Attributfelder, saubere Titel), damit Agenten Ihr Produktangebot überhaupt bewerten können.
Das Wichtigste im Überblick
Preisparität, schwellenwertbewusste Mindestpreise und vollständige strukturierte Daten sind die drei unverzichtbaren Grundlagen, damit Ihre SKUs in Empfehlungen von KI-Agenten erscheinen.
| Punkt | Details |
|---|---|
| Zuerst Preisparität durchsetzen | Uneinheitliche Preise über verschiedene Kanäle hinweg senken laut Händleranalyse von Perplexity die Kaufabschlussrate um rund 23%. |
| Schwellenwertbewusste Mindestpreise festlegen | Preisen Sie knapp unter gängigen Suchfiltern ("unter $50"), damit Agenten Ihre SKU einbeziehen, statt sie herauszufiltern. |
| Vollständige strukturierte Daten veröffentlichen | JSON-LD und vollständige Attributfelder sind Grundvoraussetzungen; fehlen Daten, überspringen Agenten die Bewertung Ihres Produktangebots oft komplett. |
| Jeweils nur eine Variable testen | Führen Sie randomisierte Choice-Set-Tests mindestens zwei Wochen lang mit einer Holdout-Gruppe von 20%–30% durch, um agentengesteuerte Effekte zu isolieren. |
| Ecentic für kontinuierliches Monitoring nutzen | Ecentic simuliert die Bewertung durch Agenten in ChatGPT, Gemini, Claude und Perplexity und scannt nach jeder Änderung am Produktangebot automatisch erneut. |
Was erfordert Pricing für KI-Agenten tatsächlich?
Diese Checkliste deckt die Hebel ab, die die Auswahl durch Agenten beeinflussen. Markieren Sie jeden Punkt als erledigt, in Arbeit oder nicht begonnen und arbeiten Sie die Liste von oben nach unten durch.
Schnelle Erfolge (Minuten bis Stunden):
- Preisparität prüfen. Ziehen Sie Ihren Live-Preis aus Ihrem Storefront, dem Google-Shopping-Feed und allen aktiven Marktplätzen. Wenn sie voneinander abweichen, korrigieren Sie zuerst den Feed.
- Preisschwellen prüfen. Ermitteln Sie die häufigsten Preisfilter in Ihrer Kategorie („unter 30 $“, „unter 75 $“, „unter 150 $“). Legen Sie Ihre Preise auf oder knapp unter jeder relevanten Schwelle fest, nicht darüber.
- Sternebewertung über 4,0. Agenten gewichten Bewertungen stark. Liegt Ihr Durchschnitt unter 4,0, priorisieren Sie das Einholen von Bewertungen vor jeder anderen Arbeit am Produktangebot.
- Mindestanzahl an Bewertungen. Zu wenige Bewertungen verschlechtern die Auswahlwahrscheinlichkeit. Schon der Sprung von 3 auf 25 Bewertungen sorgt für einen messbaren Anstieg in Experimenten zur Agentenbewertung.
- Vollständige Produkttitel. Nehmen Sie Marke, Modell, wichtigste Spezifikation und primären Anwendungsfall in den Produkttitel auf. Agenten lesen Titel als strukturierte Signale.
Benötigt Tools oder Automatisierung (Tage bis Wochen):
- JSON-LD-Schema auf jeder Produktseite. Ohne dieses Schema können viele Agenten Ihr Produktangebot nicht bewerten.
- Sichtbarkeit von Empfehlungen und Badges. „Overall Pick“, „Best Seller“ und ähnliche Tags schaffen Spielraum für höhere Preise. Machen Sie sie in Ihrem Feed und im Markup der Seite sichtbar.
- Kontinuierliches Monitoring der Preisparität. Manuelle Prüfungen driften mit der Zeit ab. Richten Sie einen automatisierten Feed-Abgleich ein oder nutzen Sie eine Plattform, die nach Zeitplan erneut scannt.
- Tracking der Agenten-Attribution. Sie können nicht optimieren, was Sie nicht messen können. Instrumentieren Sie Ihren Shop so, dass sich agentengesteuerter Traffic von organischem und bezahltem Traffic trennen lässt.
Profi-Tipp: Setzen Sie Ihren Mindestpreis auf X,99 $ knapp unter der Schwelle und nicht exakt auf die Schwelle. Ein Agent, der nach „unter 50 $“ filtert, schließt eine SKU für 49,99 $ ein und eine für 50,00 $ aus. Reine Cost-plus-Logik bringt Sie häufiger auf die falsche Seite dieses Filters, als Sie erwarten würden.
Wie bewerten KI-Agenten Ihre Produkte tatsächlich?
Agenten browsen nicht wie Menschen. Sie führen strukturierte Scorecards über Attribute aus, die sie aus Ihrem Feed und dem Seiten-Markup ziehen, und ordnen Kandidaten anschließend mit etwas ein, das einem gewichteten Nutzenmodell ähnelt. Untersuchungen der Columbia Business School bestätigen, dass verschiedene Agentenmodelle dieselben Attribute unterschiedlich gewichten. Das bedeutet: Wer nur für einen Agenten optimiert und die anderen ignoriert, geht ein reales Risiko ein.
Der Preis ist in jedem getesteten Modell ein negativer Faktor. Bewertungen und Anzahl der Rezensionen sind positive Faktoren. Die Position in den Suchergebnissen und Empfehlungshinweise erhöhen den Nutzen und können einen höheren Preis ausgleichen.
Wichtigste Erkenntnis: Randomisierte ACES-Experimente zeigen Preiselastizitätswerte von ungefähr −1.6 bis −2.8 über verschiedene Agentenmodelle und Produktgruppen hinweg. Eine Preiserhöhung um 10 % reduziert die Auswahlwahrscheinlichkeit je nach Modell um 16 %–28 %, wenn alle anderen Faktoren gleich bleiben.
| Attribut | Richtung des Effekts auf die Auswahl | Quelle der Evidenz |
|---|---|---|
| Preis | Negativ (stark) | ACES- / arXiv-Experimente |
| Sternebewertung | Positiv (stark) | ACES- / arXiv-Experimente |
| Anzahl der Bewertungen | Positiv (moderat) | ACES- / arXiv-Experimente |
| Position des Produktangebots | Positiv (modellabhängig, groß) | Columbia Business School |
| Empfehlungstag („Overall Pick“) | Positiv (sehr groß, modellabhängig) | ACES- / arXiv-Experimente |
| Vollständigkeit strukturierter Daten | Ausschlaggebend (erforderlich für die Bewertung) | Praxissynthese von AgentMint |
Eines macht die Forschung der Columbia University deutlich: Agenten prüfen zuerst die Vollständigkeit der Daten, bevor sie den Preis gewichten. Ein Produktangebot mit fehlenden Attributen wird nicht nur schlechter bewertet. Häufig wird es überhaupt nicht bewertet.
Das Pricing-Playbook: sieben Taktiken nach Wirkung priorisiert
Beginnen Sie mit Preisparität. Alles andere ist zweitrangig, bis Ihre Preise kanalübergreifend übereinstimmen.
Priorisierte Taktiken:
- Zuerst kanalübergreifende Preisparität sicherstellen. Eine Analyse von Perplexity für Händler ergab, dass Preisunterschiede zwischen einem DTC-Storefront, Google Shopping und Marktplatzangeboten den Kaufabschluss beeinträchtigen – um etwa 23 %. Beheben Sie dieses Problem vor jeder anderen Pricing-Maßnahme.
- Mindestpreise mit Blick auf Schwellenwerte festlegen. Ordnen Sie die gängigen Suchfilter in Ihrer Kategorie zu und setzen Sie Ihre Preise knapp darunter. Es geht nicht um Rabatte, sondern darum, innerhalb des Filters zu bleiben.
- Empfehlungstags nutzen, um Preisspielraum zu schaffen. ACES-Experimente zeigen, dass Tags wie „Overall Pick“ einen sehr großen geschätzten Preisspielraum schaffen – in einigen Modellen genug, um einen deutlichen Preisaufschlag gegenüber Wettbewerbern ohne Tag auszugleichen. Machen Sie jedes verdiente Badge im Feed-Markup sichtbar.
- Mit Bundles Anker setzen. Ein Bundle für 89 $ neben einem Einzelprodukt für 59 $ lässt das Einzelprodukt für einen Agenten, der relative Werte analysiert, wie ein gutes Angebot erscheinen. Agenten lesen Ankersignale in strukturierten Daten.
- Zeitlich begrenzte Aktionen an Agenten-Abfragefenster koppeln. Agenten, die während Spitzenzeiten im Shopping abgefragt werden, gewichten die Aktualität von Preisänderungen stärker. Ein temporärer Rabatt, der aktiv ist, wenn der Agent scannt, schlägt einen dauerhaften Preis, der vor sechs Monaten festgelegt wurde.
- Dauerhafte Neupositionierung nur bei ausreichender Elastizität. Nutzen Sie den Elastizitätsbereich von −1.6 bis −2.8 als Planungsgrundlage. Wenn eine Preissenkung um 10 % in Ihrer Kategorie weniger als 16 % zusätzliche Auswahl bringt, lohnt sich der Margenverlust nicht.
- Agentisches Repricing mit Leitplanken einsetzen. Autonomes Repricing kann schneller reagieren als manuelle Regeln, benötigt aber saubere Wettbewerbs- und Bestandsdaten. Legen Sie feste Margenuntergrenzen fest, bevor Sie automatisiertes Repricing aktivieren.
Das ist realer Spielraum, auch wenn die Spannweite groß und modellabhängig ist.
So testen Sie Preisänderungen gegen KI-Agenten
Führen Sie randomisierte Choice-Set-Tests durch. Präsentieren Sie Agenten gespiegelte Produktauswahlen, bei denen sich nur die Testvariable (Preis, Badge, Beschreibung) ändert, und messen Sie anschließend Auswahlrate, Conversion-Rate und KI-attribuierte Bestellungen.
Nummeriertes Testdesign:
- Pro Test nur eine Variable definieren. Preis, Empfehlungstag oder überarbeitete Beschreibung. Ändern Sie niemals zwei Variablen gleichzeitig.
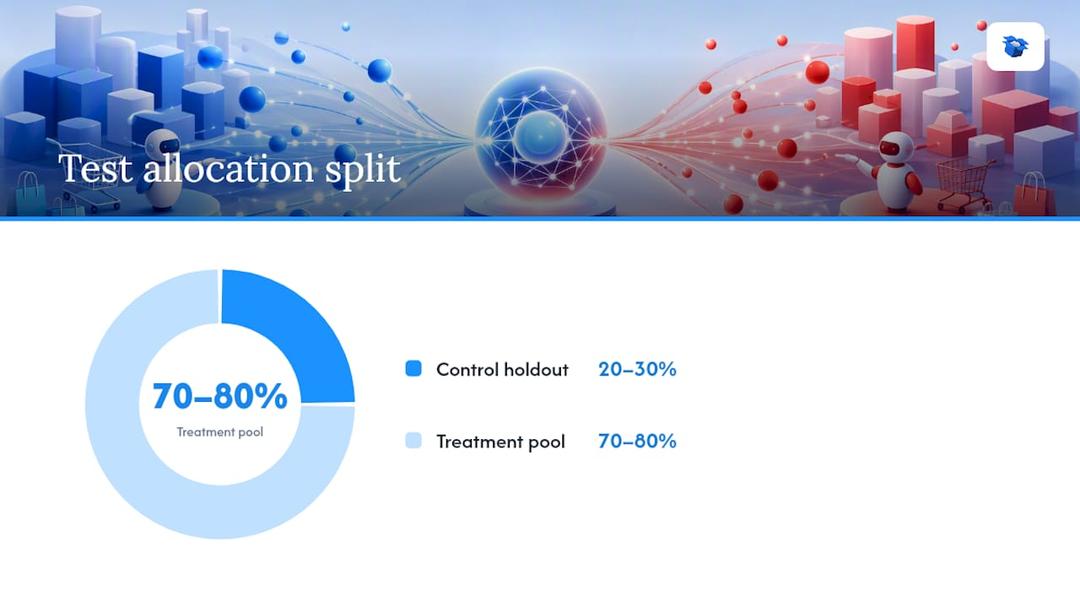
- Eine Holdout-Gruppe aufbauen. Belassen Sie 20 %–30 % der SKUs beim Kontrollpreis, damit Sie eine saubere Baseline haben.
- Mindestens zwei volle Wochen laufen lassen. Kürzere Zeiträume sind zu anfällig für Wochentagseffekte und Werberauschen.
- Auf SKU-Ebene randomisieren, nicht auf Kategorieebene, um Positionsverzerrungen zu vermeiden.
- Agenten-Attribution vor dem Start instrumentieren. Ohne Tracking für Agenten-Trafficmessen Sie die gesamte Conversion und nicht die agentengesteuerte Conversion.
| Metrik | Definition | Messmethode |
|---|---|---|
| Agenten-Auswahlrate | % der Agentenanfragen, bei denen Ihre SKU ausgewählt wird | UCP-/Profilfeld-Tags + Agenten-Attributionslogs |
| Agenten-Conversion-Rate | Bestellungen aus agentenvermittelten Sitzungen / Agentensitzungen | UTM-Parameter + Agenten-Referral-Quelle |
| KI-attribuierter Umsatz | Umsatz aus bestätigten agentengesteuerten Bestellungen | Attributions-Dashboard mit Filter für Agentenquellen |
| Delta des Preisspielraums | Änderung der Auswahlrate pro % Preisänderung | Conditional-Logit-Modell auf Basis der Testkohortendaten |
Häufige Fehler: Positionsänderungen während eines Tests verfälschen die Preisergebnisse. Saisonale Aktionen, die parallel laufen, erhöhen die Conversion in beiden Gruppen. Starten Sie keine Tests während großer Verkaufsaktionen.
Implementierungs-Checkliste für Shopify und WooCommerce
Stellen Sie KI-lesbare Produktschemata bereit, sorgen Sie für Feed-Parität und aktivieren Sie kontinuierliche Rescans. Das ist die Kurzfassung. So setzen Sie es um.
Tag 1:
- Installieren oder prüfen Sie ein JSON-LD-Schema-Plugin. Bei Shopify übernehmen Apps wie Schema Plus oder TinySEO diese Aufgabe. Bei WooCommerce erzeugen Yoast SEO oder Rank Math automatisch Produktschemata, wenn sie korrekt konfiguriert sind. Nutzen Sie die Checkliste für strukturierte Daten um jedes erforderliche Feld zu prüfen.
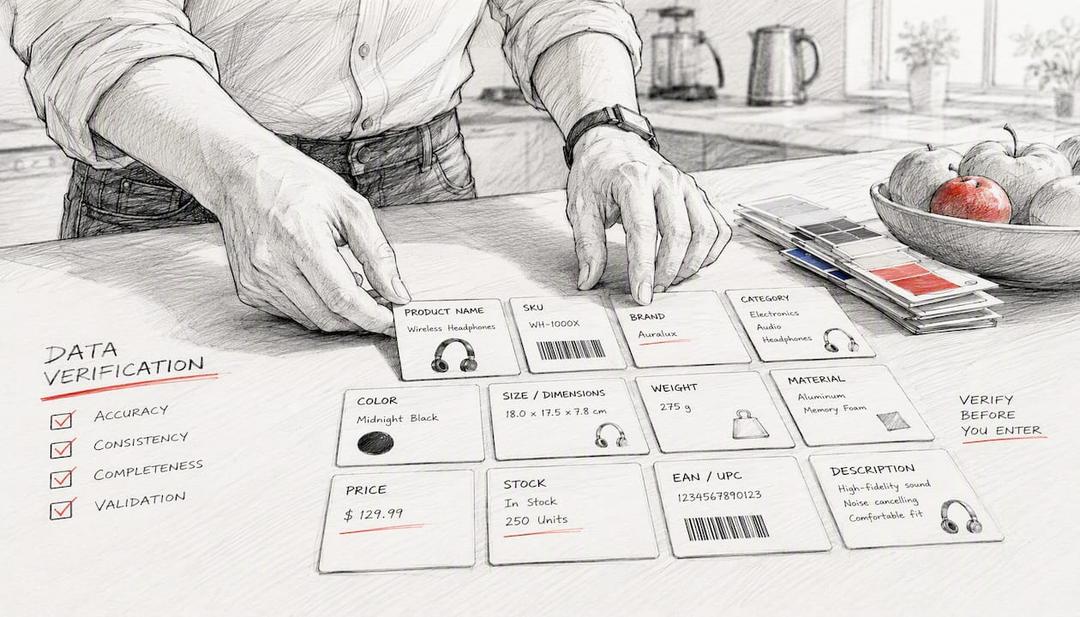
- Prüfen Sie Ihren Produktfeed auf fehlende Attribute: GTIN, Marke, Zustand, Verfügbarkeit und Preis. Agenten verwenden diese Felder als Ausschlusskriterien.
- Richten Sie ein Monitoring für Preisparität ein. Exportieren Sie Ihre aktuellen Preise aus Shopify oder WooCommerce und vergleichen Sie sie mit Ihrem Google-Shopping-Feed und allen aktiven Marktplatz-Feeds.
Woche 1:
- Füllen Sie UCP-Felder (Universal Commerce Profile) aus, falls Ihre Plattform sie unterstützt. Diese Felder ermöglichen es Agenten, strukturierten Produktkontext über das Standardschema hinaus zu lesen.
- Ergänzen Sie auf Ihren Produktseiten Markup für Auszeichnungen und Empfehlungen. Wenn Sie eine Auszeichnung wie „Best Seller“ oder „Overall Pick“ erhalten haben, muss sie in Ihren strukturierten Daten erscheinen und darf nicht nur auf der Seite sichtbar sein.
- Verbinden Sie Ihren Shop mit einem System zur Agenten-Attribution. Für WooCommerce übernimmt die WooCommerce-Integration von Ecentic die Verbindung des Feeds und die Planung von Rescans.
Monat 1:
- Aktivieren Sie automatisiertes Monitoring der Preisparität mit Warnmeldungen bei Preisabweichungen über einem festgelegten Schwellenwert (1 %–2 % sind ein sinnvoller Auslöser).
- Planen Sie kontinuierliche Rescans ein, damit Ihre Bewertungen der Produktangebote nach jeder Preis- oder Beschreibungsänderung aktualisiert werden.
- Prüfen Sie Diagnosen für KI-Produktangebote um zu erkennen, welche Attribute Ihre Scorecard nach unten ziehen.
Was funktioniert nicht mehr, wenn Agentenmodelle aktualisiert werden?
Modellupdates verändern die Gewichtung von Attributen. Ein Positionsbias, der in einer Modellversion Angebote auf dem ersten Platz bevorzugt hat, kann in der nächsten Version abgeschwächt oder umgekehrt werden. Händler, die stark auf die Gewichtung eines einzelnen Modells optimiert haben und andere nicht überwachen, verlieren über Nacht Sichtbarkeit.
Wichtige Risiken im Blick behalten:
- Verschiebungen beim Positionsbias. Untersuchungen der Columbia Business School dokumentieren starke, modellabhängige Positionseffekte. Wenn ein Modell aktualisiert wird, kann sich der Wert Ihrer Position ändern, ohne dass Sie selbst etwas getan haben.
- Paritätsfehler führen zur Unterdrückung. Wenn Ihr Preis nach dem Ende einer Aktion nicht mehr der Preisparität entspricht, können Agenten Ihr Produktangebot herabstufen oder ausschließen.
- Falsch negative Ergebnisse durch kleine Preisunterschiede. Eine Abweichung von 0,50 $ zwischen Ihrem Storefront und Ihrem Feed kann in manchen Agentenmodellen bereits ein Paritätssignal auslösen.
- Veraltete Beschreibungen. Agenten scannen regelmäßig erneut. Eine Beschreibung, die vor sechs Monaten optimiert wurde, kann nach einem Modellupdate anders bewertet werden, weil Textsignale anders interpretiert werden.
Checkliste für Warnmeldungen:
- Wöchentlich: Preisparität über alle aktiven Kanäle hinweg prüfen.
- Alle zwei Wochen: eine simulierte Agentenanfrage für Ihre Top-10-SKUs ausführen und die Auswahlraten mit dem vorherigen Zeitraum vergleichen.
- Monatlich: Daten zur Agenten-Attribution auf unerklärliche Rückgänge bei agentenvermittelten Sitzungen prüfen.
- Nach jeder Ankündigung eines Modellupdates: Führen Sie Ihre vollständige Simulationssuite erneut aus, bevor Sie davon ausgehen, dass Ihre Scores stabil sind.
Wenn ein Modellupdate die Wettbewerbslandschaft verändert, brauchen Sie Spielraum für Repricing, ohne in den negativen Bereich zu geraten. Händler mit zu eng gesetzten Preisuntergrenzen können nicht reagieren, ohne manuell einzugreifen.*
Welche Ergebnisse können Sie erwarten?
Realistisch, nicht garantiert. So lässt es sich hier ehrlich einordnen.
ACES-Experimente zeigen, dass Überarbeitungen von Beschreibung und Titel in bestimmten Kategorie- und Modellpaaren zweistellige Zuwächse beim Auswahlanteil erzielen, wobei manche Änderungen den Anteil um mehr als 30 Prozentpunkte verschieben. Viele Änderungen haben jedoch keinen messbaren Effekt. Die Zuwächse sind heterogen: Was bei Consumer Electronics funktioniert, kann bei Bekleidung wirkungslos bleiben.
Orientierungsspanne: Die Preiselastizitätsschätzungen aus ACES-Experimenten reichen von −1,6 bis −2,8. Für einen Händler mit einem Preis von $45 in einer Kategorie mit einer Elastizität von −2,0 wäre bei einer Preissenkung um $5 (11 %) unter sonst gleichen Bedingungen ein Anstieg der Auswahlwahrscheinlichkeit um ungefähr 22 % zu erwarten.
Was die Belege tatsächlich stützen:
- Die Durchsetzung von Preisparität sorgt für konsistente, messbare Zuwächse beim Kaufabschluss. Der Wert von 23 % Unterdrückung aus der Händleranalyse von Perplexity ist die klarste Einzelzahl in der praxisnahen Literatur.
- Empfehlungs-Tags schaffen Preisspielraum, der erheblich sein kann, dessen Größe aber je nach Modell und Kategorie variiert.
- Die Vollständigkeit strukturierter Daten ist ein Ausschlusskriterium, kein Differenzierungsmerkmal. Sie brauchen sie, um überhaupt mitzuhalten, aber sie garantiert keine Auswahl.
- Viele einzelne Optimierungen zeigen isoliert keinen Effekt. Dieses Playbook funktioniert als System, nicht als Satz unabhängiger Hebel.
Die Ergebnisse variieren je nach Kategorie, Agentenmodell und Wettbewerbsdichte. Führen Sie eigene Tests durch, statt anzunehmen, dass die experimentellen Durchschnittswerte auf Ihre konkreten SKUs zutreffen.
So denken wir bei ecentic darüber
Den größten Nutzen aus diesem Playbook ziehen Händler, die die Optimierung für Agenten als laufenden Prozess verstehen und nicht als einmalige Korrektur. Bei ecentic führt die Simulations-Engine gleichzeitig Choice-Set-Tests über ChatGPT, Gemini, Claude und Perplexity hinweg aus, sodass Sie sehen, wo Ihre Produktangebote gewinnen und wo sie verlieren, bevor eine echte Agentenanfrage erfolgt. Kontinuierliche Rescans bedeuten, dass eine Preisänderung oder eine Anpassung der Beschreibung automatisch eine neue Diagnose auslöst. Die Kombination aus Simulation, Paritätsüberwachung und automatischem Rescan senkt das Risiko, dass ein Modell-Update Monate an Optimierungsarbeit zunichtemacht. Genau diesen Kreislauf soll das obige Playbook schließen.
ecentic liefert die Simulationsebene, die dieses Playbook braucht
Die meisten Händler gehen diese Schritte manuell durch: Sie exportieren Feeds, prüfen die Übereinstimmung der Daten, überarbeiten Beschreibungen und hoffen beim Blick auf die Beispiele für Agentensitzungen auf ein besseres Ergebnis beim nächsten Scan. ecentic ersetzt dieses Rätselraten durch ein System. Verbinden Sie Ihren Shopify- oder WooCommerce-Shop: ecentic simuliert, wie ChatGPT, Gemini, Claude und Perplexity Ihre Produkteinträge aktuell bewerten, und liefert anschließend leicht verständliche Erklärungen dazu, was Ihre Bewertung verschlechtert.

Die Paritätsüberwachung läuft kontinuierlich. Überarbeitungen von Beschreibungen und Titeln werden vorgeschlagen und lassen sich mit einem Klick veröffentlichen. Die Agenten-Attribution zeigt Ihnen, welche SKUs über Agentensitzungen tatsächlich empfohlen und gekauft werden. Für Händler, die dieses Playbook gelesen haben und die dafür nötige Messinfrastruktur sauber aufsetzen möchten, ist der kostenlose Produktscan der schnellste Weg, um zu sehen, wo Sie heute stehen.
Quellen
- Was kauft Ihr KI-Agent? Bewertung, Verzerrungen, Modellabhängigkeit und aufkommende Implikationen für den Handel mit KI-Agenten
- So nutzen Sie die Welle der KI-Shopping-Agenten 2026, bevor sie Ihren Funnel umkrempelt
- Was ist agentengesteuerte Preisgestaltung? Wie KI Preisstrategien im E-Commerce verändert
FAQ
Wie entscheiden KI-Agenten, welche Produkte sie empfehlen?
Agenten bewerten Produktangebote anhand strukturierter Attribute: Preis, Sternebewertung, Anzahl der Bewertungen, Position des Produktangebots und Empfehlungs-Tags. Die Vollständigkeit Ihres Produkt-Feeds ist eine Grundvoraussetzung; fehlende Felder führen oft dazu, dass Ihr Produktangebot gar nicht bewertet wird.
Was ist der größte Preisfehler, der Empfehlungen durch KI-Agenten schadet?
Uneinheitliche Preise über verschiedene Kanäle hinweg. Stellen Sie Parität her, bevor Sie jede andere Preisoptimierung angehen.
Wie stark beeinflusst der Preis die Auswahlwahrscheinlichkeit durch KI-Agenten?
Randomisierte ACES-Experimente berichten über Preiselastizitätsschätzungen zwischen −1,6 und −2,8 über verschiedene Agentenmodelle hinweg.
Können Empfehlungs-Tags wie „Overall Pick“ einen höheren Preis ausgleichen?
Ja, bei einigen Modellen deutlich. ACES-Experimente zeigen, dass Empfehlungs-Tags messbaren Preisspielraum schaffen. Das bedeutet, dass ein markiertes Produkt höher bepreist sein kann als ein nicht markierter Wettbewerber und trotzdem ausgewählt wird. Wie stark dieser Effekt ausfällt, hängt vom Modell ab.
Wie hilft Ecentic Händlern, für KI-Shopping-Agenten zu optimieren?
Ecentic simuliert, wie ChatGPT, Gemini, Claude und Perplexity Ihre Produktangebote bewerten, liefert verständliche Diagnosen und scannt nach Preis- oder Beschreibungsänderungen automatisch erneut. Außerdem überwacht die Plattform kanalübergreifende Preisparität und unterstützt Produktupdates mit einem Klick für Shopify- und WooCommerce-Shops.