

Ob Menschen Google nutzen, zu Amazon gehen oder einen Chatbot fragen: KI liefert ihnen eine Antwort mit einem Produkt. Die meisten E-Commerce-Marken wissen nicht, wie ihr Produkt zu dieser Empfehlung wird. Omnichannel-KI-Attribution nutzt maschinelles Lernen, um zu ermitteln, wie jeder Kanal, online wie offline, zu einer Bestellung beigetragen hat. Dafür braucht sie saubere Daten zu den Kontaktpunkten, einige Monate Historie und eine Methode, um zu prüfen, ob ihre Ergebnisse kausale Zusammenhänge zeigen und nicht nur plausibel klingen.
Meine Einschätzung: Attribution war schon immer eine Geschichte über die Vergangenheit, die sich aus Daten ergibt. KI erzählt diese Geschichte vor allem flüssiger. Das ist nützlich, solange Sie nicht vergessen, wer sie geschrieben hat. Gleichzeitig ist ein neuer Kanal entstanden: Der Assistent eines Käufers liest Ihren Produktfeed, wählt ein Produkt aus und kauft es manchmal auch. In den meisten Attributions-Dashboards gibt es dafür keine Spalte.
Kurzfassung
- Omnichannel-Attribution führt jeden Touchpoint, einschließlich Offline- und eigener Kanäle, zu einem Gesamtbild zusammen. Multichannel-Attribution vergleicht digitale Kanäle meist einzeln.
- KI-Modelle brauchen Touchpoint- und Conversion-Daten auf Nutzerebene. Adobe sagt, dass ein gutes Modell mindestens 90 Tage Daten und 1.000 Conversions braucht.
- Attribution beschreibt, was passiert ist. Nur Experimente zeigen Ihnen, was Ihr Marketing verursacht hat, daher sollten Sie das Modell mit Holdouts kalibrieren.
- Führen Sie es schrittweise ein: KPIs festlegen, Daten prüfen, zentralisieren, Modelle testen, dann das Budget anpassen und das Ergebnis beobachten.
- KI-Assistenten sind inzwischen eine Quelle für Besuche und Bestellungen. Erfassen Sie sie als eigenen Kanal und korrigieren Sie die Produktdaten, die sie lesen.
Was Omnichannel-Attribution in der Praxis bedeutet
Multichannel-Attribution verteilt die Zuordnung auf die digitalen Kanäle, die Sie nutzen: bezahlte Suche, Social Media, E-Mail, Affiliates. Jeder bekommt einen Anteil an der Bestellung. Omnichannel-Attribution geht einen Schritt weiter. Sie betrachtet den Käufer als eine Person, die einen Connected-TV-Spot sieht, ein Geschäft besucht, eine E-Mail öffnet und dann auf der Website kauft, und fragt, wie diese Kanäle sich gegenseitig verstärken.
Die Definition unterscheidet sich leicht von Anbieter zu Anbieter, und das ist wichtig, weil die Datenregeln des Anbieters festlegen, was „Omnichannel“ tatsächlich umfasst. Nehmen wir Klaviyo. Die Hilfecenter-Dokumentation zur Omnichannel-Attribution beschreibt die Kombination identifizierter Sitzungen auf der Website mit Interaktionen aus Klaviyo-Nachrichten. Anonyme Aktivitäten können einbezogen werden, nachdem der Käufer später identifiziert wurde, wenn diese Einstellung aktiviert ist. Sitzungen aus anderen Quellen zählen nur, wenn sie Attributionsparameter enthalten und innerhalb des konfigurierten Zeitfensters liegen. Das ist ein vollkommen nachvollziehbares Design für eine E-Mail- und SMS-Plattform. Gleichzeitig ist es ein engeres Verständnis von „Omnichannel“ als das eines TV-Planers.
Der Praxistest lautet: Wenn ein Tool von Omnichannel spricht, fragen Sie nach, welche Touchpoints es tatsächlich sehen kann und welche es ableitet. Ein Händler mit Kassensystem, Marktplatzpräsenz und Shopify-Shop hat drei Datenquellen, die sich selten einig sind, wer der Kunde ist. Die Attributionsebene ist nur so gut verbunden wie die darunterliegende Identitätsebene.
Was der KI-Teil zusätzlich leistet
Klassische Regeln sind einfach. First Touch ordnet den ersten Kontakt zu, Last Touch den letzten, lineare Modelle verteilen gleichmäßig. KI-basierte Modelle lernen die Gewichtungen stattdessen aus den Daten.
Die Dokumentation von Adobe ist ein gutes konkretes Beispiel. Die Übersicht zu Attribution AI erklärt, dass der Dienst den Einfluss und die inkrementelle Wirkung von Kundeninteraktionen über Kanäle und Phasen der Customer Journey hinweg berechnet, einschließlich Display-Impressions, versendeter und geöffneter E-Mails sowie Klicks aus bezahlter Suche. Dieselbe Seite listet auch die regelbasierten Modelle auf, die unterstützt werden: First Touch, Last Touch, linear, U-förmig und Time Decay. Selbst das KI-Produkt behält also die alten Modelle zum Vergleich bei, was ich für den richtigen Ansatz halte.
Der zweite Baustein ist Offline-Reichweite. Die Dokumentation zu Unified Modeling von Adobe beschreibt ein kausales KI-Modell, das aggregiertes Marketing-Mix-Modelling mit ereignisbasierten Multi-Touch-Attributionsdaten kombiniert. Der ereignisbasierte Teil erklärt die Customer Journey. Der aggregierte Teil erfasst Offline-Kanäle, abnehmende Grenzerträge und das Zusammenspiel der Kanäle. Keiner der beiden Ansätze erfüllt allein die gesamte Aufgabe, und genau deshalb gibt es hybride Modelle.
Was bringt Ihnen KI also konkret? Meiner Erfahrung nach drei Dinge, wenn man diese Systeme liest:
Sie verarbeitet viele Touchpoints, ohne dass Sie Gewichtungen manuell festlegen müssen. Sie kann verzögerte Effekte modellieren, was bei überlegten Käufen wichtig ist. Und sie schätzt neu, wenn sich das Verhalten verändert. Was sie Ihnen nicht liefert, ist Wahrheit. Sie liefert eine besser passende Schätzung.
Welche Daten sie benötigt
Hier stocken die meisten Projekte, meist noch bevor überhaupt ein Modell erstellt wird.
Die Dokumentation zu Ein- und Ausgaben von Attribution AI von Adobe ist konkret. Das Modell benötigt Identitäts- und Zeitstempelfelder für Touchpoints und Conversions, Kanal- und Marketingfelder für Touchpoints sowie Commerce-Conversion-Daten. Ein gutes Modell braucht mindestens 90 Tage Daten und mindestens 1.000 Conversions, und die Standardwerte für Training und Lookback erfordern 236 Tage Eingabedaten. Adobe empfiehlt außerdem, möglichst viele Conversion- und Touchpoint-Spalten einzubeziehen.
Vergleichen Sie das mit einem kleinen Shop. Wenn Sie 200 Bestellungen pro Monat haben, erreichen Sie innerhalb des Mindestzeitraums von 90 Tagen keine 1.000 Conversions. Das ist kein Urteil über Ihr Marketing, sondern nur über dieses konkrete Produkt. Kleinere Teams fahren besser mit einfacheren, transparenten Modellen plus einigen sauber durchgeführten Holdout-Tests.
Die Daten können aus der eigenen Analytics-Lösung des Anbieters oder aus externen Quellen stammen, wie die gleiche Adobe-Übersicht erklärt. Graphbasierte neuronale Ansätze sind anspruchsvoller. Die technische Dokumentation von Kumo zur Conversion-Attribution erklärt, dass sie Daten zu User Journeys auf Nutzerebene, Zeitstempel und klar definierte Conversion-Ereignisse benötigen und ungeeignet sind, wenn nur aggregierte Kanaldaten vorliegen.
Einfach gesagt brauchen Sie drei Dinge, bevor ein Modell überhaupt hilft:
| Vorhandene Daten | Passender Ansatz |
|---|---|
| Aggregierte Werbeausgaben und Verkäufe pro Woche, keine User Journeys auf Nutzerebene | Marketing-Mix-Modelling und einfache Holdout-Tests |
| Web- und E-Mail-Daten auf Nutzerebene, eine Identität | Regelbasierte und datengetriebene Multi-Touch-Attribution |
| Daten auf Nutzerebene über Web, App, Geschäft und Werbung hinweg plus ausreichendes Volumen | Machine-Learning-Attribution, kalibriert mit Experimenten |
Diese Tabelle spiegelt die Datenanforderungen aus der oben genannten Adobe- und Kumo-Dokumentation wider. Wählen Sie die Zeile, in der Sie heute stehen, nicht die, in der Sie gern wären.
Attribution ist nicht gleich Inkrementalität
Wenn Sie vor dem Kauf eines Attribution-Tools nur eine Sache lesen, dann den Unterschied zwischen diesen beiden Konzepten.
Die Richtlinien des IAB für inkrementelle Messung in Commerce Mediaaus dem November 2025 trennen beides klar voneinander. Attribution und ROAS beschreiben den beobachteten Beitrag, also das, was passiert ist. Inkrementalität schätzt den zusätzlichen Effekt, den Marketing verursacht hat, verglichen mit einem glaubwürdigen Szenario ohne Marketing. Die Richtlinien nennen die Designs, die so etwas liefern: randomisierte Kontrollgruppen, Holdouts oder Ghost Ads, gematchte Märkte und synthetische Kontrollgruppen. Sie warnen außerdem davor, dass Saisonalität, Preisgestaltung, Aktionen, Wettbewerber, parallele Kampagnen, Selection Bias, Multikollinearität und unvollständige Verknüpfungen von Werbekontakten die Schätzung verzerren können.
Diese letzte Liste erklärt, warum Ihre Black-Friday-Zahlen schwer zu interpretieren sind. Alles bewegt sich gleichzeitig.
Forscher versuchen, diese Lücke zu schließen. Eine Studie in Management Science, Predicted Incrementality by Experimentationveröffentlicht am 8. Oktober 2026, nutzte 2.226 Meta-Experimente, um eine Zuordnung von Experimenten zu nicht experimentellen Kampagnen zu lernen. Die Studie berichtet über ein Out-of-sample-R² von 0,88 für inkrementelle Conversions pro Dollar gegenüber 0,19 bei Sieben-Tage-Last-Click-Attribution. Außerdem berichtet sie, dass ihre Methode bei 8 % bis 12 % der Kampagnen von experimentbasierten Entscheidungen abwich, verglichen mit 12 % bis 20 % bei Last Click.
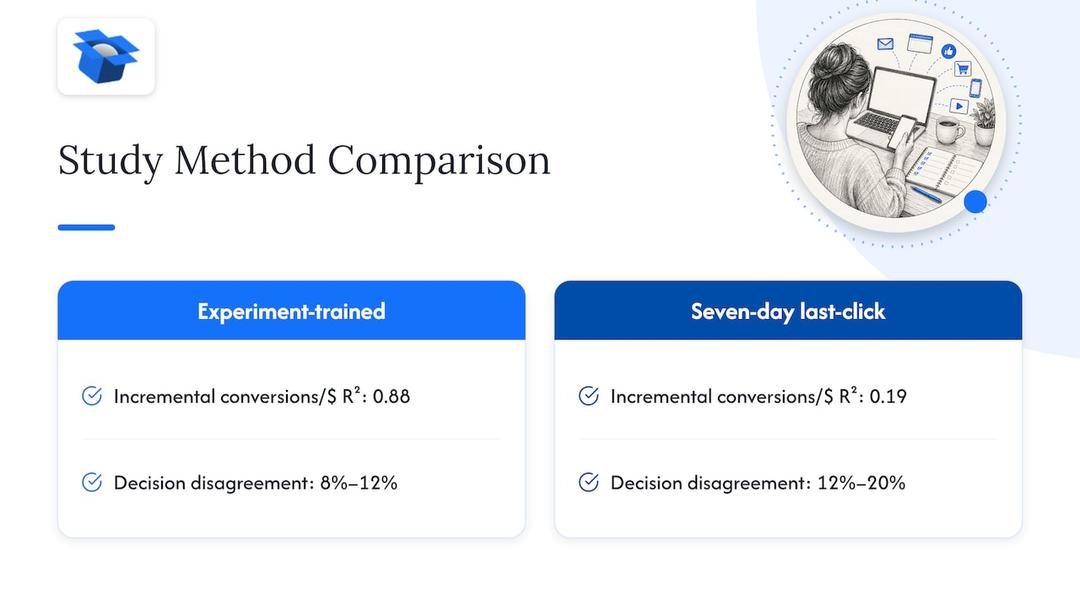
Ich nehme daraus zwei Dinge mit. Last Click ist ein schwacher Prädiktor dafür, was Werbung tatsächlich bewirkt, was die meisten von uns ohnehin vermutet haben. Und der leistungsstärkste Ansatz lernte weiterhin aus randomisierten Experimenten. Die KI hat das Experiment nicht ersetzt, sondern erweitert.
Wichtiger Vorbehalt: Die Studie betrachtet Werbekampagnen auf nur einer Plattform. Sie sagt nichts darüber aus, wie sich Ihre E-Mails, Ihr Ladenverkehr oder organische Kanäle verhalten. Betrachten Sie sie als Beleg für die Methode, nicht als Benchmark für Ihre Zahlen.
Ein Rollout, den Sie noch dieses Quartal umsetzen können
Das Playbook des IAB zur kanalübergreifenden Messung beschreibt eine Reihenfolge, die für E-Commerce-Teams fast jeder Größe funktioniert. Hier ist sie in praktischer Form:
- Ziel und KPIs definieren. Definieren Sie die Entscheidung, die das Modell verändern soll, etwa die Verschiebung von Budget zwischen Paid Social und E-Mail. Wenn keine Entscheidung von der Antwort abhängt, lassen Sie das Projekt aus.
- Kanäle und Touchpoints erfassen. Der Attributionsleitfaden von Dataiku empfiehlt, jeden Touchpoint aufzulisten und Datenquelle sowie Einschränkungen zu dokumentieren, weil schlecht verstandene Daten sowohl die Genauigkeit als auch das Vertrauen der Beteiligten untergraben.
- Daten zentralisieren. Das IAB-Playbook beschreibt, wie alle Kanäle in einem Warehouse oder Data Lake zusammengeführt, Governance-Regeln durchgesetzt und ETL-Prozesse (die Jobs zum Verschieben und Bereinigen von Daten) möglichst automatisiert werden.
- Mehrere Modelle parallel testen. Dasselbe Playbook empfiehlt datengetriebene Attribution mit Machine Learning zusätzlich zu Single-Touch- und regelbasierten Multi-Touch-Modellen. Wenn die Modelle unterschiedliche Ergebnisse liefern, ist genau das eine wichtige Information.
- Das Lookback-Fenster realistisch festlegen. Adobe Mix Modeler ermöglicht Teams Lookback-Fenster von 1 bis 52 Wochen zu definieren und kanalspezifische Adstock- und Lag-Einstellungen zu konfigurieren, damit langsame Kanäle nicht wie sofort wirkende behandelt werden.
- Datenschutz und Einwilligungen prüfen. Tun Sie das vor dem Aufbau, nicht erst nach dem Launch.
- Budget ändern und beobachten. Dataiku erklärt, dass sich Attributionsmodelle nicht wie gewöhnliche Vorhersagemodelle bewerten lassen, weil es kein bekanntes Label zum Vergleich gibt. Der Praxistest besteht darin, Budgets auf Basis des Modells zu verschieben und die Geschäftsergebnisse zu beobachten.
Schritt sieben wird von Teams oft übersprungen. Ein Modell, nach dem niemand handelt, ist nur ein Dashboard.
Grenzen und Datenschutz, klar benannt
Der Leitfaden des IAB zu Best Practices für kanalübergreifende Messung nennt Datensilos, die Komplexität der Attribution, technologische Hürden und Datenschutzbedenken als Hindernisse. Empfohlen werden zentralisierte Daten, granulare Datensätze auf Impressionsebene, zur Fragestellung passende Attributionsmodelle, Predictive Analytics, Dashboards und Einwilligungsmanagement. Nichts davon ist exotisch. Es ist größtenteils Grundlagenarbeit, und genau die entscheidet darüber, ob ein Modell funktioniert.
Der State of Data 2026 Report des IABeine US-Studie aus dem Februar 2026, erklärt, dass Datenschutzregulierung und Plattformänderungen Daten über voneinander getrennte Systeme fragmentiert haben. Die Studie nennt rechtliche, sicherheitsbezogene, Genauigkeits-, Datenqualitäts-, Zugänglichkeits-, Setup-, Kosten- und Bias-Probleme als wesentliche Hürden für den KI-Einsatz in der Messung.
Datenschutzfreundliche Verfahren haben ihren Preis. Eine systematische Übersicht von 108 Studien aus dem Jahr 2026 berichtet, dass differenzielle Privatsphäre die Präzision je nach Privacy Budget in den dokumentierten Einstellungen um 2 % bis 33 % reduzierte. Dieselbe Übersicht erklärt, dass föderierte Ansätze in dokumentierten Implementierungen etwa 90 % bis 95 % der Leistung zentralisierter Systeme erreichten, während Generalisierbarkeit und kausale Glaubwürdigkeit weiterhin zu wenig getestet sind. Außerdem zeigt sie, dass Deep-Learning-Attribution die Vorhersagegenauigkeit verbessern kann, ohne experimentelle Kalibrierung aber kausal nicht eindeutig identifizierbar bleibt.
Die ehrliche Zusammenfassung lautet also: Mehr Datenschutz bedeutet meist ein unschärferes Modell, und ein schärferes Modell ist nicht automatisch ein korrekteres. Beides sind Gründe, Experimente weiterhin einzubeziehen.
Der Kanal, den die meisten Attributions-Setups übersehen
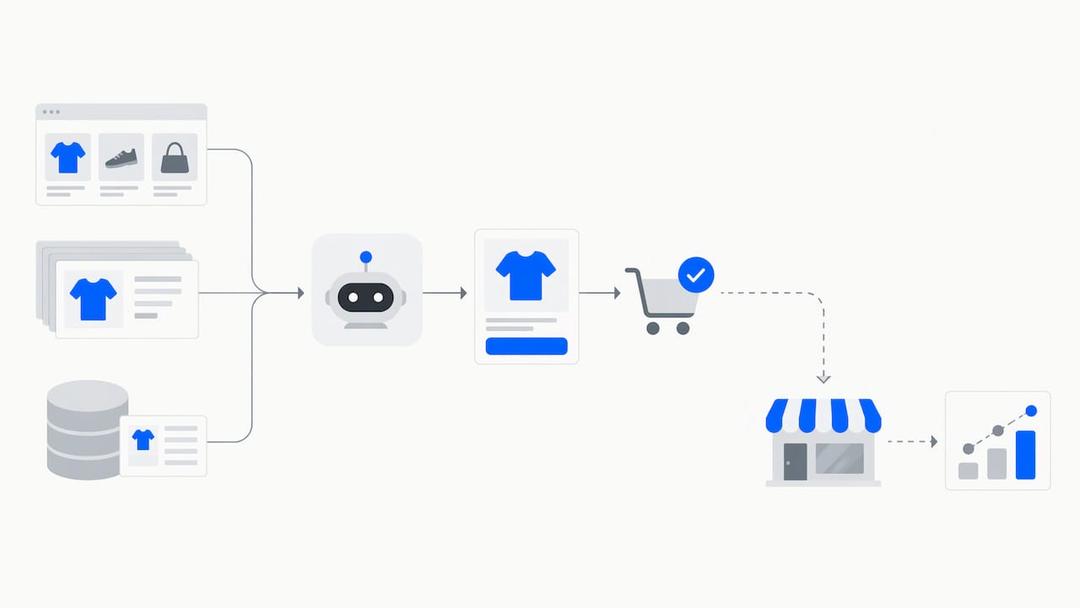
Hier beginne ich, vom Standard-Playbook abzuweichen. Es geht davon aus, dass der Käufer selbst klickt. Ein wachsender Anteil der Produktsuche läuft inzwischen über einen Assistenten, der Ihre Daten im Namen des Käufers liest. Der Assistent sieht Ihre Startseite nie. Er liest den Produktfeed, den Katalog und die strukturierten Daten auf Produktseiten (die maschinenlesbaren Angaben dazu, was ein Produkt ist, kostet und wie es versendet wird).
Im AI Mode von Google und bei Gemini in den USA kann ein Agent über UCP, den offenen Standard von Google für den Checkout durch Agenten, sogar den Kaufabschluss für den Käufer durchführen. ChatGPT verlinkt dagegen auf den eigenen Checkout des Shops. OpenAI hat ACP, Google hat UCP, Amazon hat eine geschlossene Plattform.
Für die Attribution entstehen dadurch zwei Probleme. Erstens landen Besuche von Assistenten oft in den Kategorien „direct“ oder „referral“, sodass der Kanal unsichtbar bleibt. Zweitens trifft der Assistent seine Auswahl, bevor irgendein messbarer Touchpoint entsteht. Wenn Ihre Produktdaten den Vergleich verlieren, erhalten Sie gar keinen Besuch mehr, den Sie zuordnen könnten.
Wir haben gesehen, wie unausgewogen diese Auswahl ist. In unseren eigenen simulierten Käufen mit demselben Katalog wählte ChatGPT das Produkt etwa dreimal so häufig wie Claude oder Gemini, 51,6 % gegenüber rund 18,5 %. Jeder Assistent ist faktisch ein eigener Kanal mit eigenen Regeln. Wenn Sie die Messseite im Detail verstehen möchten, behandeln diese Seiten das Thema: wie Sie KI-Shopping-Traffic verfolgen, was Sie mit KI-Attribution im E-Commerce messen können und cookielose Attribution mit KI. Wenn Sie Software auswählen, nennt unser Vergleich von KI-Attributionstools die Alternativen und erklärt, für wen sie jeweils geeignet sind.
Wichtiger Vorbehalt: ecentic ist keine vollständige Omnichannel-Attribution-Suite. Es modelliert weder TV-Ausgaben noch Laufkundschaft im Geschäft. Auf Shopify verfolgt es Besuche von KI-Assistenten, wodurch die oben beschriebene Lücke geschlossen wird, und es verfolgt weder Umsatz noch Verkäufe. Für alles andere sollten Sie Ihren bestehenden Attribution-Stack weiter nutzen.
Unsere Sicht darauf, wohin Attribution als Nächstes geht
Wir glauben, dass sich die nächste Auseinandersetzung bei Attribution nicht um Cookies drehen wird. Es geht darum, wer vor dem Klick ausgewählt wird. Wenn ein KI-Agent einem Käufer ein einziges Produkt empfiehlt, tauchen die Marken, die diesen Vergleich verlieren, in keinem Bericht mehr auf, egal wie ausgefeilt das Modell ist.
Deshalb arbeiten wir direkt am Shop selbst: am Produktfeed, am Katalog und am Checkout, den ein Agent für den Kauf nutzt. ecentic verbindet sich mit Shopify, WooCommerce oder einem Produktfeed, lässt ChatGPT, Claude und Gemini jedes Produkt mit dem eines benannten Wettbewerbers vergleichen und zeigt, warum es verliert. Wenn der Händler auf Apply klickt, schreibt ecentic Titel, Beschreibung und strukturierte Daten neu und veröffentlicht sie im Shop.
Auf Shopify überträgt ecentic die Optimierungen in Google Merchant Center und verfolgt Besuche von KI-Assistenten. Unter WooCommerce ermöglicht das kostenlose ecentic-Plugin Agenten die Suche, das Befüllen eines Warenkorbs und den Kaufabschluss über UCP. Genau dieser Checkout-Teil fehlt bei einfachen Feed-Tools.
Die Zahlen sind noch früh, und das sagen wir auch offen. In unserem ersten Pilotprojekt mit DUA Flavours stiegen Besuche von KI-Assistenten und direkter Traffic von April bis Juli 2026 um 12 %. Das ist eine Besuchszahl, keine Verkaufszahl, und wir stellen sie auch nicht anders dar.
Die sinnvolle Reihenfolge ist aus meiner Sicht diese: Messen Sie weiterhin Ihre klassischen Kanäle, kalibrieren Sie mit Experimenten und stellen Sie sicher, dass Agenten Ihren Shop überhaupt lesen und dort einkaufen können. Einen Kanal zu messen, den Sie gerade verlieren, ist eine sehr präzise Methode, dabei zuzusehen, wie Sie verlieren.
Xhurian Shaba
Testen Sie es mit Ihren eigenen Produkten
Wenn Sie sehen möchten, wie Assistenten Ihre Produkte mit denen eines benannten Wettbewerbers vergleichen, starten Sie mit dem kostenlosen Scan. Er umfasst Ihre 10 wichtigsten Produkte und benötigt keine Kreditkarte. Er zeigt in klarem Englisch, warum ein Agent das andere Produkt auswählt, damit Sie wissen, was Sie bei Titel, Beschreibung und strukturierten Daten ändern müssen.

Die kostenpflichtigen Tarife beginnen mit Compete für 14,90 $ pro Monat für bis zu 100 Produkte. Scale kostet 44,90 $ pro Monat für bis zu 1.000 Produkte inklusive One-Click-Fixes. Dominate kostet 149 $ pro Monat und ergänzt die Synchronisierung mit Google Merchant Center sowie die Einrichtung des Agent-Checkouts. Zusätzlich gibt es ein nutzungsbasiertes Modell mit 3 % der KI-attribuierten Bestellungen, gedeckelt auf 500 $ pro Monat. Die aktuellen Konditionen finden Sie auf der Preisseite von ecenticund So funktioniert es erklärt Schritt für Schritt Simulation, Diagnose und Optimierung.
FAQ
Was ist der Unterschied zwischen Omnichannel- und Multichannel-Attribution?
Multichannel-Attribution verteilt die Zuordnung auf die digitalen Kanäle, die Sie nutzen, meist kanalweise. Omnichannel-Attribution versucht, alle Touchpoints einschließlich Offline- und eigener Kanäle rund um einen einzelnen Kunden zu verbinden. In der Praxis hängt der Unterschied davon ab, welche Daten das Tool tatsächlich zusammenführen kann. Prüfen Sie deshalb genau, welche Touchpoints es sieht.
Wie viele Daten benötigt KI-Attribution?
Das hängt vom Produkt ab. Die Dokumentation zu Adobe Attribution AI erklärt, dass ein gutes Modell mindestens 90 Tage Daten und 1.000 Conversions benötigt und die Standardeinstellungen 236 Tage Eingabedaten vorsehen. Shops unterhalb dieses Volumens sind mit einfacheren Modellen und Holdout-Tests meist besser bedient.
Kann KI-Attribution beweisen, welcher Kanal einen Verkauf verursacht hat?
Nein, nicht allein. Die Richtlinien des IAB erklären, dass Attribution beschreibt, was passiert ist, während Inkrementalität ein glaubwürdiges Vergleichsszenario wie Holdouts oder gematchte Märkte benötigt. Nutzen Sie das Modell, um Hypothesen zu bilden, und Experimente, um sie zu bestätigen.
Erfasst Omnichannel-Attribution Traffic von KI-Assistenten?
Nur wenn Sie das entsprechend einrichten. Viele Setups ordnen Besuche von Assistenten dem direkten oder Referral-Traffic zu. Kennzeichnen Sie Assistenten als eigene Quelle und stellen Sie sicher, dass die gelesenen Produktdaten vollständig sind, damit Ihre Produkte überhaupt ausgewählt werden können.
Quellen
- Omnichannel-Attribution verstehen, Klaviyo Help Center
- Übersicht zu Attribution AI, Adobe Experience Platform
- Unified Modeling, Adobe Marketing Campaign Analytics
- Ein- und Ausgaben in Attribution AI, Adobe Experience Platform
- Conversion-Attribution für Ad Tech, Kumo
- Richtlinien für inkrementelle Messung in Commerce Media, IAB
- Predicted Incrementality by Experimentation, Management Science
- Implementierung kanalübergreifender Messung für Marketer, IAB
- Marketing-Attribution mit Machine Learning stärken, Dataiku
- Modelle in Mix Modeler erstellen, Adobe
- Best Practices für kanalübergreifende Messung für Marketer, IAB
- IAB State of Data 2026
- Vertrauenswürdige KI für Marketing Measurement: Eine systematische Übersicht, SSRN
Diese Themen entdecken