

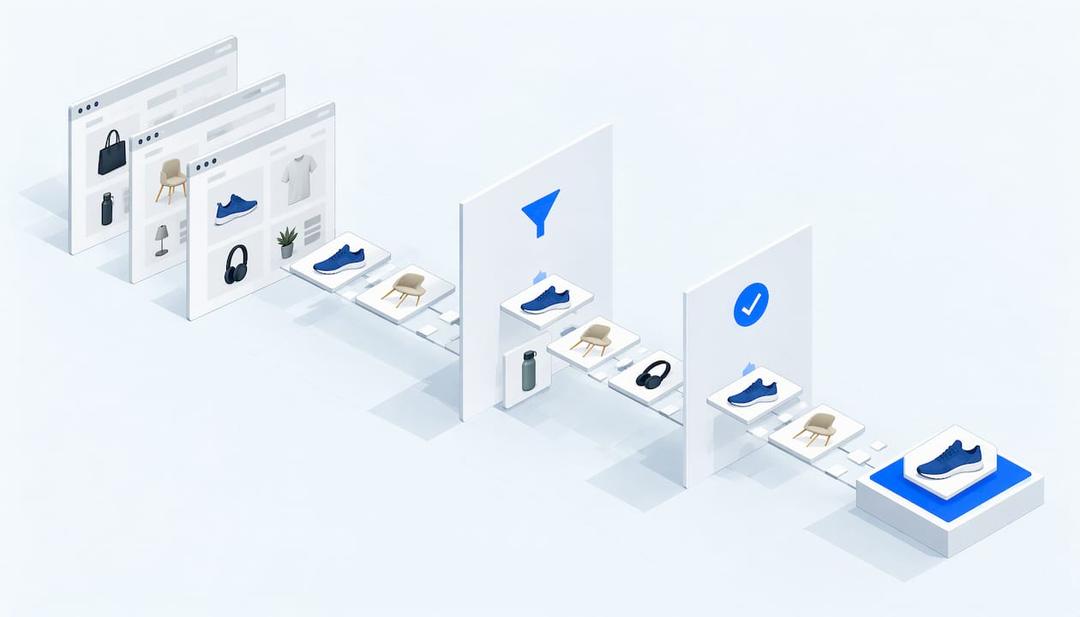
LLM-Evaluierung im E-Commerce bedeutet, zu testen, ob ein Sprachmodell reale Shopping-Aufgaben korrekt erledigt: das richtige Produkt finden, es mit anderen vergleichen und es bis zum Warenkorb bringen. Für einen Shop gibt es davon zwei Varianten. Sie können einen Chatbot testen, den Sie auf Ihrer eigenen Website betreiben, oder Sie testen, wie externe KI-Agenten mit Ihren Produkten umgehen. Ob Menschen Google nutzen, zu Amazon gehen oder einen Chatbot fragen: KI gibt ihnen inzwischen eine Antwort mit einem Produkt, und die meisten E-Commerce-Marken haben keine Ahnung, wie sie zu diesem Produkt werden.
Meine Sicht: Die meiste Diskussion über Evaluierung richtet sich an Menschen, die das Modell bauen, und fast gar nicht an die Person, die darüber verkaufen muss. Wenn Sie einen Shop betreiben, müssen Sie dem Modell keine Note geben. Sie müssen wissen, warum es das Produkt eines anderen auswählt. Das ist eine andere Prüfung, und Ihr Shop muss sie bestehen.
Kurzfassung
- Einen Einkaufsagenten zu bewerten bedeutet, den gesamten Ablauf zu beurteilen: Suche, Klärung, Empfehlung und Hinzufügen zum Warenkorb – nicht nur einzelne Antworten.
- Aktuelle Forschung zeigt, dass selbst starke Modelle bei vielen Shopping-Aufgaben scheitern, daher müssen Ihre Produktdaten mehr leisten, als Ihnen lieb sein dürfte.
- Agenten lesen Ihren Produktfeed, Ihren Katalog und die strukturierten Daten, nicht Ihre Startseite. Fehlende Kennungen, vage Preise und nicht quantifizierte Spezifikationen führen dazu, dass Ihr Produkt weggelassen wird.
- Für Shop-Betreiber ist der nützliche Test ein direkter Vergleich: dieselbe Käuferfrage, Ihr Produkt gegen das eines namentlich genannten Wettbewerbers, mehrfach wiederholt.
- Daten korrigieren, veröffentlichen, erneut ausführen. Ein Scan ist eine Momentaufnahme, eine Serie von Durchläufen ist ein Beleg.
Zwei Bedeutungen von LLM-Evaluierung im E-Commerce
Der Begriff deckt zwei Aufgaben ab, die oft durcheinandergebracht werden.
Die erste Aufgabe ist die Bewertung eines LLM, das Sie selbst einsetzen: ein Einkaufsassistent auf Ihrer Website, der Fragen beantwortet, Produkte empfiehlt und sie in den Warenkorb legt. Hier wählen Sie das Modell, kontrollieren den Prompt und können jede Unterhaltung einsehen. Die Frage ist, ob der Assistent tatsächlich gut ist.
Die zweite Aufgabe ist die Bewertung, wie externe KI-Agenten mit Ihrem Shop umgehen. Sie wählen das Modell nicht aus. Das tut der Käufer, oft ohne es zu wissen. Der Agent sieht nie Ihre Startseite. Er liest Ihren Produkt-Feed, Ihren Katalog und die strukturierten Daten auf den Produktseiten und entscheidet dann, welches Produkt dem Käufer angezeigt wird. Die Frage ist, ob Ihre Produkte diesen Prozess bestehen.
Der Großteil der akademischen Forschung beschäftigt sich mit der ersten Aufgabe. Für die zweite lohnt sie sich trotzdem, weil sie zeigt, wie eine Shopping-Aufgabe aussieht, wenn sie sauber bewertet wird, und an welchen Stellen Modelle scheitern.
Was die Benchmarks tatsächlich testen
Ein Forscher bei Rezolve veröffentlichte ein Workshop-Paper für die RecSys 2026, das 12 Modelle als dialogbasierte Shopping-Agenten benchmarkt und dabei den gesamten Ablauf von Suche, Klärung, Empfehlung und In-den-Warenkorb-Legen abdeckt. Bewertet werden 1.200 Gespräche (fünf Durchläufe über 20 Szenarien) mithilfe eines LLM-Richters mit fünf Bewertungskriterien sowie Verhaltensmetriken aus den Gesprächsverläufen. Die Kriterien decken Intent-Erkennung, Rückfragen, Qualität der Empfehlungen, Korrektheit beim Hinzufügen zum Warenkorb und Grounding ab. Grounding ist schlicht die Frage, ob die Aussagen des Agenten zu den bereitgestellten Produktdaten passen.
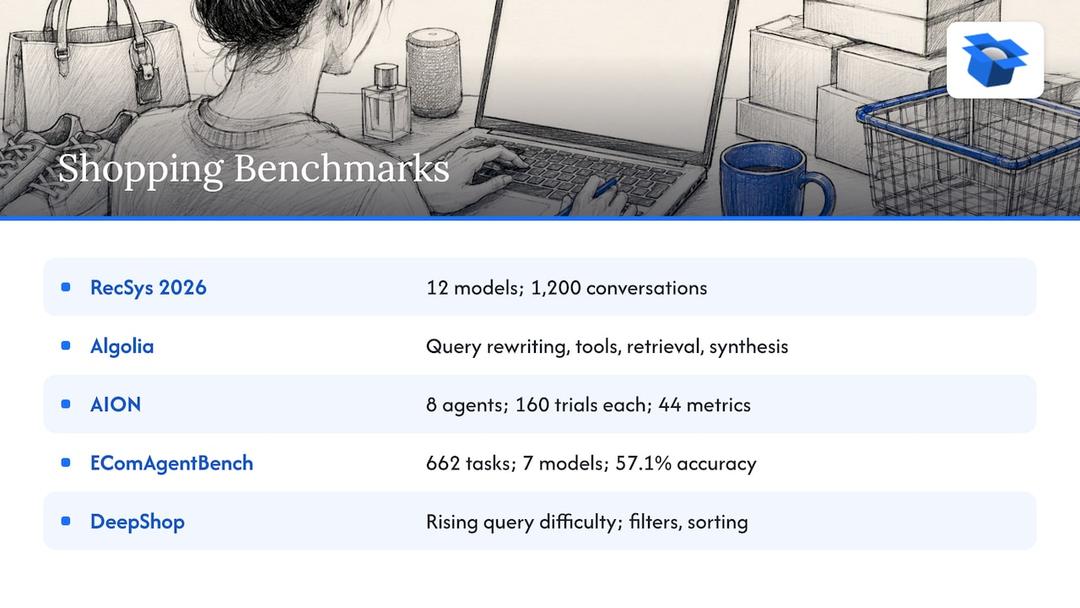
Das Leaderboard von Algolia verfolgt einen ähnlichen Ansatz aus Sicht der Suche. Jedes Modell läuft innerhalb eines produktiven Retrieval-Agenten und wird bewertet nach Query-Rewriting, Tool-Aufrufen, Retrieval und Antwortsynthese, wobei Antworttexte, Tool-Aufrufe und abgerufene Datensätze ausgewertet werden. Das Modell wird also als Teil eines Systems beurteilt, nicht als Teilnehmer eines Trivia-Wettbewerbs.
Das AION-Paper geht bei der methodischen Strenge noch weiter. Es baut eine deterministische Shopping-Umgebung auf, in der Kundenprofil, Schwierigkeit und Ziel-Warenkorb jedes Tests im Voraus festgelegt sind, und testet dann acht Open-Weight-Agenten mit jeweils 160 Tests und 44 Metriken. Der hilfreiche Punkt daran ist: Ein einfaches Bestanden oder Nichtbestanden am Ende verdeckt, was genau schiefgelaufen ist. Durch die Speicherung von Tool-Trace und Umgebungsstatus lassen sich zu wenig Aktionen, Fehlkäufe, nicht belegte Produktattribute und schlechte Suche voneinander trennen. Das sind vier unterschiedliche Fehlerarten, die alle wie „der Agent lag falsch“ aussehen.
EComAgentBench aus dem EMNLP 2026 Industry Track verwendet 662 Aufgaben auf Basis echter Amazon-Produkte und -Bewertungen. Anforderungen sind über eine sichtbare Anfrage, ein verborgenes Profil und skriptgesteuerte Rückfragen verteilt, und der Agent muss sich auf genau ein Produkt festlegen. Selbst das stärkste der sieben Modelle erreichte nur 57,1 % Gesamtgenauigkeit, und die Ergebnisse verschlechterten sich, je stärker Anforderungen von sichtbaren zu verborgenen Quellen verlagert wurden.
DeepShop von der Universität Amsterdam testet Web-Agenten mit zunehmend komplexen Shopping-Anfragen. Das Ergebnis lautet: Einfache Retrieval-Verfahren haben Schwierigkeiten mit komplexen Suchanfragen, andere Methoden scheitern an Filtern und Sortierpräferenzen.
Zusammen gelesen sagen diese Papers dasselbe mit unterschiedlichem Schwerpunkt. Shopping ist eine Aufgabe mit mehreren Schritten, Agenten scheitern auf konkrete und nachvollziehbare Weise, und ein Modell, das selbstsicher klingt, kann trotzdem das falsche Produkt auswählen. Das entspricht ungefähr dem Einkaufsverhalten vieler Menschen nach Mitternacht, insofern wirken die Maschinen zumindest vertraut.
Metriken, die für einen Shop zählen
Forscher bewerten Modelle. Händler müssen Ergebnisse bewerten. Eine sinnvolle Kombination sieht etwa so aus.
Genauigkeit dessen, was der Agent über Ihr Produkt sagt. Ein Fachartikel über dialogbasierte Shopping-Assistenten definiert die Genauigkeit von Produktinformationen für Preis, Lagerbestand und Eigenschaften, die Genauigkeit von Preisspannen und die Genauigkeit von Merkmalsbeschreibungen. Wenn ein Agent den falschen Preis nennt oder eine Funktion erfindet, rettet keine Ranking-Metrik den Kaufabschluss.
Auswahlquote. Wie oft wählt der Agent bei wiederholten Durchläufen derselben Käuferfrage Ihr Produkt statt der Alternativen aus? Genau diese Kennzahl interessiert Shop-Betreiber am meisten. Es ist eine Quote und kein simples Ja oder Nein, weil Modellantworten zwischen den Durchläufen variieren.
Verhalten über das gesamte Gespräch hinweg. Das Zalando-Paper zur Bewertung produktiver Agenten spricht sich dafür aus, gesamte Gespräche statt einzelner Dialogschritte zu bewerten, weil aggregierte Werte wie Relevanz zwar zeigen, dass sich die Qualität verändert hat, aber nicht, was genau fehlgeschlagen ist oder wie sich das beheben lässt. Für Händler bedeutet das: Zählen Sie nicht nur Gewinne, sondern lesen Sie nach, warum Sie verloren haben.
Breite statt nur Genauigkeit. Ein Paper zur Multi-Objective-Bewertung von Empfehlungssystemen warnt davor, dass eine Optimierung allein auf Genauigkeit Systeme hervorbringt, die unter realen Bedingungen schlecht übertragen, und fordert zusätzliche Kennzahlen wie Diversität, Abdeckung und Fairness. Für einen Shop bedeutet das, den gesamten Katalog zu prüfen und nicht nur die fünf wichtigsten Produkte.
Wichtiger Hinweis: Keine dieser akademischen Metriken misst Umsatz. Sie zeigen, ob ein Agent die Aufgabe grundsätzlich erfüllen könnte, nicht ob Ihr Kontostand etwas davon merkt. Dafür brauchen Sie zusätzlich Ihre eigenen Bestelldaten.
Was Agenten aus Ihren Daten benötigen
Die günstigste Erkenntnis aus Evaluierungen, die ich kenne, lautet: Agenten vergleichen Datensätze, nicht Seiten.
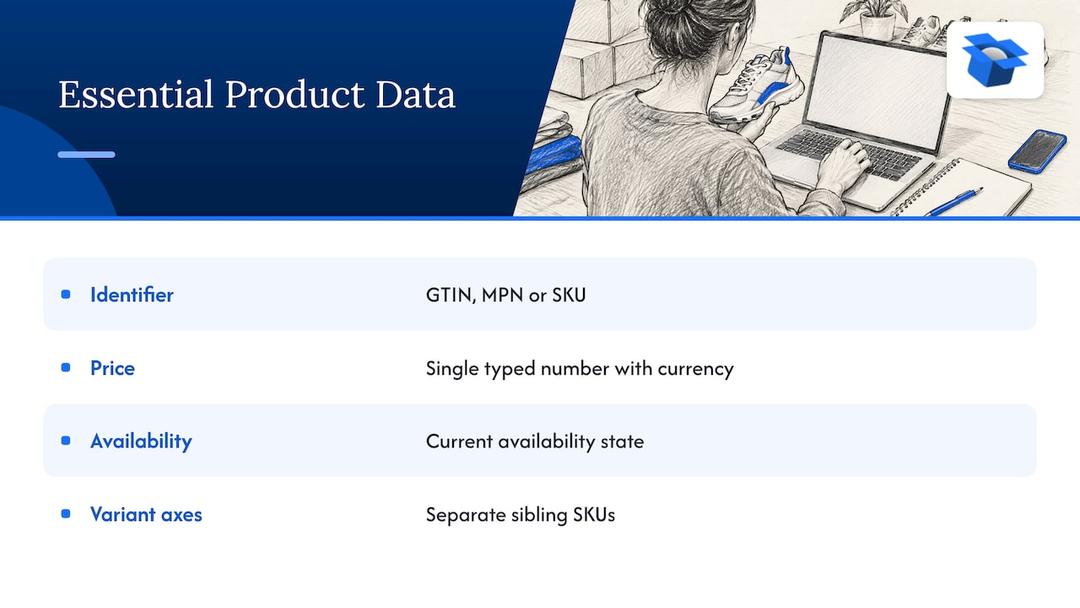
Ecommerce Guide beschreibt vier Arten von Feldern, die entscheiden, ob ein Artikel überhaupt vergleichbar ist: eine stabile Kennung (GTIN, MPN oder SKU), ein aktueller Preis mit Währung, ein Verfügbarkeitsstatus und die Variantenachsen, die eine SKU von ähnlichen Produkten unterscheiden. Fehlt eines davon, fällt der Artikel aus einem eingeschränkten Vergleich heraus. Dieselbe Quelle weist außerdem darauf hin, dass der Preis als einzelner typisierter Zahlenwert vorliegen muss. Ein Anzeigewert wie „ab $39“ gibt dem Agenten nichts, das er gegen ein Budget von $60 prüfen kann, sodass der Artikel stillschweigend ausgeschlossen wird.
Spezifikationen sind die andere Schwachstelle. Eine numerische Einschränkung lässt sich nicht gegen ein Adjektiv prüfen. „Leicht“ ist ein Eindruck, „1,2 lb“ ist ein Wert. Die meisten Kataloge bestehen aus Eindrücken.
Das deckt sich mit unseren Beobachtungen aus Audits. Ein Spirituosen-Marktplatz mit rund 70 Mio. € Jahresumsatz hatte bei 88 % seiner 9.699 Produkte einen Fehler in den Daten, die Agenten auslesen. Als Agenten gefragt wurden, wo zwei dort gelistete Flaschen gekauft werden können, tauchte der Shop in 20 Versuchen 0-mal auf. Bei einer schwedischen Hautpflegemarke erreichten Agenten-Checkouts in 0 von 6 Ländern die Zahlung, weil eine Versandeinstellung eine Telefonnummer verlangte. Ich nenne beide Shops bewusst nicht. Entscheidend ist: Keiner dieser Fehler war auf der Website sichtbar. Ein menschlicher Käufer hätte ihn nie bemerkt. Der Agent bemerkte ihn sofort und verließ den Shop, ohne Beschwerde und ohne Bewertung.
Wenn Sie mehr darüber erfahren möchten, wie die Produktseite selbst dabei eine Rolle spielt, erklärt unser Leitfaden zu KI-lesbaren Produktseiten das Markup, und der Beitrag über wie KI-Shopping-Agenten Ihre Produkte empfehlen behandelt die Auswahlmechanik.
So testen Sie Ihren eigenen Shop Schritt für Schritt
Sie brauchen kein Forschungslabor. Sie brauchen einen wiederholbaren Ablauf. So würde ich vorgehen.
- Die Fragen der Käufer formulieren. Wählen Sie 10 bis 20 echte Fragen aus, die Ihre Kunden stellen würden, jeweils mit Einschränkungen wie Budget, Größe, Anwendungsfall oder Lieferland. Lassen Sie Ihren Markennamen weg, denn Käufer tippen ihn meist nicht ein.
- Für jedes Produkt einen konkreten Wettbewerber festlegen. Der Agent entscheidet zwischen Optionen, also brauchen Sie eine Option, gegen die Sie verlieren können. Verwenden Sie den Wettbewerber, der bei Ihrer eigenen Kategoriesuche am häufigsten erscheint.
- Mehr als ein Modell und mehr als einen Durchlauf testen. Modelle widersprechen sich gegenseitig, und dasselbe Modell widerspricht oft sich selbst. In unseren eigenen Simulationen mit demselben Katalog wählte ChatGPT das Produkt etwa 3x so häufig wie Claude oder Gemini (51.6% gegenüber rund 18.5%). Das Urteil eines einzelnen Modells ist nicht das Urteil des Marktes.
- Festhalten, warum verloren wurde. Ein Verlustgrund wie „Der Wettbewerber listet eine GTIN auf, Ihr Produkt nicht“ ist wertvoller als zehn Diagramme zur Gewinnquote. Zalandos Argument für die Auswertung kompletter Gespräche gilt auch hier.
- Daten korrigieren und erneut testen. Ändern Sie jeweils nur eine Problemklasse, zum Beispiel zuerst Kennungen, dann Preise, dann Spezifikationen, damit klar bleibt, was das Ergebnis verändert hat. Das Zalando-Framework verwendet wiederholte Durchläufe zur Festlegung einer Basislinie und Paarvergleiche isolierter Änderungen, und diese Logik funktioniert auch im Maßstab eines Shops.
- Nicht nur die Antwort testen, sondern auch den Checkout. Eine Empfehlung zu gewinnen und dann an der Zahlung zu scheitern, war genau die Geschichte der Hautpflegemarke oben. Gehen Sie den Weg durch, den ein Agent nehmen würde: Suche, Warenkorb, Versand, Zahlung.
Für Schritt 6 auf der Seite von Google bietet unser UCP Playground ermöglicht es Ihnen, KI-Shopping-Agenten anhand eines Shops zu testen. UCP ist der offene Standard von Google für Agenten-Checkouts. Einkäufe direkt innerhalb der KI-Antwort sind heute bereits über UCP in Google AI Mode und Gemini in den USA verfügbar. ChatGPT verlinkt dagegen auf den Checkout des Shops selbst. OpenAI hat ACP, Google hat UCP, Amazon hat eine geschlossene Plattform.
Wenn Sie schnell sehen möchten, wie Agenten die technischen Schnittstellen Ihrer Website lesen, gibt es außerdem ein kostenloser WebMCP-Shopping-Check.
Bewertung eines Chatbots auf Ihrer eigenen Website
Wenn Ihre eigentliche Aufgabe die erste Bedeutung ist, also ein Assistent im Auftritt Ihrer Marke in Ihrem Online-Shop, übernehmen Sie die Gewohnheiten der Benchmarks. Testen Sie Gespräche mit mehreren Dialogschritten statt einzelner Fragen. Prüfen Sie jedes vorgeschlagene Produkt und jede Variante gegen die Aussagen des Käufers und gegen verifizierte Produktdaten. Prüfen Sie, ob Anforderungen Folgefragen überstehen. Prüfen Sie, was passiert, wenn ein Artikel nicht auf Lager ist. Genau in solchen Fällen beginnen Assistenten zu halluzinieren.
Es gibt zahlreiche Beispiele für KI im Ecommerce, die zeigen, wo Assistenten auf der Website ihren Nutzen entfalten, und die oben genannten Bewertungskriterien zeigen Ihnen, ob das auch für Ihren Assistenten gilt.
Eine Warnung noch von mir. Ein hervorragender Assistent auf Ihrer Website hilft dem Käufer nicht, der Ihre Website nie besucht. Der externe Agent hat bereits entschieden. Deshalb kommt die Arbeit an den Daten zuerst und der Assistent erst danach. Sobald man es laut ausspricht, wirkt diese Reihenfolge offensichtlich, und trotzdem hält sich fast niemand daran.
So bleiben die Ergebnisse langfristig belastbar
Modelle ändern sich, Kataloge ändern sich, Wettbewerber ändern ihre Feeds. Ein Wert aus dem März sagt Ihnen im November nur wenig.
Betrachten Sie Evaluierung als Schleife. Führen Sie den Scan aus, lesen Sie die Verlustgründe, korrigieren Sie die Daten, veröffentlichen Sie die Änderungen und testen Sie erneut. Halten Sie die Käuferfragen zwischen den Durchläufen konstant, sonst vergleichen Sie unterschiedliche Prüfungen. Wenn Sie eine neue Produktlinie hinzufügen, ergänzen Sie auch deren Fragen.
Verfolgen Sie außerdem, was Sie tatsächlich beobachten können: Besuche von KI-Assistenten in Ihrer Analytics-Lösung und Bestellungen auf Ihrer Seite. In unserem ersten Pilotprojekt stiegen bei DUA Flavours die Besuche durch KI-Assistenten und der direkte Traffic von April bis Juli 2026 um 12 %. Das ist eine Besuchskennzahl und keine Umsatzkennzahl, und ich sage das lieber ausdrücklich, als etwas anderes zu suggerieren. Unsere Leitfäden zu der Messung von KI-Agenten-Traffic und Attribution-Tools behandeln die Messseite ausführlicher.
Perspektive: Warum wir den Shop testen und nicht das Modell
Bis Oktober 2026 haben wir 36.797 simulierte Käufe durchgeführt, und die wichtigste Erkenntnis daraus war, wo das eigentliche Problem liegt. Selten im Modell. Meist im Produkt-Feed, im Katalog und im Checkout, den der Agent nutzen muss.
Deshalb arbeitet ecentic direkt am Shop selbst. Wir verbinden uns mit Shopify, WooCommerce oder einem Produkt-Feed und lassen ChatGPT, Claude und Gemini jedes Produkt mit einem benannten Wettbewerber vergleichen. Wir zeigen in klarem Englisch, warum der Agent das andere Produkt auswählt. Wenn Sie auf Apply klicken, schreiben wir Titel, Beschreibung und strukturierte Daten um und veröffentlichen sie in Ihrem Shop.
Auf Shopify übertragen wir die Änderungen in das Google Merchant Center und verfolgen Besuche von KI-Assistenten. Auf WooCommerce ermöglicht das kostenlose ecentic-Plugin Agenten, über UCP zu suchen, einen Warenkorb zu füllen und den Kaufabschluss durchzuführen. Genau dieser Checkout-Teil fehlt bei einfachen Feed-Tools.
Ich halte es für riskant, darauf zu warten, dass Modelle besser werden. Das ist eine Wette, die ein Shop nicht kontrolliert. Die Modelle werden besser werden, und sie werden weiterhin Ihre Daten lesen. Besser also, Daten bereitzustellen, die lesenswert sind.
Xhurian Shaba
Den ersten Test mit Ihren eigenen Produkten durchführen
Der schnellste Weg zu Ihren eigenen Zahlen ist der kostenlose Scan. Er umfasst Ihre 10 wichtigsten Produkte, benötigt keine Kreditkarte und zeigt, wie ChatGPT, Claude und Gemini diese mit den Produkten eines benannten Wettbewerbers vergleichen und warum Sie dabei verlieren.

Danach stehen auf unserer Preisseite die Tarife Compete für $14.90 pro Monat für bis zu 100 Produkte, Scale für $44.90 pro Monat für bis zu 1.000 Produkte mit One-Click-Korrekturen und Dominate für $149 pro Monat zur Verfügung, inklusive Synchronisierung mit Google Merchant Center und Einrichtung von Agenten-Checkouts. Zusätzlich gibt es ein Pay-as-you-go-Modell mit 3 % der KI-attribuierten Bestellungen, gedeckelt auf $500 pro Monat. Wenn Sie zuerst die Produktangebots-Seite optimieren möchten, sehen Sie sich Optimierung von KI-Produktangebotenan. Außerdem haben wir Plattformseiten für Shopify und WooCommerce.
FAQ
Was ist LLM-Evaluierung im Ecommerce?
Darunter versteht man die Bewertung, wie gut ein Sprachmodell Shopping-Aufgaben wie Suche, Rückfragen, Empfehlungen und das Hinzufügen zum Warenkorb bewältigt. Gute Evaluierungen bewerten komplette Gespräche und prüfen Antworten gegen echte Produktdaten. Für Händler bedeutet es außerdem zu überprüfen, wie externe KI-Agenten mit ihren Produkten umgehen.
Woher weiß ich, ob KI-Assistenten meine Produkte empfehlen?
Stellen Sie realistische Käuferfragen mit Budgets und Einschränkungen über mehrere Modelle und mehrere Durchläufe hinweg. Zählen Sie, wie oft Ihr Produkt gegenüber dem eines benannten Wettbewerbers ausgewählt wird, und notieren Sie den Grund, wenn das nicht passiert. Eine einzelne Antwort eines einzelnen Chatbots ist eine Anekdote, eine wiederholte Testreihe ist eine Messung.
Welche Produktdaten benötigen KI-Agenten?
Mindestens eine stabile Kennung wie GTIN, MPN oder SKU, einen aktuellen Preis mit Währung als einzelne Zahl, einen Verfügbarkeitsstatus und klare Variantenoptionen. Spezifikationen sollten messbare Werte sein, keine Adjektive. Ohne diese Angaben kann ein Agent Ihr Produkt nicht vergleichen und schließt es meist aus.
Wie integriere ich KI-Daten in einen Ecommerce-Shop?
Beginnen Sie mit dem Produkt-Feed und den strukturierten Daten auf Ihren Produktseiten, denn genau das lesen Agenten. ecentic verbindet sich mit Shopify, WooCommerce oder einem Produkt-Feed, schreibt Titel, Beschreibungen und strukturierte Daten neu, wenn Sie auf Apply klicken, und veröffentlicht sie im Shop. Führen Sie anschließend den Test erneut aus, um zu sehen, was sich geändert hat.
Sagen Benchmark-Ergebnisse voraus, wie mein Shop abschneiden wird?
Nicht direkt. Benchmarks zeigen, wie sich Modelle allgemein bei Shopping-Aufgaben verhalten, und der Bestwert von 57,1 % bei EComAgentBench zeigt, dass noch viel Raum für Fehler bleibt. Ihr eigenes Ergebnis hängt von Ihrem Katalog und Ihren Wettbewerbern ab, deshalb sollten Sie genau diese testen.
Quellen
- Benchmarking Models for Conversational E-Commerce (Rezolve, RecSys 2026 Workshop)
- Algolia LLM Leaderboard: Methodik
- Evaluating Open-Weight E-Commerce Agents with Environment-Grounded Verification
- EComAgentBench: Benchmarking Shopping Agents (EMNLP 2026 Industry Track)
- DeepShop: A Benchmark for Deep Research Shopping Agents
- Measuring and Improving AI Performance in Conversational Shopping Assistants
- E Pluribus Unum: Guidelines on Multi-Objective Evaluation of Recommender Systems
- On Evaluating and Improving Conversational Agents in Production (Zalando)
- Product Feeds for AI Agents: What Machines Need to Compare
Diese Themen entdecken