

Generative Engine Optimization für den Ecommerce bedeutet, Ihre Produktangebote so zu strukturieren, dass KI-Einkaufsagenten wie ChatGPT, Gemini und Claude Ihre SKUs auswählen und empfehlen statt der eines Wettbewerbers. Der erste Schritt: Prüfen Sie, ob Ihre Product- und Offer-Daten (Preis, Verfügbarkeit, GTIN) serverseitig gerendert werden oder über einen sauberen Merchant Center Feed laufen. Wenn ein Agent diese Daten nicht in Millisekunden parsen kann, überspringt er Sie. Forschung aus dem E-GEO-Benchmark und Columbias ACES-Experimenten bestätigt, dass das nicht nur Theorie ist. Tools wie Ecentic gibt es, weil diese Lücke zwischen „für Menschen lesbar“ und „für Agenten lesbar“ inzwischen ein Umsatzproblem ist.
- Rufen Sie jetzt drei Ihrer meistverkauften PDPs auf und prüfen Sie, ob Preis und Lagerstatus im Roh-HTML erscheinen und nicht erst nach dem Laden per JavaScript gerendert werden.
Die wichtigsten Erkenntnisse
Generative Engine Optimization funktioniert dann, wenn Produktdaten auf Feldebene maschinenlesbar sind und am tatsächlichen Verhalten von Agenten getestet werden, statt als statische Marketingtexte stehen zu bleiben.
| Punkt | Details |
|---|---|
| GEO-Umfang im Ecommerce | Optimieren Sie Schema, Bewertungen, FAQs, Videotranskripte und Feeds, damit Agenten Ihre SKUs auswählen können. |
| Agenten gewichten Signale unterschiedlich | ACES zeigte, dass Abzeichen, Platzierung und Modellwahl (GPT-4.1, Claude Sonnet 4, Gemini 2.5 Flash) die Auswahl auf unterschiedliche Weise verschieben. |
| Überarbeitungen verschieben Rankings messbar | E-GEO zeigte, dass prompt-optimierte Überarbeitungen 15 heuristische Baselines über mehr als 7.000 Anfragen hinweg übertrafen. |
| Nach Marge und Lücke priorisieren | Beginnen Sie mit margenstarken SKUs, die derzeit eine schwache KI-Sichtbarkeit haben, nicht mit Ihren meistverkauften Produkten. |
| Ecentic beschleunigt Tests | Es simuliert das Verhalten von Agenten, diagnostiziert Schwachstellen und veröffentlicht Korrekturen mit einem Klick in Shopify und WooCommerce. |
Was bedeutet Generative Engine Optimization für Produktangebote?
Für Ecommerce-Teams ist GEO enger gefasst als die allgemeinere Empfehlung, „von KI zitiert zu werden“, die Sie anderswo finden. Es geht darum, einzelne Produktseiten und Feeds für KI-Einkaufsagenten lesbar zu machen, die SKUs in Echtzeit abrufen, vergleichen und empfehlen. Das schließt Content-Strategien für Blogs aus, die auf allgemeine Sichtbarkeit in der KI-Suche abzielen. Dazu gehören:
- Produktattribute und Schema: Name, Marke, GTIN, Preis, Verfügbarkeit, Materialien, Abmessungen.
- Bewertungen und Bewertungsschema: AggregateRating- und Review-Markup mit echtem, datiertem Feedback.
- FAQPage-Markup: strukturierte Frage-Antwort-Paare, die Kaufhürden aufgreifen.
- Videotranskripte und VideoObject-Schema: mit Zeitstempeln versehene Aussagen, die ein KI-Einkaufsagent zitieren kann.
- Vergleichstabellen: strukturierte Daten, mit denen ein Agent Ihr Produkt Alternativen gegenüberstellen kann.
- Produkt-Feeds: ein sauberer, aktueller Merchant Center-Feed mit passenden GTINs.
Die meisten Agenten arbeiten mit Retrieval-Augmented Generation und ziehen strukturierte Fragmente heran, statt ganze Seiten zu lesen. Eine Markengeschichte in drei Absätzen verliert jedes Mal gegen eine saubere Spezifikationstabelle.
Warum ist GEO gerade jetzt für KI-Einkaufsagenten wichtig?
Die Belege dafür sind nicht bloß spekulativ. Die ACES-Experimente der Columbia Business School setzten simulierte Storefronts mehreren KI-Modellen vor und verfolgten, was die Auswahl tatsächlich verändert hat. Die Position war wichtig. Badges waren wichtig. Und für welches Modell Sie optimieren, war wichtiger, als die meisten Händler annehmen: GPT-4.1, Claude Sonnet 4 und Gemini 2.5 Flash zeigten jeweils unterschiedliche Präferenzen bei Spalten und Platzierung, wenn sie ein Produkt zur Empfehlung auswählten.
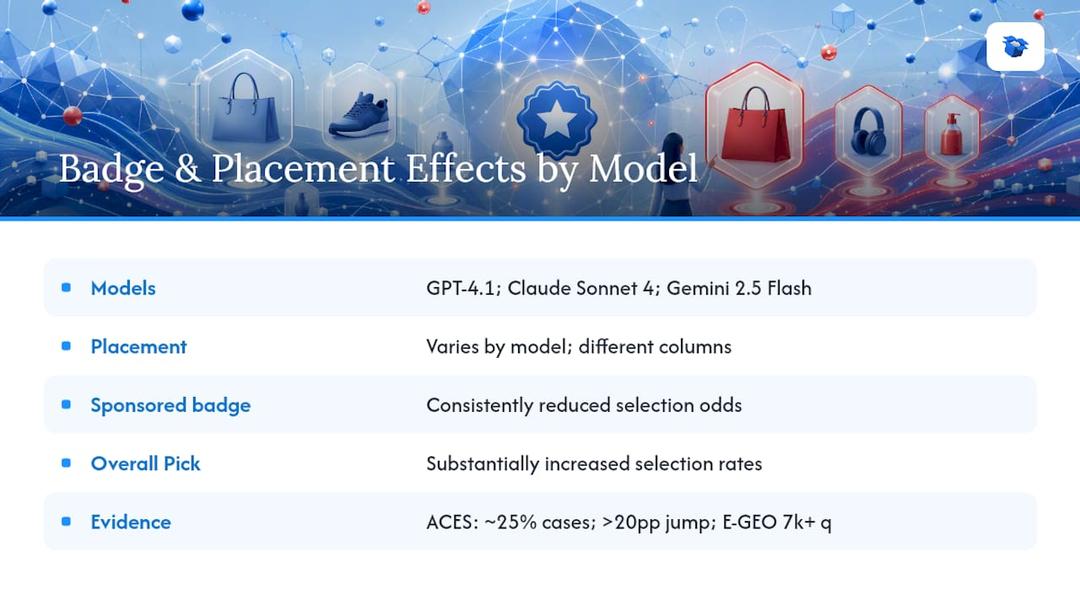
Badges wirken in beide Richtungen. Ein „Sponsored“-Tag verringerte durchgängig die Wahrscheinlichkeit, dass ein Produkt ausgewählt wurde, während ein „Overall Pick“-Hinweis die Auswahlquote deutlich erhöhte, bei konstantem Preis und Rating. Wenn Ihr Merchandising stark auf Labels für bezahlte Platzierungen setzt, arbeiten Sie mit KI-Einkaufsagenten, die „Sponsored“ eher als Warnsignal denn als Vertrauenssignal lesen, womöglich still gegen sich selbst.
Statistik: In ACES-ähnlichen Simulationen führten gezielte Überarbeitungen in rund einem Viertel der getesteten Fälle zu statistisch signifikanten Gewinnen beim Auswahlanteil, wobei mindestens eine Überarbeitung in einem einzelnen simulierten Vergleich einen Sprung des Marktanteils von mehr als 20 Prozentpunkten auslöste.
Separat testete der E-GEO-Benchmark das Umschreiben und die Meta-Optimierung von Prompts über mehr als 7.000 Suchanfragen und über 52.000 Produkte hinweg und stellte fest, dass optimierte Überarbeitungen bei der Rangänderung 15 heuristische Baselines übertrafen. Übersetzt heißt das: Das ist kein Rätselraten. Kleine, gezielte Änderungen am Text verschieben Rankings auf messbare und wiederholbare Weise.
Stellen Sie sich eine Küchenkleingeräte-Marke im Mittelfeld vor, die die Beschreibung ihrer wichtigsten SKU so überarbeitet hat, dass konkrete Anwendungsfälle im Vordergrund stehen (Kochen kleiner Portionen, spülmaschinengeeignete Teile) statt allgemeiner Marketingsprache.
Praxistipp: Beginnen Sie mit Ihrer Kategorie mit der höchsten Marge, nicht mit Ihrem Bestseller. Eine Überarbeitung, die den Auswahlanteil bei einem Artikel für $200 erhöht, amortisiert sich schneller als derselbe Aufwand bei einem Zubehörteil für $20.
Was sollte für GEO auf jeder Produktseite stehen?
Behandeln Sie dies als Umsetzungsplan, den Sie direkt an einen Entwickler oder die Content-Verantwortlichen weitergeben können.
Schema-Ebene:
- Vollständiges Product-Schema: Name, Marke, GTIN, SKU, Preis, Verfügbarkeit, Farbe, Material, Abmessungen.
- Offer-Schema: Preis, Währung, Zustand, Verkäufername, Versanddetails.
- AggregateRating- und Review-Schema: echte Anzahl an Bewertungen, Datumsangaben und verifizierte Texte.
- FAQPage-Schema: mindestens drei bis fünf Käuferfragen mit direkten Antworten.
- VideoObject-Schema: zusammen mit einem vollständigen Transkript und
hasPartmit Zeitstempeln versehenen Segmenten für zentrale Aussagen.
Rendering- und Feed-Ebene:
- Preis, Verfügbarkeit und zentrale Spezifikationen serverseitig rendern. Verstecken Sie sie nicht hinter clientseitigem JavaScript, das ein Agent-Crawler möglicherweise nicht ausführt.
- Halten Sie Ihren Merchant Center-Feed mindestens täglich synchron und achten Sie auf übereinstimmende GTINs auf Ihrer Website und im Feed.
- Prüfen Sie, ob User-Agents von Agent-Crawlern 200-Antworten erhalten und nicht blockiert werden. Prüfen Sie Ihre
robots.txtsowie allellms.txt-Datei auf versehentliche Ausschlüsse.
Validierungsrhythmus: Prüfen Sie Ihre umsatzstärksten SKUs wöchentlich mit dem Rich Results Test von Google und einem Validator für strukturierte Daten, nicht nur beim Start. Auch Änderungen am Shop-Theme, die nichts mit strukturierten Daten zu tun haben, können diese unbemerkt beschädigen. Ein defekter Markup-Block fällt Käufern nicht auf, ist für die Sichtbarkeit bei Agenten aber fatal.
Praxistipp: Wenn Sie um Bewertungen bitten, stellen Sie Kundinnen und Kunden eine konkrete Frage („Welches Problem hat dieses Produkt für Sie gelöst?“) statt nur nach Sternen zu fragen. Spezifische, datierte und belegte Bewertungen gehören zu den stärksten Signalen, die Agenten gewichten wenn sie zwischen ähnlichen Produkten wählen.
Ein häufiger Fehler: Teams ergänzen Product-Markup und belassen es dabei. FAQPage und VideoObject bleiben leer, weil sie optional erscheinen. Das sind sie nicht. Finden Agenten weder eine Vergleichstabelle noch einen Transkriptabschnitt, der die Frage nach der Kompatibilität mit X beantwortet, zitieren sie einen Wettbewerber, der darauf eingegangen ist. Eine vollständige Übersicht über alle Felder bietet die von ecentic veröffentlichte Checkliste für strukturierte Daten – dort wird das minimal erforderliche Schema für jeden Typ erklärt.
Wie rollen Sie GEO im gesamten Katalog aus?
Wer das ohne Plan katalogweit ausrollt, verbrennt schnell ein Quartal und sieht keine Ergebnisse. Arbeiten Sie in dieser Reihenfolge:
- Führen Sie ein einstündiges Audit durch. Wählen Sie fünf Top-SKUs aus und prüfen Sie die Vollständigkeit des Schemas, die Feed-Genauigkeit und das Seiten-Rendering.
- Nach Marge und Sichtbarkeitslücke priorisieren. Kategorien mit hoher Marge und schwacher aktueller KI-Sichtbarkeit kommen zuerst dran, nicht Ihre bereits dominierenden Bestseller.
- Ein Testset aufbauen. Stellen Sie ein Kontroll-Produktangebot einer überarbeiteten Variante für Titel, Beschreibung und FAQ-Inhalte gegenüber.
- Vor dem Livegang simulieren. Führen Sie, wo möglich, promptbasierte Simulationen ähnlich dem E-GEO-Ansatz durch, um Rangverschiebungen abzuschätzen, bevor Sie Produkttexte in der Live-Umgebung ändern.
- Kontrollierte Live-A/B-Tests durchführen. Messen Sie Auswahlanteil und Rangänderung über ein definiertes Zeitfenster, nicht nur an einem einzelnen Tag.
- Gewinner ausrollen, Verlierer einstellen. Führen Sie ein Änderungsprotokoll, damit Sie wissen, welche Überarbeitung welche Verbesserung ausgelöst hat.
Sinnvolle Priorisierungskriterien, die Sie gewichten sollten: Gewinnmarge pro Einheit, vorhandene Bewertungstiefe, Feed-Bereitschaft und wie weit eine SKU aktuell von der Spitze der Vergleichsergebnisse entfernt ist.
Die Teamstruktur ist genauso wichtig wie die Checkliste:
- Produktverantwortliche legt Roadmap und Priorisierung fest.
- Entwickler verantwortet die Schema-Implementierung und die Feed-Hygiene.
- Texterstellung erstellt Vorlagen für Überarbeitungen und FAQ-Texte.
- Analyst verfolgt Auswahlanteil, Rangänderungen und von Agenten vermittelten Umsatz.
Ein zweiwöchentlicher Sprint-Rhythmus funktioniert für die meisten mittelgroßen Kataloge, mit einem vollständigen erneuten Scan pro Monat. Genau hier sparen spezialisierte Plattformen echte Zeit. Ecentic führt simulationsgestützte Diagnosen für Agenten im Stil von ChatGPT, Gemini und Claude durch und veröffentlicht Korrekturen dann mit einem Klick direkt in Shopify oder WooCommerce. So verkürzt sich ein Zyklus, der sonst mehrere Engineering-Sprints braucht, auf wenige Stunden.
Woran messen Sie, ob GEO funktioniert?
Verfolgen Sie ein klar definiertes Kennzahlenset statt vager Eindrücke von „KI-Sichtbarkeit“:
- Besuche über Agenten-Referrer: Sitzungen über bekannte Agent-Referrer oder mit UTM-Tags versehene Agent-Links.
- Auswahlanteil und Veränderung der Durchschnittsposition: wie oft und an welcher Position Ihr Produkt über einen fest definierten Suchanfragesatz erscheint – nach der Kennzahl zur Positionsveränderung, die E-GEO als zentralen Bewertungsmaßstab verwendet.
- CTR aus Agent-Weiterleitungen: Klickrate auf Produktdarstellungen, die Agenten anzeigen.
- Conversion-Rate bei Traffic aus Agent-Weiterleitungen: ob von Agenten erzeugter Traffic tatsächlich kauft.
- Umsatz pro Besuch, nach Agentenquelle segmentiert, sofern Ihre Analytics das zulassen.
Statistischer Hinweis: Die Auswertung von E-GEO ergab, dass die Meta-Optimierung von Prompts über den gesamten Datensatz von mehr als 7.000 Suchanfragen hinweg konsistente Ranking-Verbesserungen gegenüber statischen heuristischen Überarbeitungen lieferte – nicht nur vereinzelte Erfolge.
Für das Testprotokoll gilt: Führen Sie, wenn möglich, zuerst Simulationsexperimente durch und bestätigen Sie die Ergebnisse dann mit live laufenden randomisierten A/B-Tests für Änderungen an Produktbeschreibung und Titel. Verwenden Sie Kontrollgruppen auf Katalogebene, damit eine plattformweite Algorithmusänderung nicht fälschlich als Effekt Ihrer Überarbeitung gewertet wird. Geben Sie jedem Test mindestens zwei bis drei Wochen, bevor Sie Schlüsse ziehen. Das Verhalten von Agenten schwankt von Tag zu Tag stärker als bei klassischer Web-SEO, und ein Ausschlag an einem einzelnen Tag hält selten an. Für die Attribution sollten Sie Merchant Center-Feed-Logs mit dem Referrer-Tracking auf Ihrer Website kombinieren, da das Produktranking in der Suche von ChatGPT auf einer Mischung aus strukturierten Feed-Daten und aktuellen Seiteninhalten beruht. Veraltete Feed-Snapshots können deshalb zu falschen Schlussfolgerungen darüber führen, was die Auswahl tatsächlich beeinflusst. Der von ecentic veröffentlichte Leitfaden zum Tracking von Agenten-Traffic erklärt das Tagging-Setup ausführlicher.
Was lernen Sie, wenn Sie GEO über mehrere Zyklen laufen lassen?
Modellpräferenzen sind nicht fest. Vergleiche von GPT-4.1 mit späteren Modellgenerationen in der ACES-Forschung zeigten, dass sich die Positionsgewichtung zwischen Versionen vollständig umkehren konnte. Eine Überarbeitung, die für einen Agenten optimiert wurde, kann beim nächsten Modell-Update wirkungslos werden oder sogar nach hinten losgehen. Den Eigenheiten eines einzelnen Agenten hinterherzulaufen, ist langfristig eine erfolglose Strategie.
Die wichtigere Erkenntnis: Kleine Änderungen beeinflussen die Ergebnisse stärker als erwartet – in beide Richtungen. Versionskontrollieren Sie Ihre Texte für Produktangebote so wie Code, prüfen Sie jede Überarbeitung vor der Veröffentlichung in einem Test und scannen Sie mindestens monatlich neu. Verstecken Sie wichtige Fakten nicht in Produktbildern, die Agenten nicht auslesen können, und verlassen Sie sich nicht auf Badges, die wie bezahlte Werbung wirken. Bestätigte, konkrete Bewertungen schneiden durchgängig besser ab als reine Hochglanzdarstellung.
Wie Ecentic Ihnen hilft, dieses Playbook umzusetzen
ecentic ist dafür gebaut, genau den Workflow aus diesem Artikel auszuführen – ohne den Engineering-Aufwand über mehrere Sprints. Es simuliert, wie Agenten im Stil von ChatGPT, Gemini und Claude Ihre Produktseiten bewerten, markiert die konkreten Lücken bei Schema, Feed und Inhalt, wegen denen Agenten Sie überspringen, und überarbeitet Produktangebote mit einer klaren Begründung, warum sie gewinnen oder verlieren.

Sobald Sie eine Korrektur freigeben, veröffentlicht ecentic sie direkt in Shopify oder WooCommerce und scannt danach weiter, damit Sie erkennen, wenn ein Modell-Update verändert, was Agenten belohnen. Kunden, die die Plattform nutzen, berichteten nach der Umsetzung ihrer Empfehlungen von messbaren Zuwächsen sowohl bei KI-getriebenen Website-Besuchen als auch bei nachgelagerten Verkäufen. Die vollständige Funktionsweise sehen Sie auf der Seite So funktioniert es, einschließlich der Frage, wie die Simulations-Engine die Art von Tests nachbildet, die hinter ACES und E-GEO stehen.
Führen Sie heute einen kostenlosen Scan Ihrer Produktangebote durch, um genau zu sehen, wie Ihre wichtigsten SKUs bei KI-Einkaufsagenten abschneiden und was nötig wäre, um sie zu verbessern.
Quellen
- What Happens When AI Does Your Shopping? | Columbia Business School
- How ChatGPT search ranks products and merchants | Search Engine Land
Versuchen Sie, einen einfachen Prompt-Test im Stil von E-GEO auf einer Produktseite nachzustellen, oder nutzen Sie den kostenlosen Scan von ecentic, um eine Diagnose ohne Einrichtungsaufwand zu erhalten.
FAQ
Was ist Generative Engine Optimization für den E-Commerce?
Damit ist die Praxis gemeint, Produktangebote, Schema und Feeds so zu strukturieren, dass KI-Einkaufsagenten wie ChatGPT und Gemini Ihre SKUs extrahieren, bewerten und empfehlen können.
Wie unterscheidet sich GEO von klassischer SEO?
Klassische SEO zielt auf das Ranking von Webseiten in Suchmaschinen ab; GEO im E-Commerce zielt darauf, ob ein KI-Agent Ihr konkretes Produkt aus einer engeren Auswahl von Optionen auswählt.
Welche Schema-Typen sind für KI-Einkaufsagenten am wichtigsten?
Laut GEO-Empfehlungen für den E-Commerce liefern Product-, Offer-, AggregateRating-, Review-, FAQPage- und VideoObject-Schemata jeweils die Fakten auf Feldebene, auf die Agenten angewiesen sind.
Kann eine einzelne Überarbeitung die Auswahlraten durch KI wirklich verändern?
Ja. In Simulationen im ACES-Stil führten gezielte Überarbeitungen in rund einem Viertel der getesteten Fälle zu deutlichen Zugewinnen beim Auswahlanteil, in einem Fall sogar zu einer Verschiebung des Marktanteils um mehr als 20 Punkte.
Wie oft sollten wir Produktangebote für GEO erneut prüfen?
Sie sollten mindestens monatlich erneut scannen, da sich das Verhalten der Agenten je nach Modellversion verändert. Die kontinuierlichen Rescans von ecentic automatisieren das, sodass Lücken ohne manuelle erneute Prüfungen erkannt werden.
Diese Themen entdecken