

Gemini und Perplexity finden Produkte über nahezu vollständig unterschiedliche Pipelines. Gemini stützt sich auf Ihren Produkt-Feed, Merchant Center und das entstehende Universal Commerce Protocol (UCP); Perplexity stützt sich auf crawlbare Seiten und darauf, wie oft andere Websites Sie zitieren. Beide prüfen dennoch dieselben Kernsignale: vollständiges Schema, übereinstimmende Preise und Bestände sowie echte Bewertungen. Wenn Sie zuerst nur eine Sache beheben, dann beheben Sie serverseitig gerendertes Product JSON-LD mit Feed-Parität für Ihre meistverkauften SKUs.
Kurz gesagt:
- Priorisieren Sie serverseitig gerendertes Product JSON-LD mit vollständigem Schema, übereinstimmenden Preisen und täglichen Feed-Updates, um die Sichtbarkeit in Gemini und Perplexity sicherzustellen.
- Beheben Sie Bestands- und Preisabweichungen, besonders bei umsatzstarken SKUs, damit Produkte aufgrund solcher Vertrauenssignale nicht aus den Ergebnissen von KI-Einkaufsagenten verschwinden.
- Vermeiden Sie clientseitige Schema-Injektion und strikte Bot-Blocking-Maßnahmen, die Ihre Produkte stillschweigend von der Indexierung durch KI-Agenten ausschließen können.
- Nutzen Sie Simulationstools, um Schema-Lücken zu erkennen und Korrekturen zuerst an besonders wichtigen Produkten zu testen, bevor Sie Updates im gesamten Katalog ausrollen.
- Verfolgen Sie regelmäßig operative Kennzahlen wie Attribut-Vollständigkeit und Bestandsabweichungen, um die Sichtbarkeit bei KI-Agenten langfristig zu erhalten und zu verbessern.
Wie Gemini und Perplexity Produkte finden (und warum das alles verändert)
Die Shopping-Ergebnisse von Gemini stammen aus einer Datenpipeline und nicht von einer Seite, die es gerade zufällig crawlt. Es bezieht Daten aus Ihrem Merchant Center-Feed, gleicht sie mit dem Shopping Graph von Google ab und fragt zunehmend UCP-Endpunkte direkt ab, wenn ein Shop sie unterstützt. Fehlen Ihrem Feed GTINs, enthält er veraltete Preise oder wird er wegen abgelehnter Einträge markiert, zeigt Gemini das Produkt schlicht nicht an – unabhängig davon, wie gut Ihre Produktseite aussieht.
Perplexity funktioniert eher wie ein Recherche-Assistent als wie eine Shopping-Engine. Es führt Live-Websuchen aus, liest Ihr tatsächliches HTML, verarbeitet die strukturierten Daten auf der Seite und bewertet, wie häufig unabhängige Websites, Reviews und Foren Ihr Produkt erwähnen. Perplexity bevorzugt Live-Websuche und Zitate von Dritten, was bedeutet, dass ein Produkt ohne Presseerwähnungen und mit dünnen strukturierten Daten auf der Seite gegen einen Wettbewerber mit schlechterem Preis, aber besserer redaktioneller Abdeckung verlieren kann.
Beide Agenten stützen sich letztlich auf strukturierte Daten, statt eine Seite so zu lesen, wie es ein Käufer tun würde. Agenten fragen strukturierte Feeds, Produktschema und indexierte Katalogdaten ab und gleichen diese Daten mit den Vorgaben ab, die der Käufer genannt hat, etwa „unter $50“ oder „Lieferung bis Freitag“. Der Unterschied liegt hier:
- Gemini belohnt vollständige Feeds, saubere Merchant Center-Daten und Unterstützung für das UCP-Protokoll.
- Perplexity belohnt crawlbares HTML, Seitenschema und Zitate von Dritten.
- Beide prüfen das Product-Schema, die Offer-Daten, den Verfügbarkeitsstatus und die zusammengefassten Bewertungswerte.
- Gemini ist näher an einer Datenbankabfrage; Perplexity ähnelt eher einer Recherche in Echtzeit.
Für die Priorisierung ist vor allem das wichtig: Diese Agenten überschneiden sich bei ihren tatsächlichen Anforderungen zu etwa 80 %. Saubere strukturierte Daten, präzise Feeds und echte Reviews helfen beiden.
Die Prioritäten-Checkliste: strukturierte Daten, Feeds, Bestand und Reviews
Arbeiten Sie diese Punkte in dieser Reihenfolge durch. Jeder Schritt ermöglicht den nächsten, und wenn Sie etwas überspringen, machen Sie die Arbeit später nur noch einmal.
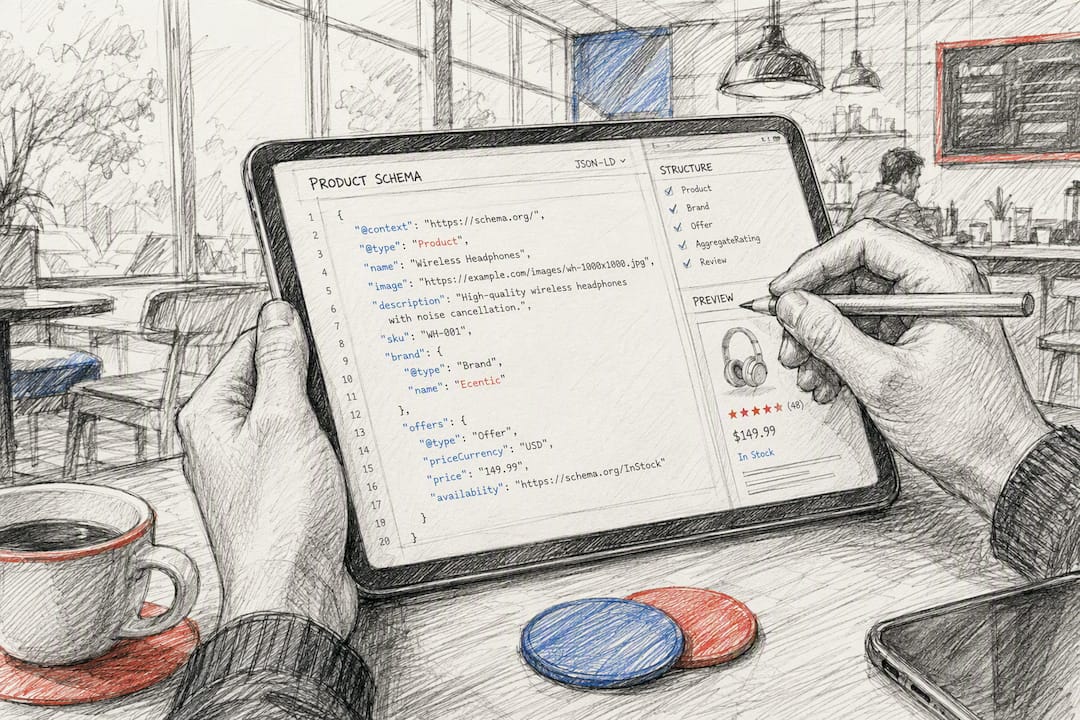
- Stellen Sie serverseitig gerendertes Product-JSON-LD bereit. Jede Top-SKU braucht
name,description,sku,brand,offers,aggregateRating,image, und entwederGTINoderMPNin der rohen HTML-Antwort vorhanden sein, nicht erst nach dem Laden der Seite injiziert werden. Ein vollständiges serverseitig gerendertes Product-Schema ist für eine zuverlässige Verarbeitung durch Agenten erforderlich, und ein fehlendes Feld reicht oft schon aus, damit ein Produkt gar nicht erst berücksichtigt wird. - Gleichen Sie den Preis überall ab. Ihr Feed, Ihre Produktseite und Ihr Kaufabschluss müssen denselben Betrag zeigen. Agenten vergleichen Preise in Feed, Produktseite und Kaufabschluss, und eine Abweichung gilt als Vertrauensbruch, nicht als Rundungsfehler.
- Aktualisieren Sie Ihren Feed mindestens täglich. Kategorien mit hoher Dynamik, Bekleidungsgrößen, limitierte Drops und Flash Sales brauchen Updates, die näher an Echtzeit liegen. Eine tägliche Aktualisierung ist das Minimum, nicht das Ziel.
- Machen Sie die Live-Verfügbarkeit sichtbar. Füllen Sie das
Availability-Schema korrekt aus, und wenn Sie einen Katalog-API-Endpunkt bereitstellen können, tun Sie es. Händler, die einen UCP-kompatiblen Endpunkt bereitstellen, gewinnen früh einen Vorteil bei der Auffindbarkeit, einfach weil sich bisher weniger Wettbewerber darum gekümmert haben. - Vereinheitlichen Sie die Taxonomie und füllen Sie Kategorieattribute aus. Größe, Material, Farbe, Passform – was auch immer Ihre Kategorie verlangt – muss vorhanden und konsistent sein, nicht verstreut in Freitextbeschreibungen.
- Veröffentlichen Sie
MerchantReturnPolicyundShippingDeliveryTime-Schema. Diese beiden werden ständig ausgelassen, und Agenten nutzen sie, um genau die Fragen zu beantworten, die Käufer stellen: „Kann ich das zurückgeben?“ und „Kommt es bis Freitag an?“
Starten Sie diesen gesamten Prozess mit Ihren umsatzstärksten Produkten, nicht mit dem gesamten Katalog. Wenn Sie zuerst die Top-20 % der SKUs nach Umsatz prüfen, sehen Sie schneller sichtbare Ergebnisse und erhalten eine Vorlage, die Sie auf den Rest des Katalogs automatisieren können.
Praxistipp: Die Qualität strukturierter Daten schlägt hier jedes visuelle Redesign. Eine optisch veraltete Produktseite mit fehlerfreiem Schema wird häufiger empfohlen als eine schön gestaltete Seite mit schlampigem Markup, weil Agenten die Datenebene bewerten, nicht Ihre Farbpalette.
Shopify vs. WooCommerce: Umsetzungsschritte und typische Fallen
Die Checkliste oben ist plattformunabhängig. Die Umsetzung ist es nicht.
Bei Shopifysollten Sie prüfen, ob Ihr Plan neue agentische Storefront-Funktionen unterstützt, und dann bestätigen, dass Ihr Theme JSON-LD serverseitig rendert, statt es über eine App erst nach dem Laden der Seite clientseitig einzufügen. Synchronisieren Sie Ihren Produktfeed direkt über das Shopify-Admin mit dem Merchant Center statt über einen Drittanbieter-Export, der nach seinem eigenen Zeitplan läuft. Prüfen Sie außerdem Ihre CDN- und Firewall-Regeln; manche Bot-Schutz-Einstellungen blockieren Agent-Crawler standardmäßig, wodurch Sie stillschweigend aus den Ergebnissen von Perplexity verschwinden, ohne jede Fehlermeldung.
Bei WooCommerce, sollten Sie ein serverseitiges PHP-Schema-Plugin oder eine direkte Einbindung ins Template bevorzugen statt Lösungen, die ausschließlich auf Google Tag Manager setzen. Richten Sie eine Feed-Automatisierung ein, der Sie wirklich vertrauen können – manuelle CSV-Exporte veralten schnell, und genau solche Abweichungen zerstören die Feed-Parität. Wenn Ihre Kataloggröße es zulässt, stellen Sie einen Catalog-API-Endpunkt bereit, damit Agenten, die UCP direkt abfragen, auf Ihren Bestand zugreifen können, ohne auf den nächsten Feed-Aktualisierungszyklus warten zu müssen.
Auf beiden Plattformen treten immer wieder dieselben drei Fehler auf:
- Ausschließlich clientseitige Schema-Einbindung. Tags, die erst nach dem initialen Laden der Seite ausgelöst werden, bleiben für Agent-Crawler oft vollständig unsichtbar, da viele JavaScript nicht wie ein Browser ausführen.
- Feed-Verzögerungen führen zu Bestandsabweichungen. Ein Feed, der nur alle 48 Stunden aktualisiert wird, zeigt regelmäßig Produkte als verfügbar an, die bereits ausverkauft sind.
- Übermäßig aggressive Bot-Challenge-Ebenen. CAPTCHA-Sperren und strikte
robots.txt-Regeln, die Scraper stoppen sollen, blockieren häufig genau die Agenten, von denen Sie empfohlen werden möchten.
Ein kostenloser JSON-LD-Schema-Generator ist ein schneller Weg, um zu prüfen, ob Ihre Markup-Struktur korrekt ist, bevor Sie Entwicklungszeit in einen vollständigen Rollout investieren. Führen Sie außerdem Ihre eigene Checkliste für strukturierte Daten an einer Stichprobe von Seiten aus, bevor Sie davon ausgehen, dass die Fehlerbehebung funktioniert hat.
Agentensichtbarkeit testen und messen
Schema und Feeds zu korrigieren ist nur die halbe Arbeit. Sie brauchen einen Nachweis, dass es funktioniert hat, und einen wiederholbaren Weg, Regressionen zu erkennen, bevor sie Traffic kosten.
- Führen Sie zuerst Simulationen aus. Testen Sie Ihre priorisierten SKUs in einem Tool wie dem UCP Playground und dokumentieren Sie, ob der Agent für jede Anfrage korrekte Preis-, Verfügbarkeits- und Zitierungsdaten zurückgibt.
- Führen Sie manuelle Abfragen als Plausibilitätsprüfung aus. Wählen Sie 10 bis 15 besonders wichtige SKUs aus, fragen Sie Gemini und Perplexity direkt danach und vergleichen Sie die Antworten mit Ihrer Live-PDP und Ihrem Feed.
- Segmentieren Sie Ihre Analytics nach Agentenquelle. Erstellen Sie GA4-Segmente für bekannte Referrer wie perplexity.ai, chatgpt.com und copilot.microsoft.com (häufig verwendete Referral-Quellen von Agenten) und verwenden Sie UTM-Tagging für alle Referral-Daten auf Protokollebene, die Sie erfassen können.
- Verfolgen Sie die operativen Zustandsmetriken wöchentlich, nicht nur die Conversion-Zahlen.
| Metrik | Was sie aussagt |
|---|---|
| Feed-Ablehnungsrate | Wie viele Produkte für Gemini aktuell unsichtbar sind |
| Vollständigkeit der Attribute % | Wie nah Ihr Katalog an einer vollständigen Schema-Abdeckung ist |
| Bestandsabweichungen pro Woche | Ob Ihr Aktualisierungsrhythmus tatsächlich funktioniert |
| Add-to-Cart-Rate über Agenten-Referrals | Ob Sichtbarkeit tatsächlich zu Conversions führt und nicht nur zu Besuchen |
AI-Shopping-Traffic korrekt zu verfolgen macht daraus statt einer einmaligen Fehlerbehebung ein dauerhaftes Programm, das Sie auch in Budgetgesprächen vertreten können.
Warum Simulation besser ist als Rätselraten
Die meisten Händler merken erst auf die harte Tour, dass ihre Produkte für KI-Agenten unsichtbar sind – indem sie fehlenden Traffic bemerken, statt die eigentliche Ursache zu erkennen. ecentic hält das für den falschen Ansatz. Sie sollten wissen, welches Schema-Feld, welches Feed-Attribut oder welche Paritätslücke den Ausschluss verursacht, bevor Sie Entwicklungsstunden in Vermutungen investieren.
Simulationsgestützte Tests machen den genauen Fehlerpunkt sichtbar. Wenn Sie eine Anfrage zu einem Produkt in einer kontrollierten Umgebung ausführen, sehen Sie exakt das, was ein Agent sieht – nicht das, was Sie vermuten. Dieser Unterschied entscheidet darüber, ob Sie diese Woche die richtigen fünf Felder Ihrer 20 umsatzstärksten SKUs korrigieren oder erst im nächsten Quartal ein umfassendes Schema-Update ausrollen und hoffen, dass es funktioniert. Kunden, die diesen Ansatz nutzen, berichten von messbaren Zuwächsen bei KI-gesteuerten Besuchen und Verkäufen, sobald die konkret durch Simulation identifizierten Probleme behoben werden.
Die funktionierende operative Reihenfolge lautet: Führen Sie eine gezielte Simulation für Ihre umsatzstärksten SKUs aus, prüfen Sie, ob die Korrekturen die Antwort des Agenten tatsächlich verändern, und automatisieren Sie dann dasselbe Korrekturmuster für den restlichen Katalog. Wer den Validierungsschritt überspringt, baut häufig dasselbe Schema zweimal neu.
— Xhurian
Von Gemini und Perplexity empfohlen werden – ohne Rätselraten
Manuelle Abfragen für jede SKU skalieren nicht, und allgemeine SEO-Ratschläge zeigen Ihnen nicht, welches konkrete Feld Sie eine Empfehlung kostet. ecentic führt simulierte Agentenanfragen mit Ihren tatsächlichen Produktseiten aus und liefert Ihnen anschließend eine verständliche Liste der Probleme: ein fehlendes aggregateRating, ein Feed-Preis, der nicht mit Ihrer PDP übereinstimmt, ein Schema-Feld, das ein Agent stillschweigend ignoriert.

Die Plattform verbindet sich direkt mit Shopify oder WooCommerce, scannt Ihre Produktangebote und erstellt Korrekturen, die Sie mit einem Klick veröffentlichen können, statt sie durch einen Engineering-Backlog zu schleusen. Außerdem erhalten Sie direkten Zugriff auf den UCP Playground, um zu testen, wie Gemini und Perplexity tatsächlich auf Ihre wichtigsten SKUs reagieren – vor und nach Änderungen. So messen Sie echtes Agentenverhalten, statt nur anzunehmen, dass Ihre Korrekturen funktioniert haben.
Beginnen Sie mit dem kostenlosen Scan, identifizieren Sie Ihre Korrekturen mit der größten Wirkung und testen Sie sie mit Live-Agentenanfragen, bevor Sie einen vollständigen Katalog-Rollout starten.
Quellen
- Für AI-Shopping-Agenten optimieren: So machen Sie Ihre Produkte für KI-Assistenten sichtbar
- AI-Shopping-Agenten im Vergleich: ChatGPT, Gemini, Perplexity, Copilot, Claude und Rufus (2026)
- Handel mit KI-Agenten: Ein Praxisleitfaden, um Ihre Produkte für AI-Shopping-Agenten sichtbar, kaufbar und empfehlenswert zu machen - YesTupa
FAQ
Ist Perplexity besser als Gemini für Produktempfehlungen?
Keines der beiden Systeme ist grundsätzlich besser. Gemini funktioniert am besten mit sauberen Feed- und Merchant-Center-Daten, während Perplexity gut strukturierte Seiten mit Zitierungen von Drittanbietern bevorzugt. Welche Lösung besser passt, hängt also davon ab, welches Signal Ihr Shop derzeit besser verarbeitet.
Was ist der Unterschied zwischen ChatGPT und Gemini beim Shopping?
ChatGPT und Gemini basieren beide auf strukturierten Katalogdaten. Die Shopping-Ergebnisse von Gemini sind jedoch stärker mit dem Merchant-Center-Feed und dem Shopping Graph von Google verknüpft, während ChatGPT sich stärker auf allgemeines Web-Crawling und Zitierungen stützt – ähnlich wie Perplexity.
Brauche ich eine separate Optimierung für Gemini und Perplexity?
Meistens nein. Beide Agenten teilen rund 80 % derselben grundlegenden Anforderungen – saubere Schemas, korrekte Feeds und echte Bewertungen –, sodass deren Optimierung den Großteil der Arbeit für beide abdeckt.
Wie oft sollte ich meinen Produktfeed aktualisieren?
Tägliche Aktualisierungen sind das Minimum für stabile Kataloge. Bei schnell wechselnden Beständen wie Bekleidung oder limitierten Drops sind Aktualisierungen nahe Echtzeit nötig, damit Agenten ausverkaufte Produkte nicht weiterhin als verfügbar ausweisen.
Kann ich testen, wie Gemini und Perplexity meine Produkte sehen, bevor ich Änderungen veröffentliche?
Ja. Wenn Sie Ihre priorisierten SKUs durch ein Simulationstool wie den UCP Playground laufen lassen, sehen Sie genau, wie ein Agent Ihre aktuellen Schema- und Feed-Daten interpretiert, bevor Sie einen vollständigen Rollout starten.
Diese Themen entdecken