

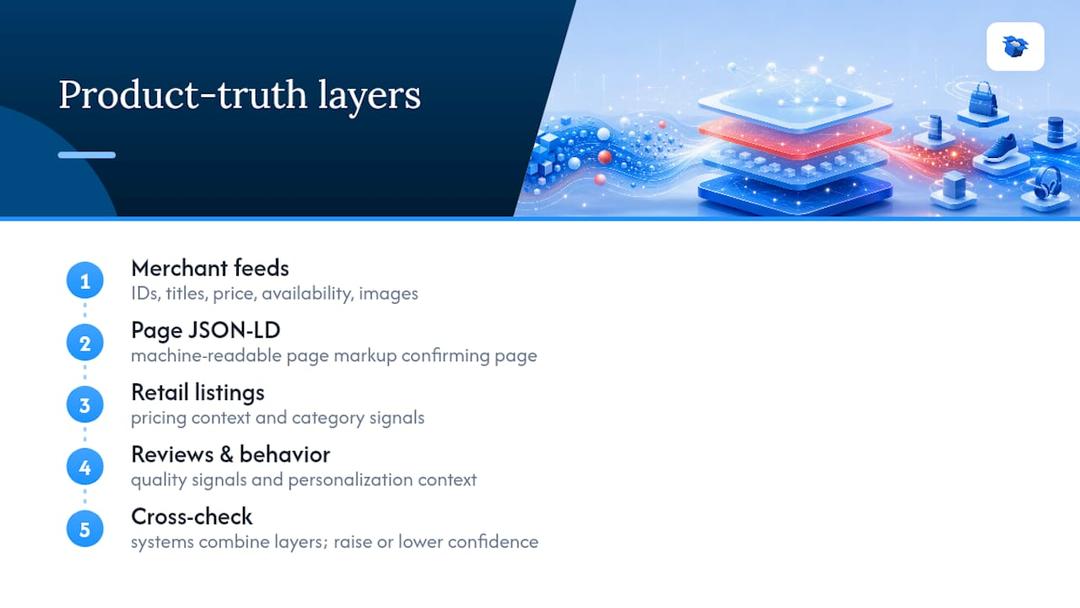
Die KI-Systeme, die heute Produkte empfehlen, greifen auf vier Ebenen zurück: Händler-Feeds und -APIs, strukturierte Daten auf Produktseiten, Produktangebote von Händlern und auf Marktplätzen sowie Bewertungen plus Verhaltensdaten aus First-Party-Quellen. Händler sollten sofort drei Dinge priorisieren: einen kanonischen Katalog mit stabilen IDs, eng synchronisierte Preise und Verfügbarkeit sowie klare Produktbeschreibungen mit vielen Attributen. Danach bestätigt promptbasiertes Testen, ob diese Korrekturen tatsächlich ändern, was ein KI-Agent empfiehlt.
Kurzfassung:
- Händler-Feeds müssen stabile IDs, synchronisierte Preise und aussagekräftige Produktattribute enthalten, um Inkonsistenzen bei Empfehlungen zu vermeiden und das Vertrauen von KI-Systemen zu verbessern.
- Die Auszeichnung mit strukturierten Daten sollte serverseitig gerendert, aktuell und mit dem sichtbaren Seiteninhalt übereinstimmend sein, damit KI-Systeme sie korrekt verstehen.
- Regelmäßige Tests mit Shopping-Prompts und echten KI-Simulationen helfen dabei zu erkennen, an welchen Stellen Produktdaten oder Beschreibungen zu Fehlschlägen bei Empfehlungen führen.
- Eine zentrale verlässliche Datenquelle sowie jederzeit übereinstimmende Feed-, Seiten- und Checkout-Daten minimieren Einbrüche bei Empfehlungen durch veraltete oder widersprüchliche Informationen.
- Verhaltensdaten aus First-Party-Quellen und Bewertungssignale unterstützen die Personalisierung, können aber grundlegende Produktfakten wie Lagerstatus oder Preis nicht übersteuern; dafür sind verlässliche Feed-Daten erforderlich.
Überblick: Die Ebenen der Produktwahrheit, die KI-Einkaufsagenten verarbeiten
Ein KI-Einkaufsagent sieht Ihren Shop nie so wie ein Käufer. Er sieht ein Patchwork aus Datensätzen und muss entscheiden, welchen er vertrauen kann. Jede Ebene liefert einen anderen Ausschnitt der Wahrheit.
Merchant-Feeds und APIs bilden das Rückgrat der Daten: stabile Kennungen, Titel, Beschreibungen, Preis, Währung, Verfügbarkeit, Varianten, Bilder und Händlerinformationen. Das ist die Ebene, die OpenAI-Commerce-Spezifikation als primäre Quelle für Produktdaten innerhalb von ChatGPT behandelt.
Strukturierte Daten auf Produktseiten (JSON-LD-Markup) geben Crawlern eine maschinenlesbare Version dessen, was bereits auf der Seite sichtbar ist, und dienen als zweite Bestätigung der Angaben im Feed.
Produktangebote von Händlern und Marktplätzen liefern Preis-Kontext und Kategoriesignale, insbesondere wenn ein Produkt über mehrere Kanäle hinweg erscheint.
Bewertungen und First-Party-Verhaltensdaten vervollständigen das Bild mit Qualitätssignalen und Personalisierungskontext, ersetzen aber niemals harte Fakten wie den Lagerstatus.
Die Systeme, die Produkte empfehlen, kombinieren alle vier Ebenen und gleichen sie miteinander ab. Wenn Ihr Feed „auf Lager“ meldet und das Markup Ihrer Seite „nicht auf Lager“, verwirrt dieser Widerspruch nicht nur den Algorithmus. Er senkt das Vertrauen in Ihren gesamten Datensatz, laut der Produktdatenspezifikation von Google.
Best Practices für Produkt-Feeds und APIs, die Händler einhalten müssen
Ihr Feed ist der wirkungsvollste Hebel, den Sie kontrollieren können, und er braucht konkrete Felder statt nur vager Vollständigkeit.
- Nehmen Sie die zentralen Identitätsfelder auf: stabile ID oder SKU, Titel, Beschreibung, kanonischer Link, Bild-URL, Preis, Währung, Verfügbarkeitsstatus, Variantenattribute und Marke.
- Richten Sie sich nach dem Flat-File-Schema von OpenAI wenn Sie für ChatGPT zugelassen werden möchten. Die Produktspezifikation für den Handel mit KI-Agenten erwartet mindestens id, title, description, link, image_link, availability, price und brand.
- Setzen Sie Eligibility-Flags bewusst.
is_eligible_searchundis_eligible_checkoutsind getrennte Schalter. Selbst ein vollständig ausgefüllter Produktdatensatz erscheint nicht in ChatGPT, wenn diese Flags nicht gesetzt sind. - Erfüllen Sie die Kernanforderungen des Google Merchant Center: stabile Produkt-ID, funktionierender Landingpage-Link, korrekter Preis und Verfügbarkeit sowie richtige Kategorie- und Kennzeichnungsfelder.
- Halten Sie Feed-Werte identisch mit den Werten auf Landingpage und im Checkout. Abweichungen an dieser Stelle gehören zu den häufigsten Ursachen für Ablehnungen oder den Verlust von Empfehlungssichtbarkeit.
Profi-Tipp: Führen Sie wöchentlich eine Stichprobe mit 20 zufällig ausgewählten SKUs durch und vergleichen Sie Feed, Produktseite und Checkout-Prozess. Die meisten Feed-Abweichungen entstehen schleichend – durch ein Preisupdate oder eine Inventarsynchronisierung nach der anderen – und niemand bemerkt sie, bis ein KI-Agent einem Käufer den falschen Preis nennt.
Zur Aktualisierungsfrequenz: Kategorien mit hoher Volatilität (Mode mit häufigen Nachbestellungen, Elektronik mit dynamischer Preisgestaltung) benötigen taggleiche oder stündliche Updates. Langsamer bewegte Kategorien können tägliche Synchronisierungen tolerieren, aber niemals längere Intervalle.
Strukturierte Daten auf Produktseiten: Schema.org-Felder und häufige Fehler
Strukturierte Daten sind die Möglichkeit, einem KI-System exakt die Fakten zu übergeben, die es verwenden soll – in einem Format, bei dem nichts geraten werden muss.
Zu den wichtigsten Schema.org-Eigenschaften für jede Produktseite gehören:
Productmit name, description und imageOfferdarin verschachtelt, mitprice,priceCurrency, sowieavailabilitygtin(oder die passende GTIN-Variante) zur globalen Produktidentifikationskufür Ihre interne Kennungitem_group_idum Varianten desselben Produkts miteinander zu verknüpfen
Die Richtlinien von Google zu unterstützten Attributen für strukturierte Daten machen ausdrücklich klar, dass dieses Markup im serverseitig gerenderten HTML enthalten sein muss und nicht erst clientseitig nach dem Ausführen von JavaScript eingefügt werden darf. Viele Crawler und Agenten führen Ihr JavaScript überhaupt nicht aus, wodurch rein JavaScript-basiertes Markup für sie praktisch unsichtbar bleibt.
Der häufigste Fehler ist nicht fehlendes Markup. Es ist Markup, das früher korrekt war und stillschweigend nicht mehr mit der sichtbaren Seite übereinstimmt – meist nach einer Preisänderung oder einem Tausch von Werbeinhalten, bei dem nur die Frontend-Anzeige aktualisiert wurde.
Profi-Tipp: Ein erfolgreicher Schema-Validator zeigt nur, dass die Syntax sauber ist. Er sagt nichts darüber aus, ob eine KI Ihr Produkt tatsächlich korrekt beschreibt. Kombinieren Sie Validator-Prüfungen mit echten Prompt-Audits, um zu sehen, wie die SKU beschrieben wird.
Bewertungen, Händler-Signale und First-Party-Verhaltensdaten
Bewertungen und Verhaltensdaten beeinflussen, wie ein KI-System Empfehlungen personalisiert, spielen aber nur eine unterstützende und keine grundlegende Rolle.
- Bewertungen liefern wahrgenommene Qualität und Nachweise für Anwendungsfälle – also genau den Kontext, der einem Agenten hilft zu entscheiden, welches vorrätige Produkt zum angegebenen Bedarf eines Käufers passt.
- First-Party-Verhaltensdaten mit Einwilligung ermöglichen Plattformen, Empfehlungen anhand von Kontext, Kaufhistorie oder Surfverhalten anzupassen, laut Klaviyos Forschung zu KI und Verbraucherverhalten.
- Beide Datentypen müssen mit einer stabilen SKU-Kennung verknüpft bleiben, sonst driften Bewertungsdaten und aktueller Produktdatensatz mit der Zeit auseinander.
- Weder Bewertungen noch Verhaltenssignale sollten jemals Ihren kanonischen Preis- oder Lagerbestands-Feed überschreiben. Wenn eine Fünf-Sterne-Bewertung sagt, ein Produkt sei ein tolles Angebot, Ihr Feed aber meldet, dass es nicht auf Lager ist, gewinnt der Feed.
Aktualität, Synchronisierung und Identität: So vermeiden Sie, dass Empfehlungen ausbleiben
Veraltete Preis- und Verfügbarkeitsdaten verärgern nicht nur Käufer. Sie führen dazu, dass KI-Systeme eine SKU stillschweigend gar nicht mehr empfehlen, um keine falsche Antwort zu riskieren.
- Halten Sie Feed-, strukturierte Daten-, Landingpage- und Checkout-Werte jederzeit synchron. Laut den Empfehlungen von Google für Merchant Center erhöht jede Abweichung das Risiko einer Ablehnung oder geringeren Sichtbarkeit.
- Benennen Sie SKUs während des laufenden Betriebs niemals um und vergeben Sie sie nicht neu. Identitätsdrift – also das Ändern einer Kennung bei einem Redesign der Website oder einer Katalogmigration – gehört zu den häufigsten Ursachen dafür, dass Händler die Verbindung zwischen Preisverlauf, Bewertungen und aktuellem Produktangebot verlieren.
- Modellieren Sie Varianten explizit mit
item_group_idanstatt Farb- oder Größenvarianten als separate, voneinander getrennte Produkte zu führen. - Passen Sie die Aktualisierungsfrequenz an die Volatilität an. Schnell wechselnde Bestände benötigen stündliche Prüfungen; stabile Katalogartikel können in einem täglichen Zyklus aktualisiert werden.
- Testen Sie Grenzfälle und nicht nur den Idealfall. Vorbestellungen, Lieferstatus bei Nachbestellung und „nicht auf Lager“-Status benötigen dieselbe Prüfgenauigkeit wie reguläre verfügbare Produktangebote.
Profi-Tipp: Erstellen Sie ein kleines Dashboard, das jede SKU markiert, bei der Feed-Preis und Seitenpreis länger als zwei Stunden voneinander abweichen. Diese Lücke ist fast immer das erste Zeichen dafür, dass vorgelagert etwas nicht mehr funktioniert.
Tests und Messung: Prompts, Simulationen und Traffic-Attribution
Ein grünes Ergebnis im Schema-Validator sagt nichts darüber aus, ob ChatGPT oder Gemini Ihr Produkt tatsächlich empfehlen, wenn ein echter Käufer fragt. Genau deshalb müssen Tests die tatsächliche Ausgabe der KI einbeziehen und nicht nur die zugrunde liegende Datenstruktur.
- Erstellen Sie ein repräsentatives Prompt-Set. Berücksichtigen Sie Kategorie-Prompts („beste Laufschuhe für Plattfüße“), Anwendungsfall-Prompts, budgetbegrenzte Prompts und direkte Vergleichs-Prompts mit Wettbewerbern.
- Führen Sie die Prompts durch Agenten-Simulationen und erfassen Sie, ob Ihre SKU erwähnt wird, ob der genannte Preis der Realität entspricht und ob die Darstellung zum angegebenen Bedarf des Käufers passt.
- Kennzeichnen Sie KI-vermittelten Traffic in Ihrer Analyse und verfolgen Sie die Conversion-Rate getrennt von organischem oder bezahltem Traffic.
- Scannen Sie regelmäßig erneut. Empfehlungen verändern sich je nach Prompt, Markt und Lagerstatus. Ein gutes Ergebnis heute garantiert daher nicht dasselbe Ergebnis nächste Woche.
Eine einzelne positive KI-Antwort ist kein Ranking-Bericht. Ergebnisse variieren je nach Formulierung des Prompts, Sprache, Markt und aktuellem Lagerbestand – genau deshalb die NIQ-Analyse zu KI-gesteuertem Shopping den eigentlichen strategischen Wandel als Wechsel von Share of Search zu Share of Recommendation beschreibt – etwas, das wiederholt gemessen werden muss und nicht nur einmal.
Praktische Checkliste: Priorisierte Schritte für die nächsten 7 bis 30 Tage
- Prüfen Sie Ihren Katalog auf stabile IDs und korrigieren Sie fehlerhafte oder doppelte Variantenbeziehungen.
- Synchronisieren Sie Feed-, Seiten- und Checkout-Werte für Preis, Währung und Verfügbarkeit.
- Korrigieren Sie JSON-LD-Markup damit es serverseitig gerendert wird und mit dem sichtbaren Seiteninhalt übereinstimmt.
- Erweitern Sie dünne Produktbeschreibungen mit konkreten Attributen und Formulierungen für Anwendungsfälle.
- Führen Sie einen einfachen Simulationstest durch für Ihre 20 wichtigsten SKUs, um das aktuelle Verhalten von KI-Empfehlungen zu sehen.
| Aufgabe | Typischer Verantwortlicher | Erfolgskennzahl |
|---|---|---|
| Prüfung stabiler IDs | Katalogmanager | Keine doppelten oder umbenannten SKUs |
| Feed-/Seiten-/Checkout-Synchronisierung | Entwickler | Übereinstimmungsrate bei Preis und Verfügbarkeit |
| JSON-LD-Korrekturen | Entwickler | Markup entspricht sichtbarer Seite |
| Anreicherung der Beschreibung | Katalogmanager | Attribut-Vollständigkeit pro SKU |
| Simulationstest | Marketing-/Ecommerce-Leitung | SKU-Erwähnungsrate über das Prompt-Set hinweg |
Wie KI-Systeme Zulassungskriterien und Produktdaten nutzen
Ein vollständiger, korrekter Produktdatensatz und ein zugelassenes Produkt sind zwei verschiedene Dinge – und Händler verwechseln sie regelmäßig.
Produktdaten wie Preis, Verfügbarkeit, Bilder und Beschreibungen beantworten die Frage: „Was ist dieses Produkt und kann es grundsätzlich aktuell verkauft werden?“ Eligibility-Kennzeichnungen beantworten eine engere, separate Frage: „Soll dieses spezifische System dieses spezifische Produkt jetzt anzeigen oder damit eine Transaktion durchführen?“ Die Dokumentation von OpenAI zum Handel mit KI-Agenten trennt diese Bereiche bewusst, wobei is_eligible_search die Auffindbarkeit steuert und is_eligible_checkout steuert, ob eine Transaktion tatsächlich innerhalb des Agenten abgeschlossen werden kann.
Diese Unterscheidung bringt viele Händler durcheinander, die davon ausgehen, dass die Sichtbarkeit automatisch korrigiert wird, sobald der Feed bereinigt ist. Das stimmt nicht. Ein Produkt mit perfekten Daten, aber einem nicht gesetzten oder falsch konfigurierten Eligibility-Flag, erscheint schlicht nicht – egal wie stark der zugrunde liegende Datensatz ist. Umgekehrt kann ein Produkt technisch zugelassen sein, aber schlecht beschrieben werden, wodurch es in Vergleichen selten angezeigt oder schnell verworfen wird.
Praktisch bedeutet das: Die Prüfung der Eligibility benötigt einen eigenen Punkt auf der Checkliste, getrennt von der Prüfung der Datenqualität. Behandeln Sie sie als explizit zu kontrollierende Freigabe und nicht als automatische Folge eines sauberen Katalogs. Händler mit mehreren Märkten sollten Eligibility-Kennzeichnungen pro Markt überprüfen, da eine korrekt gesetzte Kennzeichnung für die Feed-Einreichung einer Region nicht automatisch überall gilt, wo derselbe Katalog syndiziert wird.
Datenschutz- und Compliance-Aspekte bei KI- und Shopping-Datenquellen
First-Party-Verhaltensdaten sind die wertvollste Eingabe für die Personalisierung, auf die KI-Shopping-Systeme Zugriff haben – und zugleich die rechtlich sensibelste.
Einwilligung ist die Grundlage. Verhaltenssignale, Browserverlauf, Kaufmuster und Interaktionen auf der Website dürfen Personalisierungsmodelle nur dann speisen, wenn Käufer dieser Nutzung tatsächlich zugestimmt haben. Welche Regeln gelten, unterscheidet sich zudem je nach Rechtsraum (Datenschutzregelungen in der EU, Datenschutzgesetze einzelner US-Bundesstaaten und andere setzen jeweils eigene Maßstäbe). Händler, die in mehreren Märkten tätig sind, müssen verfolgen, welcher Einwilligungsstandard für welches Kundensegment gilt, statt eine einzige pauschale Richtlinie anzuwenden.
Auch Datenminimierung spielt hier eine Rolle. Einer KI mehr Verhaltensdetails zu geben, als ein Personalisierungsanwendungsfall tatsächlich benötigt, verbessert Empfehlungen nicht wesentlich. Es erhöht lediglich Ihr Compliance-Risiko. Dasselbe gilt für Bewertungsdaten: Wenn aus Bewertungen abgeleitete Signale aggregiert und anonymisiert werden, bevor sie in eine Empfehlungs-Pipeline gelangen, reduziert das das Risiko, ohne den Nutzen wesentlich zu verringern.
Die Weitergabe von Daten an Dritte verdient besondere Aufmerksamkeit. Wenn ein Feed oder eine API Kundendaten zur Verarbeitung an eine externe KI-Plattform überträgt, kann diese Übertragung selbst Offenlegungs- oder Vertragsanforderungen auslösen – abhängig von Plattform und Rechtsraum. Händler sollten jede neue Integration mit einer KI-Shopping-Plattform so behandeln wie die Integration eines neuen Zahlungsdienstleisters: zuerst eine Prüfung der Datenweitergabe, nicht erst nach dem Launch.
Integrationsprobleme beim Kombinieren mehrerer Datenquellen für KI-Shopping-Modelle
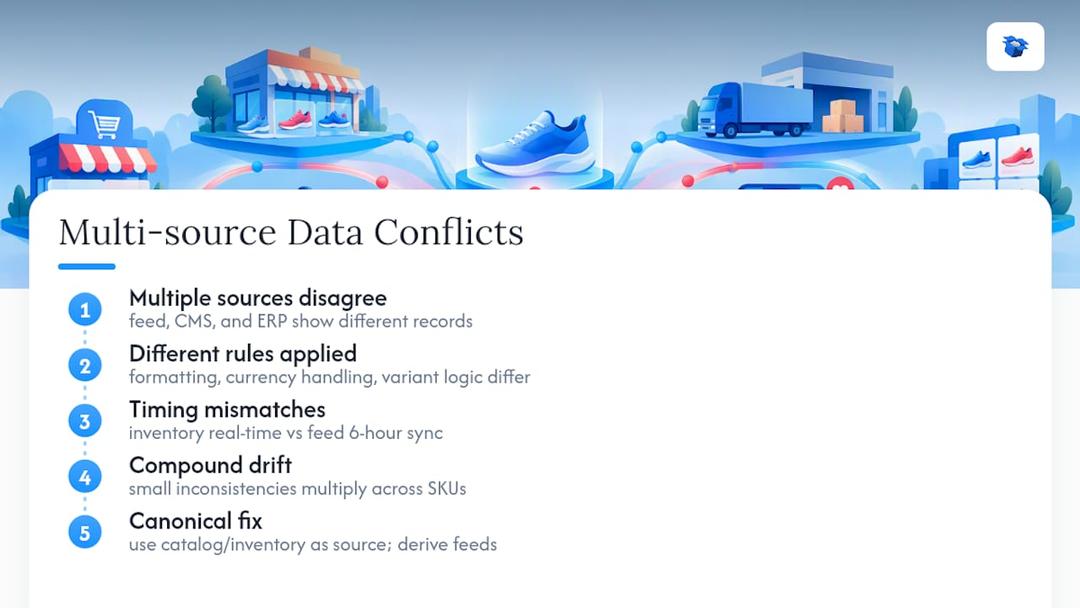
Jeder Händler stößt irgendwann auf dieselbe Hürde: Der Feed sagt das eine, das CMS etwas anderes und das ERP-System widerspricht beiden.
Die eigentliche Herausforderung besteht nicht darin, Daten zu sammeln. Es geht darum, Datensätze abzugleichen, die für unterschiedliche Zwecke entwickelt wurden und nie darauf ausgelegt waren, übereinzustimmen. Ein Feed für Google Shopping und ein Feed für eine KI-Commerce-Plattform können zwar dieselbe Quelldatenbank nutzen, aber unterschiedliche Formatierungsregeln, Währungslogiken oder Varianten-Gruppierungen anwenden. Kleine Inkonsistenzen summieren sich in einem Katalog mit Tausenden von SKUs schnell.
Zeitliche Abweichungen verschärfen das Problem. Wenn Ihr Inventarsystem in Echtzeit aktualisiert wird, Ihr Feed aber nur alle sechs Stunden synchronisiert, arbeitet ein KI-Agent zeitweise mit bereits falschen Daten. Die Richtlinien von Google zu strukturierten Daten und automatischen Updates sind hier eindeutig: Aktualität ist nicht optional, und unterschiedliche Aktualisierungszyklen zwischen Systemen erzeugen genau die Konflikte, die das Vertrauen der KI in ein Produktangebot untergraben.
Die praktische Lösung besteht darin, eine einzige kanonische Wahrheitsquelle festzulegen – meist das Inventar- oder Katalogmanagementsystem – und jeden nachgelagerten Feed als abgeleitete Ausgabe statt als unabhängig gepflegten Datensatz zu behandeln. Jede manuelle Änderung direkt in einer Feed-Datei, ohne das Quellsystem zu aktualisieren, erzeugt Abweichungen, die sich später kaum noch nachvollziehen lassen. Händler mit Shopify oder WooCommerce und mehreren Vertriebskanälen sollten prüfen, an wie vielen Stellen Preis- und Lagerbestandsdaten tatsächlich gepflegt werden, bevor sie davon ausgehen, dass ihre Systeme synchron sind.
Die Rolle aggregierter Drittanbieter-Daten und ihre Zuverlässigkeit
Aggregatoren, die Produktdaten aus mehreren Shops zusammenführen und in einen einheitlichen Feed normalisieren, spielen eine reale Rolle im KI-Shopping-Ökosystem. Ihre Zuverlässigkeit schwankt jedoch stärker, als viele Händler annehmen.
Der Vorteil liegt auf der Hand: Statt für jeden Kanal separate Feeds zu pflegen, kann ein Händler einen einzigen Feed an einen Aggregator senden, der die normalisierten Daten weiterverteilt. Das Risiko dabei: Normalisierung ist ein Übersetzungsprozess – und Übersetzungen bergen immer die Möglichkeit von Fehlern. Ein Preisupdate auf Ihrer Seite kann sich über einen Aggregator langsamer verbreiten als über einen direkten Feed. Genau diese Verzögerung untergräbt das Vertrauen von KI-Systemen in Empfehlungen.
Die Zuverlässigkeit hängt auch stark davon ab, wie oft der Aggregator selbst mit Ihren Quelldaten synchronisiert, und diese Frequenz ist für Sie als Händler nicht immer sichtbar. Bevor Sie sich bei der Sichtbarkeit im KI-Shopping auf einen Aggregator als primären Vertriebskanal verlassen, sollten Sie prüfen, ob dessen Aktualisierungsfrequenz zu Ihrer eigenen Volatilität passt – und nicht nur zur Marketingaussage „Echtzeit“-Synchronisierung.
Die sicherere Strategie besteht darin, über Aggregatoren verteilte Daten als sekundären Kanal zu behandeln, der mit Ihrem direkten Feed und dem Seiten-Markup übereinstimmen sollte – nicht als Ersatz dafür. Wenn alle drei voneinander abweichen, ist die Version des Aggregators diejenige, der ein KI-System am wenigsten vertraut, weil sie am weitesten von der Originalquelle entfernt ist.
Auswirkungen der Datenqualität auf KI-Empfehlungen in Shopping-Szenarien
Datenqualität beeinflusst nicht nur, ob ein KI-System Ihr Produkt findet. Sie entscheidet darüber, ob das System ihm genug vertraut, um es gegenüber dem Produktangebot eines Wettbewerbers zu empfehlen.
Ein Produkt kann technisch auffindbar, indexiert, feed-zugelassen und strukturell valide sein – und trotzdem Empfehlungsmöglichkeiten verlieren, weil Attribute unvollständig sind, Varianten mehrdeutig bleiben oder der Preis stillschweigend veraltet ist. Die Commerce-Spezifikation von OpenAI formuliert das direkt: Allein die Gültigkeit von Daten zu messen reicht nicht aus, weil beobachtete Empfehlungsergebnisse von dem abweichen können, was eine saubere Schema-Prüfung erwarten ließe.
Widersprüchliche Datensätze über verschiedene Quellen hinweg verschärfen das Problem. Wenn Ihr Feed, Ihr Seiten-Markup und ein Händlerangebot dasselbe Produkt leicht unterschiedlich beschreiben, mittelt ein KI-System diese Unterschiede nicht. Es wertet die Abweichung als Signal mangelnder Zuverlässigkeit, was das Gesamtvertrauen in jedes mit dieser SKU verbundene Feld senkt – etwas, das die Merchant-Center-Spezifikation von Google durch ihren Fokus auf Konsistenz über Datenquellen hinweg faktisch bestätigt.
Besonders wichtig ist hier der kumulative Effekt. Ein einzelnes schwaches Attributfeld ruiniert ein Produktangebot selten allein. Doch ein Katalog mit Dutzenden kleiner Inkonsistenzen – hier ein veralteter Preis, dort ein fehlendes Variantenattribut, eine Beschreibung ohne wichtigen Anwendungsfall – entwickelt ein Muster, das KI-Systeme zunehmend zurückstufen. Datenqualität zu verbessern ist kein einmaliges Aufräumprojekt. Es ist eine fortlaufende Disziplin, deren Nutzen sich mit der Dauer ihrer Pflege verstärkt.
Publisher-Perspektive: Warum Simulation reine Validierung übertrifft
Schema-Validatoren bestätigen die Syntax. Sie können Ihnen nicht sagen, dass ein KI-Agent Ihr Produkt überspringt, weil die Beschreibung genau das Attribut versteckt, nach dem der Käufer tatsächlich gefragt hat. Simulation macht diese Lücke sichtbar, und ein Zyklus aus Diagnostizieren, Umschreiben, Veröffentlichen und erneuten Tests schließt sie schneller als jedes statische Audit. Händler, die diesen Zyklus regelmäßig durchlaufen, entdecken Drift, Preisabweichungen, dünne Beschreibungen und mehrdeutige Varianten meist, bevor sie eine ganze Saison an Empfehlungen verlieren – nicht erst danach.
— Xhurian
Wie ecentic Datenkorrekturen in KI-Empfehlungserfolge verwandelt
Feeds und Markup isoliert zu korrigieren, bleibt Rätselraten, solange Sie nicht sehen können, wie ChatGPT, Gemini oder Perplexity aktuell tatsächlich auf Ihren Katalog reagieren. Einige Plattformen schließen diese Lücke: Sie simulieren reale Shopping-Prompts für Ihren Shop, zeigen in klarer Sprache genau, wo ein Produktangebot gegenüber Wettbewerbern gewinnt oder verliert, und ermöglichen es, die Korrektur direkt mit einem Klick zurück nach Shopify oder WooCommerce zu veröffentlichen.

Mit dem UCP Playground können Sie jeden Shop mit KI-Einkaufsagenten testen, bevor Sie sich für eine Überarbeitung entscheiden. So wissen Sie, welche SKUs Aufmerksamkeit benötigen, statt zu raten. Sobald Sie die Lücken erkennen, erstellen die von ecentic bereitgestellten Tools zur Optimierung von Produktangeboten die Korrekturen und veröffentlichen sie. Anschließend prüfen sie mit einem erneuten Scan, ob sich die Empfehlungsrate tatsächlich verändert hat.
Starten Sie mit einem kostenlosen Scan, um den aktuellen Stand Ihres Katalogs zu sehen, und vergleichen Sie anschließend die Tarife auf der Preisseite, auf der verschiedene Abonnementoptionen sowie eine leistungsabhängige Gebühr pro KI-attribuierter Bestellung aufgeführt sind.
Maßgebliche Spezifikationen und Dokumentationen für den nächsten Schritt
Für technische Details über diesen Leitfaden hinaus sollten Sie direkt zu den Originalquellen gehen. Die OpenAI-Spezifikation für den Handel mit KI-Agenten behandelt Feed-Struktur und Eligibility, während die Richtlinien von Google zu strukturierten Daten die Markup-Validierung und erforderlichen Eigenschaften für eine korrekte Auffindbarkeit abdecken.
Quellen
Bilder und Freitextbeschreibungen enthalten echte Informationen, die KI-Systeme nutzen. Sie sind jedoch schwieriger zu validieren als ein strukturiertes Preisfeld – und genau dadurch entstehen blinde Flecken, die Händler regelmäßig übersehen.
Produktbilder dekorieren ein Produktangebot nicht nur. Multimodale KI-Systeme können Attribute direkt aus Bildern extrahieren – etwa Farbe, Materialstruktur oder ungefähre Größe im Verhältnis zu anderen Objekten im Bild –, wenn strukturierte Attributfelder fehlen oder unvollständig sind. Das ist nützlich, bedeutet aber auch, dass ein minderwertiges oder generisches Stockfoto aktiv gegen Sie arbeiten kann, indem es vage oder irreführende visuelle Signale liefert, wo ein klares Textattribut zuverlässiger gewesen wäre.
Freitextbeschreibungen bergen in die andere Richtung ein ähnliches Risiko. Eine Beschreibung, die für SEO-Keyword-Dichte statt für klare Attributsprache geschrieben wurde („Premiumqualität, Klassenbester, unglaublicher Wert“), liefert einem KI-System kaum konkrete Informationen. Eine Beschreibung, die Material, Maße und spezifischen Anwendungsfall nennt, gibt der KI dagegen viel Substanz – selbst ohne ein einziges unterstützendes strukturiertes Feld.
Der praktische Ansatz besteht darin, unstrukturierte Inhalte als Ergänzung zu strukturierten Daten zu behandeln – niemals als Ersatz. Schreiben Sie Beschreibungen mit konkreten Attributen in klarer Sprache und verwenden Sie Bilder, die die für die Kategorie relevanten Produkteigenschaften deutlich zeigen: Größenreferenzen bei Möbeln, Texturen bei Stoffen, Maßstab bei Elektronik. Wo strukturierte Felder vorhanden sind, sollten Text- und Bildinhalte ihnen nicht widersprechen.
FAQ
Benötige ich sowohl einen Produkt-Feed als auch strukturiertes Daten-Markup?
Ja. Feeds und strukturierte Daten bedienen unterschiedliche Systeme und prüfen sich gegenseitig; sich nur auf eines zu verlassen, hinterlässt Lücken, die KI-Agenten als Inkonsistenz interpretieren können. Die Produktdatenspezifikation von Google behandelt konsistente Werte über beide Quellen hinweg als Grundanforderung – nicht als Option.
Wie oft sollte ich Preis- und Verfügbarkeitsdaten aktualisieren?
Richten Sie die Aktualisierung danach aus, wie schnell sich der Bestand verändert: stündlich oder noch am selben Tag bei stark nachgefragten Artikeln, bei Artikeln mit stabilem Bestand mindestens täglich. Laut den Empfehlungen von Google für Merchant Center gehören veraltete Werte zu den häufigsten Ursachen dafür, dass KI-Empfehlungen ausbleiben.
Können Bewertungen die Notwendigkeit genauer Feed-Daten ersetzen?
Nein. Bewertungen liefern Qualitäts- und Anwendungsfallnachweise, ersetzen aber niemals maßgebliche Preis- oder Bestandsdaten. Dafür bleibt unabhängig von der Stärke der Bewertungssignale weiterhin der Feed zuständig.
Wie teste ich, was KI-Agenten tatsächlich für meine Produkte empfehlen?
Erstellen Sie ein repräsentatives Set von Shopping-Prompts für Kategorien-, Budget- und Vergleichsszenarien und führen Sie diese anschließend durch eine Agenten-Simulation wie den UCP Playground von Ecentic, um SKU-Erwähnungen und Preisgenauigkeit direkt zu überprüfen.
Was kostet ecentic für einen kleinen E-Commerce-Shop?
Der Tarif Compete von ecentic beginnt bei $14.90 pro Monat, Scale bei $44.90 und Dominate bei $149. Zusätzlich gibt es eine Pay-as-you-go-Option mit einer Gebühr von 3 % pro KI-attribuierter Bestellung. Alle Preise finden Sie auf der Preisseite.
Diese Themen entdecken