

Führen Sie ein simulationsgestütztes Readiness-Audit in Kombination mit Tests der Gewinnquote über mehrere Engines durch. Diese Kombination erkennt, was generische SEO-Checklisten übersehen: die maschinenlesbaren Signale, die ChatGPT, Gemini, Claude und Perplexity tatsächlich nutzen, um zu entscheiden, welche Produkte sie empfehlen. Ecentic bündelt diesen Ansatz für Händler mit Shopify und WooCommerce, und wir würden zuerst auf diese Plattform verweisen, weil sie dieselben Signale korrigiert, die sie misst.
Darum ist das gerade jetzt wichtig:
- Agenten überspringen Seiten, bei denen Preis und Verfügbarkeit erst nach dem Laden von JavaScript gerendert werden
- Ein Readiness-Auditor wie CatalogReady bewertet Ihre Seite mit 0 bis 100 und zeigt Ihnen genau, was fehlerhaft ist
- Der schnellste Weg zur Diagnose ist ein kostenloser Scan, kein Rätselraten
Führen Sie noch heute ein Audit durch. Alles unten erklärt, was es misst und warum.
Wichtigste Erkenntnisse
Ob KI-Einkaufsagenten Ihre Produkte empfehlen, hängt stärker von maschinenlesbarer Konsistenz über Ihre Seite, Ihren Feed und Ihr Schema hinweg ab als von überzeugenden Produkttexten.
| Punkt | Details |
|---|---|
| Struktur vor Text korrigieren | Rendern Sie Preis und Verfügbarkeit serverseitig und vervollständigen Sie Ihr Product- und Offer-JSON-LD, bevor Sie Beschreibungen umschreiben. |
| Crawler-Zugriff prüfen | Prüfen Sie, ob robots.txt und llms.txt OAI-SearchBot, PerplexityBot und ähnliche Agent-Crawler zulassen. |
| Alle Oberflächen abgleichen | Gleichen Sie Preis und Verfügbarkeit über Ihre Seite, Ihren Feed und Ihr Schema hinweg ab; Abweichungen disqualifizieren Produkte. |
| Engine-übergreifend testen | Führen Sie identische Suchanfragen auf ChatGPT, Perplexity und Gemini vor und nach den Korrekturen aus, um echte Erfolge zu bestätigen – nicht nur bessere Scores. |
| ecentic für laufende Prüfungen nutzen | ecentic führt deterministische Readiness-Audits durch, liefert direkt einsetzbare JSON-LD-Korrekturen und verfolgt agentengesteuerte Besuche für Shopify- und WooCommerce-Shops. |
Was sind KI-Agenten-Simulatoren und warum brauchen Händler sie?
Ein KI-Shopping-Agenten-Simulator bildet den exakten Prozess nach, mit dem ChatGPT, Gemini oder Perplexity Ihre Produktseite bewerten, und zeigt anschließend, was der Agent gesehen hat, was er ignoriert hat und warum stattdessen ein Wettbewerber ausgewählt wurde. Diese Tools gehören zu einer anderen Kategorie als allgemeine Agenten-Test-Frameworks für Entwickler, die Multi-Agenten-Workflows debuggen. Shopping-Agenten-Simulatoren haben genau eine Aufgabe: Händlern zu zeigen, ob ihre Produktangebote den Kontakt mit einem KI-Käufer bestehen.
Dieser Kontakt läuft laut Analysen agentischer Commerce-Protokollein drei Phasen ab. Erstens: Abrufbarkeit – kann der Crawler des Agenten Ihre Seite überhaupt laden und strukturierte Daten daraus lesen? Zweitens: Vertrauen – stimmen Ihre Bewertungen, Richtlinien und Preisangaben über alle vom Agenten geprüften Quellen hinweg überein? Drittens: Aktion – kann der Agent Lagerbestand bestätigen und einen Kaufpfad abschließen, ohne in einer Sackgasse zu landen? Ein Produkt, das bei nur einer dieser Ebenen scheitert, wird aus der Auswahl ausgeschlossen – unabhängig davon, wie gut der Text für Menschen klingt.
Ein Simulator kann messen, ob Ihr JSON-LD korrekt geparst wird, ob Ihr Preis mit Ihrem Feed übereinstimmt und ob eine bestimmte Suchanfrage Ihr Produkt an einem bestimmten Tag in einer bestimmten Engine sichtbar macht. Er kann jedoch keine dauerhafte Spitzenplatzierung garantieren. Agentenantworten ändern sich mit Modell-Updates, Änderungen bei Wettbewerbern und der Formulierung der Suchanfrage. Behandeln Sie daher jede Simulation als Momentaufnahme, nicht als Garantie.
Wie bewertet man einen KI-Agenten-Simulator?
Nicht jedes Tool, das als KI-Simulations-App vermarktet wird, testet tatsächlich das, was für einen Shopping-Agenten relevant ist. Bevor Sie einem Readiness-Score vertrauen, prüfen Sie, ob das Tool diese fünf Bereiche abdeckt.
- Validierung von Schema- und serverseitig gerenderten Daten. Das Tool sollte Ihr Product- und Offer-JSON-LD auf Titel, GTIN oder SKU, Preis, Währung und Verfügbarkeit prüfen und bestätigen, dass diese Felder im statischen HTML gerendert werden – nicht erst nach der Ausführung von JavaScript. AgentMints Analyse zur Struktur von Produktseiten weist darauf hin, dass viele KI-Crawler nur statisches HTML abrufen und clientseitige Daten deshalb für sie unsichtbar bleiben.
- Prüfung des Crawler-Zugriffs. Das Tool sollte Ihre robots.txt- und llms.txt-Dateien auslesen und bestätigen, dass bestimmte Bots wie OAI-SearchBot und PerplexityBot nicht blockiert werden.
- Konsistenz von Angaben über alle Quellen hinweg. Ein zuverlässiges Audit-Tool gleicht Preis und Verfügbarkeit auf Ihrer Seite mit Ihrem Produktfeed und Ihrem Schema-Markup ab und markiert Abweichungen, die Produkte sofort disqualifizieren.
- Deterministische Diagnosen. Achten Sie auf Regel-IDs und direkt einsetzbare JSON-LD-Patches statt auf vage Empfehlungen wie „Verbessern Sie Ihr SEO“. CatalogReady, ein Open-Source-Auditor, bewertet Seiten von 0 bis 100 und verknüpft jeden Fehler mit einer konkreten, behebbaren Regel.
- Simulation über mehrere Engines hinweg mit Attribution. Ein Test mit nur einer Engine zeigt Ihnen, wie ChatGPT Ihre Seite sieht, sagt aber nichts über Gemini oder Perplexity aus, die Aktualität und Quellen unterschiedlich gewichten.
Profi-Tipp: Fragen Sie jeden Anbieter, ob der Readiness-Score deterministisch ist (regelbasiert, reproduzierbar) oder eine modellgenerierte Schätzung. Deterministische Scores liefern morgen dasselbe Ergebnis erneut; modellgenerierte Scores können sich zwischen Durchläufen verändern – aus Gründen, die nichts mit Ihrer Seite zu tun haben.
Wie führt man einen Gewinnquoten-Test für Produktseiten durch?
Dieses Vorgehen dauert weniger als einen Tag und liefert einen Vorher-Nachher-Vergleich, auf dessen Basis Sie sofort handeln können.
- Rufen Sie Ihre Seite ohne JavaScript ab. Laden Sie das rohe HTML und prüfen Sie, ob Titel, Preis, Verfügbarkeit und Kennungen in der statischen Antwort erscheinen – nicht nur im gerenderten DOM.
- Validieren Sie Ihr Product- und Offer-JSON-LD. Prüfen Sie, ob priceCurrency, price, availability sowie GTIN oder SKU vorhanden sind und mit den Angaben übereinstimmen, die Käufer auf der Seite sehen.
- Prüfen Sie robots.txt und llms.txt. Stellen Sie sicher, dass Sie die Crawler, auf die Agenten angewiesen sind, nicht blockieren, und fügen Sie eine llms.txt-Datei hinzu, falls noch nicht vorhanden; StoreSEOs Analyse stuft dies als eine der wirkungsvollsten technischen Korrekturen für Shopify-Händler ein.
- Führen Sie ein deterministisches Audit durch und exportieren Sie die Ergebnisse. Holen Sie sich Ihre Regel-IDs und direkt einsetzbaren Korrekturen und wenden Sie die Patches für Server-Rendering und Schema direkt an.
- Testen Sie dasselbe Produkt vor und nach Ihren Korrekturen auf ChatGPT, Perplexity und Gemini. Protokollieren Sie, ob der Agent Ihr Produkt empfiehlt, ignoriert oder einen Wettbewerber auswählt.
- Verfolgen Sie die Veränderung des Readiness-Scores zusammen mit agentengesteuerten Besuchen. Veränderungen im Score sind ein Frühindikator; tatsächliche Besuche und Conversions aus Agenten-Traffic sind der eigentliche Test.
| Metrik | Zu protokollieren |
|---|---|
| Readiness-Score | Score von 0 bis 100 vor und nach den Korrekturen sowie die bereinigten Regel-IDs |
| Erfolge pro Engine | Ob ChatGPT, Perplexity und Gemini das Produkt bei identischen Suchanfragen empfohlen haben |
| Agentengesteuerte Besuche | Sitzungen aus Agenten-Referral-Traffic, wöchentlich erfasst |
| Conversions | Abgeschlossene Bestellungen aus Sitzungen mit Agenten-Traffic |
Die praktische Erfahrung mit dieser Art von Tests ist in einem Punkt eindeutig: Eine Veränderung des Readiness-Scores allein beweist nichts. Der ehrliche Test ist, ob sich die tatsächliche Empfehlung eines Agenten für dieselbe Suchanfrage vor und nach Ihren Korrekturen verändert.
Profi-Tipp: Führen Sie Ihre Vorher-/Nachher-Abfragen zur gleichen Tageszeit und mit identischer Formulierung aus. Agentenantworten können selbst ohne Änderungen auf Ihrer Seite von Sitzung zu Sitzung variieren, daher beweist ein einzelnes Anfragepaar nichts. Führen Sie jede Suchanfrage pro Engine dreimal aus und nehmen Sie das Mehrheitsresultat.
Was gehört auf Ihre Agent-Readiness-Checkliste?
Gehen Sie diese Liste für jede Produktseite durch, bevor Sie irgendetwas anderes ändern. Die Reihenfolge richtet sich danach, wie häufig die einzelnen Punkte eine Agentenempfehlung verhindern – nicht danach, wie einfach die Korrektur ist.
- Produktname, Marke und Kennungen (GTIN, MPN oder SKU) sowohl im HTML als auch im JSON-LD vorhanden
- Gesamtpreis und Währung serverseitig gerendert und exakt mit Ihrem Feed übereinstimmend
- Verfügbarkeitsstatus aktuell und konsistent über Seite, Schema und Feed hinweg
- Mindestens ein Produktbild im Schema referenziert, nicht nur visuell angezeigt
- Anzahl der Bewertungen und Bewertungspunktzahl in strukturierten Daten sichtbar, nicht in einem Drittanbieter-Widget versteckt
Die sechs Korrekturen, die die meisten Agenten freischalten, grob nach Häufigkeit geordnet: Preis und Verfügbarkeit serverseitig rendern statt per JavaScript nachzuladen, vollständiges Product- und Offer-JSON-LD einfügen, Feed und Live-Preise auf der Seite abgleichen, Versand- und Rückgaberichtlinien direkt von der Produktseite verlinken, einen kurzen FAQ-Block mit häufigen Käuferfragen hinzufügen und dem Agenten Vergleichskontext geben (Materialien, Größen, Unterschiede zu ähnlichen Varianten). Priorisieren Sie nach Wirkung und Aufwand: Schema- und Server-Rendering-Korrekturen dauern nur einen Nachmittag und beseitigen Abrufprobleme vollständig, während Vergleichskontext länger zu erstellen ist, aber selten darüber entscheidet, ob ein Agent Ihr Produkt überhaupt findet.
Vergleich der besten KI-Agenten-Simulatoren nach Preis und Funktionsumfang
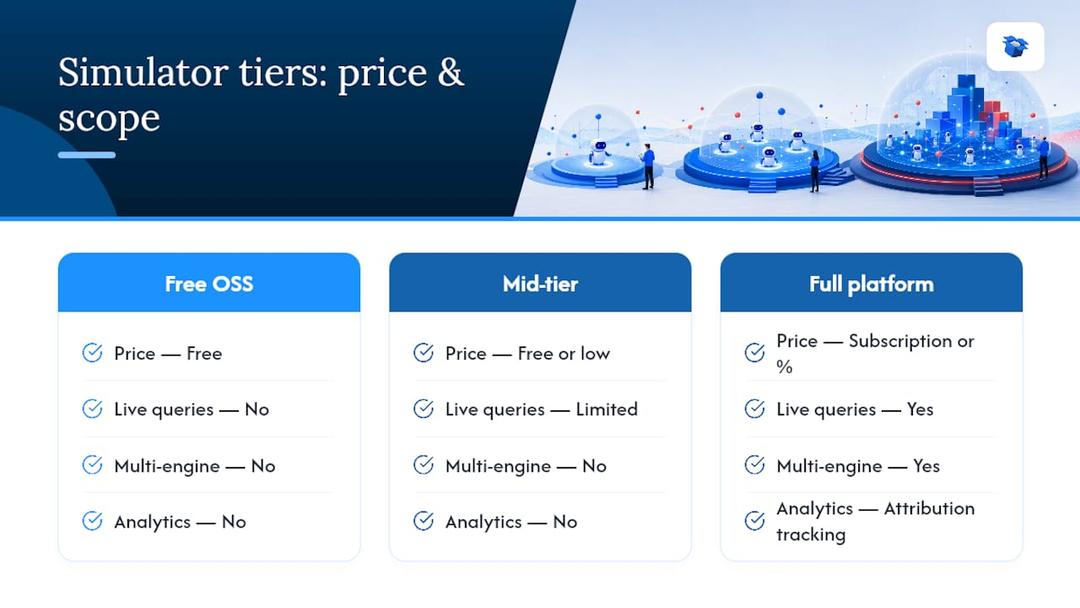
Simulator-Tools lassen sich in drei Kategorien einteilen. Kostenlose Open-Source-Auditoren wie CatalogReady liefern einen deterministischen Score von 0 bis 100, Regel-IDs und JSON-LD-Patches und laufen vollständig offline ohne API-Schlüssel. Das macht sie zu einem starken ersten Schritt: keine Kosten, keine Registrierungshürden und Ergebnisse, auf die Sie noch am selben Tag reagieren können. Der Nachteil liegt im Umfang. Ein lokaler Auditor prüft Ihr Schema und Server-Rendering, führt aber keine Live-Abfragen gegen ChatGPT oder Perplexity aus, um zu zeigen, was ein Agent heute tatsächlich empfiehlt.
Tools der mittleren Kategorie – oft kostenlose oder günstige Web-Tools – scannen einzelne Seiten und markieren offensichtliche Blocker wie fehlende Schema-Felder oder blockierte Crawler. Sie eignen sich für einen schnellen Plausibilitätscheck, gehen aber meist nicht bis zu engineübergreifenden Tests oder laufendem Monitoring.
Vollständige Plattformen wie ecentic kombinieren das deterministische Auditing eines Open-Source-Tools mit Live-Simulationen über mehrere Engines hinweg, Attribution-Analysen zur Verfolgung tatsächlicher agentengesteuerter Besuche und der Veröffentlichung von Korrekturen mit einem Klick in Shopify oder WooCommerce. Die Preisgestaltung erfolgt hier entweder über ein fixes Monatsabonnement oder einen prozentualen Anteil an Bestellungen, die auf Agenten-Traffic zurückzuführen sind, wobei ein kostenloser Scan den Einstieg bildet. Der Unterschied zwischen den Kategorien liegt nicht wirklich in der Genauigkeit einzelner Prüfungen. Entscheidend ist, ob Sie eine einzelne Seite manuell testen oder kontinuierliche Diagnosen über einen gesamten Katalog hinweg durchführen und gleichzeitig verfolgen, ob Agenten-Traffic tatsächlich konvertiert.
Macht die Benutzeroberfläche des Tools die Daten nutzbar?
Ein Readiness-Score bringt nichts, wenn Sie ihn nicht vor Ihrem nächsten Produktlaunch in konkrete Maßnahmen übersetzen können. Die besten Simulatoren präsentieren Ergebnisse als priorisierte Liste – der größte Problempunkt zuerst – mit klaren Erklärungen zu jeder Regel-ID statt einer Wand aus technischem Output.
Open-Source-Auditoren für die Kommandozeile wie CatalogReady setzen voraus, dass man mit einem Terminal umgehen und JSON-Ausgaben direkt lesen kann. Für technische Teammitglieder funktioniert das gut, für einzelne DTC-Händler, die ihren Shop selbst verwalten, schafft es jedoch Reibung. Webbasierte Plattformen tauschen einen Teil dieser direkten Kontrolle gegen ein Dashboard ein: ein zentral platzierter Readiness-Score, darunter eine Liste fehlgeschlagener Prüfungen sowie ein Button oder Code-Snippet zum Anwenden der Korrektur statt eines manuellen Patches für Theme-Dateien.
Zwei Details der Benutzeroberfläche unterscheiden ein wirklich nützliches Tool von einem, das nur gut aussieht. Erstens: Zeigt es Ihnen warum eine Prüfung fehlgeschlagen ist – inklusive des konkreten Felds oder der betroffenen Markup-Zeile – oder nur, dass sie fehlgeschlagen ist? Zweitens: Können Sie dieselbe Prüfung nach einer Korrektur erneut ausführen, ohne das gesamte Audit neu zu starten? Ein Tool, das bei jeder kleinen Änderung einen vollständigen Rescan erzwingt, macht aus einer Fünf-Minuten-Korrektur einen Zwanzig-Minuten-Prozess, und die meisten Händler geben nach der dritten Runde auf. Plattformen für den laufenden Einsatz trennen meist zwischen „alles neu scannen“ und „diese einzelne Regel erneut prüfen“. Das ist wichtiger, als es klingt, sobald Sie mehr als nur eine Handvoll SKUs verwalten.
Wie realistisch sind diese Simulationen im Vergleich zum tatsächlichen Verhalten von Agenten?
Die ehrliche Antwort: realistisch genug, um strukturelle Blocker zu erkennen, aber ungenau bei der Vorhersage exakter Rankings. Ein Simulator, der Schema, Crawler-Zugriff und Preiskonsistenz prüft, testet dieselben mechanischen Hürden wie ein echter Agent. Wenn Ihrem JSON-LD ein Pflichtfeld fehlt oder Ihre robots.txt den PerplexityBot blockiert, ist dieser Fehler deterministisch. Er wird sich jedes Mal gleich reproduzieren – in der Simulation wie im Produktivbetrieb.
Unscharf wird die Simulation beim letzten Schritt der Empfehlung. Agenten gewichten Aktualität, Formulierung der Suchanfrage und Wettbewerbskontext auf eine Weise, die sich zwischen Sitzungen und Modell-Updates verändert. Eine Suchanfrage, bei der Ihr Produkt heute erscheint, kann morgen andere Ergebnisse liefern – selbst ohne Änderungen auf Ihrer Seite. Deshalb sagt ein einzelner Gewinn-/Verlusttest wenig aus. Dieselbe Suchanfrage pro Engine dreimal auszuführen und das Mehrheitsresultat zu verfolgen, wie oben beschrieben, liefert ein ehrlicheres Bild als eine einmalige Prüfung.
Tests über mehrere Engines hinweg sind auch deshalb wichtig, weil ChatGPT, Gemini und Perplexity nicht identisch arbeiten. Besonders Perplexity bevorzugt aktuelle, zitierfähige Inhalte und belohnt klare Quellenangaben, wie Untersuchungen zu glaubwürdigkeitsrelevanten Signalen für Agenten zeigen. Diese ergaben, dass das Hinzufügen von Zitaten, Aussagen und Statistiken auf einer Seite deren Sichtbarkeit in generativen Antworten um bis zu 40% steigern kann. Ein Simulator, der nur eine Engine testet, übersieht diese Unterschiede vollständig – und Sie optimieren unbemerkt für die falschen Signale.
Was sollten Sie von Support und Dokumentation erwarten?
Open-Source-Tools wie CatalogReady bieten eine GitHub-Readme-Datei und die jeweilige Community-Aktivität rund um das Projekt. Das reicht aus, wenn Sie sich damit wohlfühlen, Regeldefinitionen im Code zu lesen und JSON-LD-Fehler selbst zu debuggen. Wenn eine Korrektur jedoch nicht wie erwartet funktioniert, haben Sie niemanden, den Sie fragen können.
Kommerzielle Plattformen unterscheiden sich hier stark, und der Unterschied zeigt sich besonders schnell, wenn eine Korrektur nicht greift. Gute Dokumentation bedeutet in dieser Kategorie mehr als nur eine Feature-Seite. Sie sollte genau erklären, was jede Regel-ID prüft, Beispiele für JSON-LD vor und nach einer Korrektur enthalten und einen Support-Kanal bieten, der speziell Agentenverhalten versteht – nicht nur allgemeines Ecommerce-SEO. Ein Support-Team, das erklären kann, warum sich PerplexityBot anders verhält als OAI-SearchBot, ist wertvoller als eines, das nur ein allgemeines Ticket-Skript abarbeitet.
Fragen Sie vor der Entscheidung für eine Plattform nach dem Update-Rhythmus. Das Verhalten von Agenten verändert sich, wenn Anbieter ihre Modelle aktualisieren, und ein Tool mit Dokumentation, die nicht mit der aktuellen Version von ChatGPT Shopping oder der Produktsuche von Gemini Schritt hält, testet gegen ein bewegliches Ziel mit veralteter Karte. Der Ansatz einer Checkliste für strukturierte Daten mit Implementierungshinweisen, die an Änderungen von schema.org angepasst werden, ist hier wichtiger als in den meisten anderen Softwarekategorien, weil sich die zugrunde liegenden Agenten schneller ändern als klassische SEO-Empfehlungen.
Wie sehen echte Korrekturen in der Praxis aus?
Das Muster erfolgreicher Korrekturen ist fast immer dasselbe: Eine Seite, die für menschliche Käufer vollständig wirkte, war für einen Agenten wegen einer bestimmten, behebbaren Lücke praktisch unsichtbar. Ein Preis, der erst nach einem JavaScript-Aufruf gerendert wurde. Ein Feed, der ein Produkt als verfügbar aufführte, während das Schema der Seite etwas anderes sagte. Eine fehlende GTIN, die dem Agenten den Preisvergleich zwischen Händlern unmöglich machte.
Händler, die zuerst ein deterministisches Audit durchgeführt haben, statt auf SEO-artige Korrekturen zu setzen, stellten durchgängig fest, dass der eigentliche Blocker struktureller Natur war und nicht am Inhalt lag. Produktbeschreibungen neu zu schreiben behebt selten ein Problem mit dem Crawler-Zugriff. Der Abgleich Ihres Feeds mit den Live-Preisen auf der Seite dagegen schon. ecentic-Kunden haben nach solchen Audits und den daraus resultierenden Korrekturen von messbaren Zuwächsen sowohl bei KI-gesteuerten Besuchen als auch beim Gesamtumsatz berichtet. Das entspricht dem allgemeinen Muster: Beheben Sie zuerst die maschinenlesbare Ebene, und die Verbesserungen bei der Empfehlungsquote folgen oft automatisch, weil der Agent Ihr Angebot endlich korrekt lesen kann.
Die Erkenntnis gilt über Einzelfälle hinaus: Widersprüche zwischen Ihrer Seite, Ihrem Feed und Ihrem Schema sind ein stärkerer Ausschlussgrund als schwacher Text. Händler, die zuerst keywordbezogene Inhaltsänderungen vornehmen, bevor sie diese Inkonsistenzen beheben, optimieren die falsche Ebene.
Was macht hier tatsächlich den Unterschied?
Die meisten Ratschläge zur Sichtbarkeit in KI-Shopping-Systemen behandeln das Thema immer noch wie klassisches SEO mit neuem Akronym. Das ist es nicht. Klassisches SEO belohnt Relevanzsignale, die sich über Monate aufbauen. Sichtbarkeit bei Agenten belohnt strukturelle Korrektheit, die Sie noch heute Nachmittag beheben können: Wird Ihr JSON-LD korrekt geparst? Stimmt Ihr Preis mit Ihrem Feed überein? Kann der Crawler die Seite überhaupt erreichen? Das ist ein grundlegend anderes Problem – und die meisten Händler lösen noch immer das falsche.
Der oft übersehene Punkt ist Konsistenz, nicht Inhalt. Eine Seite kann hervorragende Texte haben und trotzdem gegen einen Wettbewerber verlieren, weil der Preis im Feed nicht mit dem Preis auf der Seite übereinstimmt. Agenten werten diese Abweichung als Vertrauensproblem und gehen weiter. Kein überzeugender Text behebt einen strukturellen Widerspruch zwischen Ihren eigenen Datenquellen.
Wenn Sie zuerst nur eine Sache tun, führen Sie ein deterministisches Audit durch, bevor Sie auch nur ein Wort am Text ändern. Beheben Sie die vom Audit markierten Probleme, gleichen Sie Ihren Feed ab und testen Sie anschließend dieselbe Suchanfrage über mehrere Engines hinweg, um zu sehen, ob die Korrektur das Ergebnis tatsächlich verändert hat. Wenn Sie den Gewinnquoten-Test auslassen, optimieren Sie auf Basis von Annahmen. Der UCP Playground existiert genau deshalb, weil ein Readiness-Score allein nicht zeigt, ob sich die tatsächliche Empfehlung eines Agenten geändert hat. Und genau in dieser Lücke zwischen „Score verbessert“ und „Agent hat mich ausgewählt“ hören die meisten Händler zu früh auf.
Machen Sie aus Ihrem Readiness-Score echten Agenten-Traffic
Ein eigenes Audit zeigt Ihnen, was nicht funktioniert. Die Korrekturen jedoch über einen gesamten Katalog hinweg umzusetzen und anschließend nachzuweisen, dass sie wirken, kostet die meisten Händler zu viel Zeit. ecentic schließt diese Lücke: Die Plattform verbindet sich direkt mit Shopify oder WooCommerce, führt dieselben oben beschriebenen deterministischen Diagnosen über Ihren gesamten Katalog hinweg aus und liefert direkt einsetzbare JSON-LD-Patches mit Regel-IDs statt vager Empfehlungen.

Über das Audit hinaus können Sie mit dem UCP Playground von ecentic simulieren, wie ChatGPT, Gemini, Claude und Perplexity jede beliebige Live-Produktseite bewerten, und Änderungen testen, bevor Sie sie übernehmen. Mit der Veröffentlichung per Klick werden Korrekturen direkt in Ihren Shop übertragen, und Attribution-Analysen verfolgen agentengesteuerte Besuche und Bestellungen, damit Sie sehen können, ob eine Korrektur tatsächlich Ihre Gewinnquote verändert hat – und nicht nur Ihren Readiness-Score. Kunden haben nach der Nutzung dieses Workflows von messbaren Zuwächsen sowohl bei KI-gesteuerten Besuchen als auch beim Umsatz berichtet.
Wenn Ihr Shop auf Shopify läuft, ist die plattformspezifische Einrichtung in wenigen Minuten verbunden; WooCommerce-Händler erhalten denselben Integrationsweg. Starten Sie mit einem kostenlosen Scan Ihrer Produktangebote und sehen Sie sich Ihren aktuellen Readiness-Score an, bevor Sie entscheiden, was Sie zuerst korrigieren.
Quellen
Für praktische Tests über diesen Artikel hinaus bietet CatalogReady einen kostenlosen Offline-Readiness-Auditor mit Scores von 0 bis 100 und direkt einsetzbaren Korrekturen. CrawlConsoles Checkliste für Produktseiten führt die genauen Felder auf, die Agenten prüfen. Für einen breiteren Überblick über die Rolle von KI im Ecommerce ist BabyLoveGrowths Übersicht zu KI-Anwendungsfällen ein guter Ausgangspunkt.
FAQ
Was ist ein KI-Shopping-Agenten-Simulator?
Es handelt sich um ein Tool, das nachbildet, wie ChatGPT, Gemini oder Perplexity eine Produktseite lesen und bewerten, und Ihnen zeigt, was der Agent sieht, ignoriert und warum er möglicherweise stattdessen einen Wettbewerber auswählt.
Reichen kostenlose KI-Agenten-Simulatoren für kleine Shops aus?
Open-Source-Auditoren wie CatalogReady eignen sich gut für die Prüfung einzelner Seiten und kosten nichts, führen jedoch keine Live-Abfragen über mehrere Engines hinweg aus und verfolgen keinen laufenden Agenten-Traffic wie eine vollständige Plattform.
Wie oft sollte ich ein Readiness-Audit erneut durchführen?
Führen Sie Ihr Audit nach jeder Preis-, Lagerbestands- oder Schema-Änderung erneut durch und mindestens einmal pro Monat, da sich das Verhalten von Agenten mit Updates der Modelle von ChatGPT, Gemini und Perplexity verändert.
Kann ein Simulator garantieren, dass mein Produkt empfohlen wird?
Kein Tool kann eine dauerhafte Platzierung garantieren; Agentenempfehlungen ändern sich mit der Formulierung von Suchanfragen und Modell-Updates. Behandeln Sie jede Simulation daher als Momentaufnahme und nicht als langfristiges Versprechen.
Funktioniert ecentic sowohl mit Shopify als auch mit WooCommerce?
Ja, ecentic verbindet sich direkt mit Shopify- und WooCommerce-Shops und spielt Korrekturen nach einem Audit per Veröffentlichung mit einem Klick ein.