

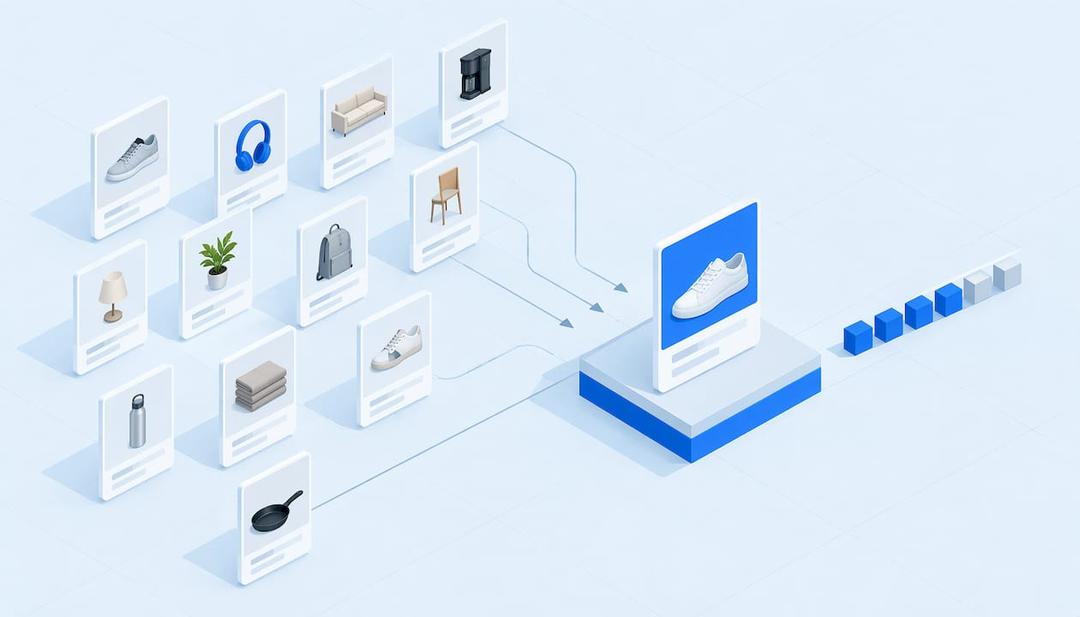
Ob Menschen Google nutzen, zu Amazon gehen oder einen Chatbot fragen: KI liefert ihnen heute eine Antwort mit einem Produkt. Die meisten E-Commerce-Marken wissen nicht, wie ihr Produkt in dieser Antwort landet. Die KI-Auswahlrate zeigt Ihnen, wie häufig Ihr Produkt ausgewählt wird. Zählen Sie dazu die Einkaufsszenarien, in denen sich ein KI-Agent am Ende für Ihr Produkt entschieden hat, teilen Sie diese Zahl durch alle getesteten Szenarien und multiplizieren Sie das Ergebnis mit 100.
Ich halte das für die ehrlichste Kennzahl in der ganzen Debatte über agentengestütztes Einkaufen, vor allem, weil sie sich nur schwer fälschen lässt. Eine Erwähnung ist billig. Ein Produkt kann in jeder Antwort genannt werden und beim letzten Schritt trotzdem den Verkauf verlieren – ein bisschen so, als wäre man zu jeder Hochzeit eingeladen und würde doch nie selbst heiraten. Auswahl ist der Moment, in dem der Agent aufhört aufzulisten und anfängt auszuwählen.
Kurzfassung
- Die KI-Auswahlrate ist der prozentuale Anteil der getesteten Einkaufsszenarien, in denen sich ein KI-Agent am Ende für Ihr Produkt entscheidet.
- Legen Sie vor der Messung fest, was als Auswahl zählt: beste Wahl, Sieger einer Shortlist, in den Warenkorb gelegt, Checkout gestartet oder Bestellung abgeschlossen.
- Weisen Sie sie pro Modell und mit Datum aus. Ein einzelner Mischwert verdeckt, dass Assistenten einander widersprechen.
- Kleine Veränderungen von Woche zu Woche sind meist nur Rauschen. Wiederholen Sie dieselben Eingaben viele Male, bevor Sie einer Veränderung glauben.
- Der schnellste Hebel sind die Daten, die der Agent liest: Produkt-Feed, Katalog und strukturierte Daten auf den Produktseiten.
Was die AI-Auswahlrate misst
Ein KI-Einkaufsagent durchsucht nicht Ihre Startseite. Er liest Ihren Produkt-Feed, Ihren Katalog und die strukturierten Daten auf Ihren Produktseiten, vergleicht das Gefundene mit anderen Angeboten und antwortet mit einem Produkt oder einer kurzen Liste mit einem Favoriten. Die Auswahlrate zählt, wie oft dieser Favorit Ihrer ist.
Die Formel ist einfach:
Auswahlrate = Szenarien, in denen Ihr Produkt ausgewählt wurde / insgesamt analysierte Szenarien × 100
Ein Szenario ist eine einzelne Einkaufsanfrage, etwa „ein Vitamin-C-Serum für empfindliche Haut unter $40“ oder „zwei Flaschen eines bestimmten Single Malts, geliefert nach Texas“. Sie erstellen dafür einen Satz solcher Anfragen für Ihre Produkte, führen sie aus und erfassen das Ergebnis.
Hier ein frei erfundenes Beispiel, nur um die Berechnung zu zeigen. Sie testen ein Produkt in 40 Szenarien. Der Agent wählt es in 8 Fällen aus. Ihre Auswahlquote für dieses Produkt liegt also bei 20 %. Wenn Ihr stärkster Wettbewerber in 18 Fällen ausgewählt wird, liegt seine Quote bei 45 %, und die übrigen Szenarien gingen an andere Händler oder an niemanden. Genau diese Lücke müssen Sie schließen.
Wichtig ist, was diese Zahl nicht ist. Sie ist weder Traffic noch eine Bestellung. Sie beschreibt die Entscheidung des Agenten – also den Schritt direkt vor beidem.
Festlegen, was als Auswahl zählt
Hier werden die meisten Teams unsauber, und genau hier verliert die Kennzahl ihre Aussagekraft. „Ausgewählt“ kann mindestens fünf verschiedene Dinge bedeuten:
- Der Agent nennt Ihr Produkt als beste Option.
- Der Agent wählt Ihr Produkt aus einer engeren Auswahl von Angeboten aus.
- Der Agent legt Ihr Produkt in den Warenkorb.
- Der Agent startet den Kaufabschluss.
- Der Agent schließt den Kauf für den Käufer ab.
Das sind verschiedene Stufen desselben Funnels, und sie ergeben sehr unterschiedliche Quoten. Die erste Definition ist großzügig. Die letzte ist streng und heute nur an wenigen Stellen möglich. Käufe direkt in der KI-Antwort sind in den USA bei Google AI Mode und Gemini über UCP möglich, den offenen Standard von Google für den Checkout durch Agenten. ChatGPT leitet den Käufer dagegen zum eigenen Checkout des Shops weiter. Für ChatGPT ist das realistische Endereignis deshalb, dass der Agent Ihr Produkt auswählt und der Käufer weiterklickt.
Mein Rat: Legen Sie eine Definition fest, dokumentieren Sie sie und ändern Sie sie nicht mitten im Quartal. Wenn Sie diesen Monat „als beste Option genannt“ berichten und nächsten Monat „in den Warenkorb gelegt“, werden Sie einen Rückgang als Gewinn feiern – oder umgekehrt.
So berechnen und verfolgen Sie die Kennzahl
Sie brauchen kein Data-Science-Team. Sie brauchen Disziplin. So würde ich vorgehen.
- Produkte auswählen. Beginnen Sie mit den zehn wichtigsten Produkten – nach Marge oder Volumen.
- Szenarien formulieren. Schreiben Sie für jedes Produkt realistische Einkaufsanfragen in der Sprache Ihrer Käufer. Berücksichtigen Sie Preisgrenzen, Anwendungsfälle, Lieferorte und Varianten. Legen Sie die Liste fest, bevor Sie starten, damit Sie später nicht stillschweigend die schlecht gelaufenen Prompts entfernen können.
- Wettbewerber festlegen. Agenten wählen zwischen Optionen. Deshalb braucht jedes Szenario ein Konkurrenzprodukt im Vergleich. Nutzen Sie die Produkte, die Ihre Kunden tatsächlich miteinander vergleichen.
- Jedes Szenario mehrfach und auf jedem Modell ausführen. Ein einzelner Durchlauf beweist nichts, weil derselbe Prompt beim nächsten Versuch eine andere Antwort liefern kann.
- Modell, Modellversion und Datum protokollieren – direkt neben jedem Ergebnis. Modell-Updates können Ergebnisse über Nacht komplett verändern.
- Die Quote pro Modell und pro Produkt berechnen. Darauf können Sie bei Bedarf eine Gesamtansicht des Portfolios aufbauen.
- Die Daten korrigieren und dieselben Szenarien erneut ausführen. Vergleichen Sie Gleiches mit Gleichem.
Von Hand funktioniert das für eine kleine Zahl von Produkten. Auf Dauer wird es mühsam. In ecentic läuft der entsprechende Prozess automatisiert: Die Plattform verbindet sich mit Shopify, WooCommerce oder einem Produktfeed, lässt ChatGPT, Claude und Gemini jedes Produkt mit dem eines benannten Wettbewerbers vergleichen und zeigt, warum Ihr Produkt verliert. Wichtiger Hinweis: Das sind simulierte Käufer, keine echten. Eine bessere Quote in einer Simulation zeigt also, wie Agenten Ihre Daten lesen – sie ist keine Prognose für Bestellungen.
Auswahlquote im Vergleich zu Erwähnungen, Empfehlungen und Conversions
Teams werfen diese Kennzahlen ständig durcheinander. Hier sehen Sie die Unterschiede direkt nebeneinander.
| Kennzahl | Was gezählt wird | Wie nah am Kauf |
|---|---|---|
| Erwähnungsquote | Wie oft Ihre Marke oder Ihr Produkt in einer Antwort genannt wird | Weit entfernt. Nennung ist nicht Auswahl |
| Empfehlungsquote | Wie oft es als gute Option vorgeschlagen wird | Näher dran, aber eine Liste kann fünf Gewinner haben |
| Auswahlquote | Wie oft es unter den Optionen die endgültige Auswahl ist | Nah dran. Das ist die Entscheidung |
| KI-Referral-Besuche | Besuche, die von einem KI-Assistenten kommen | Nach der Entscheidung, wenn der Käufer klickt |
| Conversion | Bestellungen aus diesen Besuchen | Das Ergebnis |
Ein Produkt kann in vielen Antworten auftauchen und trotzdem im letzten Schritt verlieren. Die Gründe sind meist banal: ein höherer Preis, langsamere Lieferung, eine fehlende Variante, schlechtere Rückgabebedingungen, schwächere Bewertungen oder Produktdaten, die unvollständig oder veraltet sind. Marken können in der klassischen Suche gut ranken und trotzdem aus der KI-Entscheidung herausfallen – genau diese Lücke behandeln Beispiele für KI im Ecommerce bei der Beschreibung, wie Suche und KI-Antworten inzwischen ineinandergreifen.
Noch ein wichtiger Unterschied: Eine simulierte Auswahl ist kein Verkauf. Referral-Besuche sind real, eine simulierte Auswahl ist ein Test, und Umsatz ist eine eigene Kennzahl. Halten Sie sie in getrennten Spalten fest. Wenn Sie die ausführlichere Erklärung zur Messung von Agenten-Traffic möchten, finden Sie sie in unserem Leitfaden zu KI-Analytics im Ecommerce.
Warum Sie eine Quote pro Modell brauchen – und keinen Gesamtwert
Assistenten stimmen weder untereinander überein noch mit sich selbst über verschiedene Versionen hinweg. Eine akademische Studie aus dem Jahr 2025, What Is Your AI Agent Buying?ließ Agenten mit demselben Produktsortiment arbeiten. In der Kategorie Fitnessuhren wählte Claude Sonnet 4 ein bestimmtes Fitbit-Modell in 45 % der Fälle aus, während GPT-4.1 und Gemini 2.5 Flash bei etwa 25 % lagen. Mit Claude Opus 4.5 sprang der Anteil dann auf 77 % und fiel mit GPT-5.1 auf 6 %.
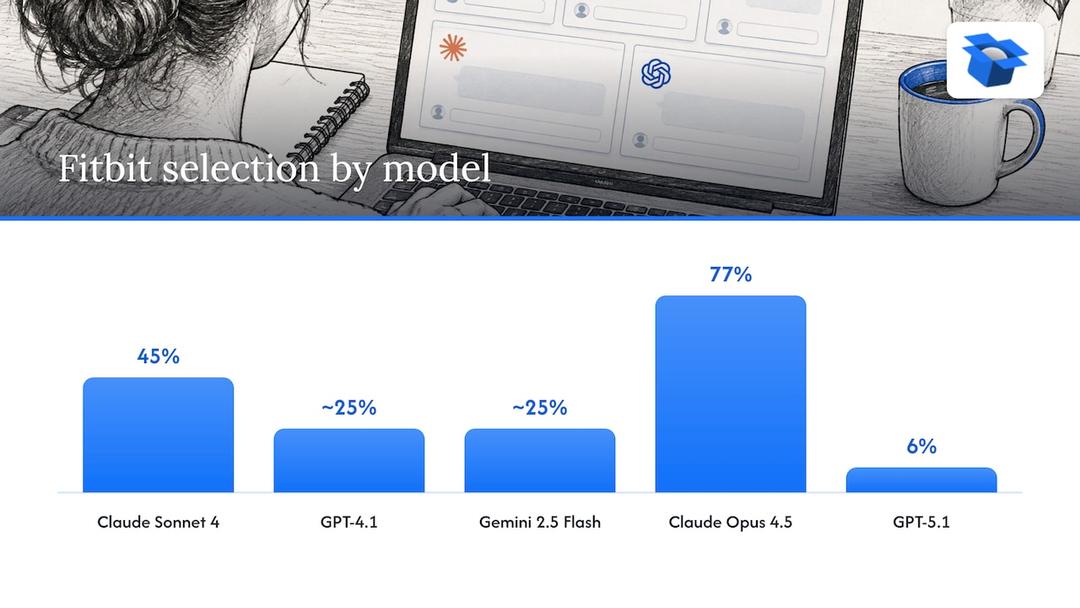
Lesen Sie das noch einmal. Dieselben Produkte, dieselbe Auswahl, aber völlig unterschiedliche Gewinner – je nachdem, welches Modell gefragt wurde. Ein gemittelter Durchschnitt dieser Zahlen würde keinen realen Käufer beschreiben.
Unsere eigenen Simulationen zeigen denselben Unterschied. Bis Oktober 2026 hatten wir 36.797 simulierte Käufe durchgeführt. Beim selben Katalog wählte ChatGPT das Produkt etwa 3-mal so häufig aus wie Claude oder Gemini: 51,6 % gegenüber rund 18,5 %. Ich behaupte nicht, jedes Mal den Grund zu kennen. Ein Teil dürfte darin liegen, dass jedes Modell Preis, Markennamen und Datenvollständigkeit unterschiedlich gewichtet. Die praktische Konsequenz ist einfach: Weisen Sie jeden Assistenten in einer eigenen Zeile mit Datum aus.
Das verändert auch Ihre nächsten Schritte. Wenn Sie bei einem Modell verlieren und bei einem anderen gewinnen, haben Sie eine konkrete Diagnose statt nur des vagen Gefühls, dass „die KI uns nicht mag“.
Was die Quote beeinflusst
Der Agent kennt nur das, was Ihre Daten ihm mitteilen. Deshalb sind die größten Einflussfaktoren oft die unspektakulärsten.
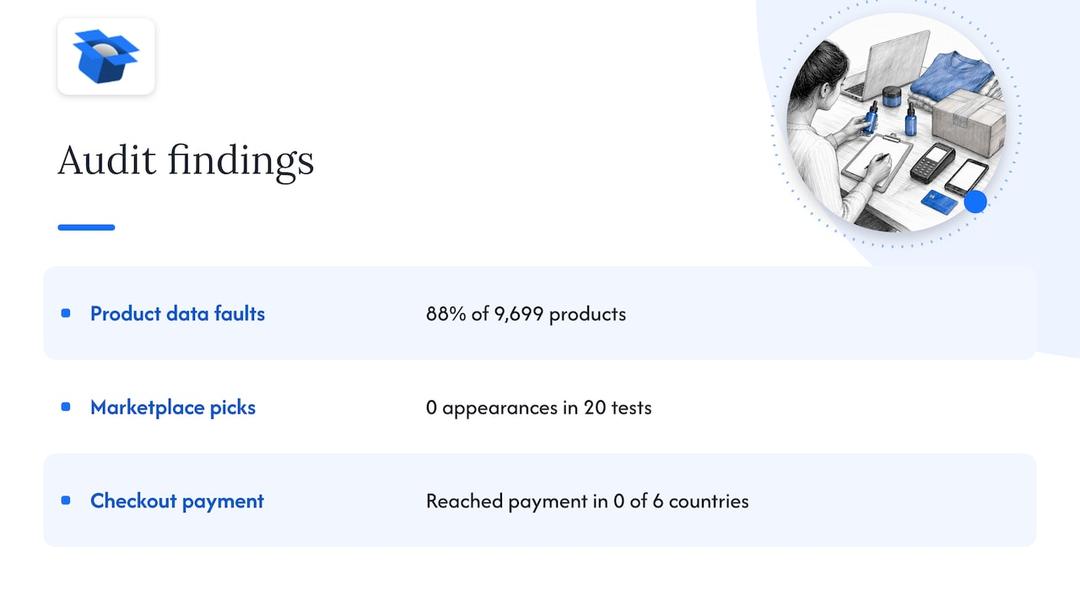
Fehler in den Produktdaten. Ein Titel wie „Serum 30ml“ liefert einem Agenten keinen Anhaltspunkt für eine Anfrage nach empfindlicher Haut. Eine Beschreibung, die für ein Poster statt für eine Kaufentscheidung geschrieben wurde, hat dasselbe Problem. In einem anonymisierten Audit wiesen bei einem Spirituosen-Marktplatz mit rund 70 Mio. € Jahresumsatz 88 % der 9.699 Produkte Fehler in den Daten auf, die Agenten lesen. Auf die Frage, wo man zwei dort geführte Flaschen kaufen könne, nannten die Agenten den Shop in 20 Versuchen 0-mal. Großartiger Katalog, unsichtbares Regal.
Strukturierte Daten. Das ist die maschinenlesbare Ebene einer Produktseite: Preis, Verfügbarkeit, Marke, Kennungen sowie Versand- und Rückgabeinformationen. Agenten verlassen sich darauf, weil diese Daten eindeutig sind. Fehlende oder widersprüchliche Felder führen schnell dazu, dass Sie verlieren.
Vergleich mit Wettbewerbern. Agenten bewerten Ihr Produkt selten isoliert. Sie stellen es einem anderen gegenüber. Wenn das Produktangebot des Wettbewerbers einen Anwendungsfall, ein Material und Rückgabebedingungen nennt und Ihres nicht, gewinnt der Wettbewerber. Deshalb lassen wir die Modelle jedes Produkt mit einem benannten Wettbewerber vergleichen und das Ergebnis in klarem Englisch erklären.
Position und Reihenfolge. Forschung zur Auswahl durch Agenten zeigt, dass Modelle davon beeinflusst werden können, an welcher Stelle ein Produkt in der Liste steht. Wenn Sie testen, randomisieren Sie die Reihenfolge der Optionen. Sonst messen Sie das Layout und nicht das Produkt.
Der Checkout selbst. Die Auswahl endet nicht mit der Entscheidung. In einem weiteren anonymen Audit erreichten die Agenten-Checkouts einer schwedischen Hautpflegemarke in 0 von 6 Ländern die Zahlung, weil eine Versandoption eine Telefonnummer verlangte. Ein Agent kann keine Telefonnummer erfinden – also scheiterte die Bestellung. Wenn Ihr Ziel Verkäufe sind und nicht nur ausgewählt zu werden, gehört der Checkout-Pfad zu den Produktdaten.
Mehr zu den Mechanismen hinter diesen Agenten erklärt wie KI-Einkaufsagenten Produkte empfehlen – inklusive der Frage, welche Daten sie lesen und in welcher Reihenfolge. Zur Optimierung von Produktangeboten siehe KI-Optimierung von Produktangeboten.
So lesen Sie Veränderungen der Quote richtig
Ihre Quote ist von 20 % auf 25 % gestiegen. Grund zur Freude oder nur Rauschen? Meistens Rauschen – bis das Gegenteil bewiesen ist.
Drei Gewohnheiten helfen. Erstens: ausreichend Stichproben. Wenn jedes Szenario nur einmal ausgeführt wurde, ist eine Schwankung von ein paar Punkten reiner Zufall. Führen Sie pro Modell viele unabhängige Durchläufe aus. Zweitens: Betrachten Sie die Größe der Veränderung und ihre mögliche Schwankung – nicht nur, ob sie „signifikant“ ist. Eine minimale Verschiebung mit großer Unsicherheit sagt nichts aus. Drittens: Verknüpfen Sie jeden Vergleich mit einer Modellversion. Wenn ein Anbieter sein Modell zwischen zwei Durchläufen aktualisiert hat, vergleichen Sie möglicherweise zwei unterschiedliche Käufer.
Wenn Sie tatsächlich etwas geändert haben – etwa 20 Titel umgeschrieben –, führen Sie dieselben festen Szenarien auf denselben Modellen erneut aus und vergleichen Sie nur diese Produkte. Wenn sich die bearbeiteten Produkte verändern und die übrigen nicht, haben Sie ein echtes Signal. Näher kommt ein Shopbetreiber einem kontrollierten Experiment kaum.
Unsere Sichtweise
Ich denke, dass die Auswahlquote in wenigen Jahren eine Standardkennzahl in E-Commerce-Reports sein wird. Und ich denke, die meisten Marken werden ihr zuerst auf die unangenehme Weise begegnen: indem sie feststellen, dass ihr Wert nahe null liegt.
Wir haben ecentic auf einer einfachen Überzeugung aufgebaut. Der Agent sieht nie Ihre Startseite. Er liest den Produktfeed, den Katalog und die strukturierten Daten. In Google AI Mode und Gemini in den USA kann er über UCP sogar für den Käufer den Kaufabschluss durchführen. Deshalb gehört die Arbeit in den Shop selbst – nicht in ein Dashboard, das nur Probleme meldet und sie dort liegen lässt.
Deshalb endet unser Prozess mit einer konkreten Aktion. Wir lassen ChatGPT, Claude und Gemini jedes Produkt mit dem eines benannten Wettbewerbers vergleichen, zeigen, warum Ihres verliert, und sobald Sie auf „Apply“ klicken, schreibt ecentic Titel, Beschreibung und strukturierte Daten neu und veröffentlicht sie in Ihrem Shop. In Shopify übertragen wir die Korrekturen in Google Merchant Center und verfolgen Besuche von KI-Assistenten. In WooCommerce ermöglicht das kostenlose ecentic-Plugin Agenten die Suche, das Befüllen eines Warenkorbs und den Kaufabschluss über UCP. Genau diesen Kaufabschluss unterstützen einfache Feed-Tools nicht.
Ich spreche offen über die Grenzen. Wir stehen noch am Anfang, wir führen Pilotprojekte durch, und unser erstes Projekt, DUA Flavours, verzeichnete von April bis Juli 2026 einen Anstieg der Besuche durch KI-Assistenten und des direkten Traffics um 12 %. Das ist eine Besuchskennzahl, keine Umsatzkennzahl, und ich sage das lieber klar, als mehr hineinlesen zu lassen.
OpenAI hat ACP, Google hat UCP, Amazon hat eine geschlossene Plattform. Wie sich das auch entwickelt: Der Shop mit sauberen, vollständigen Produktdaten wird der sein, bei dem ein Agent tatsächlich kaufen kann.
Xhurian Shaba
Finden Sie Ihre eigene Kennzahl
Der schnellste Weg herauszufinden, wo Sie stehen, ist ein Testlauf. ecentic hilft Onlineshops dabei zu verkaufen, wenn KI-Agenten einkaufen: Die Plattform optimiert Produktfeed und Katalog, damit KI-Einkaufsagenten ihre Produkte auswählen und kaufen können. Erzielen Sie Verkäufe, wenn KI den Einkauf übernimmt.
Der kostenlose Scan umfasst Ihre 10 wichtigsten Produkte und benötigt keine Karte. Wenn Sie die gefundenen Probleme beheben möchten, finden Sie die Tarife auf der ecentic-Preisseite: Compete kostet $14.90 pro Monat für bis zu 100 Produkte, Scale kostet $44.90 pro Monat für bis zu 1.000 Produkte inklusive One-Click-Korrekturen, und Dominate kostet $149 pro Monat und ergänzt die Synchronisierung mit Google Merchant Center sowie die Einrichtung von Agenten-Checkouts. Zusätzlich gibt es eine nutzungsbasierte Option mit 3 % der KI-attribuierten Bestellungen, gedeckelt auf $500 pro Monat.

Wenn Sie den Prozess vor der Registrierung sehen möchten, wie ecentic funktioniert führt Schritt für Schritt durch Simulation, Diagnose und Optimierung.
FAQ
Was ist eine gute KI-Auswahlquote?
Es gibt keinen glaubwürdigen universellen Benchmark, weil die Quote von Ihrer Kategorie, Ihren Wettbewerbern, den formulierten Szenarien und dem getesteten Modell abhängt. Ein sinnvolleres Ziel ist es, den benannten Wettbewerber zu übertreffen, gegen den Sie am häufigsten verlieren – auf jedem Assistenten einzeln – und zu beobachten, ob Ihr eigener Wert nach Datenkorrekturen steigt. Begegnen Sie jedem einzelnen „Branchendurchschnitt“ mit Skepsis.
Wie unterscheidet sich die KI-Auswahlquote von KI-Sichtbarkeit?
Sichtbarkeit bedeutet meist, dass Sie erwähnt oder gelistet werden. Auswahl bedeutet, dass der Agent Ihr Produkt gegenüber anderen Optionen bevorzugt hat. Eine Marke kann oft genannt werden und trotzdem bei der finalen Entscheidung verlieren. Deshalb liegt Auswahl deutlich näher an der Kaufentscheidung.
Wie oft sollte ich meine KI-Auswahlquote prüfen?
Prüfen Sie nach jeder Änderung und halten Sie die Szenarien zwischen den Durchläufen identisch. Modelle werden aktualisiert, deshalb sollten Sie jedes Ergebnis datieren und die Modellversion festhalten. Schwankungen von Woche zu Woche ohne Änderungen auf Ihrer Seite sind meist nur Rauschen.
Bedeutet eine höhere Auswahlquote automatisch mehr Verkäufe?
Nicht automatisch. Eine simulierte Auswahl testet, wie Agenten Ihre Daten lesen – sie ist kein Verkauf. Sie ist ein starker Frühindikator, aber Bestellungen hängen zusätzlich von Preis, Lieferung, Checkout und davon ab, ob der Käufer den Kauf abschließt. Messen Sie Referral-Besuche und Bestellungen getrennt.
Diese Themen entdecken