

Bei einem Audit von Produktinformationen für KI wird eine Produktseite strukturiert auf maschinenlesbare Signale geprüft. Das Ergebnis ist ein Score für ihre KI-Tauglichkeit und eine nach Priorität geordnete Liste von Korrekturen, die Sie in wenigen Minuten umsetzen können. Das Audit simuliert, wie KI-Einkaufsagenten wie ChatGPT, Gemini und Perplexity Ihre Produktseite lesen, und zeigt, was sie an einer Empfehlung hindern würde. In der Regel erhalten Sie einen Score von 0 bis 100, eine Aufschlüsselung nach Prüfbereichen und direkt einfügbare Korrekturen für strukturierte Daten. Jeder Händler mit einem Katalog auf Shopify, WooCommerce oder einem großen Marktplatz profitiert davon, ein solches Audit durchzuführen, bevor der Traffic-Bericht dieses Quartals vorliegt.
Kurzfassung:
- Ein KI-Produktseiten-Audit bewertet maschinenlesbare Signale wie strukturierte Daten und Kennungen, nicht nur Suchbegriffe, um die Sichtbarkeit in KI-gesteuerten Shopping-Antworten zu verbessern.
- Das Audit umfasst das Testen der gerenderten Seite nach dem Laden von JavaScript, die Bewertung anhand zentraler Säulen und die Bereitstellung einer priorisierten Korrekturliste mit direkt einfügbarem JSON-LD.
- Häufige Fehler sind fehlendes oder ungültiges Angebots-Markup, vage Titel, doppelte Kennungen, nicht belegte Aussagen sowie unzureichende Bilder oder Spezifikationen.
- Wenn Sie zuerst blockierende Fehler wie die JSON-LD-Validierung und Angebotsdaten beheben, sind große Score-Steigerungen und mehr Sichtbarkeit in Empfehlungen möglich.
- Simulationsbasierte Audits testen Produktangebote gegen tatsächliche KI-Einkaufsagenten wie ChatGPT und Gemini und liefern plattformspezifische Erkenntnisse sowie laufendes Tracking der Traffic-Auswirkungen.
Was ist ein KI-Audit für Produktangebote – und was macht es anders?
Ein SEO-Audit auf Keyword-Basis prüft, ob ein Mensch Ihren Titel in den Suchergebnissen anklicken würde. Ein KI-Audit für Produktangebote prüft, ob ein Einkaufsagent die Seite überhaupt verstehen, ihr vertrauen und sie empfehlen kann. Das ist eine andere Aufgabe. Agenten überfliegen Inhalte nicht, sondern analysieren strukturierte Daten, gleichen Angebotsdetails ab und suchen nach belastbaren Aussagen, die sie ohne Risiko einer falschen Halluzination wiedergeben können.
Der zentrale Wandel geht hin zu maschinenlesbaren Signalen: Product JSON-LD, Offer-Markup und stabile Kennungen wie GTIN, SKU und MPN. Ein Produktangebot mit starkem Hero-Bild, aber ohne strukturierte Daten kann bei Google gut ranken und trotzdem von einem Agenten übersprungen werden, der Preis, Verfügbarkeit oder sogar die eigentliche Produktidentität nicht bestätigen kann.
Der geschäftliche Nutzen ist konkret:
- Mehr Sichtbarkeit in KI-gesteuerten Shopping-Antworten, nicht nur in der organischen Suche
- Weniger Retouren, weil Produktangebote mit klaren Angaben zu Größe, Material und Kompatibilität Fehlannahmen beim Kauf reduzieren
- Bessere Conversion auf der Produktseite, weil Bullet Points mit Kaufabsicht die Fragen beantworten, die Kaufentscheidungen ausbremsen
Wie funktioniert ein Audit für Produktangebote?
Die meisten Audits folgen demselben Grundablauf, aber die Details sind wichtiger, als es Marketingtexte vermuten lassen.
- Die gerenderte Seite scannen, nicht nur das statische HTML. Dieser Unterschied bringt mehr Händler zu Fall als alles andere. Viele KI-Crawler lesen zunächst die HTML-Antwort, bevor JavaScript ausgeführt wird. Wenn Ihr JSON-LD oder wichtige Spezifikationen erst clientseitig geladen werden, sieht ein Agent sie möglicherweise überhaupt nicht.
- Nach festen Säulen bewerten. Produktidentität, Vollständigkeit des Angebots, strukturierte Daten, Medien und Varianten sowie die Nachvollziehbarkeit von Aussagen werden jeweils bewertet und zu einer gesamten Readiness-Bewertung.
- Kritische Fehler von optionalen Verbesserungen trennen. Ein fehlender Offer-Preis hat nicht dieselbe Schwere wie ein etwas generischer Bullet Point.
- Eine priorisierte Liste mit Korrekturen bereitstellen, idealerweise mit direkt einfügbarem JSON-LD statt einer vagen Anweisung wie „strukturierte Daten hinzufügen“.
- Das Audit nach der Umsetzung erneut ausführen um zu prüfen, ob sich die Bewertung verbessert hat und keine neuen Fehler entstanden sind.
Die besten Audits belegen jede Markierung mit konkreten Nachweisen statt mit generierten Vermutungen. Ein Tool, das die exakt fehlgeschlagene Regel nennt, statt nur zu behaupten „Ihre Beschreibung ist schwach“, gibt Ihrem Team etwas, das sich tatsächlich prüfen und sicher beheben lässt.
Profi-Tipp: Vergleichen Sie Ihr gerendertes DOM mit der rohen HTML-Antwort, bevor Sie Ihre Texte verantwortlich machen. Wenn Ihr JSON-LD erst nach dem Ausführen von JavaScript erscheint, wird keine Umschreibung Ihre KI-Sichtbarkeit verbessern.
Was prüft ein KI-Audit auf einer Produktseite?
Die Checkliste teilt sich in Inhaltsfelder und maschinenlesbare Elemente auf – und beide sind gleichermaßen wichtig.
Inhaltsfelder:
- Klarheit des Titels und ob der Produkttyp zuerst genannt wird, nicht nur die Marke
- Bullet Points, die echte Käuferfragen beantworten (Größe, Kompatibilität, Lieferumfang), statt nur Funktionen zu wiederholen
- Tiefe der Beschreibung und ob sie die Bullet Points wortwörtlich dupliziert
- A+- oder Enhanced-Content-Blöcke, sofern die Plattform sie unterstützt
Strukturierte Daten und Kennungen:
- Gültiges Product JSON-LD ohne fehlende Pflichtfelder
- Offer-Markup mit Preis, Währung und Verfügbarkeit
- Kennungen wie GTIN, SKU und MPN, geprüft auf Duplikate im eigenen Katalog
Medien, Varianten und Aussagen:
- Anzahl der Bilder und ob variantspezifische Bilder für Farb- oder Größenoptionen vorhanden sind
- Kanonisierung, damit doppelte oder nahezu identische Produktangebote Ihre Signale nicht aufteilen
- Nachvollziehbarkeit von Aussagen – also ob konkrete Aussagen („wasserdicht“, „klinisch getestet“) irgendwo auf der Seite belegt sind, sodass ein Agent darauf verweisen kann
Open-Source-Linter für Produktangebote haben gezeigt, dass Prüfungen zu Titellänge, Bildanzahl und Größenangaben direkt mit dem Retourenrisiko zusammenhängen. Deshalb geht diese Checkliste über reine Auffindbarkeit hinaus und umfasst auch Signale zur Produktqualität.
Wie funktioniert die Readiness-Bewertung von 0 bis 100?
Das Bewertungsmodell der meisten Audits vergibt gewichtete Punkte über mehrere Säulen hinweg und setzt anschließend eine Obergrenze, wenn ein kritischer Fehler vorliegt. Eine Bewertung von 0 bis 100 mit Aufschlüsselung pro Säule ist üblich – und genau diese Deckelung unterschätzen viele Händler.
In der Praxis bedeutet das:
- Ein Produktangebot kann bei der Inhaltsqualität 85 Punkte erreichen und insgesamt trotzdem bei 40 gedeckelt sein, wenn das Offer-Markup komplett fehlt
- Kritische Fehler (ungültiges JSON-LD, fehlende Preisdaten, doppelte Kennungen) verhindern, dass ein Agent das Produkt überhaupt sicher anzeigen kann
- Kleinere Mängel (eine etwas zu kurze Beschreibung, ein fehlendes Lifestyle-Bild) reduzieren die Bewertung, blockieren aber keine Empfehlung
Priorisieren Sie nach Wirkung pro Aufwand: Ein fehlendes Offer-Feld zu korrigieren, das 20 Punkte freischaltet, bringt mehr als fünf Bullet Points für einen Zugewinn von 3 Punkten umzuschreiben. Kritische Fehler immer zuerst beheben.
Welche Fehler finden KI-Audits am häufigsten?
Dieselben wenigen Fehler tauchen in fast jedem Katalog auf – unabhängig von Kategorie oder Plattform.
- Fehlendes oder ungültiges Offer-Markup. Preis und Verfügbarkeit sind nicht in einem Format angegeben, das ein Agent verarbeiten kann, obwohl sie für menschliche Käufer sichtbar sind.
- Vage Titel, die nur Funktionen nennen. „Premium Wireless Earbuds“ sagt einem Agenten nichts über Passform, Einsatzzweck oder darüber, was dieses Modell von zehntausend anderen unterscheidet.
- Bullet Points, die den Titel wiederholen statt Fragen zu beantworten. Käufer wollen wissen, was im Karton enthalten ist – nicht, dass das Produkt „robust und stilvoll“ ist.
- Zu wenige Bilder oder fehlende Variantenfotos. Nur eine Perspektive, kein Größenvergleich, keine farbspezifischen Bilder bei einem Produkt mit sechs Farboptionen.
- Unbelegte Aussagen. „Hypoallergen“, ohne dass die Seite oder verlinkte Dokumente dies belegen.
- Fehlende Spezifikationen, die Retouren verursachen. Keine Größentabelle, keine Materialangaben, keine Kompatibilitätsliste – Käufer müssen raten und liegen dabei oft falsch.
Profi-Tipp: Wenn sich die Retourenquote einer SKU auf viele unterschiedliche Gründe verteilt, wird eine reine Überarbeitung des Produktangebots das Problem wahrscheinlich nicht lösen. Entropiebasierte Prüfungen der Behebbarkeit können erkennen, wenn die Ursache an anderer Stelle in der Lieferkette liegt und nicht am Seitentext.
Wie beheben Sie Probleme, die ein KI-Audit findet?
Arbeiten Sie die Korrekturen nach Schwere der Blockierung ab, nicht nach ihrer Position auf der Seite.
- Zuerst ein Audit für eine einzelne SKU durchführen und die priorisierte Korrekturliste exportieren. Scannen Sie nicht Ihren gesamten Katalog, bevor Sie wissen, wie ein einzelner Korrekturzyklus aussieht.
- Kritische Fehler sofort beheben. Dazu gehören ungültiges oder fehlendes Product JSON-LD, unvollständiges Offer-Markup und doppelte Kennungen über Varianten hinweg.
- Bullet Points und Beschreibung so umschreiben, dass sie echte Käuferfragen beantworten. Größe, Kompatibilität, Lieferumfang und Nutzung – in dieser Prioritätsreihenfolge für die meisten Produktkategorien.
- Bilder und Alt-Text aktualisieren. Ein Bild mit Größenvergleich und ein Bild pro relevanter Variante hinzufügen, nicht nur pro Farbmuster.
- Den JSON-LD-Patch auf Ihrer Live-Seite veröffentlichen. Die meisten Audits erzeugen dafür ein direkt einfügbares Snippet, sodass kein manuelles Codieren des Schema-Markups nötig ist.
- Das Audit erneut ausführen um zu prüfen, ob sich die Bewertung verbessert hat und durch die Änderung keine neuen Probleme entstanden sind.
- KI-zugeordneten Traffic und Conversion zwei bis vier Wochen lang verfolgen bevor Sie die Korrektur als erfolgreich bewerten oder zur nächsten SKU wechseln.
Diese Reihenfolge ist wichtiger als jede einzelne Korrektur. Ein Händler, der fünf Produktbeschreibungen umschreibt, aber fehlerhaftes Offer-Markup bestehen lässt, wird kaum Veränderungen bei der Bewertung sehen, weil die Blockierungsgrenze unabhängig von der Qualität der Texte bestehen bleibt.
Vorher und nachher: Ein schwaches Produktangebot vs. ein KI-fähiges
Ein typisches schwaches Produktangebot sieht etwa so aus: Titel: „Yoga-Matte – rutschfest.“ Bullet Points: „Robust. Bequem. Ideal für Home-Workouts.“ Dieser Titel sagt einem Agenten nichts über Größe, Dicke oder Material, und die Bullet Points bestehen aus Adjektiven ohne Substanz. Ein Audit würde einen generischen Titel, funktionsorientierte Bullet Points ohne Bezug zur Kaufabsicht und wahrscheinlich fehlende Maßangaben in den strukturierten Inhalten markieren.
Die optimierte Überarbeitung behebt jede Markierung einzeln:
- Titel: „6 mm dicke rutschfeste Yoga-Matte, 72x24 Zoll, TPE-Material, inklusive Tragegurt“
- Bullet Points: Exakte Dicke angeben und erklären, wie sie den Gelenkkomfort beeinflusst, die genauen Maße im Verhältnis zu durchschnittlichen Körpergrößen bestätigen, das Material nennen und erläutern, warum es besseren Halt bietet als PVC, sowie den Lieferumfang aufführen
- Strukturierte Daten: Gültiges JSON-LD mit GTIN, korrektem Offer-Preis und Verfügbarkeitsstatus
Jede Änderung erfüllt zwei Aufgaben gleichzeitig. Käufer erhalten die konkrete Antwort, nach der sie gesucht haben, und der Agent erhält eine Tatsache, die er wiedergeben kann, ohne etwas zu erfinden. Genau diese Überschneidung verbessert gleichzeitig die KI-Readiness und die menschliche Conversion.
Warum simulationsgestützte Audits Ihnen einen Vorteil verschaffen
Regelbasierte Prüfungen erkennen fehlende Felder. Simulationsgestützte Audits gehen einen Schritt weiter, indem sie Ihr Produktangebot tatsächlich durch das Modellverhalten von ChatGPT, Gemini und Perplexity laufen lassen und anschließend berichten, zu welchem Ergebnis jeder Agent gekommen ist und warum.
Dieser Unterschied zeigt sich im Ergebnis. Statt „Ihr JSON-LD enthält ein fehlendes Feld“ kann ein simulationsbasierter Bericht sagen, dass ein Agent Ihr Produkt zugunsten eines Wettbewerbers übersprungen hat, weil er die Materialzusammensetzung nicht bestätigen konnte. ecentic führt diese Art von Audit durch, indem es sich direkt mit Ihrem Shopify- oder WooCommerce-Shop verbindet.
Was diese Verbindung liefert:
- Plattformbezogene Empfehlungen, abgestimmt darauf, wie einzelne Agenten Produktangebote tatsächlich bewerten – nicht nur eine generische Checkliste
- Direkt einfügbares JSON-LD und eine priorisierte Korrekturliste, erstellt aus Ihren Live-Katalogdaten
- Fortlaufendes Tracking agentengesteuerter Besuche, damit Sie sehen können, ob eine Korrektur tatsächlich Wirkung zeigt
Nutzer solcher Plattformen berichten nach Umsetzung der empfohlenen Korrekturen von steigenden KI-gesteuerten Besuchen und nachgelagerten Verkäufen. Wenn Sie sehen möchten, wie Ihr eigener Katalog abschneidet, können Sie im UCP Playground einen Live-Shop anhand echter Agentensimulationen testen, bevor Sie sich festlegen.
— Xhurian
Audits im großen Umfang durchführen: Was tatsächlich funktioniert
Audits für einzelne SKUs sollten immer manuell geprüft werden, sobald Sie eine Produktseite veröffentlichen oder wesentlich ändern. Vollständige Katalog-Scans folgen einem anderen Rhythmus: monatlich bei stabilem Bestand, wöchentlich, wenn Sie schnell an einer neuen Produktlinie arbeiten.
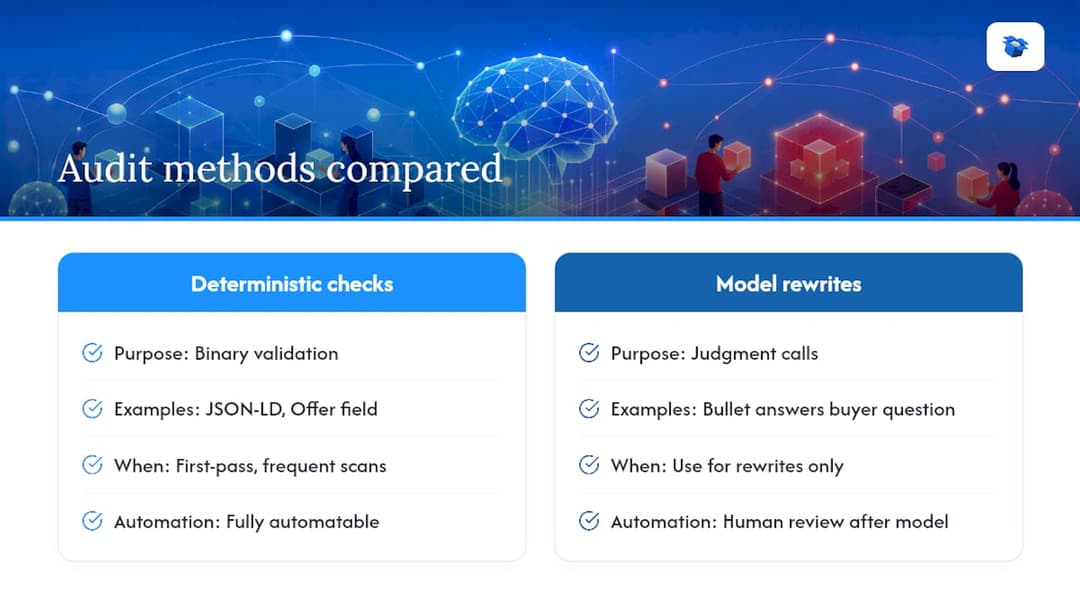
Verlassen Sie sich bei allem Binären auf deterministische Regelprüfungen – etwa ob JSON-LD validiert oder ein Offer-Feld vorhanden ist. Modellgestützte Überarbeitungen sollten Sie für Ermessensfragen nutzen, zum Beispiel ob ein Bullet Point tatsächlich eine reale Käuferfrage beantwortet. Die Automatisierung dieser ersten Prüfphase reduziert den manuellen QA-Aufwand erheblich in Katalogen mit hohem Volumen und gibt Ihrem Team mehr Zeit für Korrekturen, die echtes Urteilsvermögen erfordern.
Eine operative Regel würde ich konsequent beibehalten: Testen Sie Korrekturen zuerst an einer kleinen Stichprobe, bevor Sie sie im gesamten Katalog ausrollen, und verfolgen Sie Retouren zusammen mit der Bewertungsentwicklung – nicht nur die Bewertung selbst.
Wie ecentic Audit-Ergebnisse in echte Verkäufe verwandelt
Ein Audit zeigt Ihnen, was fehlerhaft ist. Die manuelle Behebung in einem wachsenden Katalog ist der Punkt, an dem die meisten Teams ins Stocken geraten – und an dem generische Checklisten-Tools an ihre Grenzen stoßen. ecentic schließt diese Lücke, indem es sich direkt mit Ihrem Shopify- oder WooCommerce-Shop verbindet, simuliert, wie ChatGPT, Gemini, Claude und Perplexity Ihre Produktangebote tatsächlich bewerten, und direkt einfügbares JSON-LD zusammen mit einer priorisierten Korrekturliste erstellt, die Sie noch am selben Tag umsetzen können.

Der kostenlose Scan im UCP Playground zeigt Ihnen genau, wie Ihre aktuellen Produktangebote in Live-Agentensimulationen abschneiden – ohne Login und ohne Katalogmigration. Anschließend verfolgen die kontinuierlichen Rescans von ecentic, ob Ihre Korrekturen tatsächlich KI-zugeordneten Traffic und Conversion verbessern, sodass Sie echte Auswirkungen messen, statt nur zu vermuten, ob eine Änderung geholfen hat. Wenn Sie sehen möchten, wo Ihr Katalog aktuell steht, führen Sie noch heute einen kostenlosen Scan durch und erhalten Sie Ihre erste Readiness-Bewertung.
FAQ
Kann KI ein Produktangebot tatsächlich auditieren?
Ja. Tools wie CatalogReady simulieren, wie KI-Einkaufsagenten eine Seite analysieren, und wenden deterministische Regeln an, um eine belegbare Readiness-Bewertung zu erzeugen – keine generische Vermutung.
Was kostet ein KI-Audit für Produktangebote?
Die Preise unterscheiden sich je nach Anbieter, aber das übliche Modell besteht aus einem kostenlosen Scan für eine einzelne SKU oder einem Einstiegsscan, gefolgt von kostenpflichtigen Monatsplänen, die mit Kataloggröße und Überwachungsfrequenz skalieren. ecentic bietet einen kostenlosen Scan vor jedem kostenpflichtigen Tarif an.
Welche KI-Tools eignen sich am besten für ein Audit von Produktangeboten?
Die stärksten Lösungen kombinieren deterministische Prüfungen (strukturierte Daten, Vollständigkeit des Angebots) mit Simulationen des tatsächlichen Verhaltens von Einkaufsagenten. Simulationsgestützte Plattformen wie ecentic gehen noch weiter, indem sie Produktangebote anhand realer Agentenantworten von ChatGPT, Gemini und Perplexity testen, statt sich nur auf statische Regeln zu verlassen.
Ist ein kostenloses öffentliches Audit genauso gut wie ein Scan auf Kontoebene?
Nein. Kostenlose öffentliche Audits lesen nur die Daten aus, die auf der Live-Seite sichtbar sind, während Scans auf Kontoebene einen Login-Zugang erfordern und tiefere Katalogmetriken freischalten wie historische Leistungsdaten und Massenprüfungen von Kennungen.
Wie lange dauert ein KI-Audit für Produktangebote?
Ein Audit für eine einzelne SKU ist in der Regel innerhalb weniger Minuten abgeschlossen, da nur eine gerenderte Seite anhand eines festen Regelwerks geprüft wird. Vollständige Katalog-Scans dauern je nach Anzahl der SKUs länger, aber die meisten Händler erhalten ihre priorisierte Korrekturliste noch am selben Tag.