

Agentengesteuerte Traffic-Analytics erfasst, klassifiziert und attribuiert Anfragen von nicht menschlichen Akteuren und misst dann die Aufgaben, die diese Agenten im Auftrag menschlicher Auftraggeber erledigen. Dabei ersetzt sie die Session als Maßeinheit durch ein einfacheres Modell: Akteur, Aufgabe, Ergebnis.
Wenn Ihre Dashboards für „Bot-Traffic“ noch immer eine flache Linie anzeigen, während der Anteil der Besuche durch KI-Agenten wächst und keine Conversion-Daten daran hängen, messen Sie nicht, was auf Ihrer Website tatsächlich passiert. Einkaufsagenten von ChatGPT, Gemini und Perplexity lesen Produktseiten, vergleichen Spezifikationen und geben Kaufempfehlungen an Käufer weiter, die selbst nie über den sichtbaren Bereich hinaus scrollen. Ihr Analytics-Stack weiß davon wahrscheinlich nichts.
Drei Maßnahmen beseitigen die größten blinden Flecken schnell:
- Aktivieren Sie die Weiterleitung von CDN- oder Edge-Logs, damit Sie Anfragen erfassen, die nie einen Browser laden oder ein JavaScript-Tag auslösen.
- Fügen Sie eine
actor-Eigenschaft hinzu, die als human, agent oder crawler gekennzeichnet wird, bevor die Daten überhaupt ein Dashboard erreichen. - Leiten Sie diese Logs in ein Data Warehouse statt in ein clientseitiges Tool, damit Sie Agentenereignisse im Zeitverlauf mit Ergebnissen verknüpfen können.
Agenten lesen Inhalte oft lange vor einem Kauf und informieren Käufer vorab, die dann bereits mit einer Entscheidung ankommen. Den daraus entstehenden Umsatz ordnet Ihr bestehendes Analytics-Setup derzeit entweder „direct“ zu oder erfasst ihn gar nicht.
Wichtigste Erkenntnisse
Agentengesteuerte Traffic-Analytics funktioniert, wenn Teams Session-Kennzahlen durch ein Modell aus Akteur, Aufgabe und Ergebnis ersetzen, das durch serverseitige Erfassung und identitätsverknüpfte Logs gestützt wird.
| Punkt | Details |
|---|---|
| Zuerst am Edge erfassen | Die Weiterleitung von CDN- und Edge-Logs erfasst den Großteil der Agentenanfragen, die clientseitiges JavaScript vollständig umgehen. |
| Session-Kennzahlen für Agenten abschaffen | Absprungrate und Scrolltiefe sind für nicht menschliche Akteure bedeutungslos; verwenden Sie stattdessen Akteur, Aufgabe und Ergebnis. |
| Aufgabenerfüllung statt Seitenaufrufe ausweisen | Definieren Sie Erfolgskriterien für Abruf, Formularablauf und Integrationen, bevor Sie überhaupt eine Kennzahl zur Aufgabenerfüllung berichten. |
| Die Attributionslücke gezielt schließen | Canary-Protokolle und unveränderliche, identitätsverknüpfte Logs verringern rechtliche und prüfungsbezogene Risiken durch nicht autorisierte Agentenaktionen. |
| Optimieren Sie, was Agenten tatsächlich lesen | Ecentic simuliert Bewertungen von KI-Einkaufsagenten auf Produktseiten und zeigt die konkreten Faktoren auf, die Empfehlungen fördern oder verhindern. |
Was agentengesteuerter Traffic ist und warum Sitzungsmetriken versagen
Heute greifen drei Arten von Akteuren auf Ihre Server zu, und sie verhalten sich völlig unterschiedlich. Ein Mensch surft interaktiv – mit Pausen, Scrollen und Mausbewegungen. Ein Crawler indiziert Inhalte für einen Datenbestand, meist ohne Interesse an einer konkreten Aufgabe. Ein Agent handelt im Auftrag einer Person, ruft eine Seite ab, extrahiert Daten und erledigt oft Aufgaben wie Vergleiche oder einen Kaufschritt, ohne die Seite jemals visuell darzustellen.
Standard-Webmetriken gehen davon aus, dass auf der anderen Seite ein Mensch sitzt. Bei Agenten trifft diese Annahme sofort nicht mehr zu.
- Absprungrate bedeutet nichts, wenn ein Agent eine einzelne Seite abruft, den Preis und die Spezifikationstabelle extrahiert und wieder verschwindet. Das ist eine abgeschlossene Aufgabe, kein abgebrochener Besuch.
- Verweildauer auf der Seite lässt sich nicht auf eine Anfrage anwenden, die in Millisekunden abgeschlossen ist, weil nichts gerendert, gelesen oder gescrollt wird.
- Scrolltiefe setzt ein sichtbares Fenster voraus. Headless-Agenten, die rohe HTTP-Aufrufe ausführen, erzeugen nie eines.
Die Lösung ist ein völlig anderes Denkmodell: Akteur, Aufgabe, Ergebnis. Sie klassifizieren, wer die Anfrage gestellt hat, definieren, was erreicht werden sollte, und erfassen, ob das Ziel erreicht wurde. Dieses Modell funktioniert unabhängig davon, ob der Akteur ein Käufer, ein Crawler oder ein autonomer Agent ist, der fünf Wettbewerber vergleicht, bevor er einem Käufer ein Produkt empfiehlt.
Wie Erkennung und Erfassung von Agenten tatsächlich funktionieren
Der Großteil der Agentenaktivität bleibt für die Tools unsichtbar, auf die Marketingteams bereits vertrauen. Das ist der unbequeme Teil. Google Analytics, Adobe-Analytics-Tags und die meisten Tag-Manager-Setups hängen davon ab, dass JavaScript im Browser ausgeführt wird. Agenten-Traffic überspringt diesen Schritt jedoch zunehmend vollständig.
Serverseitige und Edge-basierte Erfassung ist das, was diesen Traffic tatsächlich erkennt. Telemetriedaten von Anbietern zeigen, dass rund 59 % des ChatGPT-Agenten-Traffics über rohe HTTP-Clients eingehen, die niemals ein Skript ausführen. Das bedeutet: Clientseitige Analytics-Tools übersehen konstruktionsbedingt mehr als die Hälfte der Aktivitäten – nicht versehentlich. Wenn Ihre gesamte Instrumentierung in einem Tag-Manager steckt, messen Sie nur einen schrumpfenden Teil dessen, was tatsächlich passiert.
CDN- und Edge-Logs lösen dieses Problem, weil sie jede Anfrage erfassen, die Ihre Infrastruktur erreicht – unabhängig davon, ob ein Browser jemals ein Pixel rendert. Auf dieser Ebene beginnt die Analyse von Traffic durch KI-Agenten tatsächlich.
Sobald Sie rohe Logs analysieren, trennen einige wenige Signale Agenten zuverlässig von Menschen und generischen Bots:
- Deklarierte User-Agent-Strings. Viele Agenten identifizieren sich zumindest derzeit noch ehrlich – mit Strings, die auf das Modell oder die Plattform hinter der Anfrage verweisen.
- Verhältnis von Assets zu Anfragen. Ein Mensch, der eine Seite lädt, ruft Dutzende Bilder, Schriftarten und Skripte ab. Ein Agent, der strukturierte Daten extrahiert, fordert oft nur das HTML oder eine JSON-Payload an.
- Fehlende Beacons. Wenn auf Serverebene eindeutig ein Seitenaufruf stattgefunden hat, aber kein Analytics-Pixel ausgelöst wurde, ist das selbst ein Signal.
- Header- und Timing-Muster. Agenten fordern Seiten typischerweise mit Maschinengeschwindigkeit an – mit Header-Reihenfolgen und zeitlicher Entropie, die sich vom üblichen Browserverhalten unterscheiden.
- llms.txt und strukturierte Assets. Immer mehr Websites veröffentlichen inzwischen eine llms.txt-Datei zusammen mit OpenAPI-Schemas und geben Agenten (und Ihren Logs) damit eine dokumentierte, deklarierte Schnittstelle, anhand derer Anfragen geprüft werden können.
Die Validierung deklarierter Modell-IP-Bereiche oder der Abgleich von Request-Strings mit veröffentlichter Anbieterdokumentation schafft zusätzliche Sicherheit – auch wenn das allein nie vollkommen zuverlässig ist.
Profi-Tipp: Verlassen Sie sich nicht nur auf User-Agent-Strings. Kombinieren Sie sie mit einer Bewertung des Asset-Verhältnisses, damit auch ein gefälschter String erkannt wird, wenn das Anfrageverhalten nicht zu einer echten Browser-Sitzung passt.
Wichtige Kennzahlen, die den Einfluss von Agenten wirklich zeigen
Wenn Sie Agenten-Traffic anhand von Seitenaufrufen und Sitzungen auswerten, erhalten Stakeholder Zahlen, die aus den falschen Gründen beeindruckend oder alarmierend wirken. Relevante Kennzahlen messen Anfragen, Aufgaben und Geschäftsergebnisse – nicht Besuche.
| Kennzahl | Was sie zeigt |
|---|---|
| Anteil von Agenten an allen Anfragen | Prozentualer Anteil aller Anfragen nach Seite und Modell – zeigt, welche Seiten Agenten tatsächlich lesen |
| Abschlussrate von Aufgaben | Ob das Abrufen, ein Formularablauf oder ein Integrationsaufruf eines Agenten erfolgreich abgeschlossen wurde |
| Übergaberate von Agent zu Mensch | Wie häufig eine Agentensitzung zu einem menschlichen Folgeaufruf oder Kauf führt |
| Blockierungs-/Fehlerrate nach Akteur | Wie oft Agenten im Vergleich zu Menschen gedrosselt, blockiert oder mit Fehlern bedient werden |
| Betriebskosten pro Modell | Token-Nutzung, Latenz und Fehlerrate pro Modell, das auf Ihre Infrastruktur zugreift |
Bevor Sie die Abschlussrate von Aufgaben messen können, brauchen Sie eine klare Definition. Eine Abrufaufgabe ist erfolgreich, wenn ein Agent die gewünschten Daten extrahiert, etwa Preis oder Verfügbarkeit. Eine Formularablauf-Aufgabe ist erfolgreich, wenn ein mehrstufiger Prozess wie das Hinzufügen zum Warenkorb ohne Fehler abgeschlossen wird. Eine Integrationsaufgabe ist erfolgreich, wenn ein API-ähnlicher Aufruf eine gültige, nutzbare Antwort zurückgibt. Definieren Sie diese Kriterien im Voraus – sonst ist die Kennzahl bedeutungsloses Rauschen.
Agentengestützte Conversions verdienen eine eigene Zeile in jedem Bericht. Leitfäden, die dies korrekt erfassen, zeigen, dass agentenvermittelter Traffic deutlich höhere Conversion-Raten erzielen kann als generischer organischer Traffic – wenn er sauber isoliert und gemessen wird, statt in einem undifferenzierten „Sonstige“-Bucket zu verschwinden. Diese Zahl interessiert einen CFO, nicht das rohe Anfragevolumen.
- Weisen Sie den Anteil von Agenten nach einzelnen Modellen aus – nicht nur als aggregierte „Bot“-Kategorie.
- Berichten Sie Abschlussrate und Übergaberate gemeinsam. Ohne die jeweils andere Kennzahl bleibt verborgen, ob Agenten-Traffic tatsächlich etwas Nützliches bewirkt.
- Verfolgen Sie Blockierungs- und Fehlerraten getrennt von menschlichen Fehlerraten. Ein Anstieg deutet hier oft auf eine falsch konfigurierte Firewall-Regel hin, nicht auf bösartigen Traffic.
Die Pipeline aufbauen: Schema, Tagging und Speicherung
Die Bereitstellung von Traffic-Analysen für KI-Agenten ist zunächst vor allem ein Infrastrukturproblem – erst danach ein Analyseproblem. Diese Reihenfolge funktioniert in der Praxis.
- Aktivieren Sie zuerst die Weiterleitung von CDN-Logs. Erfassen Sie Felder wie Zeitstempel, vollständigen User-Agent-String, Request-Pfad, Antwortcode, Byte-Größe und alle TLS-Fingerprint-Daten, die Ihr CDN bereitstellt.
- Fügen Sie
actorundactor_nameEigenschaften bereits bei der Aufnahme hinzu. Jedes Ereignis wird vor dem Speichern in einer Tabelle als Mensch, Agent oder Crawler gekennzeichnet und – sofern identifizierbar – zusätzlich mit einem konkreten Namen versehen, etwa einem Modell- oder Plattform-String. - Nutzen Sie mehrstufige Klassifizierungslogik. Beginnen Sie mit dem deklarierten User-Agent, gleichen Sie ihn mit Verhaltenssignalen wie Asset-Verhältnis und Timing ab und bestätigen Sie ihn anschließend – falls vorhanden – über Auth-Tokens oder API-Schlüssel. Kein einzelnes Signal sollte die gesamte Entscheidung tragen.
- Verknüpfen Sie Agentenereignisse nach Möglichkeit mit menschlichen Identitäten. Auth-Tokens, Session-Cookies und Korrelations-IDs ermöglichen es, die Abrufaufgabe eines Agenten mit der Person zu verknüpfen, die ihn eingesetzt hat. So schließen Sie die Lücke zwischen „ein Agent hat die Seite besucht“ und „der Agent dieses Kunden hat die Seite besucht“.
- Leiten Sie alles in ein Data Warehouse– nicht nur in ein Dashboard-Tool. Die Agent-Analytics-Pipeline von BigQuery streamt rohe Interaktionsereignisse über die Storage Write API und unterstützt die nachträgliche Rekonstruktion von Traces. Das ist entscheidend, wenn Sie drei Wochen später nachvollziehen müssen, was ein Agent tatsächlich getan hat.
- Staffeln Sie Ihre Speicherung. Bewahren Sie rohe, granulare Logs für ein definiertes Prüfungsfenster auf und sampeln oder aggregieren Sie ältere Daten anschließend. Dauerhafte Speicherung in voller Detailtiefe wird schnell zum Kostenproblem, und die meisten Prüfungen benötigen ohnehin nur ein aktuelles Zeitfenster.
Profi-Tipp: Legen Sie Ihr Aufbewahrungsfenster für Prüfungen anhand Ihres längsten realistischen Streit- oder Compliance-Zyklus fest – nicht anhand willkürlicher 30 oder 90 Tage. Wenn eine Rückbuchung oder regulatorische Anfrage erst sechs Monate später auftauchen kann, müssen Ihre Traces entsprechend lange verfügbar bleiben.
Die Attributionslücke schließen
Zu wissen, dass ein Agent Ihre Website besucht hat, ist das eine. Nachzuweisen, welcher Mensch oder welche Organisation diesen Agenten eingesetzt hat, ist deutlich schwieriger – und genau das raubt Compliance-Teams den Schlaf.
Die Attributionslücke entsteht, weil die meisten Unternehmen zwar protokollieren können, dass ein Agent gehandelt hat, aber nicht nachweisen können, welcher Mensch diese Handlung autorisiert hat. Diese Lücke wird sofort zu einem realen rechtlichen und regulatorischen Risiko, sobald ein Agent etwas tut, von dem sich ein Unternehmen später distanzieren oder das es verteidigen muss.
Das ist die zentrale Erkenntnis hinter Oktas Analyse von KI-Compliance-Risiken– und sie betrifft direkt jedes Team, das Traffic-Analysen für KI-Agenten zu Prüfungszwecken aufbaut, nicht nur Sicherheitsteams.
Eine praktische Gegenmaßnahme, die zunehmend Verbreitung findet, ist das Canary-Protokoll: ein vermittlergestützter Ansatz, bei dem Agenteninteraktionen einen nachvollziehbaren Marker zurück zum Ursprungskonto tragen. Untersuchungen zu diesem Ansatz über Web-, Kommunikations- und Cyber-Agenten hinweg zeigen, dass sich beobachtetes Verhalten in nicht-konfrontativen Szenarien zuverlässig einem Ursprungskonto zuordnen lässt. Gleichzeitig ist realistisch zu erwarten, dass Lücken entstehen, sobald Akteure aktiv versuchen, die Erkennung zu umgehen.
Einige operative Gewohnheiten schließen den Großteil der verbleibenden Lücke:
- Behandeln Sie Agenten-Logs als unveränderliche Aufzeichnungen und nicht als Daten, die früh überschrieben oder komprimiert werden.
- Verknüpfen Sie jedes Agentenereignis mit einer Identität, wenn dies über Token, Cookies oder API-Schlüssel möglich ist.
- Schaffen Sie einen festen Abstimmungspunkt zwischen Sicherheit, Recht und Ihren Plattformanbietern, bevor ein Vorfall diese Gespräche erzwingt.
Tools und Dashboard-Muster, die funktionieren
Sie müssen nicht jeden Teil davon von Grund auf neu entwickeln. Einige konkrete Tools decken bereits den Großteil der Pipeline ab.
- BigQuery Agent Analytics übernimmt die gesamte Pipeline von der Erfassung bis zur Analyse: rohe Ereignisse streamen, Traces rekonstruieren und programmgesteuerte Auswertungen des Agentenverhaltens im großen Maßstab durchführen. Das wird relevant, sobald Sie über einige Tausend Agentenanfragen pro Tag hinauskommen.
- Adobes Agentic-Traffic-Dashboard liefert Ihnen eine vorkonfigurierte Ansicht, sobald die Weiterleitung von CDN-Logs eingerichtet ist – mit Filtern für Traffic-Verteilung, Trendlinien sowie stärkste Gewinner und Verlierer über Märkte, Kategorien und einzelne Agenten hinweg.
- Tag-basierte Tools wie GA4 haben weiterhin ihren Platz bei der Messung menschlichen Verhaltens, unterschätzen Agentenaktivität aber systematisch, weil ein großer Teil davon niemals ein clientseitiges Tag auslöst. Ein bewährtes Muster ist GA4 mit serverseitiger Erfassung zu kombinieren statt es vollständig zu ersetzen. So bleiben Berichte zum menschlichen Verhalten erhalten, während Sie zusätzlich die Agentenebene erfassen.
- Dashboards von Anbietern sind tatsächlich nützlich, um Trends zu überwachen. Sie ersetzen jedoch kein Warehouse-basiertes Trace-Modell, wenn Sie reproduzierbare Auswertungen für Prüfungen oder Ursachenanalysen benötigen.
Wie Agenten-Traffic Performance und Ressourcenplanung verändert
Agentenanfragen belasten Ihre Infrastruktur anders als menschlicher Traffic – und das hat reale Auswirkungen auf Kapazitätsplanung, auf die die meisten Teams noch nicht vorbereitet sind.
Ein menschlicher Besucher löst eine Reihe paralleler Anfragen aus: HTML, dann Bilder, Schriftarten, Skripte und Analytics-Beacons, verteilt über mehrere Sekunden. Ein Agent, der strukturierte Daten extrahiert, sendet dagegen oft nur eine einzelne, effiziente Anfrage für genau die benötigten Informationen und zieht weiter. Auf dem Papier klingt das ressourcenschonender – im großen Maßstab ist es das nicht. Agenten können dieselben hochwertigen Seiten, etwa Preis- oder Produktdetailseiten, in einem Volumen und mit einer Frequenz aufrufen, die kein einzelner Mensch jemals erreichen würde, weil zwischen den Anfragen keine Lesezeit liegt.
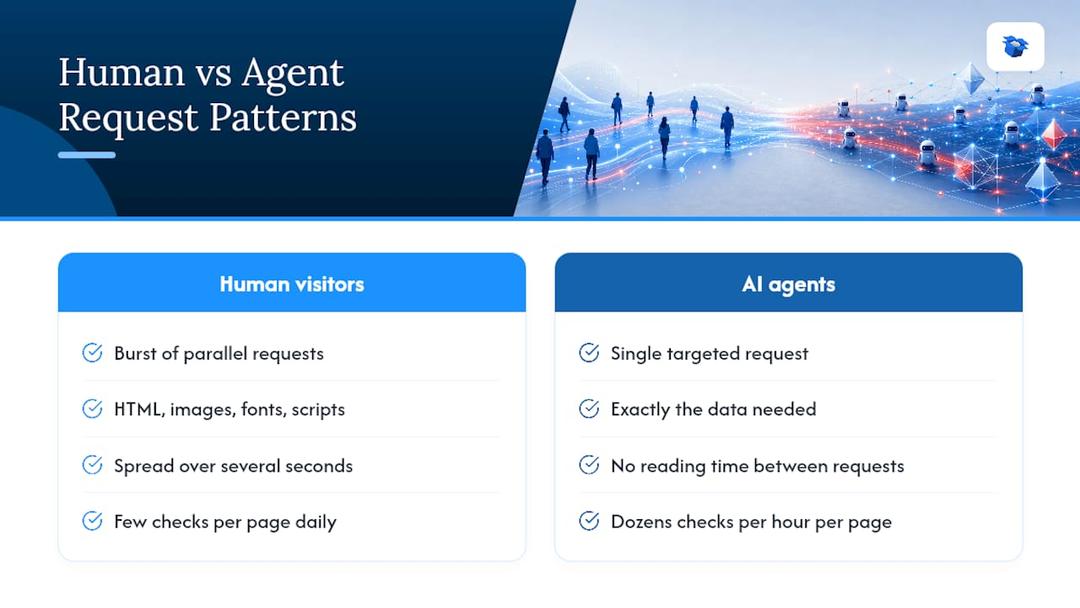
Dieses Muster zeigt sich als unerwartete Last auf bestimmten Endpunkten statt als gleichmäßige Verteilung über die gesamte Website. Rate-Limiting- und Caching-Entscheidungen, die auf menschliche Surfgewohnheiten abgestimmt wurden, können bei Agenten falsch greifen: Entweder blockieren sie legitimen Agenten-Traffic, der zu einem Verkauf geführt hätte, oder sie erlauben einem schlecht konfigurierten Agenten, einen Endpunkt zu überlasten, den Ihr Team für wenig frequentiert hielt.
Die praktische Antwort darauf ist, Agentenlast als eigene Kategorie in der Kapazitätsplanung zu behandeln. Überwachen Sie Anfrageraten nach Akteurstyp statt nur den aggregierten Traffic und konfigurieren Sie Cache- sowie Rate-Limit-Regeln gezielt für Verhaltensmuster von Agenten. Eine Produktseite, die von Shopping-Agenten dutzendfach pro Stunde geprüft wird, benötigt eine andere Caching-Strategie als eine Seite, die Menschen nur wenige Male am Tag aufrufen – selbst wenn die Gesamtzahl der Anfragen in einem kombinierten Dashboard ähnlich aussieht.
Die rechtliche und ethische Grenze bei der Überwachung von Agenten-Traffic
Das Protokollieren von Agentenaktivitäten wirft Fragen auf, für die es noch keine endgültigen Antworten gibt. So zu tun, als wäre das anders, ist ein Fehler.
Wenn Sie detaillierte Request-Daten erfassen – einschließlich Headern, Timing und Verhaltens-Fingerprints –, erfassen Sie in manchen Fällen auch Daten, die sich auf Einzelpersonen zurückführen lassen, insbesondere wenn ein Agent im Auftrag eines namentlich bekannten Kundenkontos handelt. Damit fallen Logs von Agenten-Traffic unter dieselben Datenschutzrahmen wie jede andere Datenerhebung Ihres Unternehmens – egal ob regionale Datenschutzgesetze oder interne Richtlinien zur Daten-Governance.
Die ethischen Fragen laufen parallel zu den rechtlichen. Agenten pauschal zu blockieren schützt möglicherweise Serverressourcen, schneidet aber zugleich einen wachsenden Käuferkanal ab, da immer mehr Menschen ihre Produktvergleiche über KI-Agenten statt über Browser-Tabs durchführen. Zu großzügige Zugriffe wiederum öffnen Missbrauch durch Scraping Tür und Tor, getarnt als legitimer Agenten-Traffic.
Ein praktikabler Mittelweg behandelt Agentenzugriffe wie jede andere automatisierte Integration: dokumentiert, rate-limitiert und überwacht – mit klaren Regeln darüber, was erlaubt ist. Die Veröffentlichung einer llms.txt-Datei ist ein Teil davon, weil sie gut konfigurierten Agenten eine dokumentierte Schnittstelle bietet, statt sie die Struktur Ihrer Website erraten zu lassen.
Aufbewahrungsrichtlinien sind genauso wichtig wie Erfassungsrichtlinien. Bewahren Sie detaillierte Agenten-Logs nur so lange auf, wie Ihr Prüfungs- oder Streitfenster es tatsächlich erfordert, und schützen Sie diese Logs mit denselben Zugriffskontrollen wie jede andere Datensammlung mit Verhaltens- oder identitätsbezogenen Informationen.
Agentenanalysen mit Sicherheits- und Betrugserkennung integrieren
Agenten-Traffic-Analysen und Betrugserkennung lösen überschneidende Probleme. Wer sie als getrennte Systeme behandelt, schafft auf beiden Seiten blinde Flecken.
Ein bösartiger Scraper und ein legitimer Shopping-Agent können auf Netzwerkebene nahezu identisch aussehen: automatisierte Anfragen, keine JavaScript-Ausführung, ein deklarierter oder gefälschter User-Agent-String. Der mehrstufige Klassifizierungsansatz zur Erkennung legitimer Agenten – mit Prüfung deklarierter Identität, Verhaltenssignalen und Authentifizierung – ist derselbe Ansatz, der Missbrauch erkennt. Wenn Sie daraus ein gemeinsames System statt zwei separater machen, muss Ihr Fraud-Team keine Signalerkennung neu entwickeln, die Ihr Analytics-Team bereits aufgebaut hat.
Praktische Integration beginnt mit einer gemeinsamen Akteurs-Taxonomie. Wenn Ihre Analytics-Pipeline eine Anfrage als Agent, Crawler oder Mensch kennzeichnet, sollte Ihre Sicherheitssoftware genau dieses Tag lesen und darauf reagieren – statt eine eigene Bot-Erkennung mit abweichenden Definitionen zu betreiben. Unterschiedliche Taxonomien zwischen Teams führen dazu, dass ein legitimer KI-Einkaufsagent durch eine Sicherheitsregel blockiert wird, von der das Analytics-Team nichts wusste.
Gemeinsame Alarmierung ist die andere Hälfte. Ein plötzlicher Anstieg von Agentenanfragen an einen Checkout-Endpunkt kann ein bekannter Shopping-Agent sein, der Preisänderungen in Ihrem Katalog testet – oder ein Credential-Stuffing-Angriff, der sich als Agenten-Traffic tarnt. Agentenbezogene Anomalien über denselben Incident-Workflow zu leiten, den die Sicherheit bereits für Betrugsfälle nutzt, statt über einen separaten Analytics-Alarm, den niemand im Sicherheitsteam überwacht, macht den Unterschied rechtzeitig sichtbar.
Wie sich Prioritäten bei Agentenanalysen je nach Branche verschieben
Nicht jede Branche benötigt bei Traffic-Analysen für KI-Agenten denselben Fokus. Ein Einheitsansatz verschwendet Engineering-Zeit für die falschen Signale.
E-Commerce- und Einzelhandelsseiten konzentrieren sich vor allem auf den Abschluss von Aufgaben auf Produkt- und Preis-Seiten sowie auf die Übergaberate von Agent zu Mensch, da diese Kennzahl Agentenaktivität direkt mit Umsatz verbindet. Der größte blinde Fleck im Handel sind meist Preis-Seiten, die von Vergleichsagenten stark belastet werden, ohne dass ein entsprechendes Conversion-Tracking existiert.
Medien- und Publishing-Websites gewichten die Unterscheidung zwischen Crawlern und Agenten stärker, da es geschäftlich häufig um Lizenzierung und Wiederverwendung von Inhalten statt um Conversion geht. Es macht einen Unterschied, ob ein Crawler einen Datenbestand aufbaut oder ein Agent einen einzelnen Artikel für die konkrete Frage eines Nutzers abruft – entsprechend unterschiedlich sollte dieser Traffic bewertet und gesteuert werden.
B2B-Software- und SaaS-Plattformen priorisieren meist die Kategorie der Integrationsaufgaben, da Agenten auf diesen Websites häufig API-ähnliche Aufrufe im Auftrag anderer Systeme ausführen statt für einzelne Käufer. Fehler- und Blockierungsraten nach Akteur sind hier wichtiger als die Übergaberate, weil der „Mensch“ auf der anderen Seite oft mehrere Schritte von der eigentlichen Anfrage entfernt ist.
Finanzdienstleistungs-Websites liegen am nächsten an den zuvor beschriebenen Attributions- und Governance-Problemen, da das regulatorische Risiko bei nicht autorisierten Agentenaktionen in dieser Branche am höchsten ist. Canary-basierte Attribution und unveränderliche Protokollierung sind hier wichtiger als in fast jedem anderen Bereich.
Was Analytics-Teams tatsächlich ändern sollten
Behalten Sie Ihre bestehenden, auf Menschen ausgerichteten Standardberichte genau so bei, wie sie sind. Bauen Sie kein Dashboard um, dem ein Marketingverantwortlicher bereits vertraut, nur um Agentendaten hineinzuzwingen. Erstellen Sie stattdessen eine parallele Ansicht – eine, die anders aussehen darf, weil sie etwas strukturell anderes misst.
Die größere organisatorische Veränderung betrifft die Frage, wo Agenten-Telemetrie im Alltag verankert ist. Sie gehört in Incident-Response- und Beschaffungsgespräche – nicht versteckt in einem vierteljährlichen Analytics-Deck, das niemand liest, bis etwas schiefgeht. Und wenn Sie Entwicklungszeit investieren, um etwas gezielt für die Lesbarkeit durch Agenten zu optimieren, dann investieren Sie sie in Preis- und Produktseiten. Dort treffen Agenten tatsächlich Entscheidungen im Auftrag von Käufern, und dort zeigt sich der Nutzen dieser Arbeit am schnellsten.
— Xhurian
Agenten-Transparenz in optimierte Produktangebote verwandeln
Die Messung von Agenten-Traffic zeigt Ihnen, dass Agenten Ihre Produktseiten lesen. Sie zeigt Ihnen jedoch nicht, warum ein Agent einen Wettbewerber statt Ihrer Produkte empfohlen hat – und genau diese Lücke schließt Ecentic.

Ecentic verbindet sich direkt mit Ihrem Shopify oder WooCommerce Shop und simuliert, wie ChatGPT, Gemini, Claude und Perplexity Ihre Produktangebote tatsächlich im Vergleich zu Wettbewerbern bewerten. Anschließend erhalten Sie verständliche Diagnosen darüber, was konkret verhindert, dass Ihre Produkte empfohlen werden. Kunden, die die Optimierungstools von Ecentic nutzen, berichten nach der Umsetzung der empfohlenen Überarbeitungen von Produktangebotenvon spürbaren Steigerungen sowohl bei KI-gesteuerten Besuchen als auch bei Verkäufen. Statt nur Agentenanfragen zu zählen, erhalten Sie ein auf Agentenlesbarkeit geprüftes UCP-Profil sowie einen erneuten Scan-Zyklus, der Ihre Auswahlrate im Zeitverlauf verfolgt, während sich Modelle verändern.
Wenn Sie bereits CDN-Logs weiterleiten und Akteure kennzeichnen, fehlt nur noch die Frage, was Sie mit dieser Transparenz anfangen. Führen Sie einen kostenlosen Einführungsscan für Ihren Shop durch und sehen Sie genau, wie Ihre Produktangebote bei den Agenten abschneiden, die sie bereits lesen.
FAQ
Was ist agentengesteuerte Traffic-Analyse?
Darunter versteht man das Erfassen, Klassifizieren und Zuordnen von Anfragen, die von KI-Agenten im Auftrag von Menschen ausgeführt werden, sowie die Messung der erledigten Aufgaben statt der Nutzung sitzungsbasierter Kennzahlen.
Warum versagen Sitzungsmetriken bei Agenten-Traffic?
Kennzahlen wie Absprungrate oder Verweildauer gehen davon aus, dass ein Mensch eine Seite rendert und liest. Agenten senden jedoch oft nur eine einzelne effiziente Anfrage und verlassen die Seite wieder – dadurch werden diese Werte bedeutungslos.
Wie erkennt man Traffic von KI-Agenten auf einer Website?
Serverseitige Erfassung und CDN-Logs in Kombination mit User-Agent-Analyse, Asset-zu-Request-Verhältnissen und llms.txt-Validierung machen Agentenaktivitäten zuverlässig sichtbar, die clientseitige Tools übersehen.
Was ist die Attributionslücke bei Agentenanalysen?
Sie beschreibt die Schwierigkeit nachzuweisen, welcher Mensch oder welche Organisation die Handlung eines bestimmten Agenten autorisiert hat. Dadurch entstehen rechtliche und Compliance-Risiken, die sich durch Canary-basierte Protokolle und unveränderliche Protokollierung verringern lassen.
Kann Ecentic bei der Optimierung von Agenten-Traffic helfen?
Ja. Ecentic simuliert, wie KI-Einkaufsagenten Produktangebote in Shopify- und WooCommerce-Shops bewerten, und liefert konkrete Empfehlungen, um Sichtbarkeit und Conversions durch Agenten-Traffic zu verbessern.
Diese Themen entdecken