

A/B-Testing für KI bedeutet, kontrollierte Vergleiche Ihrer Varianten von Produktseiten durchzuführen, um zu sehen, welche Version ChatGPT, Gemini, Claude oder Perplexity einem Käufer tatsächlich empfiehlt. Starten Sie, indem Sie einige Ihrer wichtigsten SKUs gegen diese KI-Einkaufsagenten simulieren, und beheben Sie dann die zwei Dinge, an denen die meisten Tests schon vor dem Start scheitern: fehlende strukturierte Daten und veraltete Feed-Felder. Priorisieren Sie zuerst ein vollständiges Schema, aktuelle Feeds und ausreichend Bewertungen, denn diese drei Signale haben das größte Gewicht dafür, was ein KI-Einkaufsagent ausspielt.
Kurzfassung:
- Felder in strukturierten Daten wie priceValidUntil, deliveryTime und merchantReturnDays fehlen oft oder sind veraltet, was Empfehlungen von KI-Einkaufsagenten deutlich beeinflusst.
- Aktuelle Feeds und Echtzeit-Updates sind entscheidend, weil veraltete Preise oder Verfügbarkeiten zu nicht passenden Produktangeboten und verlorenen Verkäufen führen können.
- Tests sollten sich darauf konzentrieren, bestimmte Schema- oder Feed-Variablen isoliert zu prüfen statt beliebige Textanpassungen vorzunehmen, da Signale von KI-Einkaufsagenten in erster Linie datengetrieben sind.
- Varianten müssen über mehrere Modelle hinweg getestet werden, weil verschiedene KI-Einkaufsagenten unterschiedliche Präferenzen bei Platzierung und Attributen haben.
- Simulationsbasierte Audits vor dem Live-Einsatz können Schema-Lücken schnell aufdecken, die Sichtbarkeit in KI-Systemen verbessern und den Traffic von Käufern mit hoher Kaufabsicht steigern.
Warum agentenorientierte A/B-Tests für Shopify- und WooCommerce-Shops wichtig sind
KI-Einkaufsagenten navigieren nicht so wie Menschen. Sie lesen maschinenlesbare Signale: strukturierte Daten, die Genauigkeit von Feeds und Bestätigungen durch Dritte wie Bewertungen und redaktionelle Erwähnungen. Eine Seite, die für menschliche Käufer großartig aussieht, kann für einen Agenten unsichtbar sein, wenn das zugrunde liegende Markup zu dünn ist.
Die Columbia Business School führte simulierte Einkaufssitzungen durch und stellte fest, dass Platzierung, Badges, Preis und Bewertung beeinflussten, welche Produkte Agenten auswählten. Verschiedene Modelle hatten unterschiedliche Präferenzen. GPT-4.1 tendierte zu Artikeln links in einer Ergebnisliste, Claude bevorzugte die Mitte, Gemini die rechte Seite. Das allein zeigt schon, dass es nicht das eine „beste“ Produktangebot für jeden Agenten gibt. Es gibt es pro Modell – genau deshalb ist Testen besser als Raten.
Für Händler ist der Nutzen real. Traffic, der über einen KI-Agenten kommt, hat meist eine hohe Kaufabsicht, weil der Käufer schon eine Empfehlung erhalten hat, bevor er auf Ihrer Seite landet. Der Haken: Ihre Produktseite muss bestätigen, was der Agent behauptet hat. Wenn der Agent etwa „kostenlose Rückgabe innerhalb von 30 Tagen“ sagt und Ihre Seite das weder im sichtbaren Text noch im Schema belegt, verlieren Sie den Verkauf sofort.
Was Agenten am stärksten gewichten:
- Vollständige strukturierte Daten über die Schema-Typen Product, Offer und Review hinweg
- Aktuelle Feed-Daten, also Preise und Verfügbarkeit, die mit dem Live-Stand auf der Website übereinstimmen
- Unabhängige Bestätigung durch Bewertungen, syndizierte Ratings und redaktionelle Berichterstattung
Was Sie testen sollten: Attribute, Schema-Felder und externe Signale
Bevor Sie irgendein Experiment starten, legen Sie die genauen Felder und Signale fest, bei denen Änderungen sinnvoll sind. Zufällige Textanpassungen zu testen verschwendet Zeit. Die Felder zu testen, die Agenten tatsächlich parsen, tut das nicht.
- Zentrale JSON-LD-Felder. Agenten lesen
Product,Offer,AggregateRating, undReview-Schema direkt. Innerhalb vonOffer,priceValidUntilist wichtiger, als den meisten Händlern bewusst ist, und ebensoShippingDeliveryTime.deliveryTimeundMerchantReturnPolicy.merchantReturnDays. Ein Sellarix-Audit von 36 Produktseiten zeigte, dass Product JSON-LD auf 72 % der Seiten vorhanden war, aberpriceValidUntilnur auf 6 %, Lieferzeit auf 11 % und Rückgabetage auf gerade einmal 6 %. Keine der geprüften Seiten hatte alle drei. - Feed- und Protokollzustand. Vollständigkeit des Merchant Center-Feeds, die Bereitschaft für agentengestützte Commerce-Protokolle (ACP, UCP, MCP) und die Aktualisierungsfrequenz entscheiden alle darüber, ob die Daten eines Agenten überhaupt mit Ihrer Live-Website übereinstimmen, wie in diesem KI-SEO-Leitfaden für den Ecommerce beschrieben. Ein Feed, der nur einmal täglich aktualisiert wird, kann ein Experiment unbemerkt verfälschen, wenn sich der Preis während des Tests ändert.
- Externe Nachweise. Umfang, Aktualität und Konkretheit von Bewertungen wiegen schwerer als eine bloße Sternebewertung. Syndizierte Bewertungen über Handelspartner hinweg und redaktionelle Erwähnungen liefern zusätzliche Bestätigung, die ein Agent gegenprüfen kann.
Jede Variante, die Sie erstellen, sollte genau eine dieser drei Kategorien isolieren. Ändern Sie das Schema, nicht den Text. Ändern Sie den Text, nicht die Feed-Frequenz. Variablen zu vermischen ist der Grund, warum Händler am Ende Ergebnisse haben, die sie nicht erklären können.
Wie führt man einen A/B-Test für KI-Einkaufsagenten durch?
Diese Art von Test ähnelt weniger einem Marketing-Split-Test als vielmehr einem kontrollierten Engineering-Rollout. Hier ist die Abfolge, die die Ergebnisse sauber hält.
- Wählen Sie Ihre Test-SKUs und definieren Sie Erfolg von Anfang an. Wählen Sie 3 bis 5 umsatzstarke Produkte, nicht Ihren gesamten Katalog. Legen Sie Ihre Erfolgskennzahlen fest, bevor Sie beginnen: AI share of voice (wie oft Ihr Produkt erscheint, wenn ein Agent in Ihrer Kategorie um eine Empfehlung gebeten wird), Zitierungshäufigkeit und Conversion-Uplift aus Sitzungen, die von einem KI-Agenten vermittelt wurden.
- Entwerfen Sie Varianten mit nur einer Variable. Erstellen Sie eine Version mit einer Schema-Korrektur (zum Beispiel durch das Hinzufügen von
merchantReturnDays), eine mit neu angeordneten Spezifikationen in der Beschreibung und eine mit einem hervorgehobenen Bewertungsauszug. Bündeln Sie niemals zwei Änderungen in einer einzigen Variante. - Simulieren Sie, bevor Sie live gehen. Lassen Sie jede Variante durch repräsentative Agenten-Sitzungen über mindestens zwei Modellfamilien laufen. Modellspezifische Verzerrungen sind inzwischen gut dokumentiert, und eine Variante, die bei einem Modell gewinnt, kann bei einem anderen verlieren.
- Validieren Sie live – mit Bedacht. Sobald die Simulation auf eine wahrscheinliche Gewinnervariante hindeutet, führen Sie diese schrittweise über zeitlich gestaffelte Feed-Übermittlungen ein oder testen sie, sofern Ihre Plattform dies unterstützt, in einer ACP/UCP-Sandbox-Umgebung. Stellen Sie nicht gleich am ersten Tag 100 % des Traffics um.
- Kümmern Sie sich um die technischen Details. Unter Shopify oder WooCommerce sollten Sie JSON-LD serverseitig rendern, statt es über einen Tag Manager einzuschleusen, pro Variante eigene GTINs vergeben, damit Agenten und Feeds nicht zwei Versionen zu einem Produkt zusammenfassen, und einen Integrationstest schreiben, der sicherstellt, dass agentenkritische Felder in der rohen HTML-Antwort vorhanden sind und nicht nur in einer Entwickler-Vorschau.
Profi-Tipp: Führen Sie Ihre Simulation jedes Mal erneut aus, wenn Sie das Theme, das Feed-Schema oder die App ändern, die Ihre Bewertungen verwaltet. Ein Template-Update kann unbemerkt einen JSON-LD-Block entfernen, dessen Aufbau Wochen gedauert hat.
Tools wie das ecentic-Funktion für Produktangebote kann Schritt 5 deutlich verkürzen, weil sie erkennt, welche Felder fehlen, und die Korrektur in einem Durchgang direkt in Ihren Shop zurückschreibt, statt einer manuellen Prüfung.
Welche Kennzahlen zeigen tatsächlich, dass eine Variante gewonnen hat?
Vanity-Metriken helfen hier nicht weiter. Entscheidend ist, ob ein Agent Ihr Produkt angezeigt hat und ob dieser dadurch vermittelte Besuch konvertiert hat.
Wichtige KPIs, die Sie verfolgen sollten:
- KI-Sichtbarkeitsanteil: wie oft Ihre Marke in einer festgelegten Gruppe von Test-Prompts im Vergleich zu Wettbewerbern erscheint
- Zitat-Häufigkeit: wie oft ein Agent auf Ihre konkrete Produktseite oder bestimmte Attribute verweist
- Konversionsrate bei Verweisen durch Agenten: Konversionsrate für Sitzungen, die über einen bekannten Agent-Referrer kommen, getrennt von organischem und bezahltem Traffic erfasst
Kennzahlen zur technischen Qualität sind genauso wichtig, denn ein fehlerhafter Feed kann eine eigentlich gewinnende Variante zunichtemachen:
- Abdeckungsrate strukturierter Daten in Ihrem gesamten Katalog
- Akzeptanz- und Ablehnungsrate des Feeds im Merchant Center
- Vorhandenseinsrate für
priceValidUntil,deliveryTime, undmerchantReturnDays
Richten Sie ein GA4-Segment für bekannte Agent-Referrer wie perplexity.ai, chatgpt.com und copilot.microsoft.com ein und erstellen Sie dann für dieses Segment einen separaten Conversion-Funnel, statt es mit dem allgemeinen organischen Traffic zusammenzufassen.
Die Stichproben bei Agent-Referral-Traffic sind anfangs meist klein, was bedeutet, dass viele Tests zunächst statistisch nicht eindeutig ausfallen. Werten Sie eine einzelne Woche mit flachen Ergebnissen als Nullergebnis, nicht als Misserfolg, und warten Sie auf ein Muster über mindestens zwei vollständige Simulations- und Live-Zyklen, bevor Sie eine Variante auf Ihren gesamten Katalog ausrollen.
Häufige Stolperfallen, Leitplanken und Profi-Tipps
Die meisten fehlgeschlagenen Tests lassen sich auf einige immer wiederkehrende Fehler zurückführen:
- Clientseitiges Nachladen des Preises. Wenn Ihr Preis erst nach dem initialen Rendern der Seite per JavaScript geladen wird, sehen manche Agenten ihn nie, und Feed-Preis und Live-Preis driften auseinander.
- Fehlende Kennungen pro Variante. Ohne eindeutige GTINs führt ein Agent (oder Ihr eigener Feed) zwei Testvarianten in einem Produktangebot zusammen.
- Fehlende Konsistenz zwischen Feed und Shop. Auf Ihrer Website steht ein Preis, im Feed ein anderer, und der Agent wählt den aus, dem er weniger vertraut.
- Falsch angegebene Rückgabe- oder Lieferfelder. Ein
MerchantReturnPolicydas nicht zu Ihrer tatsächlichen Richtlinie passt, untergräbt das Vertrauen schnell, sobald ein Käufer es bemerkt.
Erstellen Sie pro Produkt-Template einen automatisierten Integrationstest, der diese Felder in der Server-Antwort prüft, nicht im gerenderten DOM. So erkennen Sie Regressionen, bevor ein Template-Update stillschweigend sechs Wochen Arbeit an strukturierten Daten löscht.
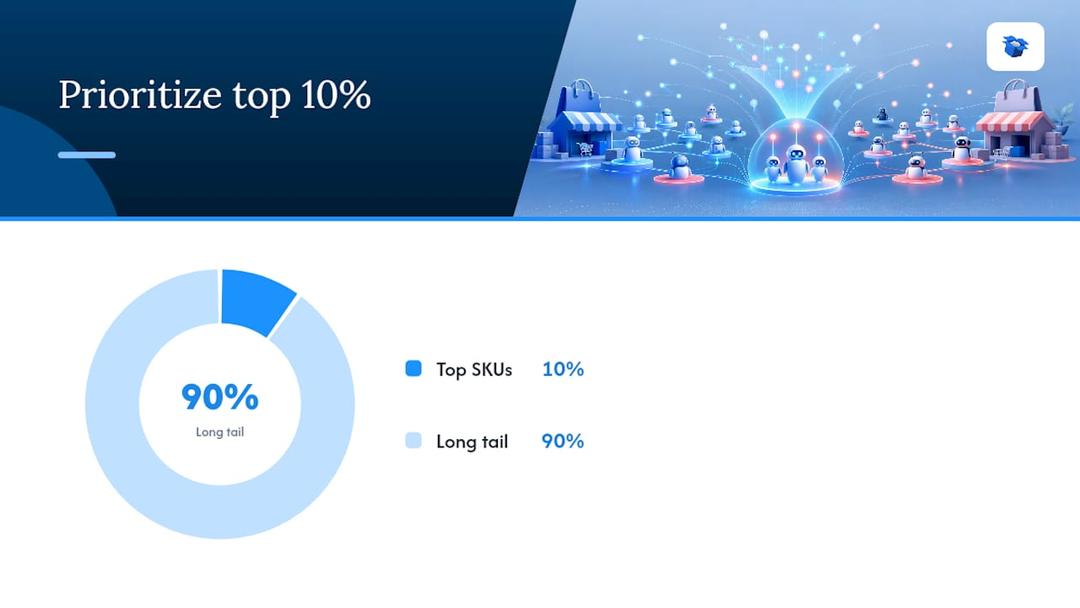
Profi-Tipp: Beginnen Sie mit Ihren umsatzstarken SKUs. Optimieren Sie zuerst die obersten 10% Ihres Katalogs nach Umsatz, bevor Sie sich um den Long Tail kümmern. Stellen Sie Rezensenten außerdem eine konkrete Frage („Wofür haben Sie das verwendet?“) statt nur allgemein um eine Sternebewertung zu bitten. Szenariospezifische Bewertungen sind das, was ein Agent tatsächlich abruft.
Was simulationsgestützte Tests tatsächlich verändern
Wenn Sie Dutzende Prüfungen von Produktseiten und simulierte Agent-Sitzungen durchführen, verändert das Ihren Blick darauf, was es heißt, bei einem Produktangebot ausgewählt zu werden. Der erste Impuls ist, bessere Texte zu schreiben. In der Realität lassen sich die meisten Niederlagen auf ein fehlendes Feld in einem Schema-Block zurückführen, den seit acht Monaten niemand geprüft hat.
Ein Ansatz, der jedes Produktangebot vor dem Livegang durch simulierte Agent-Sitzungen laufen lässt und Korrekturen dann in einem Schritt zurück in Shopify oder WooCommerce schreibt, statt über ein mehrwöchiges Entwickler-Ticket, kann Händlern helfen, KI-getriebene Besuche und nachgelagerte Verkäufe zu steigern, sobald die Lücken geschlossen sind.
— Xhurian
Führen Sie Ihren ersten A/B-Test mit ecentic durch
Einige Plattformen machen aus dem obigen Ablauf ein Tool, das Sie schnell einsetzen können. Sie simulieren Ihre Produktangebote in ChatGPT, Gemini, Claude und Perplexity, erklären in klarem Englisch, warum das Produktangebot eines Wettbewerbers einen Vergleich gewonnen hat, und schreiben die Korrektur mit einem Klick zurück in Shopify oder WooCommerce – ganz ohne Entwickler-Ticket oder Warten auf ein Template-Deployment.

Anstatt manuell zu prüfen, priceValidUntil oder merchantReturnDays in Ihrem gesamten Katalog erhalten Sie eine Diagnose, die genau kennzeichnet, welche agentenkritischen Felder fehlen, gefolgt von einer automatischen Optimierung, die diese ergänzt. Laufende Rescans verfolgen, ob Ihre Auswahlrate bei jedem Agenten nach jeder Änderung steigt, sodass Sie nicht raten müssen, ob eine Anpassung funktioniert hat. Starten Sie mit einem kostenlosen Scan, wählen Sie drei SKUs mit echtem Umsatzbeitrag aus, führen Sie die Simulation aus und veröffentlichen Sie die Gewinnervariante. Die Tarife beginnen bei $14.90 pro Monat im Compete-Tarif, mit Scale und Dominate für wachsende Kataloge und höhere Anforderungen.
FAQ
Wie lange dauert ein A/B-Test für KI-Agenten?
Ein Simulationszyklus kann innerhalb von ein bis zwei Tagen abgeschlossen werden, sobald Ihre Varianten erstellt sind, da er nicht vom Volumen des Live-Traffics abhängt. Die Live-Validierung dauert länger, typischerweise zwei bis vier Wochen, weil die Stichprobengrößen bei Agenten-Referrals für die meisten Shops noch klein sind.
Brauche ich Entwicklerressourcen, um diese Tests durchzuführen?
Sie benötigen jemanden, der JSON-LD- und Feed-Daten bearbeiten kann, aber eine Plattform wie ecentic eliminiert den Großteil der manuellen Programmierung, indem sie Lücken erkennt und Korrekturen direkt in Shopify oder WooCommerce veröffentlicht.
Welche Schema-Felder sind für KI-Agenten am wichtigsten?
Offer.priceValidUntil, ShippingDeliveryTime.deliveryTime, und MerchantReturnPolicy.merchantReturnDays sind laut dem Audit von Sellarix die drei Felder, die in Prüfungen am häufigsten fehlen — selbst bei Shops mit ansonsten soliden Product-Schemas.
Kann ich unterschiedliche Produktvarianten für verschiedene KI-Modelle testen?
Ja, und das sollten Sie auch. Simulationen zeigen modellspezifische Präferenzen. Das bedeutet: Eine Variante, die bei einem Agenten gewinnt, kann bei einem anderen verlieren. Deshalb lohnt es sich, vor dem Live-Rollout mindestens gegen zwei Modelle zu testen.
Was kostet Ecentic?
Der Compete-Tarif von Ecentic beginnt bei $14.90 pro Monat, Scale kostet $44.90 und Dominate $149. Zusätzlich gibt es ein leistungsbasiertes Gebührenmodell mit 3 % pro KI-attribuierter Bestellung für nutzungsbasierte Preise. Ein kostenloser Scan ist verfügbar, bevor Sie sich für einen Tarif entscheiden.
Diese Themen entdecken