

是的,robots.txt 是告诉 AI 爬虫它们是否可以索引你的页面或将其用于训练的标准方式,但是否遵守取决于对方自愿。使用像 GPTBot 这样的指定标识符,可禁止训练爬虫;如果仍希望页面被 AI 搜索结果引用,就继续允许使用搜索类标识符的爬虫访问。这个文件无法强制拦截恶意爬虫,但各大 AI 厂商都公布了相关说明,并遵守其中的规则。
简要说明:
- 将 robots.txt 放在域名根目录下,每个子域名分别建立独立文件,并且严格按示例大小写书写 User-agent 和 Disallow,因为指令名称区分大小写。
- OpenAI 将搜索爬虫与训练爬虫分开,因此你可以在屏蔽训练的同时保留搜索引用;变更生效可能需要大约 24 小时。
- Google 的 AI 训练控制不会影响 Googlebot 的搜索抓取;若要排除 Anthropic,则需要分别为它的两个训练爬虫设置单独规则。
- 被禁止抓取的页面无法向爬虫暴露其 noindex 标签,因此 HTML 页面应使用 meta 指令,PDF 和图片应使用 HTTP 标头。
- robots.txt 不能保护敏感内容,也无法阻止不遵守规则的机器人;私有内容应使用身份验证,如果请求仍在继续,则应使用 CDN 或 WAF 进行拦截。
可直接复制的 Robots.txt 片段:屏蔽或允许 AI 爬虫
robots.txt文件位于您的域名根目录(yoursite.com/robots.txt),绝不能放在子文件夹中,而且每个子域名都需要单独一份。指令名称和user-agent token区分大小写,因此 Disallow 和 User-agent 都必须严格按示例书写,不过您列出的路径可因服务器配置而有所不同。
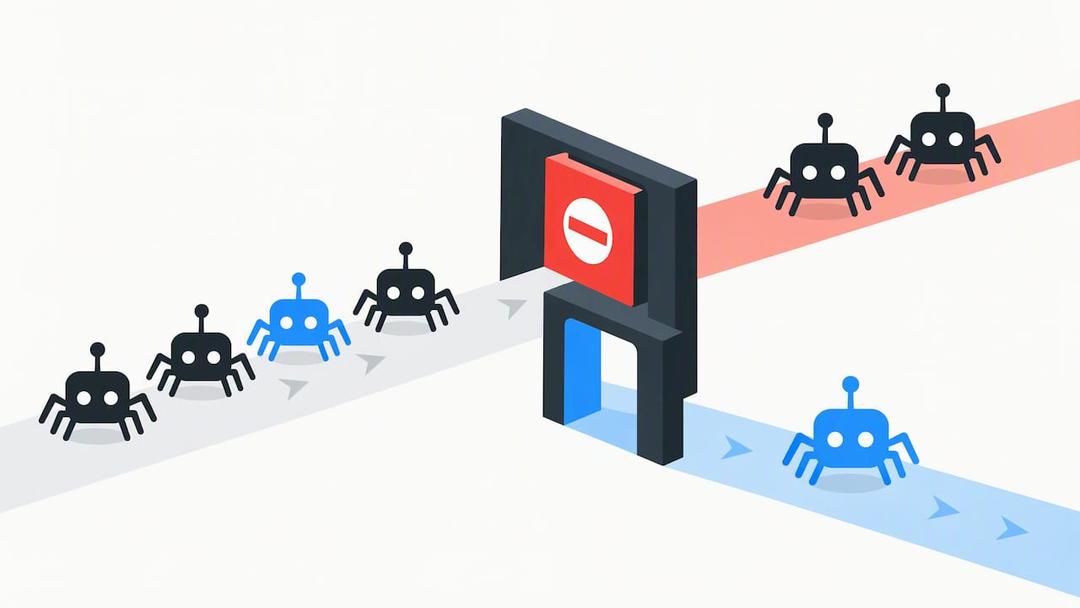
如果既要屏蔽训练爬虫,又要保留搜索可见性,最简配置如下:
User-agent: GPTBot后接Disallow: /即可禁止OpenAI的训练爬虫访问。User-agent: OAI-SearchBot后接Allow: /以继续有资格出现在ChatGPT搜索结果中。User-agent: *后接Allow: /这样通用爬虫(包括搜索引擎)就能继续获得完整访问权限。
如果网站想彻底退出AI训练,后备屏蔽列表的做法就是重复写入 Disallow: / 到每个已命名的训练token(GPTBot、Google-Extended、ClaudeBot等)下,同时让通配符分组保持开放,以便搜索引擎访问。更保守的“不屏蔽任何内容”模板则完全跳过这些已命名分组,只使用 User-agent: * 配合 Allow: /;如果您从未添加robots.txt文件,这本来就是默认状态。
尽量让文件保持简短。 Search Engine Land 建议仅对您想排除的特定训练token设置禁止规则,而不是尝试显式允许每个您不介意的爬虫,因为宽泛的允许列表更难维护,也更容易意外造成全站屏蔽。
专业提示: 每次新修改robots.txt后,先在暂存子域名上测试,因为一个放错位置的通配符就可能在屏蔽您原本想排除的AI爬虫时,顺带误伤Googlebot。
User-Agent标记和优先级规则如何生效
robots.txt解析遵循严格规则,弄错这些规则,最容易导致搜索引擎被误屏蔽。根据 RFC 9309,User-Agent标记只能包含字母、下划线和连字符,因此标记名称内部使用通配符是无效的。您必须按精确名称逐个列出要针对的爬虫,不能试图用模式一次匹配多个。
以下几条规则决定了实际生效的是哪个分组和规则:
- 像这样的已命名分组:
User-agent: GPTBot其优先级高于通配符User-agent: *分组,对该特定爬虫会优先生效。 - 当多个
Disallow或Allow规则都可能匹配某个URL时,以匹配路径最长的规则为准,不管这条规则在文件中出现得更早还是更晚。 - 末尾的
$会将规则锚定到路径的精确结尾,让您可以屏蔽特定文件类型,而不影响整个目录。
token名称只要写错一个字符,爬虫就会直接回退到通配符分组,而不会应用您原本想设置的规则。
值得了解的各厂商专用 robots.txt 条目
各大AI厂商都会发布自己的token,而且这些token不一定都直接对应单一机器人。 OpenAI 使用 OAI-SearchBot 用于搜索索引,使用 GPTBot 用于采集训练数据,两者独立控制,因此您可以允许其中一个、禁止另一个。对任一指令的修改都可能需要大约 24小时才能生效,这是 OpenAI 官方文档给出的说明。因此,修改文件后,不要期望抓取行为立刻改变。
Google的 Google-Extended 是控制token,不是独立的HTTP请求标识。它控制的是Google的AI产品是否可以将您的内容用于训练和生成式功能,而Googlebot仍会按照自身规则继续为搜索抓取。
User-agent: GPTBot配合Disallow: /即可禁止OpenAI训练,同时不影响OAI-SearchBotOAI-SearchBot。User-agent: Google-Extended配合Disallow: /即可禁止Google将内容用于AI训练,同时不影响标准搜索索引。User-agent: anthropic-ai和User-agent: ClaudeBot分别对应Anthropic的爬虫,如果想禁止训练,通常都需要显式设置Disallow。User-agent: Applebot-Extended可单独控制Apple的AI训练使用,不影响主要的Applebot,后者用于Siri和Spotlight。- Perplexity的爬虫值得配合边缘层拦截一起使用,因为 相关报道 提到过不遵守规则的情况:即使设置了Disallow规则,某些爬虫仍持续抓取页面。
结合Meta标签与边缘层拦截使用Robots.txt
Robots.txt是一种请求机制,而不是一道防线; Google官方文档 也明确说明,是否遵守取决于爬虫自身,而非强制性的安全措施。被禁止抓取的页面仍可能以裸URL形式出现在搜索结果中,而且由于 Disallow Disallow规则会彻底阻止页面被抓取,因此页面上的任何 noindex meta标签都不会被读取。
这也是为什么需要多层控制。HTML页面可以使用 noai 或 noimageai 或noimageai等meta指令实现页面级退出,而PDF、图片、Feed等非HTML资源则需要使用 X-Robots-Tag X-Robots-Tag HTTP头,因为它们没有页面主体来承载meta标签。
- 将robots.txt作为第一层控制,用于那些会读取并遵守规则的规范爬虫。
- 添加meta标签或
X-Robots-Tag头,实现更细粒度的页面级或文件类型级控制。 - 如果内容确实敏感,应使用身份验证或密码保护,因为robots.txt从来不是为安全防护设计的。
- 可以考虑使用 Cloudflare的Bot Preference Sync,它可以在现有robots.txt前添加托管指令,并按类别(搜索、智能体、训练)结合边缘层强制拦截,让声明的偏好与实际执行保持一致。
专业提示: 如果某个爬虫完全无视robots.txt,那么通过CDN或WAF进行边缘层拦截,才是真正能阻止请求的唯一手段。
测试并验证指令是否生效
确认爬虫是否真正遵守robots.txt,需要按清单逐项验证,而不是靠猜测。
- 检查服务器日志中针对
/robots.txt的请求,确认目标厂商的user agent在抓取任何被禁止路径之前,已经先访问过该文件。 - 预留厂商更新生效时间。OpenAI文档指出,配置变更大约需要24小时传播,因此应在完整一天后重新检查,而不是立即验证。
- 使用实时抓取工具或验证器,例如 BabyLoveGrowth的robots.txt检查工具,确认语法能够被正确解析,并符合预期。
- 结合CDN或WAF报告与robots.txt规则一起检查,识别那些即使收到指令仍持续抓取被禁止路径的爬虫。
- 创建一个带有唯一Disallow规则的测试页面,并在接下来的几天监控该页面是否出现在对应厂商的AI或搜索输出内容中。
平衡AI可见性与训练退出
对于电商网站来说,这个决策通常取决于三个因素:AI驱动引荐流量对收入的影响有多大、商品内容的敏感程度,以及商品目录更新的频率。如果AI搜索引用能带来有价值的流量,可以允许搜索类token,仅禁止训练类token。如果商品描述、价格或图片容易被抓取并在其他地方重新包装使用,那么禁止训练爬虫有助于保护这部分投入。偏向提升可见性的商家,仍然需要衡量这些策略是否有效,这正是专业优化工具发挥价值的地方。
— Xhurian
ecentic:衡量并优化AI购物可见性
允许搜索类token只是完成了一半工作。更关键的问题在于,像ChatGPT和Gemini这样的AI购物智能体在能够访问内容后,是否真的会推荐商品。我们打造了 ecentic ,直接回答这个问题:我们会连接您的Shopify或WooCommerce店铺,模拟AI智能体如何评估自有商品页面,并清楚展示商品在哪些方面胜过或输给竞品。

如果目标是获得更多AI驱动流量,而不是减少它,那么优化比屏蔽更有效。我们会将检测结果转化为具体的改写建议,并支持一键发布回您的店铺,从而缩小“AI可见”和“被AI推荐”之间的差距。
- 运行基于模拟的检测,查看不同AI购物智能体如何读取商品信息。
- 获取与具体商品页面对应、可直接执行的通俗建议,而不是泛泛而谈的SEO意见。
- 无需离开仪表板,即可将修复内容直接发布到Shopify或WooCommerce。
先进行 免费商品检测 ,了解当前商品信息的表现。
FAQ
使用robots.txt屏蔽AI机器人是否合法?
合法。发布robots.txt文件并列出希望禁止的爬虫token,是网站按照Robots Exclusion Protocol(机器人排除协议)运行的标准合法做法。它只是表达抓取偏好,本身不具备法律强制力,因此对于真正需要保护的内容,还应结合身份验证等措施。
是否有讨论AI机器人行为的聊天室或论坛?
目前没有由AI厂商统一运营、专门讨论robots.txt问题的官方聊天室,但各厂商都会发布自己的文档,例如OpenAI的爬虫概览和Google的robots.txt指南,这些才是确认当前token行为最可靠的信息来源。
robots.txt现在仍然有用且重要吗?
robots.txt仍然是表达爬虫偏好的主要方式,并且受到厂商认可,包括OpenAI、Google和Anthropic推出的新一代AI训练与搜索机器人。各大AI公司仍在持续记录和更新其支持的token,因此它依然是大多数网站所有者首先配置的控制手段。
机器人流量是否占互联网流量的大部分?
包括搜索爬虫和AI智能体在内的机器人流量,在大多数网站请求中都占据相当比例,但具体占比会因网站和行业而有很大差异。相比依赖单一行业统计数据,检查自己服务器日志中的爬虫user agent,才是判断流量中有多少属于自动化请求的最可靠方式。
屏蔽GPTBot是否也会屏蔽ChatGPT搜索结果?
不会,屏蔽 GPTBot 仅表示退出训练数据采集,不会影响 OAI-SearchBot,后者由OpenAI单独用于搜索索引控制。如果也希望页面不出现在搜索结果中,需要明确禁止 OAI-SearchBot OAI-SearchBot,尤其是在您也希望页面不出现在ChatGPT搜索结果中的情况下。