

会,商品评论会影响 AI 购物智能体是否推荐您的商品。ChatGPT、Gemini、Claude 和 Perplexity 等智能体在决定引用哪些证据时,会综合评估评论的新近程度、已验证购买状态、真实性信号以及评论的实际文本。最快的起点,是清晰展示评分分布和已验证购买标记,再补充结构化摘要,突出具体优点和缺点。
要点速览:
- Baymard 建议在商品积累到五条评论前先隐藏评分分布;低于这一阈值时,应展示有代表性的文字评论,以免误导消费者和智能体。
- 如果评论者能说明使用场景、权衡取舍和潜在风险,40 条详细评论的商品,获得的引用可能比 400 条泛泛评分的商品更多。
- 公开回复差评并记录解决结果,这既能为消费者提供服务质量的证据,也能为智能体提供关于投诉如何处理的可搜索上下文。
- 不要把评论激励与正面情绪挂钩;FTC 规则限制这种做法,平台也可能过滤其认定为不真实的反馈。
- 分阶段测试改动,将智能体引用与未改动的商品页面进行对比,并跟踪来自智能体的会话和订单,以衡量可见性变化。
AI 购物智能体如何使用评论和评分
AI 购物智能体并不会像排序算法那样简单计算星级平均分。它们会通过训练模型整合多个来源的评论内容,判断哪些证据真正有助于回答购物者的问题。 OpenAI 的购物文档 指出,ChatGPT 在生成商品摘要和标签时,会综合考虑价格、评论、库存状态和商家元数据,而且通常会引用第三方评论数据,而不只是单一星级评分。
这形成了研究人员所说的“决策有效性排序”。智能体不会默认优先展示最新或点赞最多的评论,而是偏向包含可执行细节的评论:明确的优点、明确的缺点,以及购物者在购买前想了解的风险提示。关于基于评论的购物问答中的证据选择研究,包括 智能体证据选择方法,发现同时保留支持性内容和风险相关内容的模型,比起只基于浅层泛泛好评生成的摘要,更容易获得购物者信任。
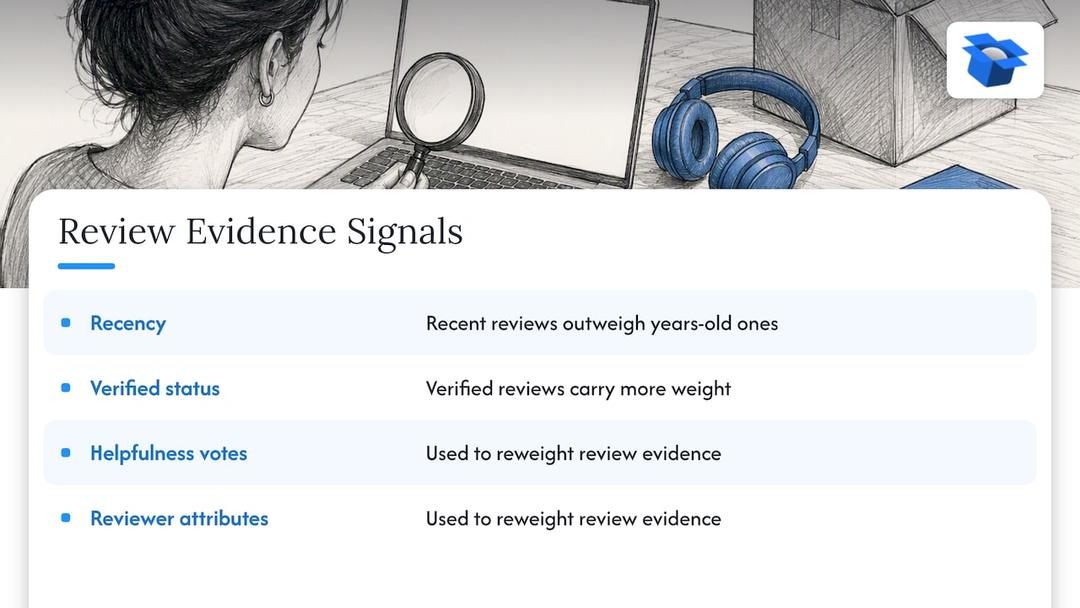
元数据与文本同样重要。智能体会根据评论的新近程度、已验证购买标记、点赞数和评论者属性重新调整证据权重。几年前由未验证账号发布的五星评论,其证据价值低于近期、已验证且明确说明使用场景的评论。这种权重调整过程对商家几乎不可见,因此很多评论运营仍在追求数量,而不是智能体真正使用的信号。
对 AI 购物智能体和购物者最重要的评论特征
单纯的平均评分几乎无法向购物者和智能体传达有效信息。 Baymard Institute 关于评分分布的研究 发现,购物者非常依赖完整的评分分布,即每个星级对应的评论数量,因为这能看出一个 4.5 分商品究竟是大多数评论都偏正面,还是五星与一星两极分化。对于提取证据的智能体来说,逻辑同样适用:存在明显波动的评分分布更像真实反馈,而过于一致的五星评论则容易被视为人为制造。
评论数量同样重要。Baymard 建议,当商品评论少于五条时隐藏评分分布摘要,因为样本过小会误导购物者和模型;在评论量增长之前,优先展示少量有代表性的定性评论会更有效。
除了数字指标,以下页面级特征也能持续提升用户信任和智能体的证据选择效果:
- 已验证购买标记和时间戳 ,让读者和模型确认评论来自真实且近期的交易。
- 内容丰富的评论文本 ,明确说明具体优点、具体缺点,以及评论者使用商品的场景。
- 评论者上传的图片或视频,可补充文本无法提供的佐证细节。
- 对差评的公开回复,电商商品页 UX 研究表明,这会提高转化率,因为购物者会把品牌如何处理投诉视为服务质量的参考。
公开处理负面反馈不仅能建立用户信任,还能为智能体提供可引用的解决记录,从而把潜在风险信号转化为“卖家响应积极”的证据。
可执行检查清单:让评论更适合 AI 智能体使用
这里的大部分工作,其实是把你可能已经收集到的信息,以购物者和智能体都能使用的方式展示出来。接下来 30 到 90 天,可以按以下步骤推进:
- 检查评论征集流程 是否符合 FTC 关于虚假和激励评论的规定,该规定禁止买卖虚假评论,并限制以正面评价为条件提供奖励。
- 展示评分分布和评论数量 ,在列表页和商品详情页都展示,而不是只显示平均分。
- 增加微调查或引导式问题 ,在评论阶段引导用户说明一个优点、一个缺点,以及商品的实际使用场景。
- 鼓励评论者上传图片和短视频 ,可在购买确认后通过简单上传提示实现。
- 在完整人工评论旁加入 AI 生成摘要,先展示人工评论,再展示摘要,因为 混合评论系统研究 表明,这种展示顺序能带来更高的信任感。
- 公开回复差评 ,并记录解决过程,把它当作可搜索证据,而不是试图隐藏。
- 分阶段上线改动 ,并在每个阶段前后检查智能体引用情况,而不是一次性全部修改。
实用建议: 在结账后的回访中,不要只请求星级评分,而是增加一个“优缺点”问题。结构化回答更容易包含智能体关注的风险提示。
合规不仅是法律层面的勾选项。平台和智能体越来越重视真实性,因此基于真实、非激励反馈建立的评论体系,往往比单纯追求评论量更能获得长期可见性。
衡量效果:面向 AI 智能体的指标与实验
既然有明确可衡量的指标,就没必要靠猜测判断评论改动是否有效。 关于 AI 生成评论摘要的研究 发现,在评论系统中加入摘要后,新评论数量和内容丰富度都会提升,因为贡献者会补充新的细节,而不是重复摘要已有内容。这也为你提供了天然的前后对比信号。
以下是几种确认评论改动是否真正影响智能体行为的实用方法:
- 抽样查看智能体摘要 ,对比改动前后热门商品的摘要,并观察引用证据是否发生变化。
- 跟踪智能体带来的归因数据,即通过分析系统统计来自智能体结果页的访问会话和订单。
- 采用分阶段发布 ,保留一组未改动的商品页面作为对照组,以便隔离评论改动的实际影响。
- 关注领先指标:评论数量增长率、评论新近度曲线、星级分布变化,以及点赞数。
定期检查引用情况,抽样查看智能体引用了哪些证据并持续对比,是从业者目前发现的高效方法之一,可用于判断评论改动是否真正被智能体识别。我们的 AI 购物引用获取指南 更详细说明了如何设计此类测试,而我们的 智能体驱动可见性追踪文章 则介绍了值得建立的相关数据看板。
为什么用模拟优化评论比靠猜测更有效
大多数商家把评论策略当作“拼数量”:收集更多五星评价,希望智能体能注意到。但这种思路其实是反的。负责推荐决策的智能体并不会单纯奖励评论量,它们更看重能解决购物者具体顾虑的证据。一个只有 40 条评论、但清晰说明使用场景和取舍关系的商品,往往比拥有 400 条泛泛五星好评的商品更容易被引用。
很多品牌低估的差距在于:评论平台宣传的是“更多评论意味着更多信任”,而真正影响智能体行为的却是另一套逻辑。仅靠查看自己的店铺页面,你无法知道智能体究竟在权衡哪些评论信号。因此,评论优化应当直接针对智能体进行测试,而不是继续沿用传统 SEO 的假设。
— Xhurian
先找出评论体系中的缺口,再决定如何修复
我们构建了一个平台,可模拟 ChatGPT、Gemini、Claude 和 Perplexity 在评估商品页面时实际看到的内容,包括与你的竞品相比,哪些评论信号缺失或较弱。你无需再猜测应该优先修复哪类评论属性;我们会为每个商品信息提供明确的胜负诊断,并生成可直接发布的改写建议,只需一键即可推送到 Shopify 或 WooCommerce。

方案支持先进行免费检测,付费版本(Compete 每月 $14.90、Scale 每月 $44.90、Dominate 每月 $149)则提供更深入的竞品分析和持续重新扫描,详情均列在我们的 定价页面。如果你想先了解商品信息优化功能,我们的 AI 商品信息优化页面 详细介绍了模拟与发布工作流。
常见问题
AI 购物智能体真的会阅读评论内容,还是只看星级评分?
智能体不仅会读取评论文本,还会利用其中内容进行证据选择,而不只是看平均星级。OpenAI 的购物文档确认,ChatGPT 在生成商品摘要时,会把评论与价格、商家元数据一起纳入考量;而关于证据选择的研究也表明,相比泛泛好评,模型更偏向包含具体优点、缺点和风险提示的评论内容。
商品需要多少条评论,评分分布才会发挥作用?
Baymard Institute 的研究建议,当商品评论少于五条时隐藏评分分布摘要,因为小样本容易同时误导购物者和模型。在达到这个数量前,有代表性的定性评论比评分分布图更有价值。
激励式评论会影响我的 AI 购物可见性吗?
以评论倾向为条件提供奖励的评论,受到 FTC 关于虚假和激励评论的规定限制,而平台也越来越重视真实性,因此以“给好评”为条件的激励机制同时存在法律与可见性风险。通过合规、无条件方式征集的评论,通常更容易成为智能体愿意引用的证据。
AI 生成的评论摘要会取代人工评论吗?
不会。关于 AI 生成摘要的对照研究发现,它们会提高评论数量,并鼓励评论者补充更丰富、更互补的细节,而不是取代人工评论。先展示人工评论、再展示 AI 摘要,通常比只依赖其中任意一种更能建立信任。
如何判断评论改动是否真的提升了 AI 购物引用?
最直接的方法,是在改动前后对同一批商品抽样查看智能体摘要,并检查引用证据是否发生变化。按照我们的 AI 搜索可见性衡量指南,跟踪智能体带来的访问会话和订单,也能在引用检查之外提供明确的归因信号。再配合 90 天可见性测试计划 ,有助于更系统地安排实验周期。
参考来源
以下是支撑上述观点的主要参考资料。如果你正在搭建或检查评论体系,建议收藏。