

如果想被 ChatGPT、Gemini 或任何 AI 购物智能体选中,影响最大的单一因素不是巧妙的营销文案,而是一份干净、规范、唯一的结构化商品记录。这意味着您需要 JSON-LD 或正确的 feed,其中包含准确的标识符、最新库存状态,以及把事实前置的纯文本描述。请以智能体实际会解析的标准为基础:OpenAI 商品 feed 规范、Shopify Catalog,以及像 product_highlight 和 question_and_answer这样的对话式字段。之所以会有 Ecentic 这样的工具,是因为大多数店铺都会在这些地方出错,而这些错误在智能体悄悄跳过它们之前往往看不出来。
要点速览:
- 要获得 AI 推荐,关键是确保商品数据具备准确的标识符、结构化 schema 和前置的事实信息,因为智能体依赖这些数据,而不是营销语气。
- 标题不一致、库存状态过期或缺少 GTIN,都可能让您的商品即使描述写得不错,仍被排除在智能体推荐之外。
- Shopify 天然更支持结构化数据,而 WooCommerce 往往需要额外插件和正确的属性映射,才能优化商品发现和选择相关字段。
- 定期用模拟工具测试商品目录,有助于找出阻碍您的商品出现在 AI 驱动搜索和推荐中的结构性缺口。
- AI 生成的描述应以事实优先、规格优先为核心,再结合人工补充的差异化细节,才能同时最大化智能体解析效果和人工信任。
AI 智能体如何读取商品描述并用于 AI 推荐?
AI 购物智能体浏览您的店铺时,并不会像真人用户那样操作。它会先将购物者的问题重写为结构化查询,提取具体“槽位”(品牌、价格上限、颜色、尺寸、材质),然后用这些槽位匹配您的商品数据,之后才会考虑描述语气或营销文案。关于商家-智能体架构的研究表明,这种约束通常通过确定性的 SQL 或知识图谱查询实现,而不是仅靠语言模型猜测。在一项 混合多智能体框架消融研究中,移除 SQL 层约束后,品牌匹配准确率从完美的 1.000 降至 0.684。简单来说:如果缺少严格的数据规则,智能体就会开始推荐本应被排除的商品。
这一区别会直接影响您修复问题的优先级。您的商品数据实际上承担着两种不同任务:
- 发现字段 决定商品能否进入候选池:JSON-LD 标记、公开 Feed 端点、站点地图条目,以及一个
llms.txt文件,用于告诉智能体您的商品目录在哪里。 - 选择字段 决定商品进入候选池后能否被选中:价格、实时库存状态、GTIN 或 MPN、AggregateRating,以及与购物者指定内容完全一致的品牌数据。
即使商品描述写得再出色,如果页面缺少 GTIN 且库存状态过期,也会输给一个文案普通但字段填写正确的商品信息。对话式属性可以缩小两者之间的差距。Google 关于 Merchant Center 对话式属性 的指南允许您提供简短的问答对和商品亮点,用于解决原本需要智能体猜测或向购物者进一步确认的歧义。澄清问题越少,通常意味着越快获得直接推荐。
商品数据检查清单应包含哪些内容?
在修改任何营销文案之前,先修复结构层。大多数商家都把顺序搞反了:他们反复润色句子,却忽略了 schema。
- 统一商品标题。 在店铺、Feed 和 schema 标记中,为每个商品使用统一且一致的标题。智能体会交叉比对标题、品牌和类目;如果不一致,它们会被视为多个较弱信号,而不是一个强信号。
- 在描述开头优先写明事实。 在第一句话中写清材质、尺寸、兼容性和使用场景。OpenAI 的 Feed 规范允许最长 5,000 字符的纯文本描述,但智能体会优先关注开头几行。
- 补全 GTIN、MPN 和 SKU。 这些标识符能帮助智能体确认您的商品确实是购物者要找的商品,而不仅仅是相似商品。
- 实时同步价格和库存状态。 库存状态过期,是商品被悄悄排除出候选范围的最快方式之一。
- 为每个变体单独编写描述。 商品 Feed 规范 支持按变体设置字段和媒体数组,因此“蓝色、中码”这样的变体可以拥有自己的准确信息,而不是继承通用父级描述。
- 添加
product_highlight和question_and_answer字段 ,适用于商品确实容易引起混淆的情况(如版型、兼容性、成分)。
以下是面向智能体的文案在实际中的写法:
服装: “男士美利奴羊毛圆领毛衣, 100% 澳大利亚美利奴羊毛,冷水机洗。常规版型,标准尺码。提供海军蓝、炭灰色和燕麦色,尺码从 S 到 XXL。”
配件: “不锈钢表带,20mm 快拆针,适配 Fossil 及兼容 fusion 风格表壳。拉丝表面,可调节适合 6.5 至 8.5 英寸腕围。”
消耗品: “深度烘焙整豆咖啡,12 oz 包装,危地马拉单一产地,每周新鲜烘焙。适用于滴滤、法压和意式研磨。”
这些描述都优先提供智能体匹配槽位所需的事实信息,而不是情绪氛围。
专业提示: 将 JSON Feed 托管在稳定且公开的 URL 上,并在站点根目录的 llms.txt 文件中明确引用。智能体会优先抓取该文件,如果引用损坏或缺失,即使您的 Feed 完美无缺,也可能根本不会被发现。
Shopify 和 WooCommerce 商家应优先修复什么?
这两个平台的基础能力差异很大,因此快速见效的方法也会因店铺所用平台而不同。
Shopify 商家应:
- 确认 JSON-LD Product schema 已正确渲染在正式商品页面上(Shopify 默认会注入,但某些主题可能会覆盖或移除它)。
- 为每个 SKU 填写 GTIN 和 metafields,而不仅是主打商品。
- 启用 Shopify Catalog 或提供公开商品数据源,让 AI 购物智能体获取结构化且已映射到分类体系的数据,而不是抓取页面文本。
- 添加一个
llms.txt文件,指向您的 Feed 和站点地图。
WooCommerce 商家应:
- 安装 schema 或 JSON-LD 插件,因为 WooCommerce 不会像 Shopify 那样自动注入结构化数据。
- 将商品属性映射到正确的 schema.org 属性,而不是保留为非结构化自定义字段。
- 提供稳定、智能体可读取的 JSON Feed,而不是依赖默认 XML 商品导出。
- 在站点根目录添加同样的
llms.txt引用。
无论使用哪个平台,都要确保 Feed、店铺以及所有第三方渠道中的价格和库存状态保持同步。为每个变体设置独立元数据,而不是统一使用一个通用描述;同时编写准确描述实际商品的图片 alt 文本,而不是只写文件名。根据 Shopify、BigCommerce 和 WooCommerce API 访问能力的对比,智能体会在结构化数据不足时,将 alt 文本作为备用信号。
如何衡量 AI 推荐率?
看不到的问题就无法修复,而由智能体驱动的流量往往隐藏在分析系统中,因为这些系统原本并不是为了区分普通机器人抓取、引荐点击和 AI 流量而设计的。
首先,标记 user agent 字符串与已知 AI 爬虫匹配的会话,并在分析系统中将这些流量与普通机器人噪音分开。然后:
- 针对自己的商品目录运行模拟测试,查看智能体在您所在类目的常见查询下会推荐哪些商品,而不是等到流量下滑后才被动发现问题。
- 对两种描述版本进行 A/B 测试:一种以事实优先,另一种以营销优先,并比较智能体在相同查询下更常选择哪一种。
- 将下游转化与 AI 智能体带来的原始访问量分开跟踪。某个描述如果能获得更多推荐却导致转化下降,需要的修复方式,与推荐较少但转化优秀的描述完全不同。
在这里,持续重新扫描比一次性检测更重要。随着模型更新,智能体行为会发生变化;而多智能体约束框架会在匹配结果少于三个时,按顺序放宽限制条件。这意味着,即使您没有做任何修改,商品也可能被纳入或排除在候选范围之外。定期重新扫描的模拟工具,能在问题真正影响收入之前发现这种偏移。
AI 编写的商品描述比人工编写的转化效果更好吗?
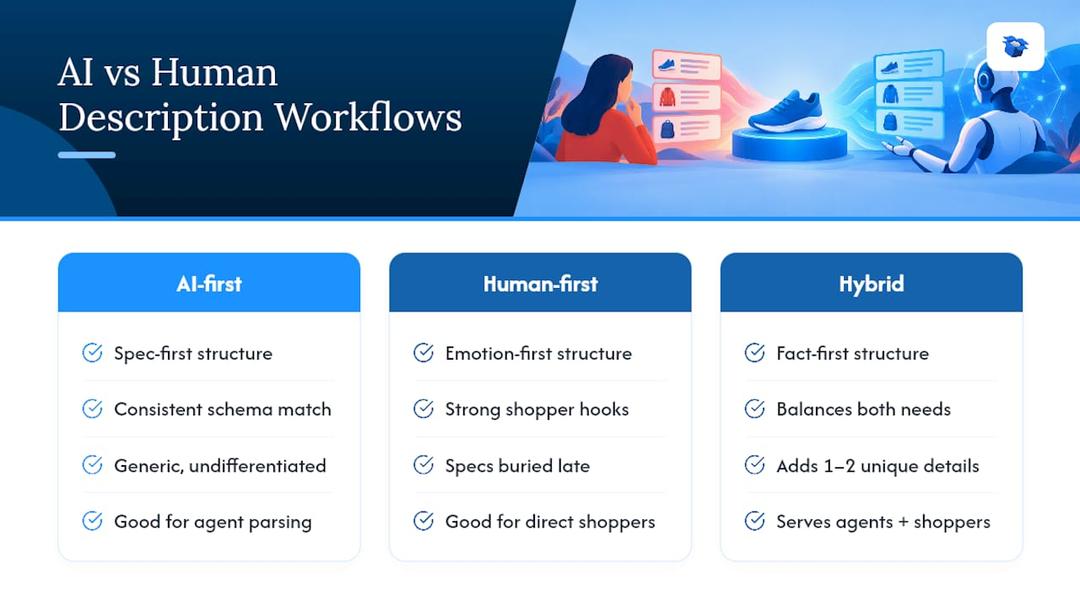
两者并不存在绝对胜负,而且这个问题本身也有些偏差。真正的问题不是“AI 对比人工”,而是描述是否符合智能体解析文本的方式,以及真人用户随意浏览时的阅读方式。
面向浏览型购物者的人类文案,通常会先强调情绪吸引和生活方式场景。这种风格在用户直接访问商品页时可能转化效果很好。但对于执行槽位提取的智能体来说,表现往往较差,因为智能体需要的信息(材质、尺寸、兼容性)被埋在第三段,而不是第一句话。
AI 生成的描述在结构层面通常更快、更一致,能够清晰列出规格,并稳定匹配 schema 字段。但风险在于过于泛化。如果一段描述像模板拼接而成,缺乏任何区分细节,那么对于价格相近的五个竞品 SKU,智能体就无法判断您的商品有什么不同。
对于 AI 驱动流量,更实际的做法是:无论初稿由谁或什么工具生成,都先采用“事实优先、规格前置”的结构,再由人工编辑补充一两个真正体现商品差异化的细节。这种混合方式通常既能满足智能体的解析需求,也能满足真人购物者对可信度的需求,而不会牺牲任何一方。
AI 编写商品描述有哪些法律风险?
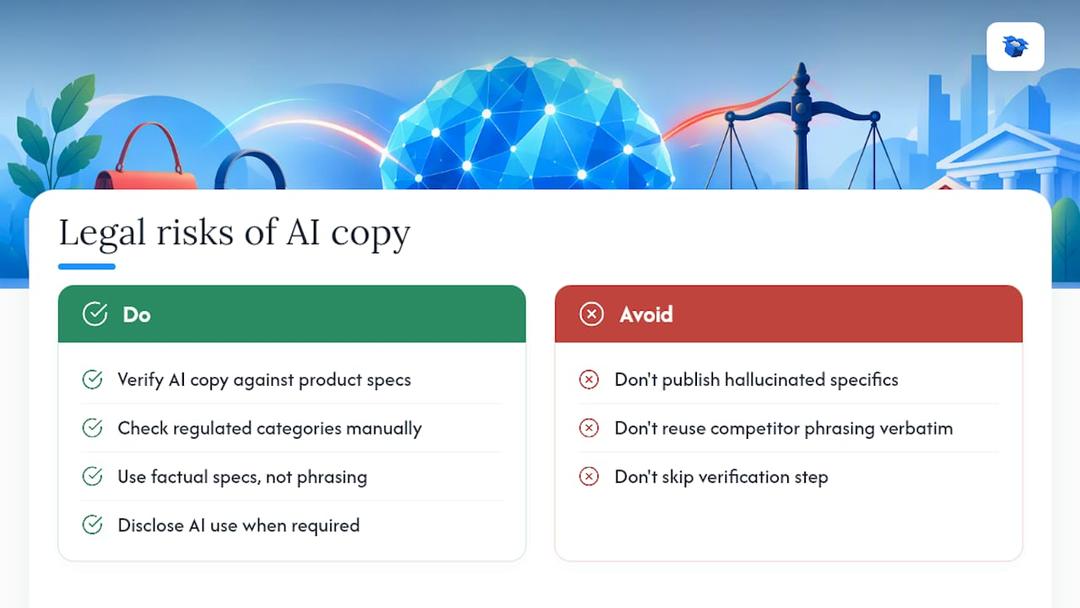
即使一句描述由语言模型生成,准确性责任也不会因此改变。如果 AI 生成的描述夸大了材质声明、认证资质或兼容性承诺,在大多数市场中,商家依然需要依据消费者保护法和广告法为这些声明负责。
实际中最大的风险是“幻觉式细节”。AI 工具可能会非常自信地生成某种面料成分、原产国或安全认证,但这些内容实际上并不适用于该商品,因为模型是在预测合理文本,而不是验证库存数据。发布前,务必基于真实商品规格对 AI 生成文案进行验证,尤其是食品、化妆品、保健品和电子产品等受监管类目。
另一个较小但真实存在的问题,是披露和原创性的伦理风险。即使 AI 工具是独立生成了相似文本,如果直接复用了竞品措辞,也可能因与受保护创意表达过于相似而引发版权争议。坚持使用自己的事实规格信息,让结构而非措辞承担主要作用,这类风险通常就会大幅降低。
视频和 3D 模型能帮助 AI 智能体理解商品吗?
多媒体有助于消费者作出购买决定,但它对 AI 购物智能体的价值,完全取决于是否有这些智能体实际能读到的文本描述。如果一个 3D 模型或商品视频没有配套的替代文本、说明文字或结构化 media 字段,那么无论视觉效果多好,这些内容目前对大多数 AI 购物智能体来说都不可见。
实际操作中,这意味着问题的关键不是“增加更多视频”,而是“描述视频内容”。OpenAI 的 Feed 规范支持在描述对象旁使用媒体数组,因此商品信息可以同时关联图片、视频和文字规格,而不是让它们作为页面中的孤立资源存在。
对于销售需要展示版型、质感或空间结构的商品(如家具、服装、五金)的商家,应将短视频或 3D 模型与简短文字说明配合使用,并明确写出其展示内容,例如:“360 度视角展示缝线细节和口袋位置。”这段说明文字,正是视觉资源与智能体文本理解之间的桥梁。如果缺少说明,那么即使这些媒体内容对浏览 JSON-LD 之外页面的真人购物者非常有帮助,对智能体而言也几乎等于不存在。
为什么模拟测试比猜测更适合用于 AI 推荐
大多数商家往往是在流量已经下滑之后,才发现自己的商品输给了竞品,这种方式是被动的。模拟测试则正好相反:您可以用真实的智能体查询来测试商品目录,提前准确发现哪些硬性条件(例如缺失 GTIN 或库存状态过期)会让商品失去竞争资格,而不是等到真实订单流失后才知道。
这正是 Ecentic 要解决的诊断缺口。它可直接连接 Shopify 和 WooCommerce 店铺,运行模拟测试,并用清晰易懂的方式展示按优先级排序的修复建议。已有商家反馈,在完成类似修复后,AI 驱动访问量和后续销售额都出现了可量化增长,这也符合本文所述:智能体的选择机制对结构化细节极其敏感。
— Xhurian
进行免费检测,查看 AI 智能体实际看到的内容
目前已经有专门工具用于回答一个问题:是什么阻止 ChatGPT、Gemini、Claude 或 Perplexity 推荐您的商品?这类工具不会靠猜测哪个字段有问题,而是会针对您的实时商品目录模拟真实智能体查询,按影响程度排序修复项,并允许您将修正后的数据重新发布到 Shopify 或 WooCommerce 店铺。

这种“模拟、诊断、发布”的闭环流程,使它区别于普通 AI 文案工具。它不仅仅是生成更好听的句子,而是专门解决商家智能体约束层会检查的具体缺口,并能量化提升胜率。您可以先进行免费检测,查看商品目录的优先修复项,然后再决定 Compete、Scale 或 Dominate 套餐 是否比基于 AI 归因订单的按量计费更适合。您还可以在决定之前,先了解完整的 商品信息优化功能。
FAQ
什么是面向 AI 智能体的商品描述?
面向 AI 智能体的商品描述,是一种结构化、事实优先的商品记录,结合纯文本描述、schema 标记以及 GTIN、MPN 等标识符编写,方便智能体提取槽位并确认匹配结果。它与面向浏览型购物者的文案不同,因为智能体会先解析结构化字段,再考虑营销语言。
哪些字段对 AI 商品推荐最重要?
商品被发现后,价格、实时库存、GTIN 或 MPN 以及品牌数据会影响其是否被选中;而 JSON-LD 标记和公开商品数据源有助于商品首先被发现。类似 product_highlight 和 question_and_answer这样的对话式字段,由 Google 的 Merchant Center 指南定义,可在这些核心字段基础上进一步减少歧义。
Shopify 和 WooCommerce,哪个更利于 AI 发现商品?
根据针对 AI 智能体 API 访问能力的平台对比,Shopify 默认会自动注入 JSON-LD Product schema,并提供 Shopify Catalog 用于结构化数据映射;而 WooCommerce 通常需要安装 schema 插件并手动映射属性。只要配置正确,两者都能达到相同水平,只是 Shopify 起点更接近终点。
ecentic 的价格是多少?
ecentic 提供免费初始检测,付费套餐包括每月 $14.90 的 Compete、每月 $44.90 的 Scale,以及每月 $149 的 Dominate。对于更偏好按使用量计费而非固定月费的商家,还提供按量付费选项:每个 AI 归因订单收取 3% 的绩效费用。
在修改之前,我可以先测试 AI 智能体如何看待我的店铺吗?
可以。模拟工具允许您针对现有商品目录运行真实智能体查询,查看哪些商品会被推荐、哪些会被排除,以及原因是什么,而无需先发布任何修改。这个诊断步骤能将猜测变成按优先级排序的修复清单,而不是盲目重写每个商品页面。