

在所有销售渠道保持价格一致、设置感知阈值的底价,以及提供完整且 AI 可读的商品数据,这三项措施最能稳定地推动您的 SKU 进入 AI 购物智能体的推荐结果。三项都做到,您才能进入评分范围;缺少任何一项,智能体甚至还没把您与竞品对比,就会先把您过滤掉。
三项可立即执行的动作:
- 先落实价格一致性 覆盖您的 Shopify 或 WooCommerce 店铺、Google Shopping Feed,以及任何电商平台上的商品信息页。 跨渠道价格不一致 会使购买完成率下降约 23%。
- 设置感知阈值的底价 让 SKU 的价格略低于常见查询的筛选阈值(“低于$50”、“低于$100”),而不是比阈值高出一美元。
- 发布完整的结构化商品数据 (JSON-LD、完整属性字段、清晰标题),这样智能体才有可能为您的商品信息评分。
核心要点
价格一致性、感知阈值的底价和完整的结构化数据,是让您的 SKU 进入 AI 智能体推荐结果的三个不可妥协的基础。
| 要点 | 详情 |
|---|---|
| 先落实价格一致性 | 根据 Perplexity 的商家分析,跨渠道价格不一致会使购买完成率下降约 23%。 |
| 设置感知阈值的底价 | 将价格设在常见查询筛选条件(“低于 $50”)之下,这样智能体才会纳入您的 SKU,而不是把它过滤掉。 |
| 发布完整的结构化数据 | JSON-LD 和完整属性字段是前置门槛;数据缺失往往意味着智能体会完全跳过对您商品信息的评分。 |
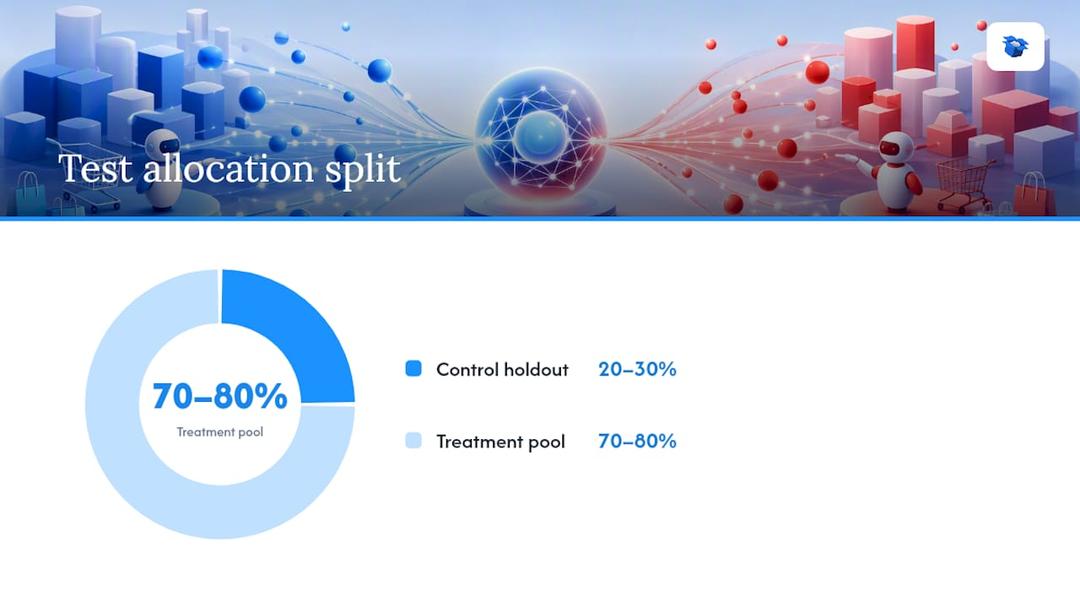
| 每次只测试一个变量 | 至少运行两周的随机选择集测试,并设置 20%–30% 的保留组,以隔离由智能体驱动的影响。 |
| 使用 ecentic 持续监控 | ecentic 会模拟 ChatGPT、Gemini、Claude 和 Perplexity 的智能体评分,并在商品信息发生任何变更后自动重新检测。 |
AI 购物智能体定价到底需要什么?
这份清单涵盖了影响智能体选择的关键因素。请将每项标记为“已完成”“进行中”或“未开始”,并按顺序从上到下执行。
快速见效项(几分钟到几小时):
- 价格一致性检查。 从店铺前台、Google Shopping feed 以及所有正在使用的市场渠道拉取实时价格。如果价格不一致,先修复 feed。
- 阈值底价检测。 找出所在品类最常见的价格筛选条件(例如“低于 $30”“低于 $75”“低于 $150”)。定价应等于或略低于相关阈值,而不是高于它。
- 星级评分高于 4.0。 智能体会高度重视评分。如果平均评分低于 4.0,应优先获取更多评价,再进行其他商品信息优化。
- 评论数量基线。 评论数量过少会降低被选中的概率。即使只是从 3 条评论提升到 25 条,也会在 智能体评分实验.
- 标题完整性。 商品标题中应包含品牌、型号、关键规格和主要使用场景。智能体会把标题解析为结构化信号。
需要工具或自动化支持(数天到数周):
- 每个商品页都部署 JSON-LD schema。 缺少它时,许多智能体无法为你的商品信息评分。
- 推荐标签和徽章可见性。 “Overall Pick”“Best Seller”等标签能提高价格空间。请在 feed 和页面标记中展示这些标签。
- 持续监控价格一致性。 人工检查容易偏离。应设置自动化 feed 对比,或使用支持定时重新检测的平台。
- 智能体归因跟踪。 无法衡量,就无法优化。应为店铺配置归因机制,将智能体带来的流量与自然流量和付费流量区分开。
专业建议: 底价应设为略低于阈值的 $X.99,而不是刚好卡在阈值上。筛选“低于 $50”的智能体会包含 $49.99 的 SKU,却会排除 $50.00。仅依赖成本加成逻辑,往往会比预期更容易落到筛选条件之外。
AI 购物智能体究竟如何给商品评分?
智能体不像人类那样浏览商品。它们会基于 feed 和页面标记中的属性运行结构化评分卡,再使用类似加权效用模型的方法对候选商品进行排序。哥伦比亚商学院的研究证实,不同智能体模型对同一属性的权重不同,这意味着只针对某一个智能体优化、忽略其他智能体,会带来真实风险。
在所有测试模型中,价格都是负向权重。评分和评论数量是正向权重。搜索结果中的位置以及推荐标签会增加效用,从而抵消更高的价格。
关键发现: ACES 随机实验报告显示,不同智能体模型和商品群组的价格弹性估计值大约在 −1.6 到 −2.8 之间。在其他条件相同的情况下,价格上涨 10%,会使被选中的概率下降 16%–28%,具体取决于模型。
| 属性 | 对被选中的影响方向 | 证据来源 |
|---|---|---|
| 价格 | 负向(强) | ACES / arXiv 实验 |
| 星级评分 | 正向(强) | ACES / arXiv 实验 |
| 评论数量 | 正向(中等) | ACES / arXiv 实验 |
| 商品信息排名位置 | 正向(依赖模型,影响大) | 哥伦比亚商学院 |
| 推荐标签(“Overall Pick”) | 正向(非常大,依赖模型) | ACES / arXiv 实验 |
| 结构化数据完整性 | 门槛条件(评分所必需) | AgentMint 从业者总结 |
哥伦比亚的研究明确指出:智能体会先检查数据完整性,再考虑价格。缺少属性的商品信息并不是得分较低,而是很多时候根本不会被评分。
定价策略手册:按影响力排序的七大策略
先解决价格一致性。在所有渠道价格保持一致之前,其他优化的重要性都排在后面。
优先策略:
- 优先确保跨渠道价格一致。 Perplexity 的商家分析发现,DTC 店铺、Google Shopping 和市场渠道商品信息之间的价格不一致 会抑制购买完成率 约 23%。在进行任何其他定价优化前,先解决这个问题。
- 设置考虑阈值的底价。 梳理所在品类的常见搜索筛选条件,并将价格设定在各个阈值之下。这不是为了打折,而是为了保持在筛选范围内。
- 利用推荐标签争取价格空间。 ACES 实验显示,“Overall Pick”这类标签能带来非常大的价格空间,在某些模型中,甚至足以抵消相较无标签竞品的明显溢价。请在 feed 标记中展示所有已获得的徽章。
- 用捆绑销售建立价格锚点。 一个售价 $89 的捆绑套装放在售价 $59 的单品旁边,会让智能体在解析相对价值时认为单品更划算。智能体会读取结构化数据中的锚定信号。
- 围绕智能体查询窗口运行限时促销。 在购物高峰期被调用的智能体,会更重视价格变动的新鲜度。智能体扫描时正在生效的临时折扣,往往比六个月前设定的长期价格更有优势。
- 只有在弹性数据支持时,才进行永久性价格重定位。 将 −1.6 到 −2.8 的弹性区间作为规划输入。如果所在品类中,降价 10% 带来的选择率提升不足 16%,那就不值得牺牲利润。
- 在设置防护条件的前提下启用智能体动态调价。 自动化动态调价 相比人工规则响应更快,但前提是竞品和库存数据足够干净。在启用任何自动调价之前,务必先设置明确的利润底线。
这确实代表着价格空间,但区间范围很大,而且依赖具体模型。
如何测试价格调整对 AI 购物智能体的影响
运行随机选择集测试。向智能体展示镜像商品集,其中只有测试变量(价格、徽章、描述)发生变化,然后测量选择率、转化率以及 AI 归因订单。
编号测试设计:
- 每次测试只定义一个变量。 可以是价格、推荐标签或描述改写。不要同时修改两个变量。
- 建立保留组。 保留 20%–30% 的 SKU 使用对照价格,以获得清晰的基线。
- 至少持续完整两周。 时间更短的测试窗口,容易受到星期效应和促销噪音干扰。
- 在 SKU 层级进行随机化, 而不是品类层级,以避免位置因素干扰。
- 开始前先配置智能体归因。 如果没有 智能体流量跟踪,你测量的只是整体转化,而不是智能体驱动的转化。
| 指标 | 定义 | 测量方式 |
|---|---|---|
| 智能体选择率 | 智能体查询中你的 SKU 被选中的 % | UCP/profile 字段标签 + 智能体归因日志 |
| 智能体转化率 | 智能体引荐会话带来的订单 / 智能体会话数 | UTM 参数 + 智能体引荐来源 |
| AI 归因收入 | 已确认由智能体驱动订单带来的收入 | 带智能体来源筛选器的归因仪表板 |
| 价格空间变化值 | 每 % 价格变动对应的选择率变化 | 基于测试群组数据的条件 Logit 模型 |
常见陷阱:测试期间的位置变化会污染价格结果。同期进行的季节性促销会同时抬高两个实验组的转化率。避免在大型促销活动期间启动测试。
Shopify 和 WooCommerce 实施清单
推送 AI 可读取的商品 schema,确保 feed 价格一致,并启用持续重新检测。这是简化版。下面是具体执行方法。
第 1 天:
- 安装或验证 JSON-LD schema 插件。在 Shopify 上,可使用 Schema Plus 或 TinySEO 等应用处理。在 WooCommerce 上,Yoast SEO 或 Rank Math 在正确配置后会自动生成商品 schema。请按照 结构化数据清单 检查所有必填字段。
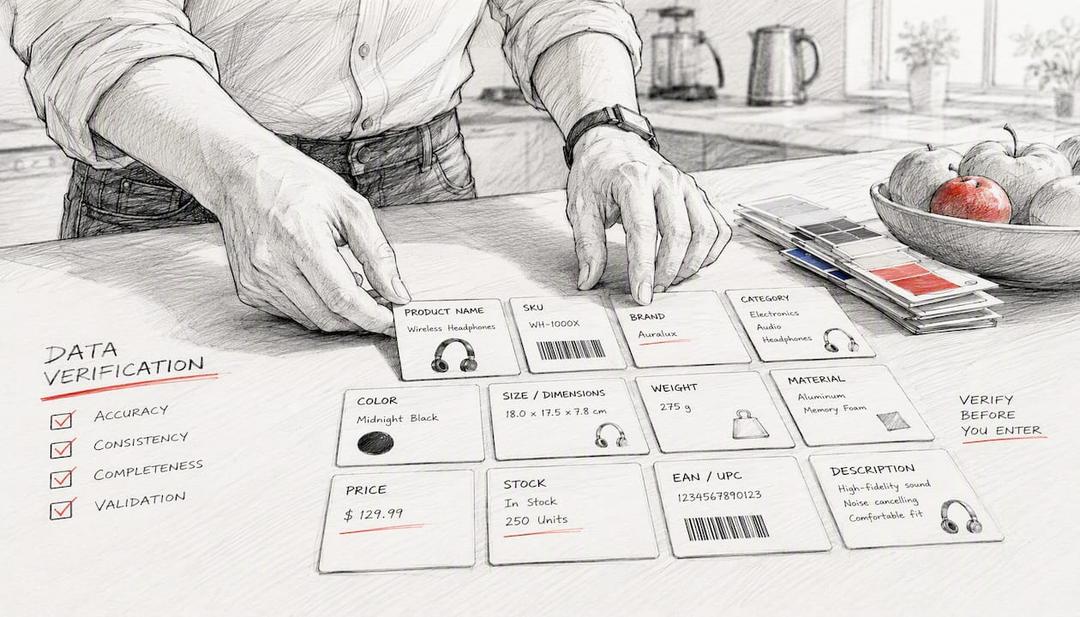
- 检测商品 feed 中缺失的属性:GTIN、品牌、商品状态、库存情况和价格。智能体会将这些字段作为门槛条件。
- 设置价格一致性监控。从 Shopify 或 WooCommerce 导出当前价格,并与 Google Shopping feed 以及所有正在使用的市场渠道 feed 进行对比。
第 1 周:
- 如果平台支持,请补充 UCP(Universal Commerce Profile)字段。这些字段能让智能体读取超出标准 schema 之外的结构化商品上下文。
- 在商品页添加徽章和推荐标记。如果你获得了“Best Seller”或“Overall Pick”等称号,它必须出现在结构化数据中,而不只是页面上的视觉元素。
- 将店铺接入智能体归因系统。对于 WooCommerce, Ecentic 的 WooCommerce 集成 可处理 feed 连接和重新检测调度。
第 1 个月:
- 启用自动价格一致性监控,并在价格偏差超过设定阈值时触发提醒(1%–2% 是合理的触发范围)。
- 安排持续重新检测,确保价格或描述发生变化后,商品信息评分会自动更新。
- 查看 AI 商品信息诊断 ,找出哪些属性正在拉低你的评分卡。
智能体模型更新后,哪些环节会失效?
模型更新会改变属性权重。某个模型版本中偏向首位商品信息的位置偏差,在下一个版本中可能会减弱甚至反转。那些过度针对单一模型权重优化、却没有监控其他模型的商家,往往会在一夜之间失去曝光。
需要关注的主要风险:
- 位置偏差变化。 哥伦比亚商学院的研究记录了明显且依赖模型的位置效应。当模型更新时,即使你没有做任何调整,商品位置带来的价值也可能发生变化。
- 价格一致性失效导致被压制。 如果促销结束后价格偏离一致性范围,智能体可能会降低商品信息优先级,甚至直接排除。
- 微小价差导致误判。 在某些智能体模型中,店铺前台与 feed 之间仅有 $0.50 的差异,就足以触发价格一致性标记。
- 描述内容陈旧。 智能体会定期重新扫描。六个月前优化过的描述,在模型更新后,由于文本信号解析方式变化,评分可能已经不同。
预警检查清单:
- 每周:检查所有活跃渠道的价格一致性。
- 每两周:为前 10 个 SKU 运行一次智能体模拟查询,并与上一周期比较选择率。
- 每月:检查智能体归因数据,查看智能体引荐会话是否出现异常下滑。
- 任何模型更新公告发布后:重新运行完整模拟测试套件,再判断评分是否稳定。
当模型更新改变竞争格局时,你需要保留重新定价的空间,而不是被迫亏损。那些利润底线设置过紧的商家,会发现自己如果不手动干预,就无法做出调整。*
可以期待什么样的结果?
结果应当以现实为基础,而不是保证。这才是更准确的表述。
ACES 实验显示,在特定品类和模型组合中,改写描述和标题能够带来两位数的选择份额增长,有些修改甚至能让份额提升 30 多个百分点。但也有很多修改完全没有可测量的效果。这些收益具有明显差异性:在消费电子品类有效的方法,在服饰品类可能毫无作用。
参考区间: ACES 实验中的价格弹性估计值介于 −1.6 到 −2.8 之间。对于在某个品类中售价 $45、且弹性为 −2.0 的商家来说,降价 $5(11%)预计会使被选中的概率提高约 22%,前提是其他条件不变。
现有证据真正支持的结论:
- 执行价格一致性管理,能稳定且可量化地提升购买完成率。Perplexity 商家分析中的 23% 抑制数据,是目前从业者研究中最明确的单一指标。
- 推荐标签能够创造可观的价格空间,但具体幅度取决于模型和品类。
- 结构化数据完整性是门槛条件,而不是差异化优势。没有它就无法竞争,但拥有它也不意味着一定会被选中。
- 许多单独的优化措施在孤立情况下并不会产生效果。这套策略的价值在于系统协同,而不是一组彼此独立的杠杆。
结果会因品类、智能体模型和竞争密度而异。应运行自己的测试,而不是假设实验平均值一定适用于你的 SKU。
关于 ecentic 如何看待这个问题
真正能从这套策略中获得最大收益的商家,是那些把智能体优化视为持续流程,而不是一次性修复的人。在 ecentic,模拟引擎会同时在 ChatGPT、Gemini、Claude 和 Perplexity 上运行选择集测试,因此你能在真实智能体查询发生之前,就看到哪些商品信息会赢、哪些会输。持续重新检测意味着,只要价格或描述发生变化,就会自动触发新的诊断。模拟 + 价格一致性监控 + 自动重新检测的组合,能够降低模型更新导致数月优化成果被清零的风险。这正是上面这套策略希望补齐的闭环。
ecentic 提供这套策略所需的模拟层
大多数商家仍在手动执行这套策略:导出 feed、检查价格一致性、改写描述,然后希望下一次 智能体会话示例 下一次检测结果会更好。ecentic 用系统化方式取代了这种碰运气的流程。连接 Shopify 或 WooCommerce 店铺后,ecentic 会模拟 ChatGPT、Gemini、Claude 和 Perplexity 当前如何为你的商品信息评分,并以通俗易懂的方式诊断哪些因素正在拉低商品信息评分。

价格一致性监控会持续运行。系统会建议描述和标题改写,并支持一键发布。智能体归因功能会告诉你,哪些 SKU 真正被智能体会话推荐并完成购买。对于已经读完这套策略、并希望建立完善测量基础设施的商家来说,免费商品检测是最快了解当前状态的方法。
常见问题
AI 购物智能体如何决定推荐哪些商品?
智能体会基于结构化属性为商品信息评分,包括价格、星级评分、评论数量、商品信息位置和推荐标签。商品 feed 的完整性是门槛条件;缺失字段通常意味着商品信息根本不会被评分。
最影响 AI 购物智能体推荐的定价错误是什么?
跨渠道价格不一致。在进行任何其他定价优化之前,先解决价格一致性问题。
价格对 AI 购物智能体的选择概率影响有多大?
ACES 随机实验报告显示,不同智能体模型中的价格弹性估计值介于 −1.6 到 −2.8 之间。
“Overall Pick”这类推荐标签能抵消更高的价格吗?
可以,在某些模型中影响非常明显。ACES 实验显示,推荐标签能够创造可量化的价格空间,这意味着带标签的商品即使价格高于无标签竞品,仍然可能被选中。具体效果取决于模型。
ecentic 如何帮助商家针对 AI 购物智能体进行优化?
ecentic 会模拟 ChatGPT、Gemini、Claude 和 Perplexity 如何为你的商品信息评分,提供通俗易懂的诊断结果,并在价格或描述发生变化后自动重新检测。它还会监控跨渠道价格一致性,并支持 Shopify 和 WooCommerce 店铺一键更新商品信息。