

AI可读的商品页,会把核心事实、价格、库存状态、规格和商品标识以直接文本和结构化数据的方式呈现出来,而不是埋在图片或脚本里。影响最大的单项修复,是发布准确的JSON-LD Product schema,并让文案开头先给出答案。下一步是运行schema检查或可读性扫描,看看ChatGPT、Gemini或Perplexity当前访问您的页面时,实际能看到什么。
简述:
- 发布完整且准确的JSON-LD商品schema,并保持SKU和变体数据一致,能确保AI购物智能体直接从您的页面稳定提取核心事实。
- 将尺寸、颜色、价格等可见属性以清晰、带标签的文本呈现,而不是藏在图片或脚本中,能让AI系统更容易核实关键细节。
- 加入结构化FAQ和评价数据,再配合有描述性的alt文本和语义化HTML,可以提升AI购物智能体核实并引用您的商品信息的能力。
- 定期扫描schema与可见内容之间的不一致,可以发现阻碍AI发现和推荐的关键缺口。
- 速度、可抓取性和服务器响应时间也会影响AI可见性,因此服务端渲染和正确的技术配置对实现最佳表现至关重要。
为什么AI可读性现在会影响发现与销售
传统SEO优化的是点击。AI驱动的发现优化的是引用:让智能体读取您的页面,提取一个事实,并直接引用它,或据此判断是否向用户推荐您的商品。这是完全不同的游戏规则:页面在Google里可能排名不错,但如果关键信息藏在由JavaScript渲染的轮播组件里,或埋在没有可提取细节的营销文案段落中,AI智能体仍然可能直接跳过。
这种转变正在一个已经发生变化的搜索环境中展开。 Generative Engine Optimization 普林斯顿的这项研究把目标说得很直接:用直接文本呈现商品身份、属性、价格和库存情况,并以核心schema栈作为支撑,这样语言模型就能把您的商品视为一个结构化实体,而不是一大段需要自行解释的文字墙。
这里的商业逻辑很直接。引用带来推荐,推荐带来销售,而从您的商品数据到AI智能体解析器之间,每多一层模糊性,就多一层收入损失。把这件事当成可选项的商家,实际上会对越来越多的一类消费者变得几乎不可见——这些消费者现在会直接让智能体替他们挑一个。
现代AI智能体究竟如何读取商品页面
AI系统读取商品页面的方式并不像人眼那样扫视。根据对 AI究竟如何读取商品页面.
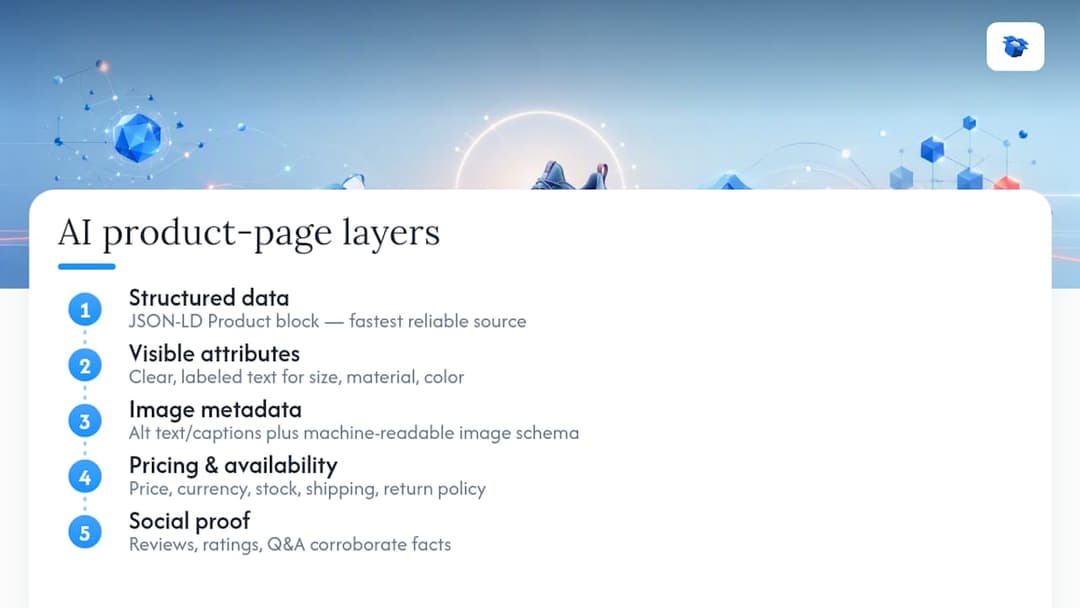
第一层 是结构化数据。只要实际存在且内部一致,JSON-LD的Product区块就是智能体最快、最可靠的可解析事实来源。
第二层 是可见属性。尺寸、材质、颜色和兼容性需要以清晰、带标签的文本形式出现,而不是通过图片或尺码表图片来暗示。
第三层 是图片及其元数据。替代文本、图片说明,以及任何直接嵌在图片里的可见规格,只有在schema中也有与图片对象关联的机器可读描述时,才真正算数。
第四层 涵盖价格、可售情况和商家可靠性:当前价格、币种、库存状态、发货时效和退货政策。智能体会权衡这些信息,因为它们可以作为一次推荐能否真正转化为完成订单的判断信号。
第五层 是社会证明:评价、评分,以及能回答消费者(或代表消费者行事的智能体)在特定情境下会提出的问题的问答内容。 Practical Ecommerce的分析 对大型电商平台商品信息的研究发现,胜出的页面会把高密度属性数据与评价和FAQ结合起来——这种冗余恰恰能帮助AI系统在足够信任并加以引用之前,先跨多个层次相互印证同一个事实。
技术检查清单:应公开什么,以及如何公开
让商品页面具备机器可读性,不是一个重设计项目,而是一个数据规范项目,大部分工作都在schema和标记中,而不是视觉设计中。
先从JSON-LD结构开始。至少,您的 Product schema需要包含 name, description, sku, brand,以及一个包含 offers 对象,其中包含 price, priceCurrency和 availability。再加入站点级别的 Organization schema,以及 BreadcrumbList ,这样智能体才能理解商品在您的商品目录中的位置。Schema.org的Product参考是所有字段名称和预期格式的权威来源,值得收藏起来,而不是凭记忆猜属性名。
以下是按优先级排序的重点:
- 发布
Product,Offer,Organization,BreadcrumbList以及FAQPage在每个商品URL上发布JSON-LD,而不只是部分页面使用 - 同时包含
sku或gtin,并在可见文本和 schema 中使用完全一致的值 - 通过独立 URL 或清晰的
hasVariant结构来建模商品变体(尺寸、颜色、套装),不要把所有变体放在同一个页面里,只靠下拉菜单中的 JavaScript 切换 - 把目前锁在图片、PDF 规格表或点击后才加载的折叠区域中的信息,迁移到可抓取的纯文本中
- 为每张商品图片添加描述性的 alt 文本和说明文字,并在 schema 中将这些图片引用为结构化
ImageObject条目 - 检查商家 feed(Google Merchant Center 或同类平台),确保价格、库存和标题与页面实时内容一致,而不是来自过期导出数据
变体规范化需要特别关注。如果同一件衬衫的红色中码和蓝色大码共用一个 URL,只通过客户端切换器变化,智能体就无法可靠确认它实际引用的是哪个商品报价。使用独立的变体 URL,或结构清晰的 hasVariant 关系即可解决这个问题。我们的 电商商品页面结构化数据检查清单 会逐字段讲解具体实现,适合需要更深入技术参考的团队。
实用建议: 使用纯文本视图检查页面(在 DevTools 中禁用 JavaScript),确认价格、库存状态和 SKU 是否仍然可见。如果这些信息消失了,AI 爬虫大概率也无法读取。
撰写可提取而不只是可阅读的文案
优秀的 AI 可读文案与高转化文案之间的差距,比大多数团队想象得更小。关键在于结构:每个部分先给出明确答案,再补充说服性的营销语言。
与其用“专为舒适而设计,经久耐用”作为描述开头,不如直接写“这是一款 14 盎司保温钢瓶,可保冷 24 小时”。前一句能为智能体提供可引用的事实,后一句则没有任何可提取的信息。 Netguru 的 UX 写作研究 也从用户体验角度得出了同样的结论:AI 可读设计与优秀的 UX 写作并不冲突,它们本质上是同一种能力。减少空话,对两者都有帮助。
以下几个具体习惯会带来明显差异:
- 把尺寸、材质、保修条款和兼容性放在简短的标签字段中,而不是写成长段落
- 添加简洁的 FAQ 区块,回答场景化问题(例如“是否适配 16 英寸 MacBook Pro?”),因为这类问题与用户向智能体提问的方式高度一致
- 保持商品目录、商品 feed 和网站文案中的命名一致。同一个页面叫“无线充电板”,另一个页面却写成“WCP-100 充电器”,会同时让用户和解析系统产生混淆
- 每个标题下的第一句话都放最重要的事实;关于 AI 搜索行为 的研究表明,系统更偏向于优先提取前一百个词内直接回答隐含问题的内容
我们的 AI 购物智能体商品信息优化指南 提供了更多商品信息改写前后的示例,方便参考实际应用效果。
智能体真正会参考的评价与信任信号
评价不只是提升转化的装饰。当用户问“这商品好吗?”时,它还是智能体可引用的证据。在 schema 中暴露 aggregateRating ,并搭配少量可见的评价摘录,而不是只有一个没有任何文字支撑的星级图标。
问答区块有双重作用:既能捕捉用户与 AI 助手交流时的真实表达方式(例如“这个能用于燃气灶吗?”),也能为智能体提供可直接引用的回答。除了评价之外,运营信号同样重要,包括准确的库存数量、真实的配送时间以及清晰的退货条款。评价审核应保持真实可信;一旦评分看起来虚高或模板化,无论是智能体还是用户,都会迅速失去信任。
快速见效:无需彻底重建,也能通过分阶段路线图逐步提升效果。先从验证并添加 Product JSON-LD 开始,在可见文本中展示 SKU/GTIN,添加 FAQPage 区块,并确认价格和库存状态以纯文本形式显示。接着规范变体数据、用真实描述重写 alt 文本、在 schema 中添加结构化图片对象,并清理 feed 导出数据以匹配实时内容。最后,统一分类体系、补充商品属性,并运行智能体模拟扫描来评估引用可见性。
这一阶段值得运行的工具包括:
- 在上线前捕获结构错误的 schema 验证工具
- 用于确认 feed 与页面数据一致性的商家 feed 检测工具
- 像 Ecentic 扫描那样的智能体就绪度模拟工具,用于查看每个商品的胜负结果,而不是靠猜测
我们的 ChatGPT 商品推荐实战手册 进一步拆解了相同的 30/60/90 阶段结构,并提供更细致的任务清单,适合作为团队执行文档。
模拟驱动诊断能发现验证工具遗漏的问题
schema 验证工具只能告诉您标记语法是否正确,却无法判断 JSON-LD 是否与用户或智能体在页面上实际看到的内容一致。而大多数 AI 可见性问题,恰恰就藏在这个差距里。
Ecentic 的模拟扫描会模仿 ChatGPT、Gemini、Claude 和 Perplexity 实际评估商品信息的方式,并输出通俗易懂的胜负诊断,而不是简单的 schema 通过/失败结果。根据 Mirakl 对 AI 商品可见性的分析,真正能提升智能体引用率的,是那些能发现跨内容一致性错误的就绪度分析工具,例如 schema 显示一个价格,而页面上却是另一个价格。
商家通常能从扫描中了解到:
- 竞品商品信息具备但当前商品缺失了哪些具体事实
- schema 与可见文本之间哪些地方存在矛盾
- 哪些 feed 缺口阻碍了准确的价格或库存信号传递给智能体
按出现频率优先修复问题:先处理影响 SKU 数量最多的缺口。
AI 可读性的无障碍设计考量
无障碍标记与 AI 可读性解决的是高度重叠的问题:两者都要求内容以清晰、结构化的文本形式存在,而不是被困在视觉元素中。ARIA 角色、语义地标以及适配屏幕阅读器的标记原本是为辅助技术用户设计的,但它们恰好也能生成 AI 解析器最偏好的明确文档结构。
一个商品页面如果在交互元素上正确使用 aria-label 属性、正确关联表单标签,并具备合理的标题层级,无论是屏幕阅读器还是 AI 爬虫,都能清晰理解页面重点。如果您的尺码选择器只是一些没有标签的 div 元素,并通过样式伪装成按钮,屏幕阅读器就无法提供有效信息,而解析 DOM 的 AI 智能体也会遇到同样的问题:没有任何语义信号表明这里是与特定商品报价关联的变体选择器。
实际修复方式几乎与标准无障碍检测完全一致:为每个表单控件添加标签,使用真正的 <button> 和 <select> 元素替代纯样式化的 div,并确保图片的 alt 属性描述的是商品本身,而不是重复文件名。跳转链接、正确的焦点顺序以及描述清晰的链接文本,都能减少辅助技术的歧义;而这种歧义的减少,也正是帮助语言模型提取准确事实、而不是仅凭页面布局猜测意图的关键。可以把无障碍检测视为一举两得:一次优化,同时修复合规问题和机器可读性问题。
面向语音助手与对话式 AI 搜索的优化
语音搜索和对话式智能体会剥离页面中所有依赖视觉呈现的元素:没有图片、没有布局、没有颜色提示。剩下的只有智能体能够朗读或总结的文本,因此简洁、事实明确的句子变得更加重要。
与文本型 AI 搜索相比,最大的实际区别在于简洁性。语音助手在总结商品时,通常只会朗读一两句话,因此最重要的信息必须放在描述的第一句,而不是埋在几段品牌故事之后。“这款搅拌机配备 64 盎司容器和 1200 瓦电机”能够直接回答语音查询;而关于“释放您的烹饪潜力”的营销段落,则无法为语音助手提供任何可读内容。
FAQ 内容在这里更加重要,因为对话式查询往往直接以问题形式出现:“这款咖啡机有定时功能吗?”“这件夹克可以机洗吗?” 围绕用户真实对话表达来组织 FAQPage schema 和可见问答,而不是使用泛泛的营销问题,可以提高助手直接展示您答案的概率。回答要保持完整独立:语音助手不会朗读“请查看下方图表”,因为语音响应中根本不存在图表。
影响 AI 可读性的技术 SEO 基础
结构化数据最受关注,但在 schema 发挥作用之前,AI 爬虫首先必须能够访问并渲染页面。页面速度、可抓取性以及渲染行为,都是本指南其他可读性优化工作的前提。
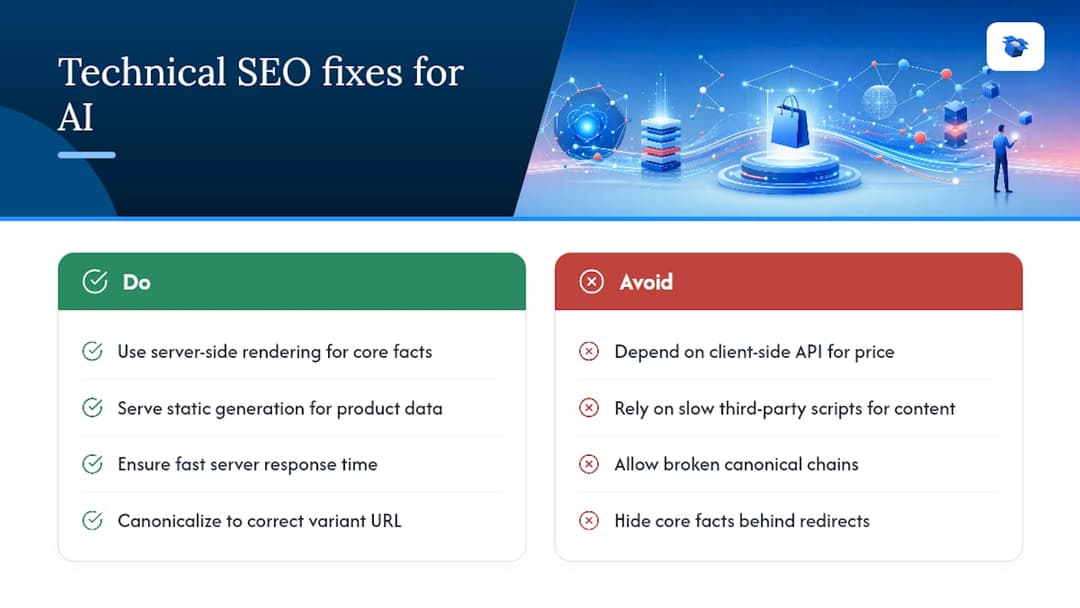
如果页面加载缓慢,爬虫可能在 JavaScript 执行完成前超时,从而导致部分内容无法渲染。这意味着任何通过客户端注入的信息——价格、库存状态、变体选项——都有可能根本不会出现在爬虫实际看到的内容中。对核心商品信息使用服务端渲染或静态生成,可以彻底消除这种风险。如果价格和库存状态只能在客户端 API 请求完成后才显示,应将其视为可读性缺陷,而不仅仅是性能问题。
基础的可抓取性原则依然适用:清晰的 robots.txt、准确的 XML sitemap,以及指向正确变体 URL 的 canonical 标签,都会决定智能体爬虫是否能够访问目标页面。错误的 canonical 链会悄悄让商品失去被考虑的机会,例如某个变体 URL 被 canonical 到完全不同的商品页面,无论页面 schema 多么完善都无济于事。
对 AI 爬虫而言,服务器响应时间的重要性远超大多数团队的认知,因为很多 AI 爬虫的超时预算比传统搜索引擎机器人更严格。一个经过多次重定向的商品页面,或者依赖缓慢第三方脚本才能完成核心内容渲染的页面,都可能在智能体提取任何信息之前就被直接放弃。
帮助 AI 理解内容的语义化 HTML 实践
语义化 HTML 在 JSON-LD 加载之前,就已经赋予页面结构明确含义。使用 <article> 作为商品区块容器, <h1> 作为商品名称,以及使用 <dl> (定义列表)元素来展示“材质:不锈钢”这类规格键值对,可以让解析器明确知道每段内容的角色,无需额外推断。
通用的 <div> 堆砌会迫使 AI 系统根据 CSS 类名或视觉位置猜测结构,而这种方式既不可靠,也无法跨网站保持一致。使用 <table> 展示尺码表,使用规范的 <ul> 或 <ol> 标记来呈现功能列表,而不是用换行段落模拟列表,以及使用 <figure> 配合 <figcaption> 来展示商品图片,都能将这种猜测几乎降到零。
一个值得养成的习惯:在商品标题下方,使用带清晰标题的语义化容器包裹核心规格信息,例如“商品信息”或“规格参数”,并与 JSON-LD 中的字段保持一致。可见的语义化 HTML 与结构化数据之间的这种冗余一致性,正是让 AI 智能体足够信任某个事实并愿意引用它,而不是直接跳过的关键。
品牌表达与机器可读性:真正的取舍
机器偏好具体信息,人类依然会被好故事打动。解决方法不是二选一,而是分层呈现:用面向用户的主视觉区块传达品牌感受,再用面向机器的规格区块清晰陈述事实。许多品牌把这视为妥协,但它更像是优秀写作习惯带来的清晰表达,而这种清晰对所有人都有帮助,包括那些在手机上快速浏览商品的用户。
一个实用的编辑规则:每二十个词至少包含一个明确、可验证的事实。如果一句话写了很长,却始终没有出现具体数字、材质或尺寸,那它大概率只是披着品牌表达外衣的空话。
— Xhurian
ecentic 如何帮助您的商品被 AI 购物智能体发现
本指南中的所有内容——schema 体系、多层信号、无障碍设计与可读性的重叠——最终都指向一个核心难题:如何准确知道哪些修复措施真正能改善您的商品目录表现。模拟扫描可以逐个商品告诉您,为什么智能体推荐了竞品,而不是您的商品。

您获得的不再是泛泛的 schema 分数,而是通俗易懂的胜负诊断、缺失的 SKU 数据、价格冲突提示,以及可一键直接发布到 Shopify 或 WooCommerce 的改写建议。持续重新扫描还能追踪每次修复后 AI 选择率是否提升,让您不必再靠猜测判断优化是否有效。
先从核心商品类目的免费扫描开始,修复诊断中标记为影响最大的项目,然后重新发布。查看 商品信息优化功能 ,了解一次扫描能够为商品目录发现哪些问题。
FAQ
什么样的商品页面才算“AI 可读”?
当页面中的核心信息——价格、库存、规格和商品身份——以直接文本和一致的结构化数据形式存在,而不是隐藏在图片、PDF 或解析器可能根本不会渲染的客户端脚本中时,这个页面就具备 AI 可读性。
如果文案里已经写了价格,还需要结构化数据吗?
需要。结构化数据与可见文本必须完全一致;智能体会交叉验证两者,而 JSON-LD 中的价格与页面显示价格不一致,是商品信息被跳过的最常见原因之一。
这与传统 SEO 有什么不同?
传统 SEO 的目标是排名和点击;AI 可读性的目标则是信息提取与引用——智能体会直接从您的页面提取具体事实来做推荐,用户甚至可能还没访问过您的网站。
现在最快如何检查页面是否具备 AI 可读性?
先对 Product JSON-LD 运行 schema 验证工具,然后在禁用 JavaScript 的情况下查看页面,确认价格、库存和 SKU 是否仍然可见。像 ecentic 这样的模拟驱动扫描还能进一步显示,智能体实际使用了哪些信息,又忽略了哪些信息。
修复这些问题也会提升传统 SEO 吗?
通常会。清晰的结构化数据、一致的属性以及先回答问题的文案,往往同时有助于提升传统搜索摘要和 AI 引用效果,因为两种系统都更偏好清晰、事实一致的内容,而不是模糊的营销语言。