

AI 竞品分析利用大语言模型、embeddings 和自动化数据管道,从几十个来源提取竞品信号,将其整合为通俗易懂的洞察,并将这些洞察直接推送到团队真正会打开的 Slack 频道、仪表盘和竞品作战卡中。它用更接近实时信息流的方式,取代了没人看的季度 PDF 报告。如果你现在就开始,接下来一小时先做三件事:
- 先选出 5 个你目前可以合法获取的数据来源(竞品网站、价格页面、App Store 评价、一个招聘网站、一个广告资料库)。
- 针对一个竞品执行一次抓取或手动采集,然后把原始文本粘贴到 ChatGPT 或 Claude,并附上摘要提示词。
- 把这份摘要整理成一页简报,发给团队中负责定位策略的人。
最后一步是本周值得尝试的一次快速验证:选一个竞争对手,花一小时,生成一份 AI 摘要,再判断结果是否确实改变了某项决策。如果改变了,您就已经在还没为工具花钱之前,验证了这套方法。
关键要点
当结构化数据采集接入评分系统,并且只把高优先级信号分发到团队已经在使用的格式中(如竞品作战卡和 Slack 提醒)时,AI 竞品分析才能真正发挥作用。
| 要点 | 说明 |
|---|---|
| 先从 5 个来源开始 | 在增加更多来源之前,先选定价格、评价、广告、商品页面和招聘信息。 |
| 先标准化,再自动化 | 把抓取到的文本整理成一致的字段结构,这样 LLM 生成的摘要才能保持准确。 |
| 给信号打分,不要对每一条都采取行动 | 使用加权公式,只有高影响变动才触发跨团队评审。 |
| 将洞察推送到现有工作流 | 作战卡和 Slack 提醒会被真正用起来;静态报告通常不会。 |
| 单独诊断 AI 智能体可见性 | Ecentic 会模拟 ChatGPT、Gemini、Claude 和 Perplexity 如何将您的商品信息与竞品对比评估,这是通用 CI 工具无法覆盖的信号。 |
AI 到底为竞品分析增加了什么?
坦白说,AI 带来的是速度和综合能力,不是魔法。过去分析师要花两天完成的工作(阅读十个竞品网站、给功能分类、起草摘要),现在只要数据收集完成,LLM 几分钟就能做完。瓶颈会从“把所有内容都读完”转移到“确保输入数据足够干净”。
与人工研究相比,AI 驱动的竞品分析真正改进的地方包括:
- 更快拆解竞品。 LLM 可以在一次提示中对比五个竞品的功能列表、价格层级和信息传达,而不必分别处理五份文档。
- 跨来源综合。 检索增强生成(RAG)让您通过一个问题,同时调取价格页面、评论和招聘信息,而不是手动把各个来源拼起来。
- 自动化监测。 定时抓取能在价格变动或新功能上线当天发现变化,而不是等到有人想起来才去检查。
- 可直接行动的作战卡。 相比一整墙项目符号,提示设计得当的模型可以直接输出“如果潜在买家提到 X,就回答 Y”,销售团队可直接使用。
- 可持续保留的上下文。 向量数据库意味着每个新数据点都会自动与历史数据对比,因此您看到的是趋势,而不只是某一时刻的快照。
但这些都不是零成本的。有两种失败模式反复出现,而且在您开始搭建任何系统之前,都值得先标出来。
数据质量与抓取伦理。 高频抓取竞品网站可能违反其服务条款,而从限制自动化采集的平台拉取评论数据也会带来法律风险。在自动化采集之前,务必先检查 robots.txt、速率限制和服务条款;如有官方 API,优先使用。
幻觉风险。 如果源文本有歧义或缺失,LLM 会很有把握地编造某项功能,或把价格说错。这是 AI 竞品分析在实践中失败的最大原因:团队相信 AI 生成的摘要,却不去对照实际来源页面核验。
凡是要进入面向客户的作战卡或汇报材料的内容,仍然需要人工核验。应把 AI 输出视为分析师要审核的草稿,而不是成品。Orbit Media 对快速 AI 评分方法的测试发现,这种 方法很适合做相对比较 ,但底层结论仍然需要人工做合理性检查。
如何运行由 AI 驱动的竞品分析工作流?
这套工作流包含八个步骤,而多数团队最后只得到一堆截图、没能做成可运行系统,原因就在于跳过了中间步骤(标准化、向量嵌入)。
- 发现阶段。 列出所有值得跟踪的竞品,并按威胁级别分层。不要用跟踪前三大竞品同样的力度去跟踪二十家公司。
- 数据采集。 从下一节列出的来源中抓取数据,并根据各来源的变化频率安排采集计划。
- 标准化。 将抓取到的 HTML、PDF 和截图转换为结构化文本,并使用一致的字段(竞品名称、日期、来源类型、原始内容)。
- Embeddings 和 RAG 索引。 将标准化后的文本切分为块,生成 embeddings,并存入向量数据库,这样 LLM 就能按需检索相关上下文,而不是每次都读取全部内容。
- LLM 摘要生成。 提示模型基于检索到的文本块生成摘要、功能对比或胜负诊断。
- 评分。 应用加权评分公式(下文会介绍),判断哪些信号现在就值得关注,哪些只需进入每月摘要。
- 分发。 将高优先级发现推送到 Slack 或 Teams;将低优先级事项分流到仪表板或每周邮件。
- 复盘节奏。 安排固定的每周或每两周会议,由市场、产品和销售团队一起查看系统标记的内容,并决定要采取哪些行动。
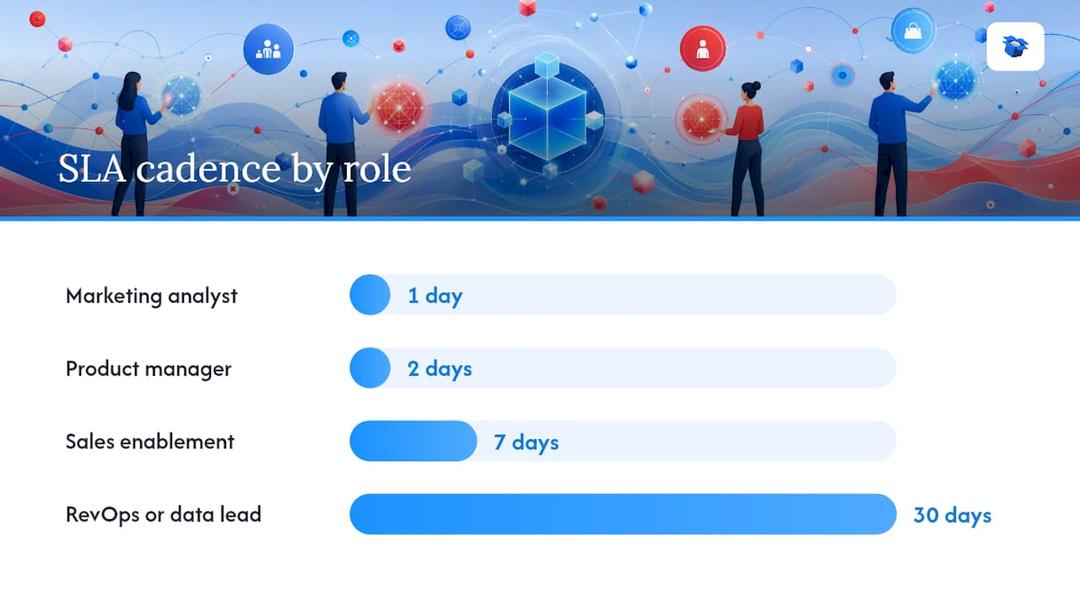
一个简单的责任矩阵可以避免流程沦为“人人都以为有人在盯”:
| 角色 | 任务 | 典型 SLA |
|---|---|---|
| 市场分析师 | 负责数据采集和标准化 | 每日检查,每周报告 |
| 产品经理 | 审阅功能差距相关发现 | 对已标记差距在 48 小时内响应 |
| 销售赋能 | 将诊断结果整理成战卡 | 每周更新一次 |
| RevOps 或数据负责人 | 维护向量数据库和自动化流程 | 每月数据流程检查 |
每个 sprint 都应产出一组固定输出:1 到 2 张更新后的战卡、一份针对有重大动作竞品的单页拆解、针对价格或功能变动的实时 Slack 提醒,以及一张展示过去 30 天趋势线的仪表板卡片。
实用建议: 爬虫调度应按变化速度来定,不要只图方便。价格页和广告资料库变化很快,适合按天甚至按小时轮询;招聘信息和 SERP 排名变化较慢,按周检查即可。把所有内容都设成每小时轮询,只会白白消耗算力,让提醒充满噪音。
哪些 AI 模型和提示词模式最适合这项工作?
实践中更可靠的架构通常是这样:抓取工具和 API 将原始数据送入 ETL 层做格式标准化;标准化后的文本经过 embeddings 处理后存入向量数据库;RAG 层在查询时检索相关文本块;LLM 在最后负责综合输出;然后由编排工具将结果路由到 Slack、仪表板或 CRM。
当你需要在一个持续增长的大型竞品内容库中进行查询时,应使用 embeddings 和 RAG(这样模型只会调取相关文本块,而不是每次都处理全部内容)。对于一次性任务,比如总结刚粘贴进来的一页内容,则可以直接提示 LLM,无需检索。向量数据库的重建索引节奏应与变化最快的数据源一致;如果你在跟踪价格,通常应按天更新。
以下这些提示词模式值得直接照搬:
高管摘要提示词: “请将以下竞品页面内容总结成一段,面向市场副总裁。重点关注定位变化、价格调整,以及任何关于性能或 ROI 的新声明。标记出任何看起来夸大或无法验证的内容。”
战卡生成提示词: “基于所附的 [Competitor] 功能列表和定价,生成一张战卡,包含以下部分:他们的优势、他们的弱点、我们在 [specific feature] 上的对比情况,以及当这个竞品在交易中出现时,销售代表可使用的一条沟通要点。”
功能提取提示词: “从这个产品页面中提取一张结构化功能表。列包括:功能名称、描述、适用套餐层级,以及自 [last date checked] 以来它是否为新增功能。”
胜负诊断提示词: “根据这份提到 [Competitor] 的已丢单备注列表,找出最常见的三条异议,并按出现频率排序。”
Slack 自动提醒提示词: “如果该页面价格与上次记录的数值不同,生成一条两句话的 Slack 提醒,说明旧价格、新价格以及变动百分比。”
Orbit Media 的测试发现,当你让 AI 聊天机器人按照一套简单的 1 到 10 分标准、基于少数几个维度为竞品打分时,只要每次使用同一套评分规则,就能得到出乎意料地稳定且有据可依的对比结果。关键不在于模型更高级,而在于提示词结构稳定、可重复,而不是每周都改写一次。
如何给竞品信号打分并排定优先级?
并不是每一个竞品动作都值得发 Slack 提醒、拉起作战会议。一个简单的加权评分系统,可以避免团队把一篇普通博客文章和一次重大降价同等对待。
按照潜在业务影响,对每条传入信号进行加权评分:
- 与核心用例匹配的功能发布: 权重为8到10(如果面向您的主要买家画像,影响较高)。
- 价格变动: 权重为7到9(如果压低了您的主力价格档位,权重更高)。
- 大规模广告投放加码: 权重为5到7(表明获客策略发生了值得关注的变化,但通常不算紧急)。
- 负面评价激增: 针对竞品时权重为4到6(机会信号);如果涉及您自己的产品,则为9到10。
- 招聘模式变化(例如销售岗位突然大幅扩招): 权重为3到5(早期信号,单独出现时很少紧急)。
设定阈值分层,把评分转成行动:低于4分进入月度汇总,4到7分在48小时内触发一页简报,超过7分则立即触发由销售和产品参与的跨团队评审。
取平均并根据共现情况调整后,这个信号大约落在8.5分,明显高于评审阈值。正确的响应不是在Slack里回一个表情,而是产品、定价和销售管理层在同一周内开会,决定是跟进、差异化应对,还是按兵不动。
AI 竞品分析应该用哪些工具?
合适的工具取决于您要解决工作流中的哪个环节,对小团队来说,第一天就买一整套一体化企业套件通常是个错误。 美国商会面向小企业的指导 也指向同一个方向:先用精简、聚焦的工具组合,随着流程成熟再逐步扩展。
下面按类别拆解,并说明在投入预算前该检查什么:
- 爬虫和 API: 这是采集层。要检查它们是否清楚说明速率限制,以及提供的是结构化 JSON 输出,还是需要您自己解析的原始 HTML。
- SEO 和流量数据集: 像 Ahrefs Ahrefs 和 Semrush 可以提供反向链接画像、关键词排名和预估流量,其中 Semrush 尤其把流量、关键词和广告数据与内置监控提醒整合在一起。
- 流量与市场基准对比: Similarweb 是竞品间预估流量规模和渠道结构对比的标准参考。
- 社媒监听: Sprout Social 覆盖各社交渠道的互动追踪和情绪分析,适合在竞品活动势头出现在其他地方之前先捕捉到信号。
- LLM 提供方: ChatGPT 和 Claude 是目前最广泛用于摘要、信息提取和作战卡起草的两个模型,而且两者对大多数竞品拆解所需的长上下文文档处理能力都足够。
- 自动化拆解平台: 像 Competely 这样的工具主打跨多类数据点、即时且持续监控的竞品报告,这能作为一个有用的参考,让您了解报告层面的“自动化”大致是什么样。
- 向量数据库与编排: 连接您的数据、LLM 和结果输出渠道(Slack、仪表盘、CRM)的基础设施层。
如果您在评估选项,Zapier 的工具盘点是一个不错的入门短名单;而在投入预算前,再用 G2 评价交叉核查这份短名单,能发现供应商营销页面不会展示的风险信号。如果您的业务以电商为核心,而您最关心的是 AI 购物智能体是否会推荐您的商品而不是竞品,这就不同于通用竞品研究工具,像 ecentic 这样的平台就特别契合这类场景。
把这些环节串起来是这样的:爬虫和 API 将数据送入 ETL 层,标准化后的数据进入向量数据库,RAG 层按查询检索相关上下文,编排工具再把 LLM 的输出推送到团队真正会看到的渠道。
如何把 AI 洞察转化为团队行动?
再好的模型生成的洞察,如果没人采取行动,也毫无价值。从“AI 标记了某件事”到“有人因此改变了决策”之间的这道鸿沟,正是大多数竞品情报项目悄无声息失败的地方。
销售对战卡要能在真实销售通话中派上用场,就必须包含明确字段,而不只是做成一份信息性文档:竞品名称和层级、我方前三项差异化优势、对方前三项优势、价格对比快照、常见异议及回应,以及“最后更新”日期,让销售知道内容是否已经过时。防守打法要直接回应竞品优势(“对方会提到上线更快,这是我们的回应”)。进攻打法则要突出对方无法匹配的能力(“优先强调我们的实时归因,这是他们任何档位都不提供的”)。
对于 Slack 或 Teams 通知,结构比数量更重要。有效的通知应包含竞品名称、检测到的变化、来源链接,以及一条建议的后续动作,并发送到负责该决策的具体频道(例如价格变动发送到定价频道,而不是通用营销频道)。
明确责任归属,才能避免通知变成所有人都忽略的噪音:
- 每个竞品指定一位负责人,而不是由某个人笼统负责“竞品情报”。
- 设定响应 SLA:高优先级通知需在 24 小时内确认,中优先级需在一周内确认。
- 要求每条已处理的通知都补充一条结果说明(采取了什么行动,或为什么决定不采取行动),形成闭环。
- 每月检查“通知到行动”的转化比例。如果 90% 的通知都被忽略,需要调整的是评分阈值,而不是增加更多通知。
行业实践者反复验证的规律其实都一样:竞品情报只有嵌入团队已经在使用的工具和流程中,才能真正发挥作用,而不是被存进一个没人打开的文件夹。
应用到电商场景会是什么样?一个简短案例
一家中型 DTC 服饰品牌是从一个不太常见的角度发现这个问题的:它并不是在 Google 搜索中输给竞品,而是在消费者向 ChatGPT 和 Gemini 询问商品推荐时,被竞品抢走了机会。传统竞品分析(SEO 排名、广告投入、社交互动)根本无法解释,为什么 AI 购物智能体总是推荐竞争对手那款几乎相同的商品,而不是它自己的。
该品牌将自己的 Shopify 店铺 接入 ecentic,通过模拟分析 AI 购物智能体如何在其商品页面与指定竞品之间进行比较和评估。平台诊断结果指出了几个具体问题:缺少 AI 智能体用于比较材质和尺码的结构化属性;商品描述过于简略,模型无法引用具体信息;以及页面中的价格信息缺乏清晰、可解析的格式。
团队利用通俗易懂的胜负诊断结果,优先修复流量最高的十个商品页面,而不是试图一次性重做整个商品目录。重写建议可直接通过 ecentic 的一键发布功能 同步到 Shopify 后台,平台的持续重新扫描功能则会跟踪这些页面在后续评估周期中的 AI 选择率是否提升。
平台早期客户反馈的趋势性结果:完成商品信息调整后,AI 智能体带来的访问量和后续销售额都出现了可衡量的增长,但具体数据会因店铺和品类而异,因此品牌应以自身的初始检测结果作为参考基准,而不是行业平均值。
集成方式和最终结果同样重要。由于重写内容可以直接发布到线上店铺,因此无需再经过单独的 CMS 流程,也不会出现建议等待开发人员处理的情况。每次发布后系统都会自动重新扫描,这意味着团队几天内就能看到某个商品页面调整是否提升了 AI 智能体的选择率,而不用等上几个月。正是这种反馈闭环,才是通用竞品分析工具无法提供的,因为它们并不是为模拟 LLM 如何读取和排序特定页面而设计的。
前 90 天应该如何推进?
相比第一天就试图搭建完整流程,分三个阶段推进通常更有效。
第 1 到 30 天(负责人:营销主管): 选出 3 到 5 个核心竞品。手动从五个主要来源收集数据。首次运行 LLM 摘要时,可直接将内容粘贴到 ChatGPT 或 Claude 中处理。先产出一份销售对战卡。
第 31 到 60 天(负责人:营销主管 + 数据或运营人员): 为变化最快的两个来源(通常是定价和广告)实现自动化采集。搭建基础向量数据库。创建第一条 Slack 通知规则。建立每周复盘会议。
第 61 到 90 天(负责人:跨部门团队,包括产品和销售): 将自动化覆盖扩展到所有核心来源。实施评分公式和阈值-行动映射。正式确定责任归属和 SLA。向管理层提交首份月度趋势报告。
建议保留一个精简的提示词库,覆盖前文提到的五类常见模式(高管摘要、销售对战卡生成、功能提取、胜负诊断和通知生成),另外再增加一种适合自动化阶段的模式:规范化提示词,让模型在写入向量数据库之前,先将抓取到的文本转换成统一的 JSON 结构。
对于这种结构,大多数团队使用简单的 Schema 就足够:
| 字段 | 示例值 |
|---|---|
| competitor_name | “Acme Co.” |
| source_type | “pricing_page” |
| source_url | “https://example.com/pricing” |
| date_collected | “2026-02-14” |
| raw_content | “完整提取文本……” |
| change_detected | “true” |
| score | “7.5” |
只要持续按照这种结构输入数据,即使几个月后已经忘记某个数据点的上下文,你的 LLM 摘要和向量搜索依然能够保持可靠。
从小规模开始,比等待“完美系统”更有效
大多数团队在验证流程是否真正创造价值之前,就已经过度建设。我更愿意看到营销人员先用一个简陋版本跑两周,而不是花一个月评估向量数据库供应商。先从一个竞品、五个数据源和一个 ChatGPT 摘要提示词开始。如果这些都无法影响真实决策,那么再多自动化也无济于事,因为问题不在于速度,而在于这些洞察本来就没人会采取行动。
小团队真正容易踩的坑,并不是缺少工具,而是数据质量逐渐失控。你一开始可能只有三个来源、数据干净且带时间戳,但六个月后,可能就变成了一个塞满半标注截图的文件夹,以及一个没人阅读的 Slack 通知频道。解决方法不是增加更多自动化,而是建立纪律:每新增一个数据源,都必须先定义来源字段和采集频率,再接入系统,而不是事后补救。
当第一份销售对战卡真正改变了销售对话,或者第一次价格通知促成了真实的价格复盘时,从个人项目扩展为跨部门协作计划会自然发生。这才是让产品和销售正式成为利益相关方,而不只是报告接收者的信号。在还没有任何明确成果之前就急着搭建责任矩阵,只会给一个尚未获得认同的系统增加流程负担。
ecentic 如何融入你的 AI 竞品分析流程
本指南讨论的是广义上的竞品情报,但有一个战场并不是通用工具为之设计的:当消费者向 ChatGPT、Gemini、Claude 或 Perplexity 等 AI 购物智能体寻求商品推荐时,它们如何决定推荐哪款商品。Ecentic 专门模拟这一决策过程,帮助你看到自己的商品信息在 AI 智能体评估中,相对于指定竞品是胜出还是落败,而不仅仅是传统搜索排名中的表现。

ecentic 可直接连接 Shopify 或 WooCommerce 店铺,并直接嵌入上述流程:它负责运行模拟(数据采集与评分由系统完成)、提供通俗易懂的胜负诊断(预置好的 LLM 分析层),并支持一键发布商品信息重写内容(无需等待开发人员上线修改)。持续重新扫描会跟踪每次调整后 AI 选择率是否提升,从而形成通用 SEO 或社交监听工具无法衡量的反馈闭环。
对于已经在执行本文所述整体流程的电商团队来说,ecentic 解决的是一个很容易被忽视、却越来越决定销售来源的信号:你的商品在 AI 智能体推荐中的呈现效果。先进行一次免费的商品信息检测,了解当前页面相对于竞品的表现,再决定优先修复哪些问题。
AI 竞品分析下一步怎么做
在搭建自己的流程时,以下资源值得收藏,它们分别覆盖了不同环节:
- Zapier 的竞品分析工具汇总,是快速建立初始工具候选清单的好方法。
- 美国商会关于小企业 AI 工具的指南,适合刚起步、暂时不想购买企业级套件的团队。
- Orbit Media 关于 AI 驱动评分的实战指南,提供了适用于快速品牌对比的具体提示词示例。
- 如果你需要在一个平台中整合流量、关键词和广告监测,可以考虑评估 Semrush 的竞品研究套件。
- Babylovegrowth 的竞品内容分析指南 详细说明了如何系统化提取 SEO 和内容信号。
在自动化任何抓取工具之前,先检查目标网站的服务条款和 robots.txt,并确认所选工具的 API 速率限制,避免项目进行中访问权限被撤销。
来源
并非所有来源都值得投入同样的关注。价格页面和广告库变化很快;招聘信息和外链画像变化较慢。只有让采集频率与各来源真实变化速度匹配,系统才能保持有效,而不会变成噪音。
以下几个采集习惯,往往决定系统是长期可靠,还是悄悄滑向一堆垃圾数据:
这里还需要特别提一下评价平台和买家目录。 像 G2 这样的同行评测网站 以及 Capterra 不仅有助于优化你自己的产品定位,还能帮助理解买家是如何用自己的语言描述竞品的,而这正是 LLM 特别擅长处理的非结构化文本。
FAQ
什么是 AI 竞品分析?
它利用 LLM、Embedding 和自动化数据管道,从价格页面、评价和广告等来源收集竞品信号,再将其整合为销售对战卡、通知等可执行且有优先级的输出。
哪些 AI 工具最适合做竞品分析?
ChatGPT 和 Claude 擅长摘要与信息提取;Semrush 和 Ahrefs 适合 SEO 与流量数据;Similarweb 用于流量估算基准;Sprout Social 提供社交监听;Competely 则可自动生成完整的竞品拆解报告。
AI 竞品分析在电商领域有什么不同?
电商品牌如今不仅要争夺搜索排名,还越来越需要争取在 ChatGPT、Gemini 等 AI 购物智能体中的曝光,因此需要像 ecentic 这样的工具,来模拟这些智能体如何评估和推荐商品信息。
竞品数据应该多久更新一次?
像价格和广告素材这类变化快的信号,适合按天或按周轮询;而外链和招聘信息等变化较慢的信号,则按月更新即可。
抓取竞品网站是否合法?
这取决于网站的服务条款、采集的数据类型以及所在司法辖区。务必查看 robots.txt 和服务条款,并在可用时优先使用官方 API。
小团队不使用企业级工具也能做这件事吗?
可以。将 SERP 数据、广告库、招聘信息等公开来源与 LLM 驱动的摘要分析层结合,即使第一天没有一体化企业套件,也能获得有价值的信号。