

はい。robots.txtは、AIクローラーに対してページのインデックス登録や学習利用を許可するかどうかを伝える標準的な方法ですが、遵守は任意です。たとえば GPTBot のような名前付きトークンを使えば、学習クローラーをブロックしつつ、AI検索結果でページを引用してほしい場合は検索向けトークンの許可を維持できます。このファイルで非準拠のボットを物理的に止めることはできませんが、主要なAIベンダーはどこもその内容を文書化し、遵守しています。
要点:
- robots.txtはドメインのルートに配置し、サブドメインごとに別ファイルを作成してください。ディレクティブ名は大文字・小文字を区別するため、User-agentとDisallowは必ずその表記どおりに書く必要があります。
- OpenAIは検索クローラーと学習クローラーを分けているため、学習をブロックしながら検索での引用は許可できます。変更の反映には約24時間かかる場合があります。
- GoogleのAI学習制御は、Googlebotの検索クロールには影響しません。Anthropicを除外するには、両方の学習クローラーそれぞれに別のルールが必要です。
- 許可しない設定にしたページでは noindex タグをクローラーに見せられないため、HTMLページには meta ディレクティブを、PDFや画像には HTTP ヘッダーを使ってください。
- robots.txtでは機密コンテンツを保護できず、非準拠のボットも止められません。非公開の素材には認証を使い、リクエストが続く場合はCDNまたはWAFでブロックしてください。
AIクローラーをブロックまたは許可する、コピーして使えるrobots.txt設定例
robots.txt ファイルはドメインのルート(yoursite.com/robots.txt)に置き、サブフォルダには置きません。サブドメインごとに個別のコピーも必要です。ディレクティブ名と User-agent トークンは大文字・小文字を区別するため、 Disallow と User-agent は表示どおり正確に記述する必要があります。ただし、記載するパスはサーバー構成に応じて変わる場合があります。
トレーニング用クローラーをブロックしつつ検索での可視性を保つ最小構成は、次のとおりです。
User-agent: GPTBotの後にDisallow: /を指定して OpenAI のトレーニング用クローラーを除外します。User-agent: OAI-SearchBotの後にAllow: /を指定して ChatGPT の検索結果に表示され続けるようにします。User-agent: *の後にAllow: /を指定すると、検索エンジンを含む一般的なクローラーが引き続き全面的にアクセスできます。
AI トレーニングを完全にオプトアウトしたいサイトでは、フォールバック用のブロックリストとして Disallow: / を各トレーニング用の名前付きトークン(GPTBot、Google-Extended、ClaudeBot など)の下に繰り返し記述し、検索エンジン向けにはワイルドカードグループを開放したままにします。保守的な「何もブロックしない」テンプレートでは、名前付きグループ自体を省略し、 User-agent: * に Allow: /だけを使います。これは robots.txt ファイルをまったく追加しない場合のデフォルト状態です。
ファイルは短く保ちましょう。 Search Engine Land は、許可してよいすべてのクローラーを明示的に allow しようとするのではなく、除外したい特定のトレーニング用トークンだけを disallow することを勧めています。広い allow リストは保守が難しく、サイト全体を誤ってブロックする原因にもなりやすいためです。
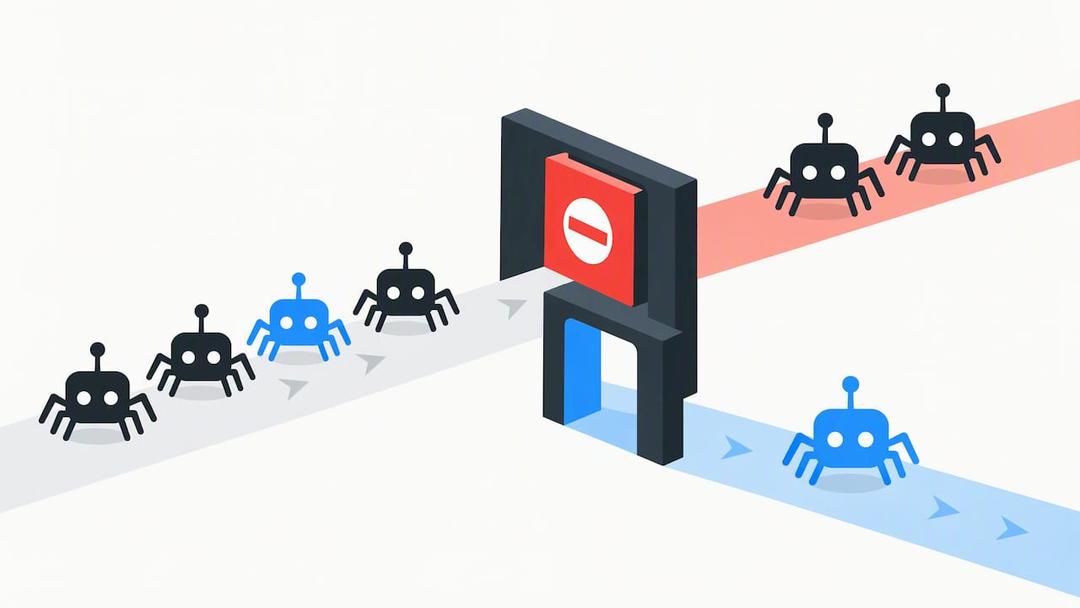
ヒント: robots.txt を新しく編集したら、まずステージング用サブドメインで毎回テストしてください。ワイルドカードの置き方を誤ると、除外したかった AI クローラーだけでなく Googlebot まで誤ってブロックしてしまうことがあります。
User-Agent トークンと優先ルールの仕組み
robots.txt の解析には厳密なルールがあり、そこを間違えるだけで、検索エンジンを意図せず簡単に締め出してしまいます。 RFC 9309では、user-agent トークンに使えるのは英字、アンダースコア、ハイフンのみです。そのため、トークン名の中でワイルドカードを使うのは無効です。対象にしたいクローラーは、それぞれの正確な名前で個別に列挙する必要があり、まとめてパターンマッチさせることはできません。
どのグループとルールが実際に適用されるかは、いくつかのルールで決まります。
- たとえば
User-agent: GPTBotのような名前付きグループは、その特定のクローラーに対してはワイルドカードのUser-agent: *グループより優先されます。 - 複数の
DisallowまたはAllowルールが URL に一致しうる場合は、ファイル内で先に書かれているかどうかに関係なく、最も長く一致するパスが優先されます。 - 末尾の
$は、ルールをパスの正確な末尾に固定します。これにより、ディレクトリ全体に影響させず、特定のファイルタイプだけをブロックできます。
トークン名を一文字でも間違えると、そのクローラーは意図したルールではなく、ワイルドカードグループにフォールバックします。
知っておきたいベンダー別 Robots.txt エントリ
主要な AI ベンダーはそれぞれ独自のトークンを公開しており、それらが必ずしも単一のボットに直接対応するとは限りません。 OpenAI は OAI-SearchBot を検索インデックス用に使い、 GPTBot をトレーニングデータ収集用に使っています。両者は独立して制御されるため、一方を許可して他方を拒否できます。どちらのディレクティブの変更も反映までに 最大 24 時間ほどかかる場合がありますと OpenAI 自身のドキュメントにあるため、ファイルを編集した直後にクロール動作が即座に変わるとは考えないでください。
Google の Google-Extended は、個別の HTTP リクエストエージェントではなく制御用トークンです。これは Google の AI 製品がコンテンツをトレーニングや生成機能に利用できるかどうかを管理するもので、Googlebot は引き続き独自のルールで検索向けクロールを行います。
User-agent: GPTBotにDisallow: /を指定すると、OpenAI のトレーニングをオプトアウトしつつOAI-SearchBotには影響を与えません。User-agent: Google-ExtendedにDisallow: /を指定すると、通常の検索インデックスには影響を与えずに、Google の AI トレーニング利用をオプトアウトできます。User-agent: anthropic-aiとUser-agent: ClaudeBotは Anthropic のクローラーに対応しており、通常は両方に明示的なDisallow指定が必要です。トレーニング対象から除外したい場合に設定します。User-agent: Applebot-Extendedは、メインのApplebotとは別に、Apple の AI トレーニング利用を制御します。こちらは Siri や Spotlight に使用されます。- Perplexity のクローラーでは、非準拠事例が報告されているため、エッジレベルの制御と組み合わせる価値があります。 報告 では、disallow ルールがあるにもかかわらず、クローラーがページ取得を継続した非準拠事例が紹介されています。
Robots.txt にメタタグとエッジ制御を組み合わせる
Robots.txt はリクエストであり、防御壁ではありません。 Google の公式ドキュメント でも、これは強制力のあるセキュリティ対策ではなく、任意の準拠であることが確認されています。Disallow されたページでも、検索結果に URL のみ表示される場合があります。また、 Disallow ルールによってページ自体の取得が停止されるため、 noindex メタタグをそのページに設置していても、読み取られることはありません。
そのため、複数レイヤーでの対策が重要です。HTML ページには noai または noimageai メタディレクティブを設定してページ単位でオプトアウトできます。一方、PDF、画像、フィードなどの非 HTML リソースでは、 X-Robots-Tag HTTP ヘッダーを使用する必要があります。これらにはメタタグを配置するページ本文が存在しないためです。
- robots.txt は、内容を読み取り尊重する一般的なクローラー向けの第一レイヤーとして使用します。
- より細かいページ単位またはファイルタイプ単位の制御には、メタタグや
X-Robots-Tagヘッダーを追加します。 - 機密性の高いコンテンツには認証やパスワード保護を使用してください。robots.txt はもともとセキュリティ対策として設計されたものではありません。
- 検討したいのが Cloudflare の Bot Preference Syncです。既存の robots.txt に管理対象ディレクティブを追加し、カテゴリ別(Search、Agent、Training)のエッジ制御ブロックと組み合わせることで、設定したポリシーと実際の制御を一致させやすくなります。
プロのヒント: クローラーが robots.txt を完全に無視する場合、実際にリクエストを止められるのは CDN や WAF によるエッジ制御だけです。
ディレクティブが機能しているかテストして確認する
クローラーが実際に robots.txt を尊重しているか確認するには、推測ではなく短いチェックリストを使うのが有効です。
- サーバーログで
/robots.txtへのリクエストを確認し、対象としたベンダーの user-agent からのアクセスが、disallow 対象パスのクロールより前に発生していることを確認してください。 - ベンダー側の更新反映時間も考慮してください。OpenAI のドキュメントでは、変更の反映におよそ 24 時間かかる場合があるとされています。設定直後ではなく、丸一日後に再確認してください。
- 構文が正しく解釈され、意図どおりに動作しているか確認するために、 BabyLoveGrowth の robots.txt checkerなどのライブ検証ツールやバリデーターを使用してください。
- CDN や WAF のレポートを robots.txt ルールと合わせて確認し、ディレクティブを無視してブロック済みパスを取得し続けるクローラーがないか確認してください。
- 固有の disallow ルールを設定したテストページを用意し、その後数日間、そのベンダーの出力に表示されるかを監視してください。
AI 可視性とトレーニング拒否のバランスを取る
EC サイトでは、判断材料は通常 3 つです。AI 経由の流入が売上にどれだけ影響しているか、商品コンテンツの機密性がどの程度高いか、そしてカタログがどれくらい頻繁に更新されるかです。AI 検索からの引用が有意なトラフィックを生んでいる場合は、検索用トークンは許可し、トレーニング用のみを disallow にするのが適しています。一方で、商品説明、価格、画像が容易にスクレイピングされ、他サイトで再利用されやすい場合は、トレーニング用クローラーをブロックすることで、その投資を保護できます。可視性を重視するマーチャントにとっては、それが実際に成果につながっているか測定する手段も必要であり、そこで専用の最適化ツールが役立ちます。
— Xhurian
ecentic: AI ショッピングでの可視性を測定・最適化
検索用トークンを許可するだけでは十分ではありません。本当に重要なのは、ChatGPT や Gemini のような AI ショッピングエージェントが、商品を認識できる状態になったあとに実際に推奨するかどうかです。その確認のために ecentic を開発しました。Shopify または WooCommerce ストアと連携し、AI エージェントが商品ページをどのように評価するかをシミュレーションして、競合商品と比較してどこで勝ち、どこで負けているのかを具体的に表示します。

目的が AI 経由トラフィックを減らすことではなく増やすことであれば、ブロックより最適化のほうが効果的です。診断結果を具体的なリライト提案に変換し、ワンクリックでストアへ反映できるため、「AI に認識される」状態から「AI に推奨される」状態へのギャップを埋められます。
- シミュレーションベースのスキャンを実行し、各種 AI ショッピングエージェントが商品情報をどう読み取るか確認できます。
- 一般的な SEO アドバイスではなく、特定の商品ページに紐づいた、わかりやすく実行可能な改善提案を取得できます。
- ダッシュボードを離れることなく、修正内容を Shopify や WooCommerce に直接反映できます。
まずは 無料の商品スキャン で、現在の商品情報の状況を確認してください。
FAQ
AI ボットのブロックに robots.txt を使うことは合法ですか?
はい。robots.txt ファイルを公開し、任意のクローラートークンを disallow に指定することは、Robots Exclusion Protocol に基づく標準的かつ合法なサイト運用の一部です。これはクロールに関する希望を示すものであり、それ自体に法的強制力はありません。本当に保護が必要なコンテンツには、認証と組み合わせて使用してください。
AI ボットの挙動について議論できるチャットルームやフォーラムはありますか?
robots.txt に関する質問向けの公式チャットルームを AI ベンダーが共同で運営しているわけではありません。ただし、各ベンダーは独自のドキュメントを公開しています。たとえば OpenAI のクローラー概要や Google の robots.txt ガイドは、現在のトークン挙動を確認するうえで最も信頼できる情報源です。
robots.txt は今でも使われていて重要ですか?
robots.txt は現在でも、クローラーに対する希望を示すための主要かつベンダー公認の方法です。OpenAI、Google、Anthropic の新しい AI トレーニングボットや検索ボットにも対応しています。主要な AI 企業は対応トークンのドキュメント更新を継続しており、そのため現在でも、多くのサイト運営者が最初に設定する制御手段となっています。
インターネットトラフィックの大半はボットですか?
検索クローラーや AI エージェントを含むボットトラフィックは、多くの Web サイトで一定割合のリクエストを占めています。ただし、その比率はサイトや業界によって大きく異なります。業界全体の単一データに頼るより、自社サーバーログで crawler user-agent を確認するほうが、トラフィックのどれだけが自動化アクセスかを把握するうえで確実です。
GPTBot をブロックすると ChatGPT の検索結果もブロックされますか?
いいえ、 GPTBot をブロックしても、トレーニングデータ収集をオプトアウトするだけで、 OAI-SearchBotには影響しません。OpenAI は検索インデックス用にこれを別途管理しています。 OAI-SearchBot も個別に拒否設定にする必要があるのは、ChatGPT の検索結果からも自社のページを除外したい場合です。