

はい、商品レビューはAIショッピングエージェントがその商品を推奨するかどうかに影響します。ChatGPT、Gemini、Claude、Perplexity などのエージェントは、何を根拠として引用するかを選ぶ際に、投稿時期、認証済み購入ステータス、真正性の手がかり、そしてレビュー本文そのものを考慮します。最も早く着手できるのは、評価分布と認証済み購入フラグを明確に表示し、そのうえで具体的な長所と短所が伝わる構造化サマリーを追加することです。
要点:
- Baymardは、商品にレビューが5件付くまでは評価分布を非表示にすることを推奨しています。その閾値を下回る場合は、購入者やエージェントに誤解を与えないよう、代表的な文章レビューを表示してください。
- 40件の詳細なレビューがある商品は、レビュー投稿者が利用シーン、トレードオフ、リスクを説明していれば、400件の一般的な評価しかない商品より多く引用されることがあります。
- 否定的なレビューには公開で回答し、解決内容を記録してください。そうすることで、購入者にはサービス品質の根拠を示せ、エージェントには苦情への対応方法に関する検索可能な文脈を提供できます。
- レビューのインセンティブを肯定的な感情と結び付けないでください。FTCの規則でその慣行は制限されており、プラットフォームが真正性に欠けると判断したフィードバックを除外する可能性もあります。
- 変更は段階的にテストし、変更していない商品ページとエージェントの引用を比較し、エージェント経由のセッション数と注文数を追跡して可視性の変化を測定してください。
AIショッピングエージェントはレビューと評価をどう活用するのか
AIショッピングエージェントは、単純な並び替えアルゴリズムのように星評価を平均するだけではありません。学習済みモデルを使って複数ソースのレビュー内容を統合し、購入者の質問に答えるうえで実際に有用な根拠を判断します。 OpenAIのショッピング関連ドキュメント によると、ChatGPTは商品概要やラベルを生成する際、価格、レビュー、在庫状況、販売者メタデータをまとめて考慮しており、単一の星評価ではなく第三者のレビューデータを参照することも少なくありません。
これは研究者が「意思決定有用性ランキング」と呼ぶ考え方につながります。エージェントは、最新レビューや高評価レビューを単純に優先表示するのではなく、具体的な長所、具体的な短所、購入前に知りたいリスク要因など、行動につながる詳細情報を含むレビューを重視します。レビューを根拠にしたショッピングQAにおける根拠選択の研究では、 エージェントの根拠選択手法を含め、肯定的な内容とリスク関連の内容の両方を保持するモデルのほうが、浅く一般的な称賛だけで構成された要約よりも購入者から高い信頼を得られることが示されています。
重要なのはテキストだけではありません。エージェントは、投稿時期、購入確認済みフラグ、参考になった投票、レビュアー属性などを使って根拠の重み付けを行います。数年前に認証されていないアカウントから投稿された星5レビューよりも、具体的な利用シーンが記載された最近の購入確認済みレビューのほうが、根拠として高く評価されます。この重み付けは販売者から見えにくいため、多くのレビュー施策が、エージェントが実際に利用するシグナルではなく件数の増加に偏っています。
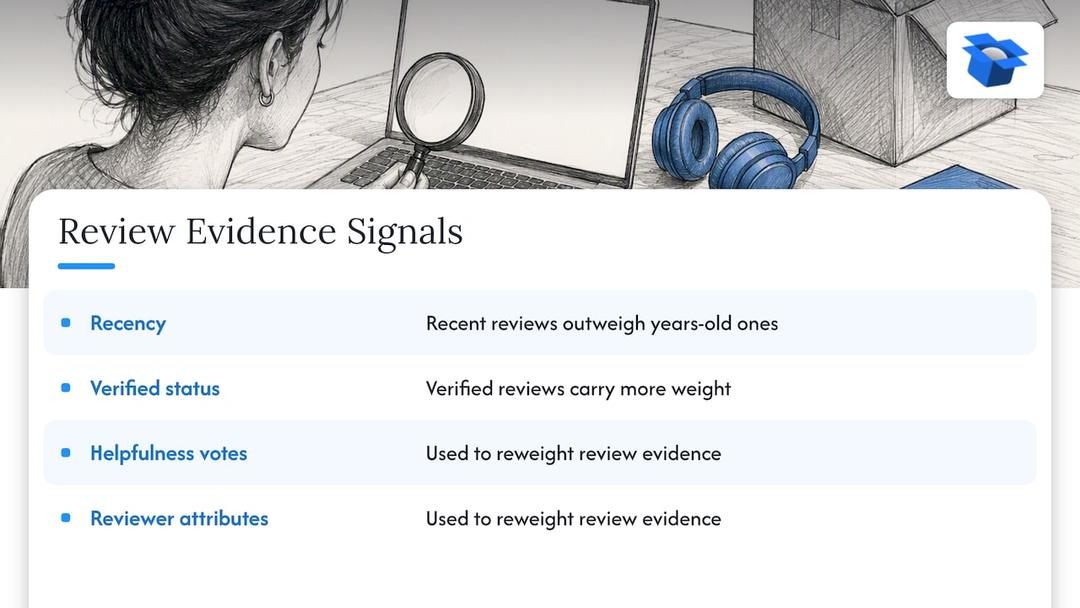
AIエージェントと購入者に最も重要なレビュー要素
平均評価だけでは、購入者にもエージェントにもほとんど情報を伝えられません。 Baymard Instituteによる評価分布の研究 では、購入者は各星評価にどれだけレビューが分布しているかという全体像を強く重視していることが示されています。これは、平均4.5が圧倒的に高評価なのか、それとも星5と星1に二極化しているのかを判断できるためです。同じ考え方は、根拠を抽出するエージェントにも当てはまります。ばらつきが見える分布は信頼性のシグナルになりますが、不自然に均一な星5レビューばかりだと作為的に見える可能性があります。
レビュー件数も重要です。Baymardのガイドラインでは、レビュー数が5件未満の商品では評価分布の要約を非表示にすることを推奨しています。サンプル数が少ないと、購入者にもモデルにも誤解を与えるためです。件数が増えるまでは、代表的な定性的レビューを数件見せるほうが有効です。
数値以外にも、人間の信頼とエージェントの根拠選択の両方を一貫して改善するページレベルの要素がいくつかあります。
- 購入確認済みフラグとタイムスタンプ により、実際の最近の取引に基づくレビューであることを読者とモデルの両方が確認できます。
- 内容の充実したレビュー本文 では、具体的な長所、具体的な短所、そして商品をどのような状況で使ったかが明記されています。
- レビュアーが投稿した写真や動画は、テキストだけでは伝わらない補強情報を提供します。
- 低評価レビューへの公開返信は、ブランドが苦情にどう対応するかを購入者がサービス品質の指標として見るため、eコマースの商品ページUX研究でもコンバージョン向上との関連が示されています。
ネガティブなフィードバックに公開で対応することは、人間の信頼構築だけではありません。エージェントが引用できる文書化された解決内容が残るため、潜在的な警告サインを、対応力のある販売者の証拠へ変えられます。
実践チェックリスト:レビューをAIエージェントにとって有用にする手順
ここで必要なのは、多くの場合すでに収集している情報を、購入者とエージェントの両方が利用できる形式で公開することです。今後30〜90日で次の内容を確認してください。
- レビュー収集プロセスを監査する 際は、 FTCの偽レビュー・インセンティブレビュー規則を基準にしてください。この規則では、偽レビューの売買や、肯定的な感想を条件とした報酬提供が制限されています。
- 評価分布とレビュー件数を表示する 際は、平均スコアだけでなく一覧ページと商品詳細ページの両方で表示してください。
- マイクロアンケートやガイド付き入力を追加する ことで、レビュー投稿時に長所1つ、短所1つ、利用シーンを回答してもらいます。
- レビュアーによる写真や短い動画の投稿を促す には、購入手続き完了直後にシンプルなアップロード案内を表示します。
- AI生成要約を人間のレビューと併記する際は、人間のレビューを先に、要約を後に表示してください。 ハイブリッドレビューシステムの研究 では、この順序のほうが信頼性の認知向上につながるとされています。
- 低評価レビューには公開で返信する とともに、隠す対象ではなく検索可能な根拠として解決内容を記録してください。
- 変更は段階的に展開する ことで、すべてを一度に変更するのではなく、各段階の前後でエージェントの引用内容を確認してください。
プロのヒント: 一般的な星評価依頼ではなく、購入後フォローアップで「良かった点」と「気になった点」を1つずつ尋ねてください。構造化された回答のほうが、エージェントが探しているリスクシグナルを含みやすくなります。
コンプライアンスは単なる法的チェック項目ではありません。プラットフォームやエージェントは信頼性を重視する傾向を強めているため、インセンティブに依存しない本物のフィードバックを基盤とした施策のほうが、件数重視の施策よりも長期的な可視性を得やすくなります。
効果測定:AIエージェント向けの指標と実験
レビュー変更が効果をもたらしたかを推測する必要はありません。測定できる具体的な指標があります。 AI生成レビュー要約に関する研究 では、レビューシステムに要約を追加すると、新規レビュー数と内容の充実度の両方が向上したことが示されています。投稿者は要約を繰り返すのではなく、補完的な詳細を追加する傾向がありました。これは、変更前後を比較するための自然な指標になります。
レビュー変更が実際にエージェントの挙動を変えたか確認する実践的方法をいくつか紹介します。
- エージェントの要約をサンプリングする ことで、主要商品の変更前後を比較し、引用される根拠が変化したか確認します。
- エージェント経由のアトリビューションを追跡するとは、エージェントが提示した結果から発生したセッションや注文を分析基盤で追跡することです。
- 段階的ロールアウトを実施する 際は、一部の商品ページを変更せずに残し、レビュー変更の影響を切り分けられるようにします。
- 先行指標を監視するには、レビュー件数の増加率、投稿時期の分布カーブ、星評価分布の変化、参考になった投票数などがあります。
エージェントが根拠として何を引用しているかを定期的にサンプリングし、時間経過で比較する引用チェックは、レビュー変更が実際に反映されたかを確認するうえで、実務上もっとも効率的な方法の1つです。当社の AIショッピングで引用を獲得するためのガイド では、この種のテストをどう設計するかを詳しく解説しており、 エージェント経由の可視性を追跡する記事 では、そのために構築すべきダッシュボードを紹介しています。
レビュー最適化で当て推量よりシミュレーションが優れる理由
多くの販売者は、レビュー戦略を件数勝負として扱っています。星評価を増やし、エージェントに気づいてもらうことを期待するのです。しかし、その考え方は逆です。推奨を決めるエージェントは件数そのものを評価しているわけではなく、購入者の具体的な迷いを解消する根拠を重視しています。そのため、利用シーンやトレードオフが明確な40件のレビューを持つ商品が、一般的な星5レビュー400件の商品より多く引用されることもあります。
多くのブランドが過小評価しているのは、レビュー基盤が約束すること(「レビューが増えるほど信頼が高まる」)と、実際にエージェントの挙動を変える要因とのギャップです。自社ストアフロントを読むだけでは、エージェントがどのレビューシグナルを重視しているかは分かりません。だからこそ、レビュー最適化は従来のSEOの前提ではなく、エージェントそのものを対象にテストすべきなのです。
— Xhurian
修正を推測する前に、レビューの不足点を診断する
私たちは、ChatGPT、Gemini、Claude、Perplexityが商品ページを評価する際に何を見ているのかを正確にシミュレーションするプラットフォームを構築しました。競合商品と比べて不足している、あるいは弱いレビューシグナルも確認できます。どのレビュー属性を最初に改善すべきかを推測する代わりに、商品情報ごとの具体的な勝因・敗因を診断し、ShopifyやWooCommerceへワンクリックで反映できる公開用の書き換え案を生成します。

プランは無料スキャンから開始でき、有料プラン(Competeは月額$14.90、Scaleは月額$44.90、Dominateは月額$149)では、より深い競合分析と継続的な再スキャンを利用できます。詳細は 料金ページに掲載しています。まず商品情報機能を確認したい場合は、 AI商品情報最適化ページ でシミュレーションと公開ワークフローを詳しく解説しています。
FAQ
AIショッピングエージェントはレビュー本文を実際に読んでいるのか、それとも星評価だけを見るのか?
エージェントは星評価の平均だけでなく、レビュー本文を読んで根拠選択に利用します。OpenAIのショッピング関連ドキュメントでも、ChatGPTが商品概要生成時に価格や販売者メタデータとあわせてレビューを考慮することが確認されています。また、根拠選択に関する研究では、一般的な称賛よりも、具体的な長所・短所・リスクシグナルを含むレビュー本文をモデルが優先することが示されています。
評価分布が役立つようになるには、レビューは何件必要か?
Baymard Instituteの研究では、レビュー数が5件未満の商品では評価分布の要約を非表示にすることが推奨されています。サンプル数が少ないと、購入者にもモデルにも誤解を与えるためです。この閾値未満では、分布グラフより代表的な定性的レビューのほうが有用です。
インセンティブ付きレビューはAIショッピングでの可視性を損なう可能性があるか?
感情表現を条件に報酬を与えるレビューは、 FTCの偽レビュー・インセンティブレビュー規則によって制限されています。また、プラットフォームは信頼性を重視する傾向を強めているため、感情条件付きインセンティブは法的リスクと可視性リスクの両方を生みます。倫理的に収集された無条件レビューのほうが、エージェントが引用可能な根拠として維持されやすくなります。
AI生成レビュー要約は人間のレビューを不要にするのか?
いいえ。AI生成要約に関する統制研究では、要約によってレビュー件数が増え、投稿者が人間のレビューを置き換えるのではなく、より豊富で補完的な情報を追加する傾向が確認されています。人間のレビューを先に、AI要約を後に表示する構成のほうが、どちらか一方だけに依存する場合より高い信頼につながる傾向があります。
レビュー変更によってAIショッピングでの引用が実際に改善したか、どう確認すればよいか?
もっとも直接的な方法は、変更前後で同じ商品のエージェント要約をサンプリングし、引用される根拠が変化したか確認することです。また、AI検索可視性の測定ガイドで説明しているように、エージェント経由のセッションや注文を追跡すると、引用チェックとあわせて具体的なアトリビューション指標を得られます。これを 90日間の可視性テスト計画 と組み合わせることで、実験スケジュールを整理しやすくなります。
参考資料
以下は、上記の主張の根拠となる主要な参考資料です。レビュー施策を構築または監査する場合は、ブックマークしておく価値があります。
関連トピックを確認