

ChatGPT、Gemini、またはあらゆるAIショッピングエージェントに選ばれるための最大のてこは、巧みなマーケティングコピーではなく、クリーンで標準となる構造化商品レコードです。つまり、正確な識別子、最新の在庫状況、そして事実を先に示すプレーンテキストの説明を含むJSON-LDまたは適切なフィードが必要です。根拠にすべきなのは、エージェントが実際に解析する標準です。たとえば、OpenAI product feed spec、Shopify Catalog、そして会話型フィールドである product_highlight と question_and_answerです。多くのストアは、エージェントに静かにスキップされるまで気づけない形でここを誤っているため、そうした問題に対応するためのツールとしてEcenticのような製品があります。
要点:
- AIのレコメンドではマーケティングの語調よりも商品データが重視されるため、正確な識別子、構造化スキーマ、事実を先に示す記述を商品データに含めることが重要です。
- 説明文が優れていても、タイトルの不一致、古い在庫ステータス、GTINの欠落があると、商品がエージェントのレコメンド対象から除外されることがあります。
- Shopifyは構造化データを扱いやすい一方、WooCommerceでは発見項目と選定項目を最適化するために、追加プラグインと適切な属性マッピングが必要になることがよくあります。
- シミュレーションツールでカタログを定期的にテストすると、AI主導の検索やレコメンドに商品が表示されない原因となる構造上のギャップを特定しやすくなります。
- AI生成の商品説明では、エージェントによる解析と人の信頼の両方を最大化するために、事実先行・仕様重視の内容に、人が加える差別化ポイントを組み合わせるべきです。
AIショッピングエージェントは、AI推奨のために商品説明をどう読み取るのか?
AIショッピングエージェントは、人のようにストアを閲覧しません。購入希望者の質問を構造化クエリに書き換え、特定の「スロット」(ブランド、価格上限、色、サイズ、素材)を抽出し、説明文のトーンや訴求表現を評価する前に、まず商品データがそのスロットに合っているかを確認します。マーチャントとエージェントのアーキテクチャに関する研究では、この適用は言語モデルが推測するのではなく、決定論的なSQLやナレッジグラフのクエリで実行されることが多いと示されています。ある ハイブリッド型マルチエージェントフレームワークのアブレーション研究では、そのSQLレベルの適用を外すと、ブランド適合率が完全な1.000から0.684まで低下しました。平たく言えば、厳格なデータルールがないと、除外すべき商品までエージェントが推奨し始めるということです。
この違いは、どの修正を優先するかを決めるうえで重要です。商品データでは、別々の2つの役割が動いています。
- 発見用フィールド は、そもそも商品を候補プールに入れるためのものです。JSON-LDマークアップ、公開フィードのエンドポイント、サイトマップの登録、そして
llms.txtでカタログの所在をエージェントに示すファイルです。 - 選定用フィールド は、候補プールに入ったあとで勝てるかどうかを左右します。価格、最新の在庫状況、GTIN または MPN、AggregateRating、そして購入希望者が指定した内容と完全一致するブランド情報です。
どれだけ魅力的な説明文でも、GTINがなく在庫ステータスも古いページでは、項目が正しく埋まったより簡素な商品情報に負けます。会話型属性は、その差を埋めるのに役立ちます。Google の Merchant Center の会話型属性 では、短いQ&Aの組み合わせや商品ハイライトを追加でき、エージェントが本来は推測するか、購入希望者に確認しなければならない曖昧さを解消できます。確認のための質問が少ないほど、通常は直接の推奨までの経路が速くなります。
商品データのチェックリストには何を含めるべきですか?
販促文の一語を直すより先に、構造の層を修正してください。多くの販売事業者は、この順序が逆です。文章を磨く一方で、スキーマを省いてしまっています。
- 商品タイトルを正規化する。 ストアフロント、フィード、スキーママークアップのすべてで、商品ごとに一貫した1つのタイトルを使ってください。エージェントはタイトルをブランドやカテゴリと照合するため、不一致があると1つの強いシグナルではなく、別々の弱いシグナルとして扱われます。
- 説明文の冒頭に事実を置く。 素材、サイズ、互換性、用途を最初の1文に入れてください。OpenAI のフィード仕様ではプレーンテキストの商品説明を最大5,000文字まで扱えますが、エージェントが最も重視するのは冒頭の数行です。
- GTIN、MPN、SKU を入力する。 これらの識別子があることで、エージェントはその商品が購入希望者の求めた商品そのものなのか、単に似ているだけなのかを確認できます。
- 価格と在庫状況をリアルタイムで同期する。 古い在庫ステータスは、気づかれないまま検討対象から外される最も手っ取り早い方法の1つです。
- バリアント単位で説明文を書く。 この product feed specification はバリアントごとの項目やメディア配列をサポートしているため、「青、Mサイズ」のようなバリアントに、汎用的な親商品の説明を引き継がせるのではなく、そのバリアント固有の正確な情報を持たせられます。
- 追加
product_highlightとquestion_and_answerのペア は、商品に本当に混同されやすい点(フィット感、互換性、成分)がある場合に追加してください。
エージェント向けのコピーが実際にはどう見えるか、例を示します。
アパレル: 「メンズのメリノウール クルーセーター、 100% オーストラリア産メリノ使用。水洗いは低温で洗濯機使用可。レギュラーフィットで、サイズ感は標準。カラーはネイビー、チャコール、オートミール、サイズはSからXXLまで。」
アクセサリー: 「ステンレススチール製の時計バンド。20mmのクイックリリースピン付きで、Fossil および互換性のあるフュージョンスタイルのケースに対応。表面はブラッシュ仕上げで、手首周り6.5〜8.5インチに調整可能。」
消耗品: 「ダークローストのホールビーンコーヒー。12オンス袋入り、グアテマラ産シングルオリジンで毎週焙煎。ドリップ、フレンチプレス、エスプレッソ挽きに対応。」
どの例も、雰囲気ではなく、エージェントが条件に一致させるために必要な事実から先に記載しています。
プロのヒント: JSONフィードは安定した公開URLでホスティングし、 llms.txt ファイルでサイトルートから明示的に参照してください。エージェントはまずそのファイルをクロールするため、参照が壊れている、または存在しない場合、他は完璧でもフィードが見つかりません。
Shopify と WooCommerce のマーチャントは何を優先して修正すべきか?
両プラットフォームは出発点が大きく異なるため、すぐ効果が出る改善ポイントも、利用しているストア基盤によって変わります。
Shopify マーチャントが行うべきこと:
- JSON-LD の Product スキーマが実際に本番の商品ページで出力されているか確認する(Shopify はデフォルトで挿入しますが、テーマによって上書きや削除が行われる場合があります)。
- GTIN とメタフィールドを主力商品だけでなく、すべてのSKUに設定する。
- 有効化する Shopify Catalog を有効化するか、公開フィードを提供して、スクレイピングされたページテキストではなく、分類体系にマッピングされた構造化データをエージェントが取得できるようにする。
- 次の
llms.txtファイルを追加し、フィードとサイトマップを参照させる。
WooCommerce マーチャントが行うべきこと:
- WooCommerce は Shopify のように構造化データを自動挿入しないため、スキーマまたは JSON-LD プラグインを導入する。
- 商品属性を、非構造化のカスタムフィールドのままにせず、適切な schema.org プロパティへマッピングする。
- デフォルトのXML商品エクスポートに依存せず、エージェントが読み取れる安定したJSONフィードを公開する。
- 同じ
llms.txt参照をサイトルートに追加する。
どのプラットフォームを使っていても、価格と在庫状況はフィード、ストアフロント、サードパーティチャネル間で同期させてください。すべてのバリエーションに個別のメタデータを設定し、共通説明文を使い回さないこと。また、画像の alt テキストには実際の商品内容を記載し、単なるファイル名にしないでください。Shopify、BigCommerce、WooCommerce の API アクセス比較によると、構造化データが不足している場合、エージェントは alt テキストを補助シグナルとして利用します。
AIによる推奨率をどう測定するか?
見えないものは改善できません。そしてエージェント経由のトラフィックは、通常のボットクロールや参照クリックと区別するように設計されていない分析環境では埋もれてしまいます。
まず、ユーザーエージェント文字列が既知のAIクローラーに一致するセッションへタグ付けし、そのトラフィックを一般的なボットノイズから分離してください。その上で、次を実施します。
- 自社カタログに対してシミュレーションを実行し、カテゴリー内の一般的な検索クエリでエージェントがどの商品を表示するか確認する。トラフィック減少で問題に気づく前に把握できます。
- 事実優先型とマーケティング優先型の2種類の説明文でA/Bテストを行い、同じクエリでどちらがより頻繁にエージェントに選ばれるか比較する。
- エージェント経由の訪問数と、その後のコンバージョンを分けて追跡する。推奨獲得数は増えてもコンバージョンが大きく落ちる説明文と、推奨数は少なくても高くコンバージョンする説明文では、必要な改善策が異なります。
ここでは、一度きりの監査より継続的な再スキャンの方が重要です。モデル更新によってエージェントの挙動は変化し、さらに、3件未満しか一致候補がない場合には制約を段階的に緩和するマルチエージェントの適用フレームワークが使われるため、自社側で何も変更していなくても商品が候補に入ったり外れたりする可能性があります。定期的に再スキャンするシミュレーション主導型ツールなら、その変化を売上問題として表面化する前に検知できます。
AI生成の商品説明は人間が書いたものよりコンバージョン率が高いのか?
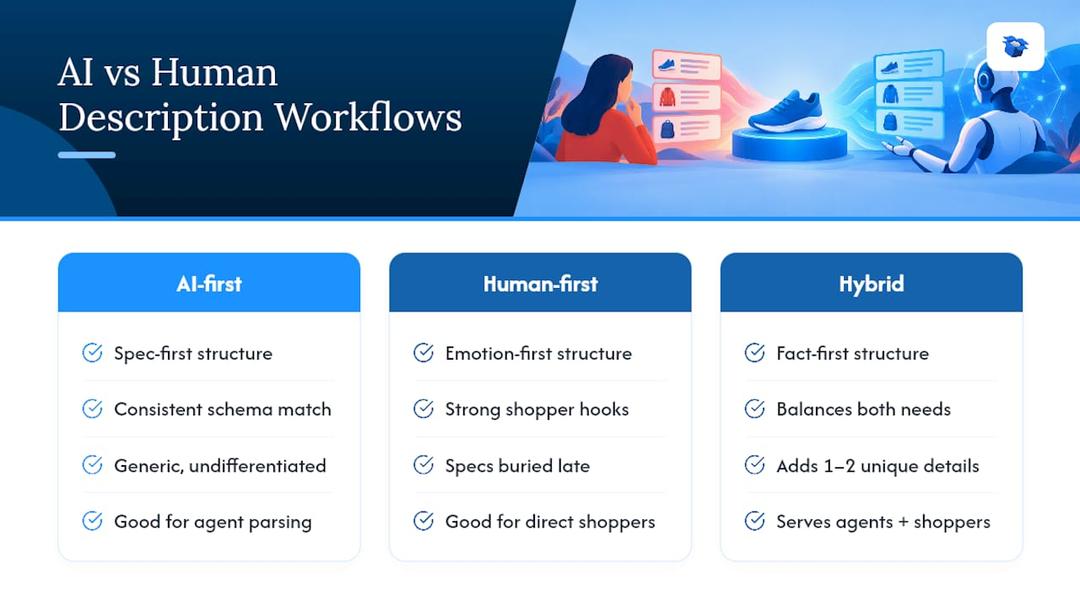
どちらかが一方的に優れているわけではなく、その比較自体が少しずれています。本当に重要なのは「AIか人間か」ではなく、説明文がエージェントのテキスト解析方法と、商品を気軽に閲覧する人間の読み方の両方に合っているかです。
人間向けの閲覧体験に最適化された説明文は、感情的なフックやライフスタイル訴求から始まる傾向があります。このスタイルは、人が直接訪れた商品ページでは高いコンバージョンを生むことがあります。一方、エージェントによるスロット抽出では性能が落ちやすく、必要な情報(素材、寸法、互換性など)が最初の文ではなく3段落目に埋もれているケースが多いためです。
AI生成の説明文は、構造面では高速かつ一貫性があり、仕様を整理して列挙し、スキーマ項目とも正確に一致させやすい利点があります。リスクは汎用化です。テンプレートから組み立てられたような説明文で差別化要素がない場合、同価格帯の競合SKU5件と比較した際に、エージェントが自社商品を選ぶ理由がなくなります。
AI経由トラフィックへの実践的な答えは、誰が、あるいは何が初稿を書いたとしても、事実優先・仕様重視の構造を維持し、その上で人間の編集者が商品を本当に差別化する1〜2点の特徴を加えることです。このハイブリッド型アプローチは、エージェントの解析要件と、人間の購入者が求める安心感の両方に対応しやすく、どちらも犠牲にしません。
AI生成の商品説明における法的リスクとは?
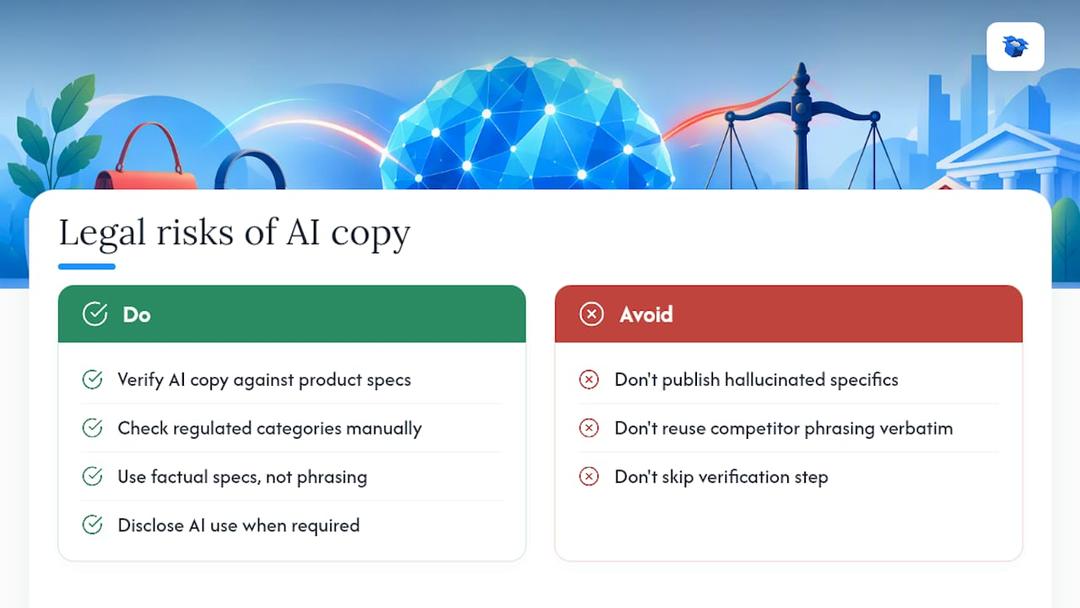
文を書いたのが言語モデルだからといって、正確性に関する責任が変わるわけではありません。AI生成の説明文が素材、認証、互換性に関する主張を誇張した場合、多くの市場では、標準的な消費者保護法や広告法の下で、その責任は依然としてマーチャントが負います。
実務上で最大のリスクは、もっともらしい誤情報の生成です。AIツールは、実際には存在しない生地構成、原産国、安全認証などを自信を持って生成する場合があります。これは、モデルが在庫データを検証しているのではなく、もっともらしい文章を予測しているためです。公開前には必ず、AI生成コピーを実際の商品仕様と照合する検証工程を入れてください。特に食品、化粧品、サプリメント、電子機器など規制対象カテゴリーでは重要です。
開示と独自性に関しては、規模は小さいものの現実的な倫理上の考慮点もあります。競合他社の表現をそのまま再利用した場合、たとえAIツールが独立して類似テキストを生成したとしても、保護対象となる創作表現にどれだけ近いかによっては著作権上の問題になる可能性があります。自社の事実ベースの仕様に基づき、表現ではなく構造で差別化すれば、このリスクの大半は回避できます。
動画や3DモデルはAIエージェントの商品理解に役立つのか?
マルチメディアは買い物客の判断に役立ちます。ただし、AI エージェントにとっての価値は、そのメディアが、エージェントに実際に読める文章で説明されているかどうかで決まります。3D モデルや商品動画に、alt テキスト、キャプション、または構造化された media フィールドが付いていなければ、人にはどれだけ魅力的に見えても、現時点では大半のエージェントに認識されません。
実務的には、必要なのは「動画を増やすこと」ではなく、「動画を説明すること」です。OpenAI のフィード仕様では、説明オブジェクトと並んで media 配列をサポートしているため、商品情報は画像、動画、文章仕様を、ページ上で分断されたアセットではなく、同一レコードの関連要素として参照できます。
フィット感、質感、空間的な複雑さが重要な商品(家具、アパレル、ハードウェアなど)を扱うマーチャントは、短い動画や3Dモデルに加え、「縫製ディテールとポケット配置を示す360度ビュー」のように、何を示しているかを明記したテキストキャプションを組み合わせてください。そのキャプションが、視覚アセットとエージェントのテキストベース理解をつなぐ橋になります。キャプションがなければ、JSON-LD を見ずにスクロールする人間の購入者には役立っていても、エージェント用途では存在しないのと同じです。
AI推奨では、なぜ推測よりシミュレーションが有効なのか
多くのマーチャントは、トラフィックが落ちて初めて自社商品が競合に負けていることに気づきます。しかし本来は逆です。シミュレーションを使えば、実際のエージェントクエリを想定してカタログをテストし、GTIN欠落や古い在庫フラグのような厳格な条件によって、どこで候補から外れるのかを、実際の注文損失が発生する前に正確に把握できます。
Ecentic は、その診断ギャップを埋めるために構築されました。Shopify や WooCommerce ストアへ直接接続し、シミュレーションを実行して、優先度付きの修正項目をわかりやすい言葉で提示します。類似の改善を実施したマーチャントからは、AI経由の訪問数とその後の売上の両方で測定可能な増加が報告されており、これは本記事で扱った構造的な詳細に対して、エージェント選定が非常に敏感であることと一致しています。
— Xhurian
無料スキャンでAIエージェントに実際どう見えているか確認する
ChatGPT、Gemini、Claude、Perplexity が今すぐ商品を推奨しない理由は何か。この1つの問いに答えるために作られたツールがあります。どの項目が壊れているか推測する代わりに、こうしたツールは実際のエージェントクエリをライブカタログに対してシミュレーションし、影響度順に修正項目を順位付けし、修正済みデータを Shopify や WooCommerce ストアへ反映できます。

シミュレーション、診断、公開までを閉じたループで行う点が、一般的なAIコピーライティングツールとの違いです。単に文章を魅力的に生成するだけでなく、マーチャント向けエージェントの適用レイヤーが確認する具体的な欠落に対応し、勝率の定量的改善につなげます。まずは無料スキャンを実行し、カタログの優先修正項目を確認した上で、 Compete、Scale、または Dominate プラン が、AI起因注文ベースの従量課金より適しているか判断してください。また、 商品情報最適化機能 を確認してから導入を決めることもできます。
FAQ
AIエージェント向け商品説明とは何か?
AIエージェント向けの商品説明は、プレーンテキストの説明、スキーママークアップ、GTIN や MPN のような識別子を組み合わせた、事実優先の構造化レコードです。エージェントがスロット抽出を行い、一致を確認できるように記述されます。閲覧重視のコピーと異なるのは、エージェントが説得的な表現を評価する前に、まず構造化フィールドを解析する点です。
AIの商品推奨で最も重要な項目は何か?
商品が発見された後の選定には、価格、リアルタイム在庫、GTIN または MPN、ブランドデータが影響し、発見自体には JSON-LD マークアップと公開フィードが重要になります。また、 product_highlight や question_and_answerのような会話型フィールドは、Google の Merchant Center ガイダンスで定義されており、これらの主要項目に加えて曖昧さを減らします。
Shopify と WooCommerce のどちらがAIで見つけられやすいか?
AIエージェント向けAPIアクセスの比較によると、Shopify はデフォルトで JSON-LD Product スキーマを自動挿入し、構造化データマッピング用の Shopify Catalog も提供しています。一方、WooCommerce では通常、スキーマプラグインと手動の属性マッピングが必要です。適切に設定すれば両プラットフォームとも同等レベルに到達できますが、Shopify の方がスタート地点がゴールに近いと言えます。
Ecentic の料金はいくらか?
Ecentic は無料の初回スキャンを提供しており、その後は月額 $14.90 の Compete、月額 $44.90 の Scale、月額 $149 の Dominate から始まる有料プランを利用できます。また、定額制ではなく利用ベース課金を希望するマーチャント向けに、AI起因注文ごとに3%の成果報酬を課金する従量課金オプションもあります。
変更前にAIエージェントからの見え方をテストできるか?
はい。シミュレーションツールを使えば、既存のカタログで実際に近いエージェントの検索を試し、変更を一つも公開する前に、どの商品が表示され、どれが除外されるのか、その理由まで確認できます。この診断工程によって、すべての商品ページを手当たり次第に書き直すのではなく、推測を優先順位付きの修正リストに変えられます。