

すべての販売チャネルでの価格整合性、しきい値を意識した下限価格設定、そしてAIが読み取れる完全な商品データ。この3つが、SKUをAIショッピングエージェントの推奨に載せるうえで最も再現性の高い施策です。3つすべてを満たせばスコアリング対象に入れますが、1つでも欠けると競合比較の前に除外されます。
今すぐ実施すべき3つの施策:
- 価格整合性を徹底する ShopifyまたはWooCommerceストア、Google Shoppingフィード、各種マーケットプレイスの商品情報間で価格を統一します。 チャネル間で価格が一致していない状態 は、購入完了率を約23%低下させる可能性があります。
- しきい値を意識した下限価格を設定する ことで、SKUの価格が「50米ドル未満」「100米ドル未満」といった一般的な検索条件のしきい値を1米ドル超えるのではなく、その直下に収まるようにします。
- 完全な構造化商品データを公開する (JSON-LD、完全な属性項目、整理されたタイトルなど)ことで、エージェントが商品情報をスコアリングできるようにします。
重要ポイント
価格整合性、しきい値を意識した下限価格設定、完全な構造化データは、SKUをAIエージェントの推奨に載せるための不可欠な3つの基盤です。
| 項目 | 詳細 |
|---|---|
| まず価格整合性を徹底する | Perplexityのマーチャント分析によると、チャネル間の価格不一致は購入完了率を約23%低下させます。 |
| しきい値を意識した下限価格を設定する | 「$50未満」などの一般的な検索フィルターをわずかに下回る価格に設定し、SKUが除外されず含まれるようにします。 |
| 完全な構造化データを公開する | JSON-LDと完全な属性項目は必須条件です。データが不足していると、エージェントは商品情報のスコアリング自体を行わないことがよくあります。 |
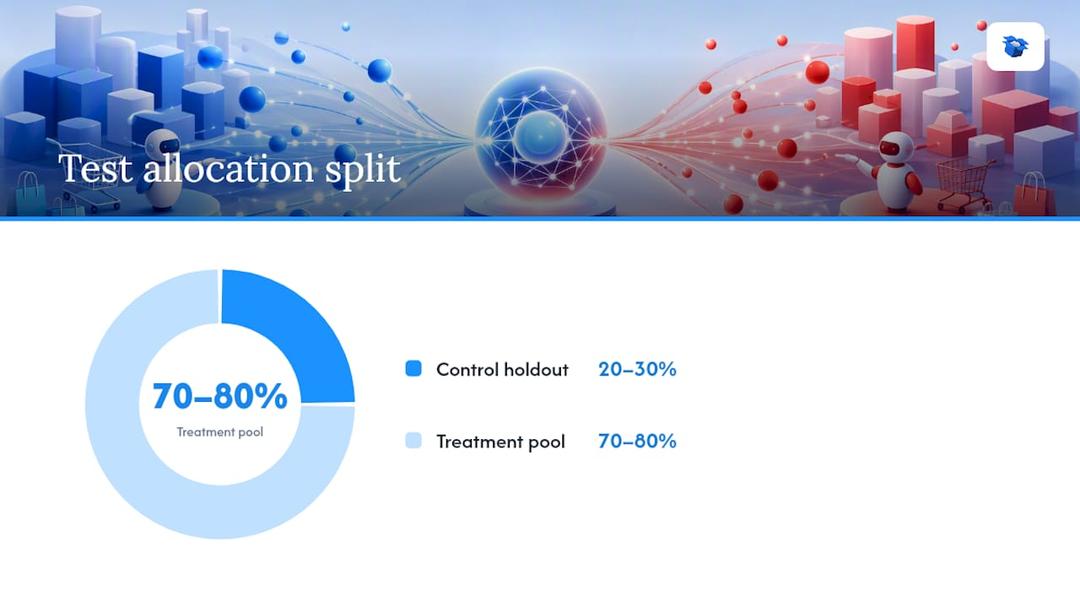
| 一度に1つの変数だけをテストする | エージェント由来の効果を切り分けるため、20%〜30%のホールドアウトを設け、少なくとも2週間のランダム化選択セットテストを実施します。 |
| 継続的な監視にEcenticを利用する | Ecenticは、ChatGPT、Gemini、Claude、Perplexityにおけるエージェントのスコアリングをシミュレーションし、商品情報変更後に自動で再スキャンします。 |
AIエージェント向け価格戦略で実際に必要なこと
このチェックリストでは、エージェントによる選定を左右する要素を整理しています。各項目を「完了」「進行中」「未着手」で管理し、上から順に対応してください。
すぐにできる改善(数分〜数時間):
- 価格整合性の確認。 ストアフロント、Google Shoppingフィード、稼働中のマーケットプレイスから現在価格を取得します。差異があれば、まずフィードを修正してください。
- しきい値価格の監査。 カテゴリで一般的な価格フィルター(「$30未満」「$75未満」「$150未満」など)を特定します。各しきい値を超えるのではなく、同額または直下に価格を設定してください。
- 星評価4.0以上。 エージェントは評価を強く重視します。平均評価が4.0未満の場合は、ほかの商品情報改善より先にレビュー収集を優先してください。
- レビュー数の基準。 レビュー数が少ないと選定確率が下がります。レビュー数を3件から25件に増やすだけでも、 エージェントのスコアリング実験.
- タイトルの完全性。 商品タイトルにはブランド、モデル、主要仕様、主な用途を含めてください。エージェントはタイトルを構造化シグナルとして解析します。
ツールまたは自動化が必要な施策(数日〜数週間):
- すべての商品ページにJSON-LDスキーマを実装する。 これがないと、多くのエージェントは商品情報をスコアリングできません。
- 推薦タグとバッジの可視化。 「Overall Pick」「Best Seller」などのタグは価格上乗せ余地を生みます。フィードとページ上のマークアップに表示してください。
- 継続的な価格整合性監視。 手動確認ではズレが生じます。自動フィード比較を設定するか、定期再スキャン対応のプラットフォームを利用してください。
- エージェント流入のアトリビューション計測。 計測できないものは最適化できません。エージェント経由のトラフィックをオーガニックや広告流入と分けて計測できるようストアを設定してください。
プロのヒント: しきい値ちょうどではなく、その直下の$X.99で下限価格を設定してください。「$50未満」で絞り込むエージェントは$49.99のSKUを含めますが、$50.00は除外します。原価積み上げだけの価格設定では、想像以上にフィルターの外側に出やすくなります。
AIエージェントは実際にどのように商品をスコアリングするのか?
エージェントは人間のように閲覧しません。フィードやページマークアップから取得した属性に対して構造化スコアカードを実行し、重み付き効用モデルに近い方法で候補を順位付けします。Columbia Business Schoolの研究では、同じ属性でもエージェントモデルごとに重み付けが異なることが確認されており、1つのエージェントだけを最適化して他を無視するのは実際にリスクがあります。
テストされたすべてのモデルで、価格は負の重みとして作用します。一方、評価とレビュー数は正の重みです。検索結果内の掲載順位や推薦タグは効用を加算し、高価格を相殺できる場合があります。
重要な発見: ACESのランダム化実験では、おおよそ −1.6〜−2.8 の価格弾力性推定値が、エージェントモデルや商品群ごとに報告されています。ほかの条件が同じ場合、価格を10%上げると、モデルによって選定確率が16%〜28%低下します。
| 属性 | 選定への影響 | 根拠ソース |
|---|---|---|
| 価格 | 負の影響(強) | ACES / arXiv実験 |
| 星評価 | 正の影響(強) | ACES / arXiv実験 |
| レビュー数 | 正の影響(中程度) | ACES / arXiv実験 |
| 掲載順位 | 正の影響(モデル依存・大) | Columbia Business School |
| 推薦タグ(「Overall Pick」) | 正の影響(非常に大きい・モデル依存) | ACES / arXiv実験 |
| 構造化データの完全性 | 必須条件(スコアリング対象になるために必要) | AgentMint実務者分析 |
Columbiaの研究で明確になった点が1つあります。エージェントは価格を比較する前に、まずデータ完全性で選別します。属性が欠けた商品情報はスコアが低くなるのではなく、そもそもスコアリングされないことが多いのです。
価格戦略プレイブック:効果順に並べた7つの施策
まず価格整合性を優先してください。チャネル間で価格が一致するまでは、それ以外は二次的です。
優先施策:
- まずチャネル間の価格整合性を徹底する。 Perplexityのマーチャント分析では、DTCストアフロント、Google Shopping、マーケットプレイス商品情報間での価格不一致が 購入完了率を低下させる ことが確認されています。低下幅は約23%です。ほかの価格施策より先に修正してください。
- しきい値を意識した下限価格を設定する。 カテゴリ内で一般的な検索フィルターを洗い出し、それぞれの直下に価格を設定してください。目的は値下げではなく、フィルター内に残ることです。
- 推薦タグで価格上乗せ余地を確保する。 ACES実験では、「Overall Pick」形式のタグが非常に大きな価格上乗せ余地を生み、一部モデルではタグなし競合より高い価格差を十分相殺できることが示されています。獲得済みバッジはすべてフィードマークアップに表示してください。
- バンドル商品でアンカリングを行う。 $59の単品商品の隣に$89のバンドル商品を置くと、相対価値を解析するエージェントには単品がお得に見えます。エージェントは構造化データ内のアンカリングシグナルを読み取ります。
- エージェント検索タイミングに合わせた期間限定プロモーションを実施する。 購買ピーク時に検索されたエージェントは、価格変更の新しさを重視します。エージェントがスキャンした時点で有効な一時的値引きは、6か月前に設定された恒久価格より有利です。
- 価格弾力性で裏付けられる場合のみ恒久的な価格変更を行う。 計画時には−1.6〜−2.8の価格弾力性レンジを参考にしてください。カテゴリ内で価格を10%下げても選定率上昇が16%未満なら、利益率を犠牲にする価値はありません。
- ガードレール付きでエージェント型リプライシングを導入する。 自律型リプライシング は手動ルールより高速に対応できますが、正確な競合データと在庫データが必要です。自動リプライシングを有効にする前に、利益率の下限を必ず設定してください。
これは実際に有効な価格上乗せ余地ですが、幅は広く、モデル依存です。
AIエージェントに対する価格変更のテスト方法
ランダム化選択セットテストを実施します。テスト変数(価格、バッジ、説明文)だけを変更したミラー商品セットをエージェントに提示し、選定率、コンバージョン率、AI由来注文数を計測してください。
テスト設計手順:
- テストごとに変数は1つに限定する。 価格、推薦タグ、説明文リライトのいずれかです。2つ同時には変更しないでください。
- ホールドアウトセットを作成する。 SKUの20%〜30%はコントロール価格のまま維持し、比較基準を確保してください。
- 最低2週間は実施する。 それより短い期間では、曜日変動やプロモーションノイズの影響を受けやすすぎます。
- SKU単位でランダム化する。 掲載順位の交絡を避けるため、カテゴリ単位では行わないでください。
- 開始前にエージェント流入のアトリビューション計測を設定する。 もし エージェントトラフィック計測がなければ、測定しているのはエージェント由来コンバージョンではなく全体コンバージョンです。
| 指標 | 定義 | 測定方法 |
|---|---|---|
| エージェント選定率 | エージェント検索でSKUが選ばれた割合(%) | UCP/プロフィールフィールドタグ + エージェントアトリビューションログ |
| エージェント経由コンバージョン率 | エージェント経由セッションからの注文数 / エージェントセッション数 | UTMパラメータ + エージェント参照元 |
| AI経由売上 | エージェント経由と確認された注文からの売上 | エージェント参照元フィルター付きアトリビューションダッシュボード |
| 価格許容幅差分 | %価格変動あたりの選択率変化 | テストコホートデータに基づく条件付きロジットモデル |
よくある落とし穴: テスト期間中の掲載順位の変動は価格結果を汚染します。並行して実施される季節プロモーションは、両テスト群のコンバージョンを押し上げます。大型セール期間中のテスト開始は避けてください。
ShopifyとWooCommerce向け実装チェックリスト
AIが読み取れる商品スキーマを配信し、フィード整合性を維持し、継続的な再スキャンを有効化する。要点だけならこれです。実装方法は次のとおりです。
1日目:
- JSON-LDスキーマプラグインを導入または確認します。Shopifyでは、Schema PlusやTinySEOなどのアプリが対応します。WooCommerceでは、Yoast SEOやRank Mathを正しく設定すると商品スキーマが自動生成されます。 構造化データチェックリスト を使って、必要なフィールドがすべて揃っていることを確認してください。
- 商品フィードに欠落している属性をチェックします: GTIN、ブランド、状態、在庫状況、価格。エージェントはこれらの項目を選定条件として使用します。
- 価格整合性モニタリングを設定します。ShopifyまたはWooCommerceから現在の価格をエクスポートし、Google Shoppingフィードや稼働中のマーケットプレイスフィードと比較してください。
1週目:
- プラットフォームが対応している場合は、UCP(Universal Commerce Profile)フィールドを入力します。これらのフィールドにより、エージェントは標準スキーマを超えた構造化商品コンテキストを読み取れます。
- 商品ページにバッジと推奨マークアップを追加します。「Best Seller」や「Overall Pick」の指定を獲得している場合は、ページ上で視覚的に表示するだけでなく、構造化データにも含める必要があります。
- ストアをエージェントアトリビューションシステムに接続します。WooCommerceでは、 ecenticのWooCommerce連携 がフィード接続と再スキャンスケジュールを処理します。
1か月目:
- 設定した閾値(1%〜2%が一般的なトリガー)を超える価格乖離に対してアラートを出す、自動整合性モニタリングを有効にします。
- 価格や説明文が変更された後に商品情報スコアが更新されるよう、継続的な再スキャンをスケジュールします。
- 確認 AI商品情報診断 を確認し、どの属性がスコアカードを下げているかを特定します。
エージェントモデル更新時に何が壊れるのか?
モデル更新によって、属性の重み付けは変化します。あるモデルバージョンで上位掲載を有利にしていた掲載順位バイアスが、次のバージョンでは弱まったり逆転したりすることがあります。1つのモデルの重みに強く最適化し、他モデルを監視していなかった事業者ほど、一夜で可視性を失います。
注意すべき主なリスク:
- 掲載順位バイアスの変化。 Columbia Business Schoolの研究では、モデル依存の大きな掲載順位効果が確認されています。モデルが更新されると、自社で何も変更していなくても掲載順位の価値が変わる可能性があります。
- 整合性違反による表示抑制。 プロモーション終了後に価格整合性が崩れると、エージェントが商品情報の優先度を下げたり、除外したりする可能性があります。
- 小さな価格差による誤検知。 ストアフロントとフィードの間で$0.50の差異があるだけでも、一部のエージェントモデルでは整合性フラグが発生する可能性があります。
- 説明文の陳腐化。 エージェントは定期的に再スキャンを行います。6か月前に最適化した説明文でも、モデル更新によってテキストシグナルの解析方法が変われば、スコアが変化する可能性があります。
アラートチェックリスト:
- 毎週: 稼働中のすべてのチャネルで価格整合性を確認する。
- 隔週: 上位10件のSKUに対してエージェントシミュレーションクエリを実行し、前期間と選択率を比較する。
- 毎月: エージェント経由セッションの原因不明な減少がないか、エージェントアトリビューションデータを確認する。
- モデル更新の発表後: スコアが安定していると判断する前に、完全なシミュレーションスイートを再実行する。
モデル更新によって競争環境が変化した場合、赤字にならずに再価格設定できる余地が必要です。下限価格を厳しく設定しすぎた事業者は、手動オーバーライドなしでは対応できなくなることがあります。*
どの程度の結果を期待すべきか?
現実的な期待値であり、保証ではありません。ここでの前提はそれです。
ACESの実験では、説明文やタイトルの書き換えによって、特定のカテゴリとモデルの組み合わせで選択シェアが二桁伸びることが示されています。一部の変更では、シェアが30パーセントポイント以上動いています。ただし、多くの変更では測定できる効果が出ません。効果にはばらつきがあり、家電・電子機器で有効な変更が、アパレルでは何の効果も生まない場合があります。
基準レンジ: ACES実験による価格弾力性推定値は−1.6〜−2.8です。価格弾力性が−2.0のカテゴリで$45の商品を販売している場合、$5の値下げ(11%)により、他条件が同じなら選択確率はおよそ22%上昇すると予測されます。
実際に根拠として示されている内容:
- 価格整合性の維持は、購入完了率に一貫した測定可能な改善をもたらします。Perplexityの加盟店分析で示された23%の表示抑制という数値は、実務系文献で最も明確な単一指標です。
- 推奨タグは大きな価格許容幅を生み出す可能性がありますが、その規模はモデルやカテゴリによって異なります。
- 構造化データの完全性は差別化要因ではなく、参入条件です。競争するには必要ですが、揃っているだけで選ばれる保証にはなりません。
- 多くの個別最適化は、単独では効果を示しません。このプレイブックは、独立したレバーの集合ではなく、システムとして機能します。
結果はカテゴリ、エージェントモデル、競争密度によって異なります。実験平均が自社SKUに当てはまると決めつけず、独自テストを実施してください。
ecenticにおける考え方
このプレイブックから最も成果を得るのは、エージェント最適化を一度限りの修正ではなく、継続的なプロセスとして扱う事業者です。ecenticでは、シミュレーションエンジンがChatGPT、Gemini、Claude、Perplexityを横断して選択セットテストを同時実行するため、実際のエージェントクエリが発生する前に、どの商品情報が選ばれ、どれが比較で負けているかを把握できます。継続的な再スキャンにより、価格変更や説明文編集が行われると自動で新しい診断が実行されます。シミュレーション、価格整合性モニタリング、自動再スキャンを組み合わせることで、モデル更新によって数か月分の最適化作業が無効になるリスクを抑えられます。上記プレイブックは、このループを完成させるために設計されています。
ecenticは、このプレイブックに必要なシミュレーションレイヤーを提供します
多くの事業者は、このプレイブックを手作業で実行しています。フィードを書き出し、価格整合性を確認し、説明文を書き換え、次の エージェントセッション事例 スキャン結果が改善することを願う。ecenticは、この推測ベースの運用をシステム化します。ShopifyまたはWooCommerceストアを接続すると、ecenticがChatGPT、Gemini、Claude、Perplexityによる商品情報のスコアリングを現在の状態でシミュレーションし、何がスコアカードを下げているのかを平易な言葉で診断します。

価格整合性モニタリングは継続的に実行されます。説明文とタイトルの書き換え提案はワンクリックで公開可能です。エージェントアトリビューションにより、どのSKUが実際にエージェントセッション経由で推奨され、購入されているかを確認できます。このプレイブックを読み、適切に運用するための計測基盤を求めている事業者にとって、無料の商品スキャンは現在地を最速で把握する方法です。
FAQ
AIエージェントはどのように推奨商品を決定するのですか?
エージェントは、価格、星評価、レビュー数、掲載順位、推奨タグなどの構造化属性を使って商品情報をスコアリングします。商品フィードの完全性は必須条件であり、フィールドが欠けていると商品情報自体がスコアリング対象にならないこともあります。
AIエージェントの推奨に悪影響を与える最大の価格設定ミスは何ですか?
チャネル間の価格不一致です。ほかの価格最適化を行う前に、まず価格整合性を修正してください。
価格はAIエージェントの選択確率にどの程度影響しますか?
ACESのランダム化実験では、エージェントモデルごとの価格弾力性推定値は−1.6〜−2.8の範囲と報告されています。
「Overall Pick」のような推奨タグは、高価格を補えますか?
はい。一部のモデルでは大きな効果があります。ACESの実験では、推奨タグが測定可能な価格許容幅を生み出すことが示されています。つまり、タグ付き商品はタグなし競合より高価格でも選ばれる可能性があります。効果の大きさはモデル依存です。
EcenticはどのようにAIショッピングエージェント向け最適化を支援しますか?
Ecenticは、ChatGPT、Gemini、Claude、Perplexityが商品情報をどうスコアリングするかをシミュレーションし、平易な言葉で診断結果を提供します。また、価格や説明文の変更後には自動で再スキャンを実行します。さらに、チャネル間の価格整合性を監視し、ShopifyおよびWooCommerceストア向けにワンクリックの商品情報更新もサポートします。