

検索するにせよ、Amazonに行くにせよ、チャットボットに尋ねるにせよ、AIは商品を含む回答を返します。しかも多くのECブランドは、どうすれば自社商品がその回答に選ばれるのか把握できていません。オムニチャネルAIアトリビューションとは、オンラインとオフラインを含む各チャネルが注文にどう貢献したかを、機械学習で明らかにしようとするものです。そのためには、クリーンなタッチポイントデータ、数か月分の履歴、そして出てきた答えがもっともらしいだけでなく因果的に妥当かを確かめる手段が必要です。
これが私の見方です。アトリビューションは昔から、データが過去について語るひとつのストーリーであり、AIはその語りをより流暢にすることが多いだけです。誰がそのストーリーを書いたのかを忘れなければ、それは有用です。一方で、買い物客のアシスタントが商品フィードを読み、商品を選び、ときにはその商品を購入する新しいチャネルが現れています。たいていのアトリビューションダッシュボードには、そのための列がありません。
要点
- オムニチャネルアトリビューションは、オフラインや自社保有チャネルも含むすべてのタッチポイントを、ひとつの全体像として結び付けます。マルチチャネルアトリビューションは通常、デジタルチャネルを1つずつ比較します。
- AIモデルには、ユーザー単位のタッチポイントデータとコンバージョンデータが必要です。Adobeによれば、良いモデルには少なくとも90日分のデータと1,000件のコンバージョンが必要です。
- アトリビューションが示すのは何が起きたかです。マーケティングが何を引き起こしたかを示せるのは実験だけなので、ホールドアウトでモデルを補正してください。
- 段階的に導入します。KPIを設定し、データを監査し、一元化し、モデルを検証してから、予算配分を変えて結果を見ます。
- AIアシスタントは今や訪問と注文の流入元です。独立したチャネルとしてタグ付けし、読み取られる商品情報を修正してください。
実務で見るオムニチャネルアトリビューションの意味
マルチチャネルアトリビューションは、運用しているデジタルチャネル、たとえば有料検索、ソーシャル、メール、アフィリエイトの間で貢献度を割り当てます。それぞれが注文への持ち分を受け取る形です。オムニチャネルアトリビューションは、さらに先まで踏み込みます。コネクテッドTV広告を見て、店舗を訪れ、メールを開き、その後サイトで購入する買い物客を1人の人物として扱い、それらのチャネルがどう相互に強化し合うかを問います。
定義はベンダーごとに少しずつ異なります。ここが重要です。というのも、何が本当に「オムニチャネル」に含まれるかは、そのベンダーのデータルールで決まるからです。たとえばKlaviyoの オムニチャネルアトリビューションに関するヘルプセンターのドキュメント では、識別済みサイトセッションとKlaviyoメッセージのインタラクションを組み合わせると説明されています。その設定がオンであれば、買い物客が後から識別された場合に、それ以前の匿名アクティビティも含められます。他のソースからのセッションは、アトリビューションパラメータが付いていて、設定された期間内に収まる場合にのみ計上されます。これはメールとSMSのプラットフォームとしては、きわめて妥当な設計です。一方で、TVプランナーが使う「オムニチャネル」よりは狭い概念でもあります。
実務上の見極め方はシンプルです。ツールがオムニチャネルをうたうなら、実際にどのタッチポイントを観測できていて、どれを推定しているのかを確認してください。POS、マーケットプレイス出店、Shopifyサイトを持つストアには、顧客が誰かについて一致しないことが多い3つのデータソースがあります。アトリビューション層のつながりは、その下にあるID統合層の完成度を超えません。
AIが加わることで何が変わるか
従来のルールはシンプルです。ファーストタッチは最初の接点に、ラストタッチは最後の接点に貢献を割り当て、線形モデルは均等に配分します。AIベースのモデルは、その重みを代わりにデータから学習します。
具体例としてわかりやすいのがAdobeの Attribution AI overview です。そこでは、このサービスがディスプレイ広告のインプレッション、メールの送信・開封、有料検索のクリックなどを含め、チャネル横断・ジャーニー各段階における顧客インタラクションの影響度と増分効果を計算すると説明されています。同じページには、対応しているルールベースのスコアとして、ファーストタッチ、ラストタッチ、線形、U字型、タイムディケイも挙げられています。つまりAI製品であっても、比較のために従来モデルを残しています。これは正しい判断だと考えます。
2つ目の要素はオフラインのリーチです。Adobeの unified modeling documentation では、集計レベルのマーケティング・ミックス・モデリングとイベントレベルのマルチタッチアトリビューションを組み合わせる因果AIモデルが説明されています。イベントレベルの部分はジャーニーを説明します。集計レベルの部分は、オフラインチャネル、逓減効果、チャネル同士の相互作用を捉えます。どちらか片方だけでは役割を果たしきれず、それがハイブリッド型アプローチが存在する主な理由です。
では、AIによって何が得られるのでしょうか。これらの仕組みを見てきた経験では、主に3つあります。
多数のタッチポイントを、手作業で重み付けせずに扱えます。検討期間の長い購入で重要になる遅効性もモデル化できます。そして、行動が変化すれば再推定できます。ただし、真実そのものが得られるわけではありません。得られるのは、より当てはまりのよい推定です。
必要なデータ
多くのプロジェクトが止まるのはここで、たいていはモデルを作る前です。
Adobeの Attribution AIの入力と出力に関するドキュメント は具体的です。モデルには、タッチポイントとコンバージョンの識別関連の項目とタイムスタンプ項目、タッチポイントのチャネル項目とマーケティング項目、さらにコマースのコンバージョンデータが必要です。良いモデルには少なくとも90日分のデータと1,000件以上のコンバージョンが必要で、デフォルトのトレーニング設定とルックバック設定では236日分の入力が求められます。Adobeは、コンバージョン列とタッチポイント列をできるだけ多く含めることも推奨しています。
これを小規模ストアに当てはめて考えてみてください。月200件の注文なら、90日という最小期間内に1,000件のコンバージョンには届きません。これはマーケティングへの評価ではなく、その特定の製品に関する適合性の話です。小規模チームには、シンプルで透明性のあるモデルに、少数の適切に実施されたホールドアウトテストを組み合わせるほうが向いています。
データはベンダー自身の分析基盤からでも外部ソースからでも取り込めると、 同じAdobeの概要ドキュメント にもあります。一方、グラフベースのニューラルアプローチは、より多くのデータを必要とします。Kumoの コンバージョンアトリビューションに関する技術ドキュメント では、ユーザーレベルのジャーニーデータ、タイムスタンプ、明確なコンバージョンイベントが必要であり、チャネル別の集計データしかない場合には不向きだと説明されています。
平たく言えば、どのモデルを使うにしても、その前に必要なのは次の3つです。
| 手元にあるデータ | 適した手法 |
|---|---|
| 週次の広告費と売上の集計データのみ、ユーザーレベルのジャーニーなし | マーケティング・ミックス・モデリングとシンプルなホールドアウトテスト |
| Webとメールのユーザーレベルデータ、単一のID | ルールベースおよびデータ駆動型のマルチタッチアトリビューション |
| Web、アプリ、店舗、広告をまたぐユーザーレベルデータに加え、十分なボリューム | 実験で補正した機械学習アトリビューション |
この表は、上記のAdobeとKumoのドキュメントにあるデータ要件を反映したものです。こうありたい行ではなく、現在の状況に当てはまる行を選んでください。
アトリビューションはインクリメンタリティではない
アトリビューションツールを導入する前に1つだけ読むなら、この2つの考え方の違いを読んでください。
IABの コマースメディアにおけるインクリメンタル測定のガイドラインは、2025年11月に公開され、両者を明確に区別しています。アトリビューションと ROAS は、観測された寄与、つまり何が起きたかを示します。インクリメンタリティは、信頼できる「マーケティングを行わなかった場合」という反実仮想と比べて、マーケティングが生んだ追加的な成果を推定します。ガイドラインでは、その反実仮想を作る方法として、無作為に割り付けた対照群、ホールドアウトやゴースト広告、マッチドマーケット、合成コントロールを挙げています。また、季節性、価格設定、販促、競合、同時進行のキャンペーン、選択バイアス、多重共線性、広告接触データの結び付けが不完全であることが、推定を歪める可能性があるとも警告しています。
最後の一覧こそ、Black Fridayの数字が読みづらい理由です。すべてが同時に動くからです。
研究者たちは、そのギャップを埋めようとしています。Management Scienceの研究 Predicted Incrementality by Experimentationは、2026年10月8日に公開され、2,226件の Meta の実験を使って、実験結果と実験を行っていないキャンペーンとの対応関係を学習しました。この研究では、ドル当たりの増分コンバージョンについて、サンプル外の R² は 0.88 で、七日間のラストクリックアトリビューションでは 0.19 だったと報告しています。また、この手法の判断が実験に基づく判断と食い違ったのは、キャンペーンの 8%〜12% で、ラストクリックでは 12%〜20% だったとも報告しています。
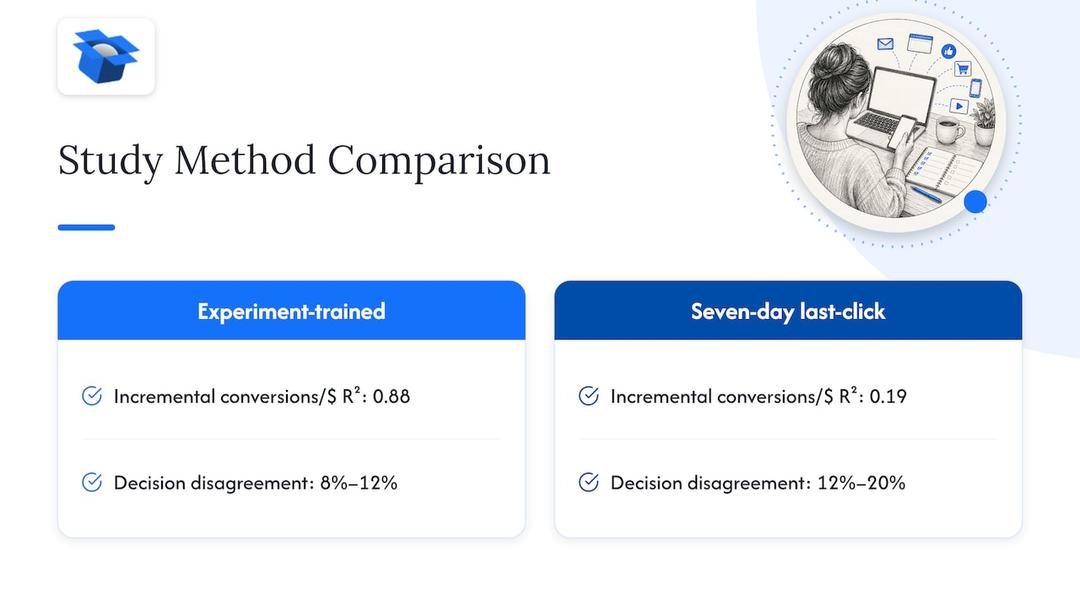
ここから私が読み取ったことは二つあります。一つは、ラストクリックは広告が実際に生んだ成果を予測する指標として弱く、多くの人が感じていた通りだということです。もう一つは、最も良い成績を収めた手法も、無作為化実験から学習していたということです。AI は実験を置き換えたのではなく、その適用範囲を広げたのです。
公平に言えば、この研究が対象にしているのは1つのプラットフォーム上の広告キャンペーンです。メール、店舗来訪、オーガニックチャネルがどう動くかまでは分かりません。これは手法の根拠として受け取り、数字のベンチマークとしては扱わないでください。
今四半期に実行できる展開計画
IABの クロスチャネル測定プレイブック では、多くの規模のeコマースチームで通用する手順が示されています。実務の順番に並べると、次の通りです。
- 目的とKPIを定義する。 モデルによって変えるべき意思決定を選びます。たとえば、有料ソーシャルとメールの間で予算配分を変えるといった判断です。その答えに依存する意思決定がないなら、そのプロジェクトは見送ってください。
- チャネルとタッチポイントを洗い出す。 Dataikuの アトリビューションガイド では、すべてのタッチポイントを一覧化し、それぞれのデータソースと制約を文書化することを勧めています。データへの理解が不十分だと、精度だけでなく関係者の信頼も損なわれるからです。
- データを一元化する。 IABのプレイブックでは、すべてのチャネルをウェアハウスまたはデータレイクに集約し、ガバナンスを徹底し、可能な場合はETL(データを移動・クレンジングする処理)を自動化することが説明されています。
- 複数のモデルを並行して検証する。 同じプレイブックでは、機械学習によるデータドリブンアトリビューションを、シングルタッチやルールベースのマルチタッチモデルと並行して使うことを勧めています。結果が食い違うなら、それ自体が情報です。
- ルックバック期間は正直に設定する。 Adobe Mix Modelerでは、チームが 1週間から52週間のルックバックウィンドウを定義でき 、さらにチャネルごとのadstockとlagを設定できるため、反応の遅いチャネルを即効性のあるチャネルのように扱わずに済みます。
- プライバシーと同意を確認する。 これは構築前に行ってください。ローンチ後ではありません。
- 予算配分を変え、その後を観察する。 Dataikuは、アトリビューションモデルは通常の予測モデルのように評価できないと説明しています。比較対象となる既知のラベルがないからです。実務上のテストは、モデルに基づいて予算を動かし、その後の事業成果を観察することです。
チームが飛ばしがちなのは7番目です。誰も行動に移さないモデルは、ただのダッシュボードです。
限界とプライバシー:率直な説明
IABの クロスチャネル測定のベストプラクティスガイド では、障害としてデータサイロ、アトリビューションの複雑さ、技術的な障壁、プライバシーへの懸念を挙げています。推奨される対応策は、データの一元化、インプレッション単位の詳細な記録、問いに合ったアトリビューションモデル、予測分析、ダッシュボード、同意管理です。この一覧に特別なものはありません。大半は運用の基本であり、モデルが機能するかどうかを決めるのもその基本です。
IABの State of Data 2026レポートは、2026年2月の米国調査で、プライバシー規制とプラットフォームの変更により、データが分断された別々のシステムにまたがるようになったと述べています。また、測定におけるAI導入の主な障壁として、法務、セキュリティ、精度、データ品質、アクセス性、セットアップ、コスト、バイアスへの懸念を挙げています。
プライバシー保護技術にはコストが伴います。 2026年の108件の研究を対象としたシステマティックレビュー では、差分プライバシーにより、文書化された設定におけるプライバシーバジェット次第で精度が2%〜33%低下したと報告しています。同レビューでは、フェデレーテッド型アプローチは文書化された導入事例において、集中型パフォーマンスのおよそ90%〜95%を維持した一方、汎化性能と因果的妥当性については十分に検証されていないとも述べています。また、ディープラーニングによるアトリビューションは予測精度を向上できるものの、実験によるキャリブレーションなしでは因果関係を特定できないことも指摘しています。
率直にまとめると、プライバシーを強化するほどモデルは曖昧になりやすく、モデルの精度が高いからといって自動的に正しいとは限りません。どちらも、実験を組み込んで検証を続けるべき理由です。
多くのアトリビューション設定が見落としているチャネル
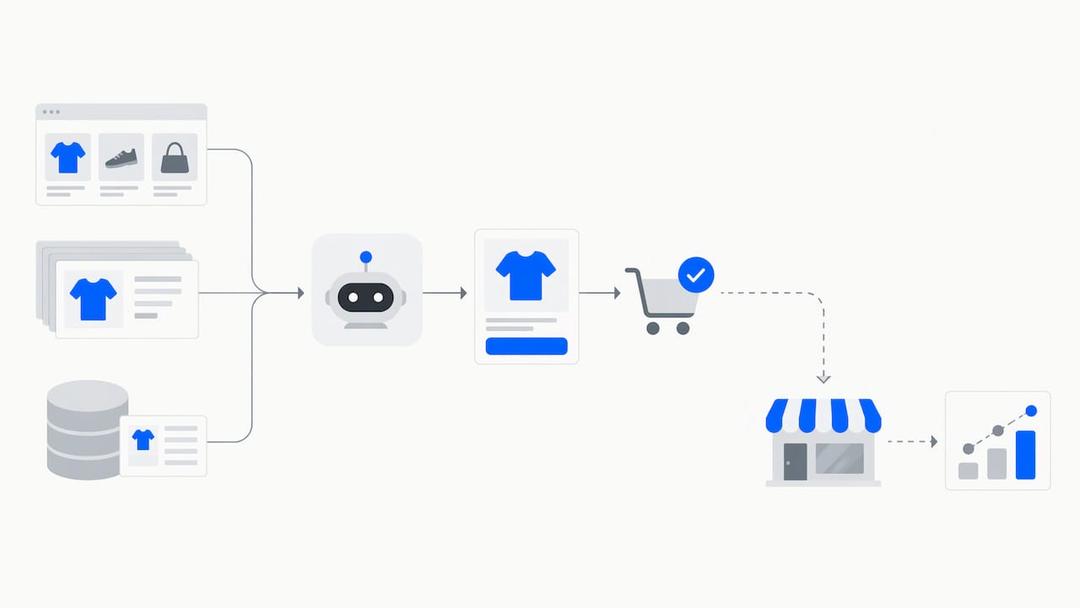
ここで、一般的な定石とは異なる見方になります。従来の考え方は、クリックするのは購買者本人だと想定しています。しかし現在では、商品発見のかなりの割合が、購買者に代わってデータを読むアシスタント経由で行われています。アシスタントはホームページを見ません。読み取るのは商品フィード、カタログ、そして商品ページ上の構造化データ(商品内容、価格、配送情報などを示す機械可読ラベル)です。
米国のGoogleのAI ModeやGeminiでは、エージェントがGoogleのエージェント決済向けオープン標準であるUCPを通じて、購買者の代わりに決済まで行える場合があります。一方、ChatGPTはストア独自の購入手続きへリンクします。OpenAIにはACP、GoogleにはUCP、Amazonには閉じた仕組みがあります。
アトリビューションにおいて、これは2つの問題を生みます。1つ目は、アシスタント経由の訪問が「direct」や「referral」に分類されることが多く、チャネルが見えなくなること。2つ目は、アシスタントによる選択が、測定可能な接点より前に行われることです。商品情報の比較で負ければ、そもそもアトリビューション対象となる訪問自体が発生しません。
その選択の偏りがどれほど大きいかも確認しています。同じカタログで実施した自社シミュレーション購入では、ChatGPTがClaudeやGeminiより約3倍多く商品を選択しました。割合は51.6%に対して約18.5%です。実質的に、各アシスタントは独自ルールを持つ別々のチャネルと言えます。測定面を詳しく知りたい場合は、以下のページをご覧ください。 AIショッピングトラフィックを追跡する方法, eコマース向けAIアトリビューションで測定できること および AIを活用したCookieレスアトリビューション。ソフトウェアを比較検討している場合は、 AIアトリビューションツール比較 で、各ツールの違いと適した用途を紹介しています。
公平に補足すると、ecenticは完全なオムニチャネルアトリビューションスイートではありません。TV広告費や実店舗への来店数をモデリングすることはできません。ShopifyではAIアシスタントからの訪問を追跡し、前述のギャップを埋めますが、収益や売上は追跡しません。それ以外については、既存のアトリビューション基盤を引き続き利用してください。
アトリビューションの次の展開についての私たちの見解
次のアトリビューション競争の焦点はCookieではないと考えています。クリック前に誰が選ばれるかです。AIエージェントが購買者に1つの商品だけを提示した場合、その比較で負けたブランドは、どれほど高度なモデルを使っていてもレポートに現れません。
そのため私たちは、ストア自体に取り組んでいます。対象は、商品フィード、カタログ、そしてエージェントが商品を買う際の購入手続きです。ecentic は Shopify、WooCommerce、または商品フィードに接続し、ChatGPT、Claude、Gemini に各商品を指定した競合の商品と比較させ、選ばれない理由を表示します。販売事業者が「適用」をクリックすると、ecentic がタイトル、説明文、構造化データを書き換え、ストアに公開します。
Shopify では、ecentic が修正内容を Google Merchant Center に送り、AI アシスタントからの訪問を追跡します。WooCommerce では、無料の ecentic プラグインを使い、エージェントが商品を検索し、カートに追加して、UCP で購入手続きを完了できます。この購入手続きの部分が、単なるフィードツールにはない機能です。
数値はまだ初期段階であり、その点も明示しています。最初のパイロット導入であるDUA Flavoursでは、AIアシスタント経由の訪問とダイレクトトラフィックが2026年4月から7月にかけて12%増加しました。これは訪問数の指標であり、売上指標ではありません。それ以上の意味づけはしていません。
現実的な順序はこうだと考えています。従来チャネルの測定は継続し、実験でキャリブレーションを行い、そのうえでまずエージェントがストアを読み取り、購入できる状態を整えることです。負けているチャネルを測定するだけでは、負け続ける様子を正確に観測することになります。
Xhurian Shaba
自社商品で試す
AIアシスタントが自社商品を指定した競合商品とどう比較しているか確認したい場合は、まず無料スキャンをお試しください。対象は上位10商品で、カード登録は不要です。エージェントがなぜ他の商品を選ぶのかを平易な英語で表示するため、タイトル、説明文、構造化データのどこを改善すべきか分かります。

有料プランは、最大100商品まで対応するCompeteが月額$14.90からです。Scaleは月額$44.90で、最大1,000商品とワンクリック修正に対応します。Dominateは月額$149で、Google Merchant Center同期とエージェント決済設定が追加されます。また、AIアトリビューション対象注文の3%を課金する従量制オプションもあり、上限は月額$500です。最新の利用条件は ecentic料金ページに掲載されています。また、 仕組みを見る では、シミュレーション、原因分析、最適化の流れを説明しています。
FAQ
オムニチャネルアトリビューションとマルチチャネルアトリビューションの違いは何ですか?
マルチチャネルアトリビューションは、運用しているデジタルチャネル間で貢献度を分配するもので、通常はチャネル単位で評価します。オムニチャネルアトリビューションは、オフラインや自社保有チャネルを含むすべての接点を、1人の顧客を軸に結び付けようとします。実際には、その違いはツールが実際にどのデータを統合できるかに左右されるため、どの接点を可視化できるか確認することが重要です。
AIアトリビューションにはどの程度のデータが必要ですか?
製品によって異なります。AdobeのAttribution AIドキュメントでは、良好なモデルには少なくとも90日分のデータと1,000件のコンバージョンが必要であり、デフォルト設定では236日分の入力データが求められるとされています。それより少ない規模のストアでは、通常はよりシンプルなモデルやホールドアウトテストの方が適しています。
AIアトリビューションで、どのチャネルが売上を生んだか証明できますか?
いいえ、それだけではできません。IABのガイドラインでは、アトリビューションは「何が起きたか」を説明するものであり、インクリメンタリティの測定にはホールドアウトやマッチドマーケットのような信頼できる反実仮想が必要だとされています。モデルは仮説形成に使い、実験で検証してください。
オムニチャネルアトリビューションはAIアシスタントからのトラフィックも対象になりますか?
設定次第です。多くの設定では、アシスタントからの訪問がdirectやreferralトラフィックにまとめられています。アシスタントを独立した流入元としてタグ付けし、さらに読み取られる商品データを充実させて、まず商品が選ばれる状態にしてください。
参考資料
- オムニチャネルアトリビューションの理解、Klaviyo Help Center
- Attribution AI概要、Adobe Experience Platform
- Unified Modeling、Adobe Marketing Campaign Analytics
- Attribution AIの入力と出力、Adobe Experience Platform
- Ad Tech向けコンバージョンアトリビューション、Kumo
- Commerce Mediaにおけるインクリメンタル測定ガイドライン、IAB
- 実験による予測インクリメンタリティ、Management Science
- マーケター向けクロスチャネル測定の実装、IAB
- 機械学習で強化するマーケティングアトリビューション、Dataiku
- Mix Modelerでのモデル構築、Adobe
- マーケター向けクロスチャネル測定のベストプラクティス、IAB
- IAB State of Data 2026
- マーケティング測定のための信頼できるAI:システマティックレビュー、SSRN