

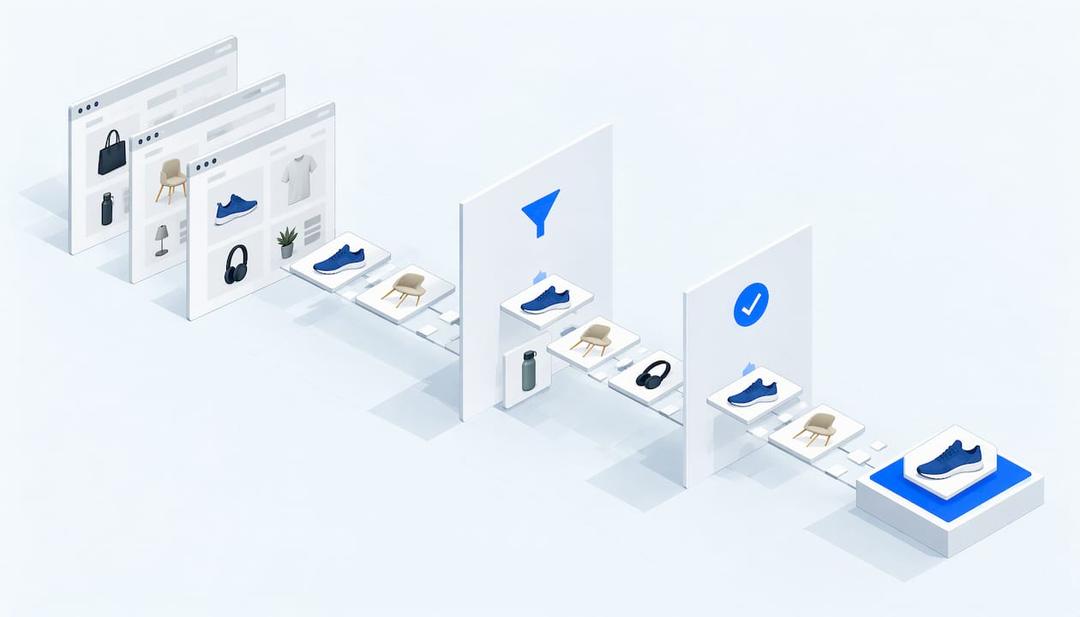
ECサイトにおけるLLM評価とは、言語モデルが実際の購買タスクを正しく完了できるかを検証することです。たとえば、適切な商品を見つけること、他商品と比較すること、そしてカートに入れることです。ストアにとっては、これには2つの形があります。自社サイトで運用しているチャットボットをテストする場合と、外部のAIエージェントが自社商品をどう扱うかをテストする場合です。人々がGoogleで調べるにせよ、Amazonに行くにせよ、チャットボットに尋ねるにせよ、AIは今や商品を含む回答を返します。しかし、ほとんどのECブランドは、その商品として選ばれるにはどうすべきかを把握していません。
私見では、評価に関する議論の大半はモデルを作る側に向けられており、それを通じて売らなければならない側にはほとんど向けられていません。ストアを運営しているなら、必要なのはモデルを採点することではありません。なぜ他社商品が選ばれるのかを知ることです。これは別の試験であり、受けているのはストアの側です。
要点
- ショッピングエージェントの評価とは、単発の回答ではなく、ループ全体(検索、確認質問、レコメンド、カート追加)を採点することです。
- 現在の研究では、強力なモデルでも購買タスクの多くで失敗することが示されており、商品データは期待以上にその負担を担わなければなりません。
- エージェントが読むのはホームページではなく、商品フィード、カタログ、構造化データです。識別子の欠落、あいまいな価格、数値化されていない仕様があると、商品は候補から外されます。
- ストア運営者にとって有用なテストは、同じ購買質問で、自社商品と指名した競合商品を正面比較し、それを複数回繰り返すことです。
- データを修正し、公開して、もう一度実行します。1回のスキャンはスナップショットにすぎませんが、複数回の実行結果は根拠になります。
ECサイトにおけるLLM評価の2つの意味
この言葉は、混同されがちな2つの作業を指しています。
1つ目は、自社で導入するLLMを評価することです。たとえば、サイト上で質問に答え、商品を提案し、カートに追加するショッピングアシスタントです。この場合はモデルを選び、プロンプトを管理し、すべての会話を確認できます。評価すべきなのは、そのアシスタントが本当に役に立つかどうかです。
2つ目は、外部のAIショッピングエージェントが自社ストアをどう扱うかを評価することです。モデルを選ぶのはストア側ではありません。多くの場合、買い物客自身も気づかないまま選んでいます。エージェントはホームページを見ません。商品フィード、カタログ、商品ページの構造化データを読み取り、どの商品を買い物客に提示するかを決定します。問われるのは、その過程で自社商品が選ばれ続けるかどうかです。
学術研究の多くは1つ目の作業に焦点を当てています。それでも2つ目にも参考になるのは、ショッピングタスクを適切に評価するとどう見えるか、そしてモデルがどこでつまずくのかを示しているためです。
ベンチマークが実際に検証していること
Rezolveの研究者は、RecSys 2026ワークショップで次の内容を扱う論文を公開しました。 12種類のモデルを会話型ショッピングエージェントとしてベンチマーク評価 検索、要件確認、推薦、カート追加までの一連の流れ全体を対象にしています。5種類の評価基準を持つLLMジャッジと、会話ログから取得した行動指標を用いて、1,200件の会話(20シナリオを各5回実行)を採点しています。評価基準には、意図理解、要件確認、推薦品質、カート追加の正確性、グラウンディングが含まれます。グラウンディングとは、エージェントの説明内容が与えられた商品データと一致しているかという、シンプルな確認です。
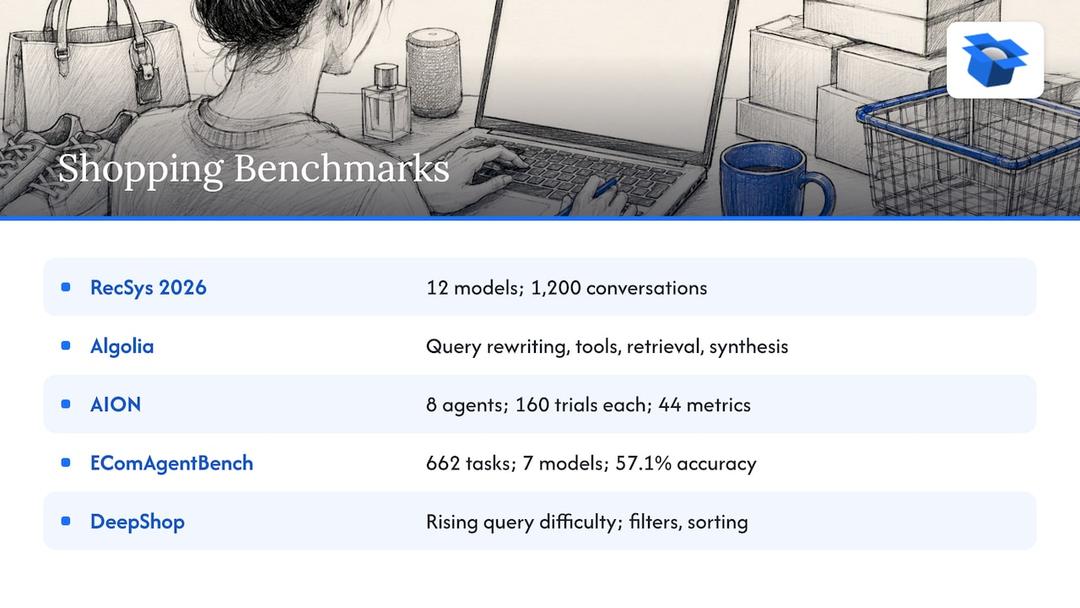
Algoliaのリーダーボードも、検索の観点から同様の考え方を取っています。各モデルは本番用の検索エージェント内で実行され、 クエリ書き換え、ツール呼び出し、情報取得、レスポンス生成について評価されます。評価対象には、回答テキスト、ツール呼び出し、取得されたレコードが含まれます。つまりモデルは、雑学クイズの回答者としてではなく、システムの一部として評価されています。
AIONの論文は、さらに厳密な評価を行っています。各試行で顧客ペルソナ、難易度、目標カートを事前に固定した決定論的なショッピング環境を構築し、 8つのオープンウェイトエージェントを、それぞれ160回の試行と44種類の指標で評価しています。この研究で有用なのは、最終的な成功・失敗だけでは、どこで問題が起きたか分からない点を示していることです。ツール実行ログと環境状態を保持することで、行動不足、過剰購入、根拠のない商品属性、検索品質の低さを切り分けています。これらはすべて「エージェントが間違えた」と見える一方で、実際には異なる4種類の失敗です。
EMNLP 2026 Industry TrackのEComAgentBenchは、実際のAmazon商品とレビューを基にした662件のタスクを使用しています。要件は、表示されるクエリ、非表示のプロフィール、あらかじめ決められた確認のやり取りに分散しており、エージェントは最終的にひとつの商品を選ばなければなりません。七つのモデルの中で最も性能が高いものでも、 総合精度は57.1%にとどまりました。また、要件が表示情報から非表示情報へ移るほど、結果は悪化しました。
アムステルダム大学のDeepShopは、難易度が段階的に上がるショッピングクエリでWebエージェントを評価しています。その結果として示されたのは、 単純な検索取得は複雑なクエリに弱く、他の手法もフィルターや並び替え条件でつまずく.
これらの論文をまとめて読むと、表現は違っても同じ結論にたどり着きます。ショッピングは複数ステップの作業であり、エージェントの失敗には具体的で診断可能な原因があります。そして、自信ありげに話すモデルでも間違った商品を選ぶことがあります。深夜の買い物で人間がやりがちなことに少し似ているので、その点では機械も親しみがあります。
ストアにとって重要な指標
研究者はモデルを採点します。一方、EC事業者は結果を評価しなければなりません。現実的なのは、次のような組み合わせです。
エージェントの商品説明の正確性 会話型ショッピングアシスタントに関するある論文では、 価格・在庫・機能の商品情報精度、価格帯精度、機能説明精度を定義しています。エージェントが誤った価格を提示したり、存在しない機能を作り上げたりすれば、どれほどランキング指標が良くても売上にはつながりません。
選択率 同じ買い物客の質問を繰り返し実行した場合、エージェントはどの程度の頻度で競合商品ではなく自社商品を選ぶでしょうか。これはストア運営者にとって最も重要な数値です。そして、モデルの回答は実行ごとに変わるため、これは単なるYes/Noではなく割合として見る必要があります。
会話全体の挙動 Zalandoの本番エージェント評価に関する論文では、 個々のターンではなく会話全体を評価するべきだと主張しています。関連性のような集計スコアでは、品質が変化したことは分かっても、何が失敗したのか、どう修正すべきかまでは分からないためです。EC事業者向けに言い換えると、勝率を見るだけでなく、なぜ負けたのかを確認する必要があります。
精度だけでなく網羅性 複数目的のレコメンド評価に関する論文では、 精度だけを最適化すると、実運用ではうまく機能しないシステムになると警告し、多様性、カバレッジ、公平性といった指標も求めています。ストアに置き換えると、主力商品5点だけでなく、カタログ全体を確認するということです。
公平を期すなら、これらの学術指標はいずれも売上を測定しているわけではありません。エージェントがその作業をこなせるかどうかを示しているのであって、銀行口座に変化があったかまでは分かりません。自社の注文データと合わせて確認する必要があります。
エージェントが商品データに求めるもの
評価に関して最も低コストで得られる気づきはこれです。エージェントはページではなくレコードを比較しています。
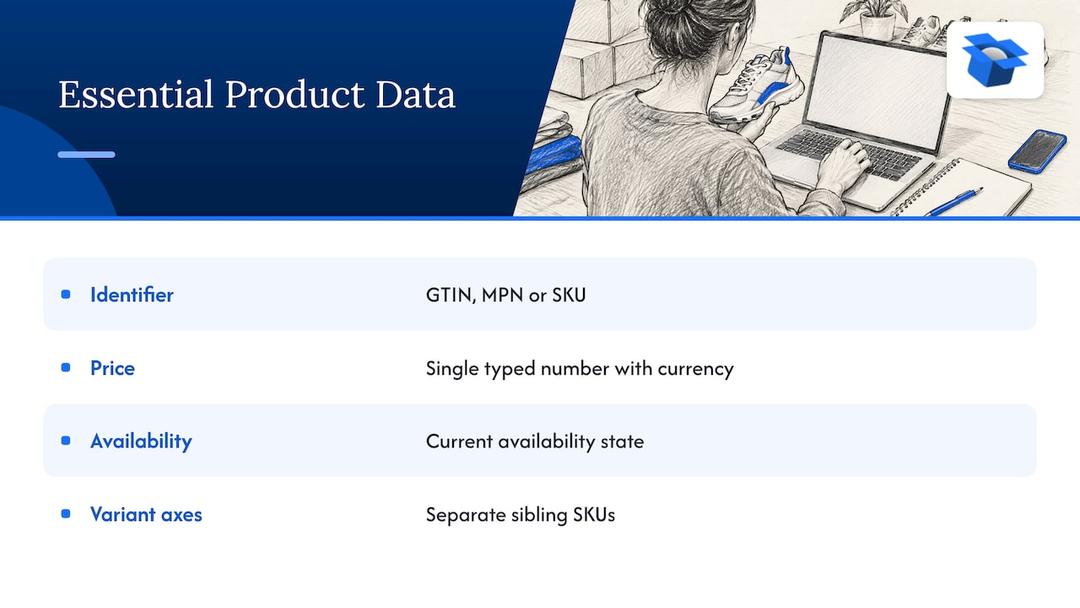
Ecommerce Guideでは、商品を比較可能にするかどうかを左右するフィールドを4種類挙げています。 安定した識別子(GTIN、MPN、SKU)、通貨付きの最新価格、在庫状態、そしてSKUを他のバリエーションと区別するバリエーション軸です。1つでも欠けると、その商品は条件付き比較から外されます。同じ記事では、価格は単一の型付き数値である必要があるとも指摘しています。「from $39」のような表示では、エージェントは$60の予算と照合できないため、その商品は静かに除外されます。
仕様情報も弱点になりがちです。数値条件は形容詞では検証できません。「軽量」は感覚ですが、「1.2 lb」は値です。多くのカタログは感覚表現で埋まっています。
これは、実際のチェックで見られる状況とも一致します。年間約€70Mを売り上げるある酒類マーケットプレイスでは、エージェントが読み取るデータに9,699商品のうち88%で問題がありました。そのストアで扱っている2本のボトルの購入先をエージェントに尋ねると、20回中0回しか選ばれませんでした。また、あるスウェーデンのスキンケアブランドでは、配送設定で電話番号入力が必須だったため、6か国中0か国でエージェントによる購入手続きが決済に到達しました。どちらのストア名も公開しません。重要なのは、どちらの問題もWebサイト上では見えなかったことです。人間の買い物客なら気づかなかったでしょう。しかしエージェントは即座に検知し、何も言わず、レビューも残さず離脱しました。
商品ページ自体がこの仕組みにどう関わるかを詳しく知りたい場合は、 AIが読み取れる商品ページ ではマークアップを解説しており、 AIショッピングエージェントが商品を推薦する仕組み では選定ロジックを扱っています。
自社ストアを段階的にテストする方法
研究機関は必要ありません。必要なのは、繰り返し実行できる手順です。実際に行うなら、次の流れになります。
- 買い物客の質問を作成する 顧客が実際に尋ねそうな質問を10〜20件選び、予算、サイズ、用途、配送先国などの条件を含めます。ブランド名は除外してください。買い物客は通常それを入力しないためです。
- 各商品に競合商品を設定する エージェントは複数の選択肢から選ぶため、比較対象が必要です。自分でカテゴリ検索した際に最も頻繁に表示される競合を使ってください。
- 複数モデルを複数回試す モデルごとに判断は異なり、同じモデルでも結果が変わります。自社シミュレーションでは、同じカタログに対して、ChatGPTはClaudeやGeminiの約3倍の頻度で商品を選択しました(51.6%対約18.5%)。1つのモデルの判定は、市場全体の判定ではありません。
- 負けた理由を記録する 「競合にはGTINがあるが、自社商品にはない」のような敗因は、勝率グラフ10枚分より価値があります。会話全体を読むべきだというZalandoの主張は、ここにも当てはまります。
- データを修正して再実行する 識別子、価格、仕様情報のように、一度に1種類ずつ問題を修正してください。何が結果を変えたのかを把握するためです。Zalandoのフレームワークでも、 ベースライン設定のための反復実行と、個別変更を比較するペア評価を使用しており、その考え方はストア規模でも有効です。
- 回答だけでなく決済も確認する 推薦で選ばれても、決済で失敗すれば、先ほどのスキンケアブランドの事例と同じです。エージェントが通る経路を実際に確認してください。検索、カート、配送、決済までです。
Google側のステップ6については、 UCP Playground で、AIショッピングエージェントをストアに対してテストできます。UCPは、Googleによるエージェント決済向けのオープン標準です。現在、Google AI ModeとGeminiでは、米国内でUCPを通じてAI回答内購入が利用可能です。一方、ChatGPTはストア独自の購入手続きへリンクします。OpenAIにはACPがあり、GoogleにはUCPがあり、Amazonは閉じた仕組みを取っています。
エージェントがサイトの機能をどう読み取っているかを手軽に確認したい場合は、 無料のWebMCPショッピング診断.
自社サイト上のチャットボットを評価する
本当に必要なのが1つ目の意味、つまりストアフロント上のブランド専用アシスタントであれば、ベンチマーク評価の手法を取り入れてください。単発の質問ではなく、複数ターンの会話をテストします。提案された各商品とバリエーションが、買い物客の条件や検証済みの商品データと一致しているか確認してください。追加質問を経ても条件が維持されるかも重要です。在庫切れ時の挙動も確認してください。アシスタントが事実を作り始めるのは、こうしたケースです。
ECにおけるAI活用事例を見ると、サイト内アシスタントがどこで価値を発揮するかが分かります。そして前述の評価基準を使えば、自社アシスタントが実際に機能しているか判断できます。
1点だけ注意があります。どれほど優れたサイト内アシスタントでも、サイトに訪れない買い物客には役立ちません。外部エージェントがすでに選定を終えているためです。だからこそ、前章のデータ整備が先で、アシスタントは後です。口に出せば当然に聞こえますが、実際にはほとんどの企業がこの順番を守っていません。
結果の信頼性を維持する
モデルもカタログも変わり、競合も商品フィードを更新します。三月のスコアから十一月の状況を知ることはほとんどできません。
評価はループとして扱ってください。スキャンを実行し、敗因を確認し、データを修正し、公開し、再度実行します。実行間で買い物客の質問を固定しないと、別の試験を比較することになります。新しい商品ラインを追加したら、その質問も追加してください。
また、実際に観測できる指標も追跡してください。たとえば、分析ツールで確認できるAIアシスタント経由の訪問数や、自社側の注文数です。最初のパイロットでは、DUA FlavoursのAIアシスタント経由および直接流入の訪問数が、2026年4月から7月にかけて12%増加しました。これは売上ではなく訪問数です。誤解を招くより、明示したほうが良いと考えています。 AIエージェント流入の測定 と アトリビューションツール のガイドでは、測定面を詳しく解説しています。
視点:モデルではなくストアをテストする理由
2026年10月時点で36,797件の購入シミュレーションを実施しましたが、そこから分かった最大のことは、問題がどこにあるかです。多くの場合、問題はモデルではありません。エージェントが利用する商品フィード、カタログ、購入手続きにあります。
そのためecenticは、ストア自体の改善に取り組んでいます。Shopify、WooCommerce、または商品フィードに接続し、ChatGPT、Claude、Geminiが各商品を競合商品と比較します。そして、なぜエージェントが競合を選ぶのかを、平易な英語で表示します。Applyをクリックすると、タイトル、説明文、構造化データを書き換え、ストアへ公開します。
Shopifyでは、修正内容をGoogle Merchant Centerへ反映し、AIアシスタントからの訪問数を追跡します。WooCommerceでは、無料のecenticプラグインにより、エージェントがUCP経由で検索、カート追加、決済まで実行できます。この決済部分は、一般的な商品フィードツールでは対応していません。
モデルの進化を待つだけのストアは、自分で制御できない賭けをしているように見えます。モデルは改善され続けますが、それでも読み取るのは商品データです。読まれる価値のあるデータを整えるほうが重要です。
Xhurian Shaba
まずは自社商品で最初のテストを実行する
最も手早く自社の数値を確認する方法は、無料スキャンです。上位10商品を対象とし、カード登録は不要です。ChatGPT、Claude、Geminiが、指定した競合商品とどう比較するか、そして負ける場合はなぜなのかを確認できます。

その後は、 料金ページ で、Competeは最大100商品まで月額$14.90、Scaleはワンクリック修正付きで最大1,000商品まで月額$44.90、Dominateは月額$149で、Google Merchant Center同期とエージェント決済設定が追加されます。また、AI由来注文の3%を課金する従量制プランもあり、上限は月額$500です。まず商品情報の最適化から始めたい場合は、 AI商品情報最適化をご覧ください。 Shopify と WooCommerce 向けのプラットフォームページも用意しています。
FAQ
ECにおけるLLM評価とは何ですか?
検索、確認質問、商品推薦、カート追加などのショッピングタスクを、言語モデルがどの程度うまく処理できるかを評価するプロセスです。優れた評価では、会話全体を採点し、回答を実際の商品データと照合します。EC事業者にとっては、外部AIエージェントが自社商品をどう扱うかを確認することも含まれます。
AIアシスタントが自社商品を推薦しているか、どう確認できますか?
予算や条件を含む現実的な買い物客の質問を用意し、複数のモデルで繰り返し実行してください。指定した競合の商品と比べて自社商品がどれだけ選ばれるかを数え、選ばれなかった場合は理由を記録します。ひとつのチャットボットによる一度の回答は単なる事例ですが、繰り返し実行した一連の結果は測定になります。
AIエージェントにはどのような商品データが必要ですか?
最低限必要なのは、GTIN、MPN、SKUのような安定した識別子、通貨付きの最新価格を単一数値で表したもの、在庫状態、そして明確なバリエーション情報です。仕様情報は形容詞ではなく測定可能な値にする必要があります。これらが欠けると、エージェントは商品比較ができず、候補から除外しがちになります。
ECストアにAI向けデータを組み込むにはどうすればよいですか?
まずは商品フィードと商品ページの構造化データから始めてください。エージェントが読み取るのはそこだからです。ecenticはShopify、WooCommerce、または商品フィードに接続し、Applyをクリックするとタイトル、説明文、構造化データを書き換えてストアへ公開します。その後、再度テストを実行して何が変わったか確認します。
ベンチマークスコアで自社ストアの成果は分かりますか?
直接的には分かりません。ベンチマークは、ショッピングタスク全般でモデルがどう振る舞うかを示すものであり、EComAgentBenchの最高スコア57.1%からも分かるように、まだ多くの失敗余地があります。実際の結果を左右するのは、自社カタログと競合状況です。そのため、それらを自分でテストする必要があります。
参考文献
- Benchmarking Models for Conversational E-Commerce(Rezolve、RecSys 2026 workshop)
- Algolia LLM Leaderboard: methodology
- Evaluating Open-Weight E-Commerce Agents with Environment-Grounded Verification
- EComAgentBench: Benchmarking Shopping Agents(EMNLP 2026 Industry Track)
- DeepShop: A Benchmark for Deep Research Shopping Agents
- Measuring and Improving AI Performance in Conversational Shopping Assistants
- E Pluribus Unum: Guidelines on Multi-Objective Evaluation of Recommender Systems
- On Evaluating and Improving Conversational Agents in Production(Zalando)
- Product Feeds for AI Agents: What Machines Need to Compare
関連トピックを確認